ARTICLE · 1015836
文档也要“压缩构建”了?GitHub 把 README 做成了机器版
文档也要“压缩构建”了?GitHub 把 README 做成了机器版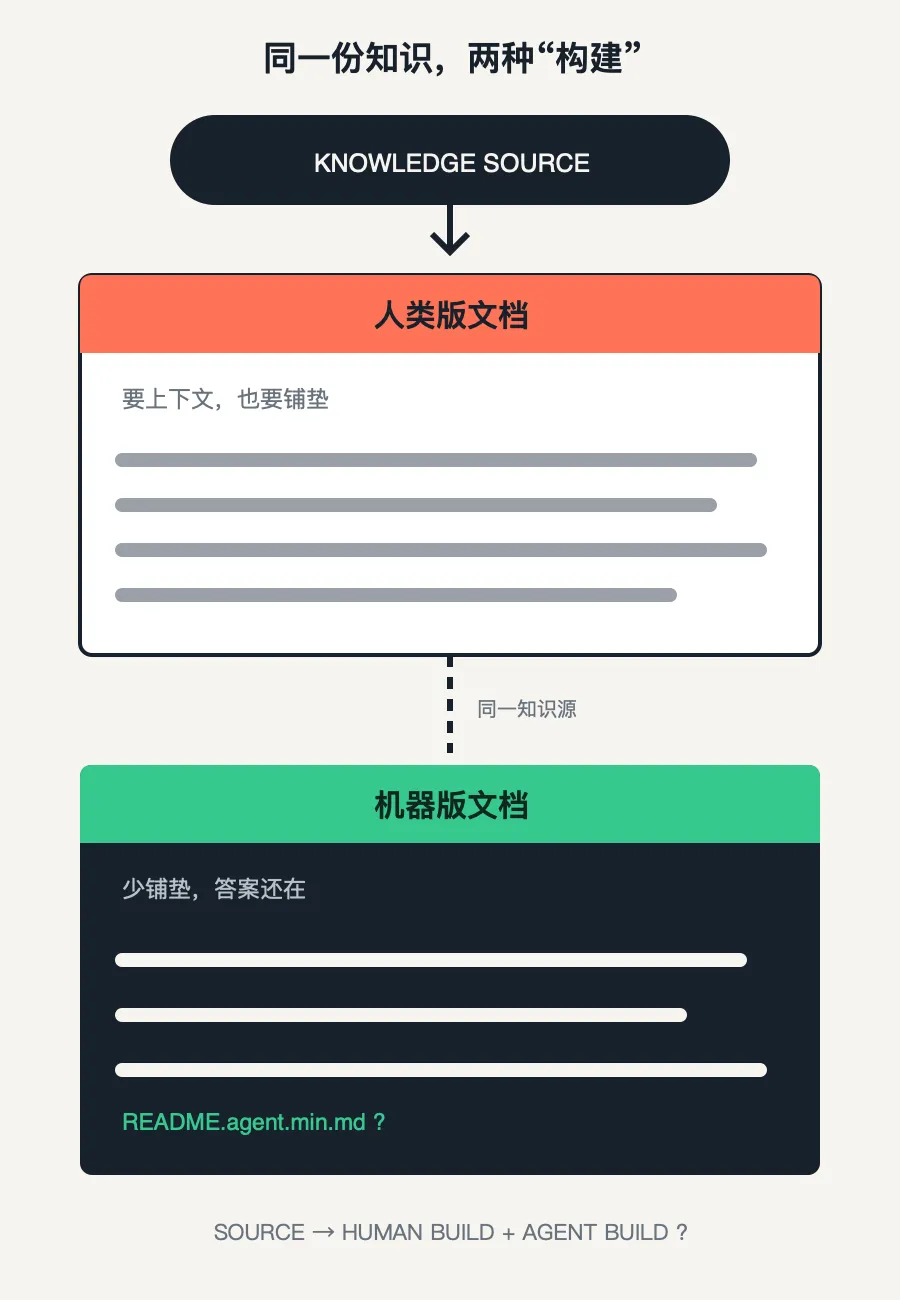
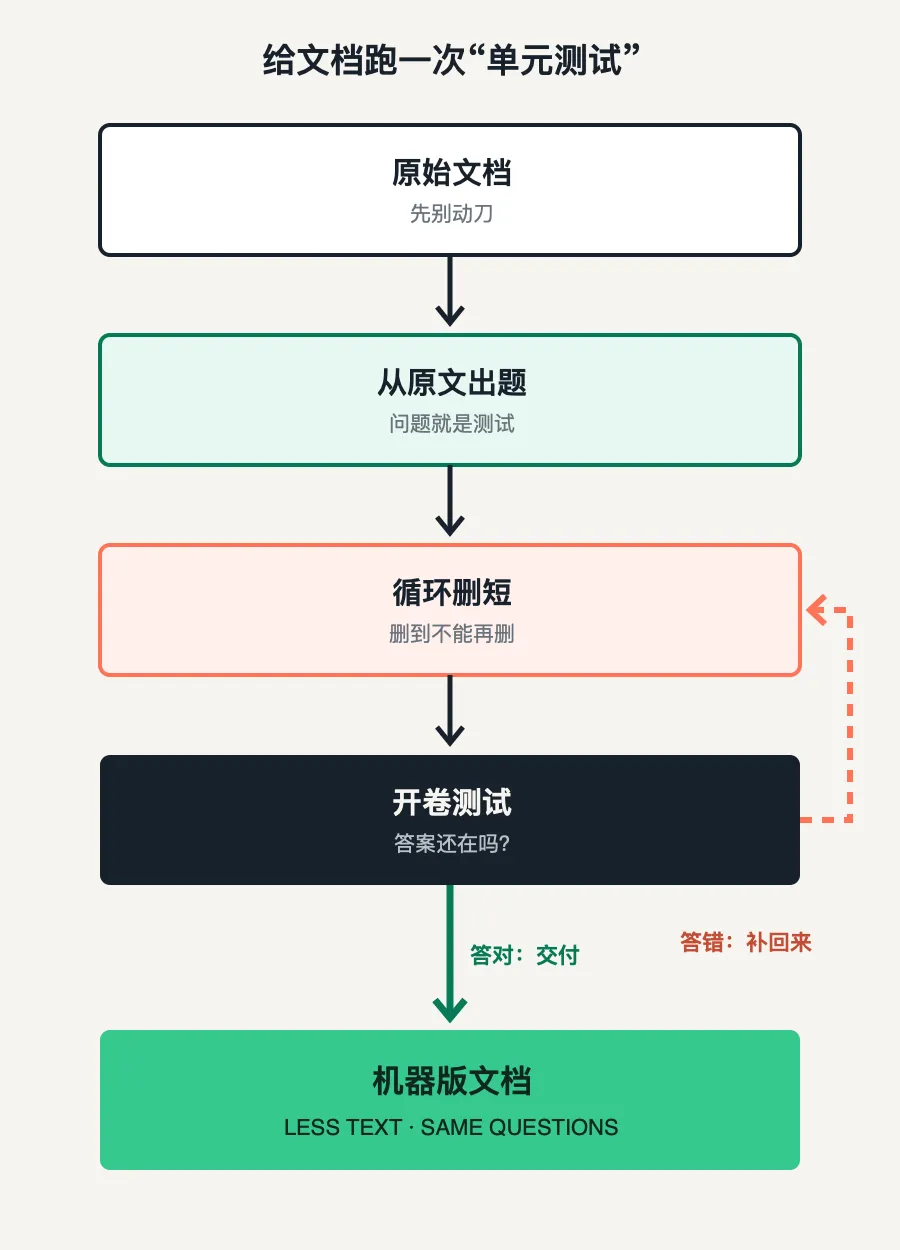
GitHub Next 真把图里的问号做成了实验:给技术文档做“minify”。Knowledge Compressor 反复删短文档,再让 Agent 考试——该知道的还记不记得。
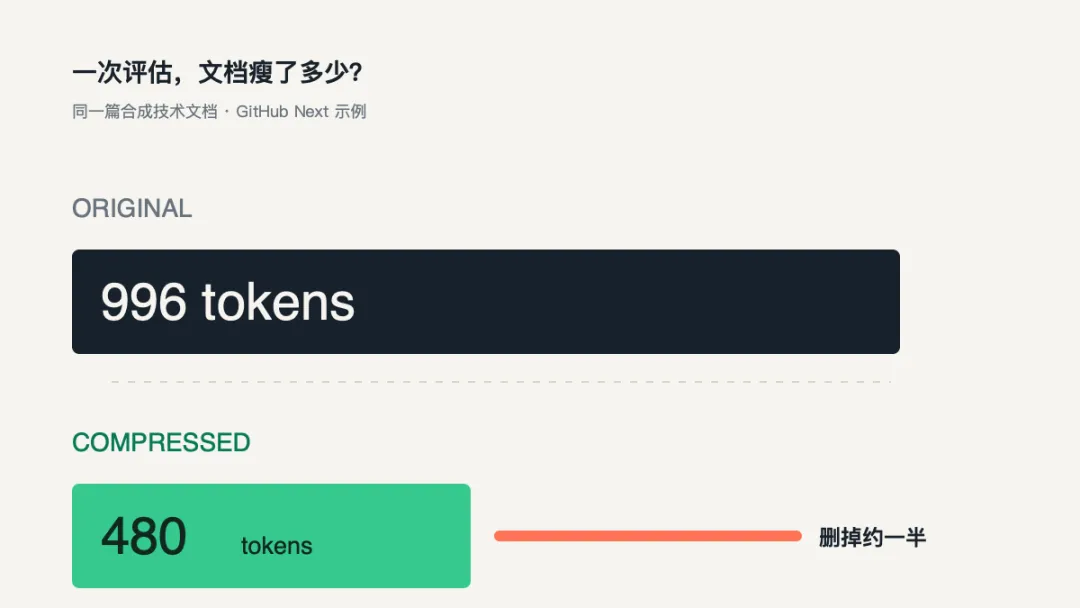
人读 README,需要铺垫;Agent 读 README,铺垫按 token 收费。GitHub Next 认为,典型技术文档约可减半,而对模型的用处没有明显下降。
一次示例:996 → 480。不是魔术,是删完还要考试。
它先从原文出题,再循环删字;一旦答案丢了,就把关键内容补回来。技术文档第一次享受了“压坏就亮红灯”的待遇。
先别找 npm。官方目前称它为原型,也没有提供仓库或安装命令。它更适合围观,不适合今晚顺手塞进 CI。
但现在就能试。找一份经常喂给 Agent 的文档,把下面这段贴给模型:
把下面技术文档压缩成“Agent 版”:1. 保留步骤、约束、例外、数字和因果。2. 删除重复、铺垫和不影响答案的修辞。3. 不添加原文没有的信息。4. 先从原文生成 10 个测试问题。5. 只用压缩稿回答;答不出的内容补回去。输出:压缩稿、前后 token 数、10 个问题的测试结果。原文:{{粘贴文档}}本文实验版 Prompt,并非 GitHub Next 官方模板。
第一次别拿整个 docs/ 开刀。一篇反复使用的 README 或 API 说明就够了:分别让 Agent 用原稿和压缩稿答题,再看看省下的 token 值不值得。
于是问题来了:以后会不会同时维护“人类版”和“机器版”文档?
查看 GitHub Next 原文[1]
引用链接
[1]查看 GitHub Next 原文: https://githubnext.com/posts/knowledge-compressor/