ARTICLE · 1015961
多维表格 + AI:公益机构怎么把 Excel 变成一套数据系统(上)
在公益机构的数据工作中,我们常常面对这样的场景:项目申请表、活动签到表、服务记录表、进度监测表……表格越建越多,数据越积越厚。当有人问一句"这个项目到底服务了多少人""这家机构的参与情况怎么样"时,答案往往不是"没有",而是"要算一下"。
"算一下"的背后,是大量重复的筛选、核对和公式搬运。数据明明就在那里,却无法直接回答问题。这不是工具的缺失,而是组织方式的局限。
本文想讨论的,是如何把一份只会逐条累积的原始数据,变成一套可以从不同角度审视、彼此关联、可持续维护的数据系统。
实现这套系统,需要三个要素协同:
| 人 | AI | 飞书多维表格 |
人负责判断——数据怎么分层、哪些实体该合并、业务关心哪些视角,只有人能做主;
AI负责执行——建表、关联、清洗、统计这些技术工作都可以交给它,通过 AI 工作台连接飞书后,AI 能直接读写多维表格,真正动手帮你完成搭建;
飞书多维表格提供载体——数据存储、关联引用、自动计算与视图切换都在同一处完成。
三者缺一不可。人没有判断,系统建不对;AI 没有,执行全靠人力;载体没有,想法落不了地。
📋 本文索引:
一、重新认识问题:不是表格太多,而是数据没有被组织 二、什么是"系统":让数据之间建立关系 三、数据分层:词典、选项、流水与看板
一、重新认识问题:不是表格太多,而是数据没有被组织
大多数公益机构的数据工作流是相似的:通过表单工具收集信息,定期导出为 Excel,再用公式将明细汇总成监测表。这套流程在项目初期运转良好。
但随着项目推进,数据量增大,一些问题浮现出来。
信息重复出现。机构名称、课程名称、志愿者姓名等信息,在同一张表里反复出现,在不同表格间反复复制。比如一个服务了 200 家机构、开展了上百场活动的项目,"机构名称"这一列有 200 个不同的值,但在几千条活动记录里,这些名称被重复写了几千次。
维护成本增加。当某家机构改了名,需要在每张相关的表里逐一修改。汇总表里的数字依赖公式链条,链条越长,维护越吃力。
视角切换受限。数据按某种方式组织好之后,想换一个角度观察——比如从"按时间排列"切换到"按机构排列"——意味着重新筛选、重新汇总、重新制作。
这些问题的根源相同:数据停留在"平铺"状态。所有信息堆在同一张表里,实体之间没有建立关系,事实与统计混在一起,录入和呈现没有分离。
当数据量足够大、业务需求足够复杂时,我们需要一种更结构化的方式来组织数据。
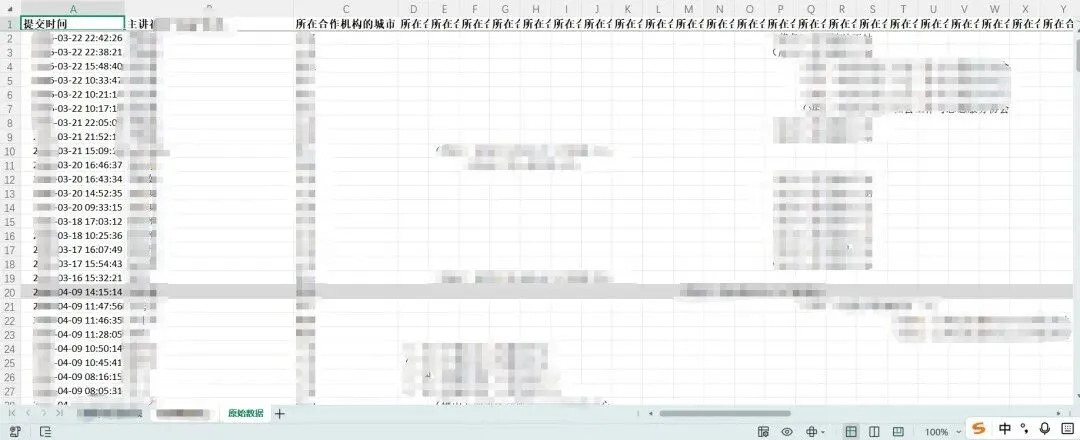
📸 数据"平铺状态"示意图
二、什么是"系统":让数据之间建立关系
系统不是换个地方存数据,而是让数据获得新的能力:
底层数据只记录一次,其余各处都靠引用获得。一家机构的名字只在一个地方维护,但当你在活动记录、统计报表、看板图表中看到它时,它指向的是同一个对象。机构改了名,所有引用自动更新。
凡是算出来的数字,都由系统实时计算。完成率、累计人次、机构排名——这些不是被填进去的静态数字,而是从底层数据中实时派生的结果。任何一个汇总数字都可以点开,一路下钻到构成它的每一条明细。
牵一发而动全身。新增一条活动记录,相关机构的场次、人次、完成率立即重新计算。数据是"活"的——一处变化,全局呼应。
在飞书多维表格里,这种"关系"通过关联字段实现。我们把"机构"做成一张独立表,把"课程"做成另一张独立表,然后在"活动记录"表里,用关联字段指向机构表和课程表中的具体条目。
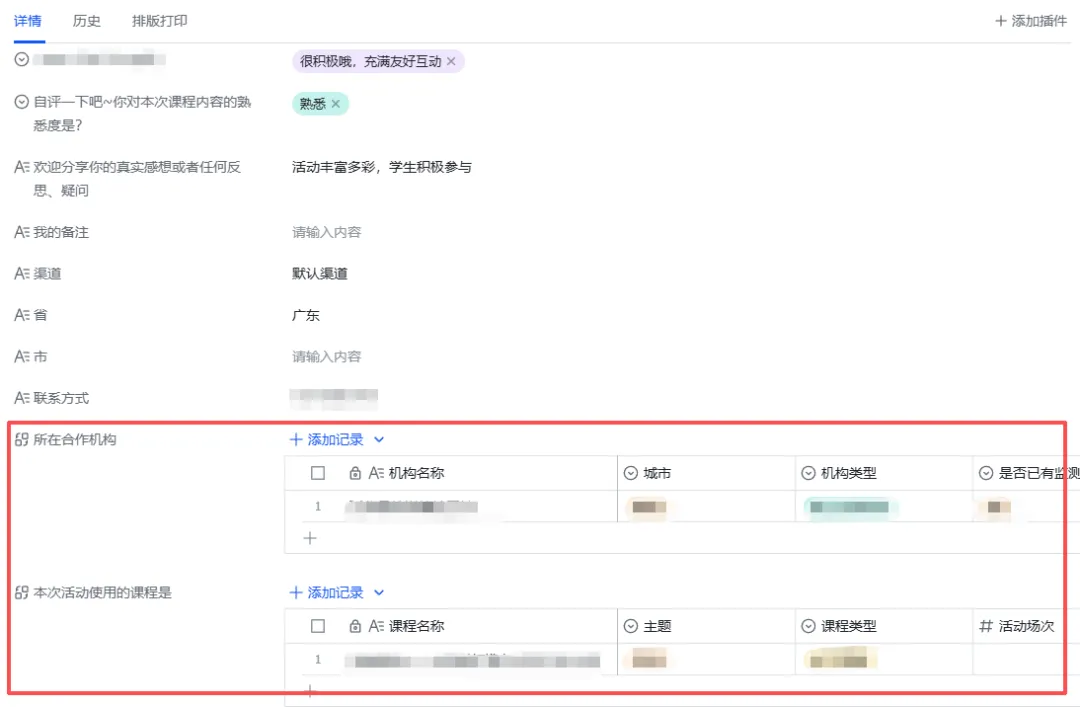
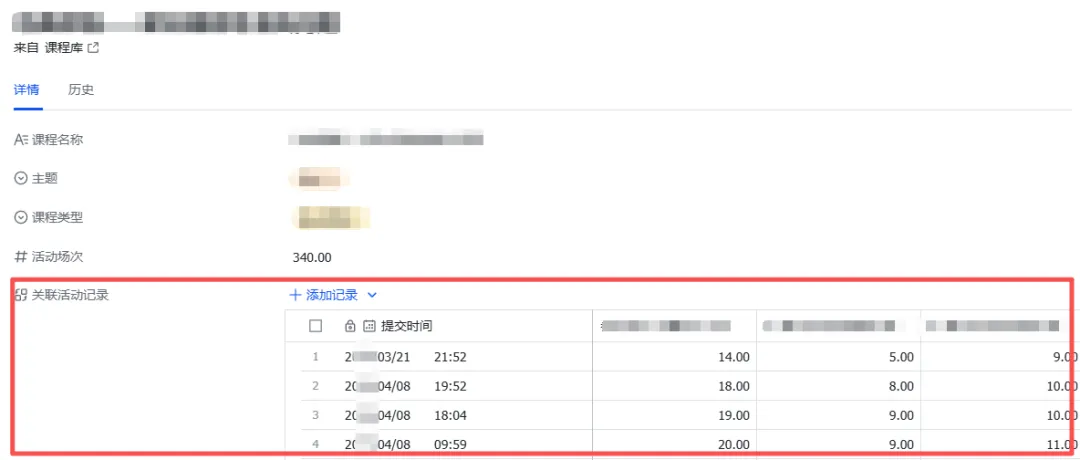
📸通过“双向关联”,实现在两个不同维度的记录中互查详情
以一个儿童教育支持项目为例:合作了 200 多家机构,开展了上百门课程,积累了 3000 多条活动记录,每条记录包含:机构名称、课程名称、主讲志愿者、活动日期、服务人次等字段。
在"平铺"的组织方式下,这些数据是 3000 多行独立的记录。想回答"某家机构累计服务了多少人次",需要筛选出这家机构的所有活动,再求和。
在"系统"的组织方式下:
- 机构:成为飞书多维表格中的一张独立表;
- 课程:成为另一张独立表;
- 活动记录:不再把机构名称、课程名称写成文本,而是通过关联字段指向机构表和课程表中的具体条目。
这样做之后,回答"某家机构累计服务了多少人次"不再需要手工筛选——飞书多维表格会自动汇总所有关联到这家机构的活动记录。机构改了名,所有关联的活动记录和统计结果自动更新。
单独看一条记录,意义有限;但当它们连成一个整体,趋势、对比与差异便自然浮现。
三、数据分层:词典、选项、流水与看板
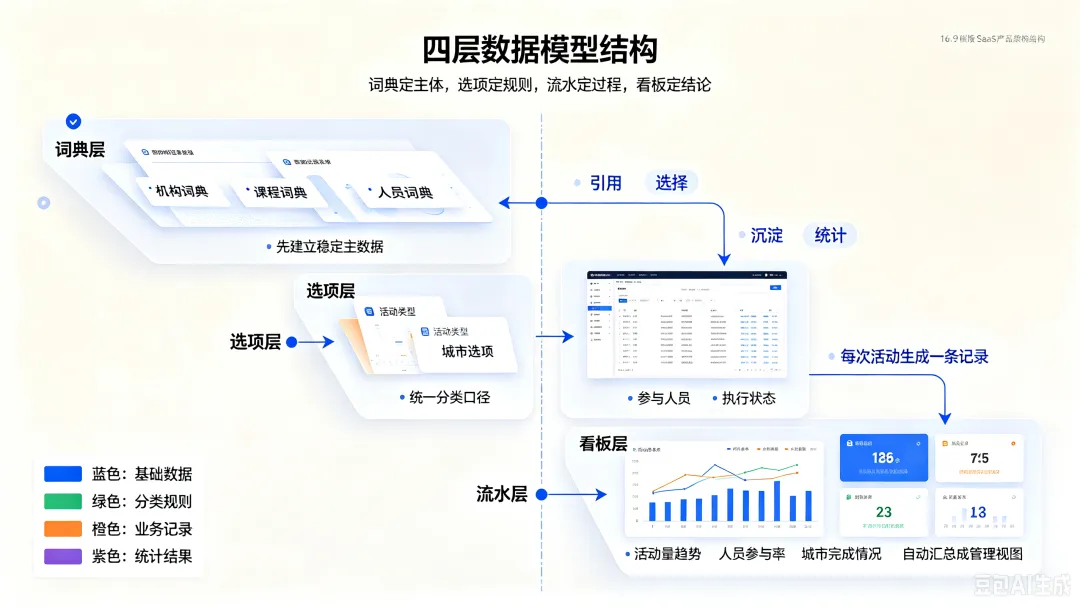
要建立起这样的系统,需要先建立分层的意识。
但在动手之前,更高效的做法是:先把原始数据交给 AI,让它帮你做去重统计。在 AI 工作台里,你可以直接把 Excel 文件丢给它,AI 会自动读取、解析、分析。
比如 AI 会告诉你:"机构名称有 285 个不同的值,课程名称有 31 个,活动类型有 4 个,志愿者有 990 个。"
这份统计结果是分层的关键依据。根据每个字段的取值数量和复用频率,我们可以把它们归入不同的层级:
第一层:词典。取值多、且会被反复引用的实体——机构、课程、人员。在飞书多维表格里,这些建成独立的数据表。
第二层:选项。取值有限且稳定的字段——活动类型(如 4 种)、城市(如 6 个)、状态(如 10 种)。这些不需要独立成表,在飞书多维表格里做成单选或多选字段即可。轻量、够用,还能限定填法、统一口径。
第三层:流水。每一件实际发生的事——一次活动、一笔捐赠、一条服务记录。流水表中的每一行对应一次真实发生,通过关联字段指向词典表中的相应实体,而不是把机构名称、课程名称等文本重复抄写。
第四层:看板。各类统计结果——完成率、累计值、排名。看板不应该被"手工制作",它应该由系统根据流水数据自动计算。在飞书多维表格里,这通过视图和仪表盘实现。
| ① 词典 | ||
| ② 选项 | ||
| ③ 流水 | ||
| ④ 看板 |
分层的重心在前两层。把词典和流水组织好、关联好,看板会随之而来。
回到那个儿童教育项目的例子,根据 AI 给出的去重统计,分层方案可能是:
| 机构表 | ||
| 课程表 | ||
| 志愿者表 | ||
| 活动类型 | ||
| 活动记录表 |
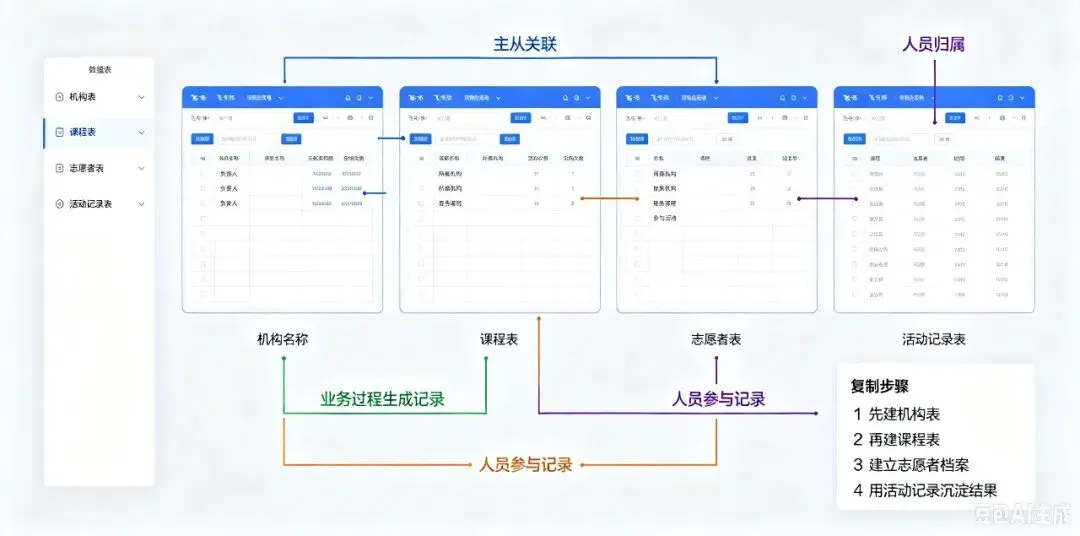
你可以把这个方案拿给 AI 看,让它帮你检查有没有遗漏:有没有哪些字段其实也值得拆出来?有没有哪些关联关系你没考虑到?AI 会根据数据结构给出建议,但最终拍板的还是你。
用一个比喻:词典是骨骼,选项是关节,流水是血肉,关联是经络。骨骼和血肉就位了,经络自然会连通;而如果你试图跳过骨骼直接搭建"肌肉线条",它注定站不起来。
上篇小结:想清楚,再动手
到这里,我们拿到了一份可以落地的方案:哪些字段该独立成表,哪些该做成选项,哪些是流水,看板交给系统自动算。
但方案清楚了,下一个问题是:谁来建?建表、关联、导数据、清洗——这些工作量不小,全靠人工做不动;交给 AI,又有一个前提要先解决:它得够得着你的表格。
下篇接着讲这件事:人和 AI 怎么分工,以及一个绕不开的现实问题——脏数据。
如果你也想把这件事做下去
我们建了一个公益数字化交流群,欢迎同行一起聊
| 同行交流 | |
| 工具分享 | |
| 问题咨询 |
扫码加入「全思科技_AI工具交流」由广州全思信息科技有限公司发起并维护