ARTICLE · 1015988
LightLLM 源码拆解part01(Router)
1. LightLLM 大模型推理框架
本文以纯大语言模型为例,不考虑多模态模型,并设置 TP=1,即单卡推理。不影响后续分析的代码将省略。
1.1 部署和快速使用
部署参考:LightLLM 官方文档
使用两个终端:
• 启动服务 python -m lightllm.server.api_server \
--model_dir Llama-3.2-1B-Instruct/ \
--host 0.0.0.0 \
--port 8080 \
--max_req_total_len 1024 \
--batch_max_tokens 256• 发送请求 python test/benchmark/service/benchmark_sharegpt.py \
--dataset ShareGPT_V3_unfiltered_cleaned_split.json \
--tokenizer Llama-3.2-1B-Instruct/ \
--num-prompts 1000 \
--request-rate 10.0
2. 框架结构
LightLLM 采用多进程架构,主要包括:
• Router:负责请求调度 • Detokenization:负责 Token 到文本的转换 • Metric:负责指标收集 • Health:负责健康监控
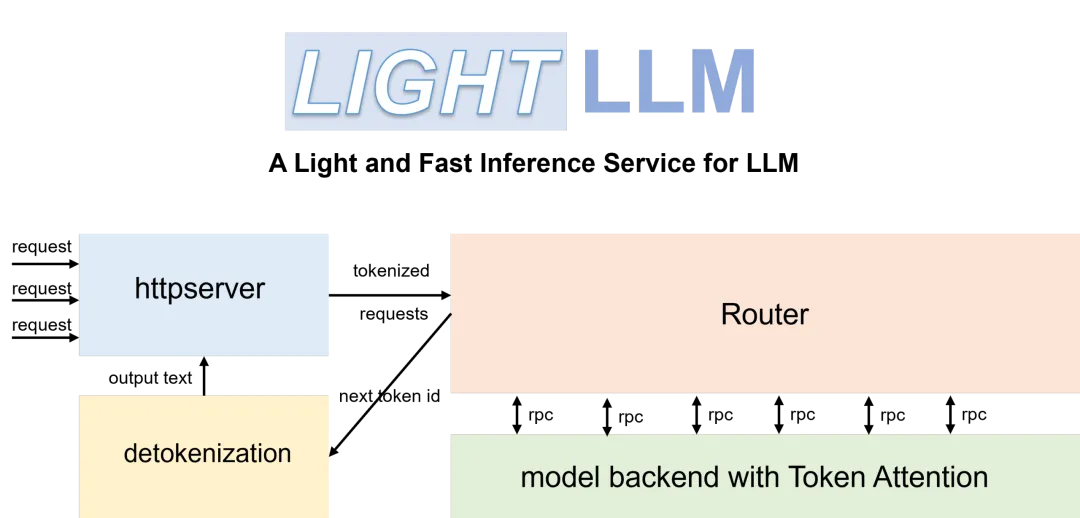
通过 python -m lightllm.server.api_server 启动服务后,程序进入 api_server.py 的 launch_server()。本文使用 normal 启动方式,该方式通过 normal_or_p_d_start() 启动相关进程。
其中,_launch_subprocesses() 负责创建 Router、Detokenization 和 Metric 三个子进程:
def_launch_subprocesses(args: StartArgs):
# 启动 metric manager
    process_manager.start_submodule_processes(
        start_funcs=[start_metric_manager],
        start_args=[(args,)],
    )

# 启动 router 和 detokenization
    router_process, _ = process_manager.start_submodule_processes(
        start_funcs=[start_router_process, start_detokenization_process],
        start_args=[(args,), (args,)],
    )
如果开启健康监控,还会额外启动 Health Monitor 进程。
3. Router 子进程
Router 子进程主要负责请求调度与筛选,从等待队列中选择满足当前资源约束的请求,并将其加入可运行请求列表。
请求处理主要涉及两个队列:
• waiting_req_list:存放通过 ZMQ 接收的新请求。• can_run_list:存放经过调度筛选后、可以加入当前执行计划的请求。
代码中会出现多个与 batch 相关的变量,这里的 batch 主要用于计算请求组合下的内存资源消耗,与通常意义上实际送入模型执行的 Batch 并不完全等价,需要注意区分。
该部分的核心调度逻辑主要来自论文 Past-Future Scheduler for LLM Serving under SLA Guarantees,具体内容可以参考我的论文分享博客。
该部分代码主要涉及两个文件:
• lightllm/server/router/manager.py• lightllm/server/router/req_queue_chunked_prefill/beam_impl.py
Router 的启动函数为 start_router_process()。Router 进程启动后,会创建并设置 asyncio event loop,完成 RouterManager 的初始化,并等待模型准备完成。初始化完成后,进入主循环 loop_for_fwd()。
3.1 loop_for_fwd()
loop_for_fwd() 会持续循环执行 Router 的调度逻辑,主要包括以下几个部分:
• 执行 _step():负责读取新到达的请求,并进行请求调度与筛选,将符合条件的请求加入可运行请求列表。• 输出监控指标:定期统计并打印 Router 当前的运行状态和相关监控指标。
    async def loop_for_fwd(
        self,
    ):
        counter_count = 0
        while True:
            await self._step()
            counter_count += 1
            #下面代码省略 周期性统计并输出 Batch、Token Load 及队列状态,同时更新相关监控指标。

            await asyncio.sleep(self._get_schedule_time_interval())
_step() 主要负责请求接收、请求调度以及 Router 状态更新,整体流程可以概括为:
• 1. 接收新请求并加入等待队列
从 ZMQ 接收新请求,每次最多处理 64 个,并将其加入waiting_req_list。随后按照当前调度策略,从等待队列中筛选满足资源约束、可以加入当前执行计划的请求。• 2. 将筛选结果写入共享内存
将调度筛选出的请求信息写入共享内存,由model-infer端从共享内存中读取并执行。• 3. 更新 Router 状态
获取当前running_batch的运行信息,根据模型执行状态动态更新 Router 内部维护的资源、请求等相关状态。
  loop_for_fwd()
  └── _step()
      ├── _recv_new_reqs_and_schedule()
      │   ├── zmq_recv_socket.recv_pyobj() //从zmq获取请求
      │   ├── _add_req() //将请求放到waiting_req_list,每次最多取64个
      │   └── _generate_new_batch()
      │       └── generate_new_batch() //将合适的请求从waiting中筛选出来
      │           ├── _init_cache_list()
      │           ├── _can_add_new_group_reqs() //三个条件判断请求是否合适
      │           │   └── req.get_tuple_tokens()
      │           └── 生成 Batch
      │
      ├── _add_new_batch_to_running_batch()
      ├── _add_batch()
      │   ├── req.to_router_rpc_obj()
      │   ├── shm_reqs_io_buffer.write_obj()
      │   └── shm_reqs_io_buffer.set_ready()
      └── _filter_reqs_from_running_batch()
          └── running_batch.filter_out_finished_req()
              ├── 读取 req.shm_infer_released
              ├── router_statics.update(req.candetoken_out_len)
              └── shm_req_manager# 1.LightLLM 大模型推理框架
3.2 调度器核心部分
调度器的主要实现位于 generate_new_batch() 中,代码文件为 lightllm/server/router/req_queue_chunked_prefill/beam_impl.py。
generate_new_batch() 会按照 waiting_req_list 中的请求顺序依次进行调度。对于待加入的新请求组,通过 _can_add_new_group_reqs() 判断加入后的资源占用是否满足调度约束:
• 满足约束:将该请求组加入当前可运行请求列表,继续检查后续请求。 • 不满足约束:停止本轮调度,不再继续检查后面的请求。
其中,_can_add_new_group_reqs() 是该调度机制的核心实现,主要根据请求的输入 Token、预估输出 Token 等信息计算加入请求后的峰值 Token 占用,并检查最大 Token 数、最大请求数以及 Prefill Token 数等约束。
这部分调度机制是论文 Past-Future Scheduler for LLM Serving under SLA Guarantees 提出的核心工作,在 LightLLM 中进行了具体实现。
官方相关说明可参考:Efficient Router
defgenerate_new_batch(self, current_batch: Batch):
iflen(self.waiting_req_list) == 0:
returnNone

# 当前正在运行的请求数达到上限,不再调度新的请求
    exist_req_num = self.get_batch_dp_req_size(current_batch)
    req_is_full = exist_req_num >= self.running_max_req_size
if req_is_full:
returnNone

self.filter_aborted_reqs()
iflen(self.waiting_req_list) == 0:
returnNone

# 判断当前服务是否处于繁忙状态
    is_busy = self.is_busy()

# 初始化资源占用统计,将当前 Batch 纳入后续 Token 占用计算
self._init_cache_list(current_batch, is_busy)

    can_run_list = []
# 当前已选请求对应的首轮 Router / Prefill Token 数
    new_batch_first_router_need_tokens = 0
    cur_group_reqs = []

# 按 waiting_req_list 中的顺序依次调度请求
for req inself.waiting_req_list:

# 相同 group 的请求加入当前组,暂不进行资源检查
ifself._add_to_group(cur_group_reqs, req):
continue

# 检查加入当前请求组后是否满足资源约束
        ok_insert, new_batch_first_router_need_tokens = self._can_add_new_group_reqs(
            cur_group_reqs, is_busy, new_batch_first_router_need_tokens
        )

if ok_insert:
# 当前请求组满足约束,加入可运行列表
            can_run_list.extend(cur_group_reqs)
# 开始判断新的请求组
            cur_group_reqs = [req]
else:
# 当前请求组无法满足约束,结束本轮调度
            cur_group_reqs = []
break

# 检查最后一个尚未判断的请求组
iflen(cur_group_reqs) != 0:
        ok_insert, new_batch_first_router_need_tokens = self._can_add_new_group_reqs(
            cur_group_reqs, is_busy, new_batch_first_router_need_tokens
        )
if ok_insert:
            can_run_list.extend(cur_group_reqs)

# 根据筛选结果创建新的 Batch
    new_batch = None
iflen(can_run_list) != 0:
        new_batch = Batch(uuid.uuid4().int, can_run_list, dp_size_in_node=self.dp_size_in_node)

# 从 waiting 队列中移除已经被调度的请求
self.waiting_req_list = self.waiting_req_list[len(can_run_list):]

return new_batch-----------------------------------------------------------def_can_add_new_group_reqs(
self,
cur_handle_group_reqs: List[Req],
is_busy,
new_batch_first_router_need_tokens
):
# 获取请求的输入长度和预估输出长度,用于计算峰值 Token 占用
for req in cur_handle_group_reqs:
self.cache_len_list.append(
(req, req.get_tuple_tokens(
is_busy,
self.router.router_statics.ema_req_out_len
))
)
# 按预估输出长度从大到小排序
self.cache_len_list.sort(key=lambda x: -x[1][1])
# 计算当前请求组合的峰值 Token 占用
need_max_token_num = 0
cumsum_len = 0
exist_group_req_set = set()
for index, (req, (cur_input_len, cur_ouput_len)) inenumerate(
self.cache_len_list, 1
):
if req.group_req_id notin exist_group_req_set:
# Group 中的第一个请求,需要计算完整的输入长度
exist_group_req_set.add(req.group_req_id)
cumsum_len += cur_input_len
need_max_token_num = max(
need_max_token_num,
cumsum_len + index * cur_ouput_len
)
else:
# 同一 Group 的请求共享部分 Token,因此扣除共享部分
assert cur_input_len - req.input_len >= 0
cumsum_len += cur_input_len - req.input_len
need_max_token_num = max(
need_max_token_num,
cumsum_len + index * cur_ouput_len
)
# Beam 请求共享首轮 Prefill,只计算一次对应的 Token 数
new_batch_first_router_need_tokens += req.get_first_router_need_tokens()
# 约束 1:峰值 Token 占用不能超过最大 Token 容量
ok_token_num = need_max_token_num < self.max_total_tokens
# 约束 2:请求数量不能超过最大请求数
ok_req_num = len(self.cache_len_list) <= self.running_max_req_size
# 约束 3:首轮 Prefill Token 数不能超过 Batch 上限
ok_prefill = new_batch_first_router_need_tokens <= self.batch_max_tokens
if ok_token_num and ok_req_num and ok_prefill:
self.router.shared_token_load.set_estimated_peak_token_count(
need_max_token_num,
self.dp_index
)
self.router.shared_token_load.set_dynamic_max_load(
need_max_token_num / self.max_total_tokens,
self.dp_index,
)
returnTrue, new_batch_first_router_need_tokens
else:
returnFalse, new_batch_first_router_need_tokens