ARTICLE · 1016510
Java 程序员学习 AI(十):XGBoost——为什么给树加上“复杂度成本”?
JAVA 程序员学习 AI · 第十篇
上一篇,我们理解了 Boosting:先给出预测,再让新树学习如何修正当前整体模型。
但持续修正也带来一个问题:如果一棵树不断增加分支,它可能把训练数据里的偶然现象也记下来。
多分裂一次,能改善多少预测?这点改善,值得增加一条规则吗?
今天,我们用这个问题走近 XGBoost。重点不是罗列参数,而是理解它为什么把模型复杂度写进训练目标。
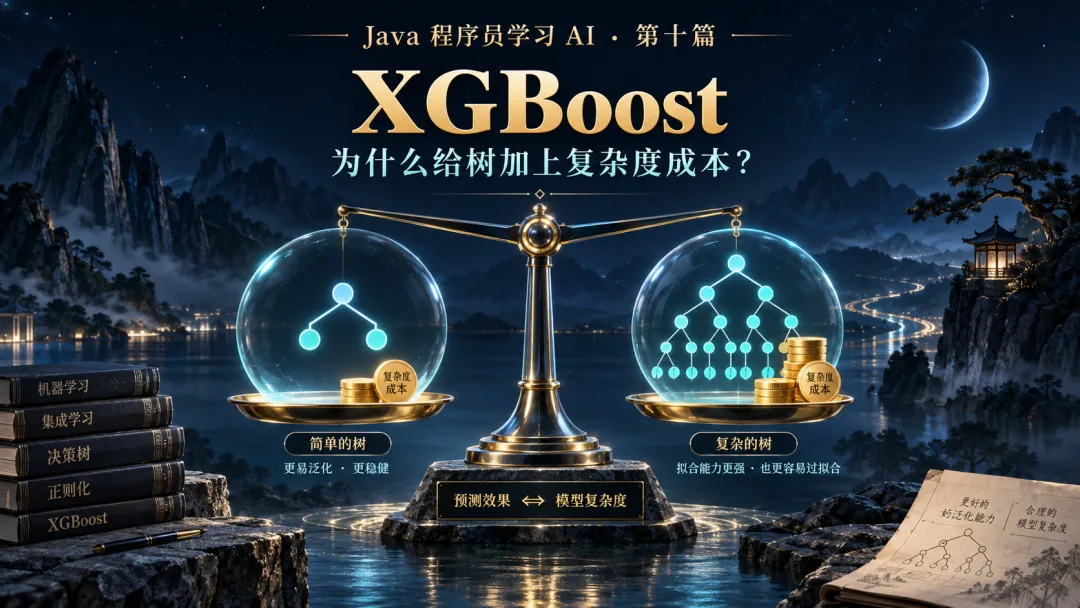
XGBoost:在拟合效果与模型复杂度之间做取舍。
01 先给规则算一笔账
继续用配送时长的例子。当前模型发现,下雨天经常预测偏低,于是新树按“是否下雨”分裂,学到了有用的修正。
继续细分,它还可能发现:某个商家在某个时间段,恰好有两笔订单延误。
为这两笔订单专门增加一个叶节点,也许能降低训练误差。但延误如果来自偶然的电梯故障,这条规则对未来未必有帮助。
我们需要一个机制,让模型在增加规则之前先问一句:收益是否足以抵消复杂度成本?
这里的“成本”是训练目标中的数学惩罚,不是服务器费用,也不直接等于运行耗时。
02 目标不仅是把训练集拟合得更准
可以先把正则化训练目标理解成:
训练目标 = 预测误差 + 模型复杂度惩罚
第一部分鼓励模型贴近真实值,第二部分让过于复杂的模型付出代价。
在一个便于入门的 XGBoost 树模型推导中,单棵树的复杂度项写成:
Ω(树) = γ × T + ½ × λ × Σw²
T 是这棵树的叶子数量;w 是各个叶节点输出的分数或修正量;γ 和 λ 控制两种惩罚的强度。
本文先忽略 L1 正则化等其他项。公式中的平方和,是把每个叶子的输出平方后相加,不是先相加再平方。
不用急着背公式。先记住:叶子太多要付成本,叶子输出太大也要付成本。这是两种不同的约束。
03 γ:多长出一个叶子,值不值得?
把一个叶节点分成左右两个叶节点,叶子总数增加了 1。因此,γ × T 这一项增加的成本就是 γ。
做一个简化的教学算例:暂时令 λ = 0,其他约束也先不考虑,所有收益与成本都使用同一训练目标尺度。
如果某个候选分裂使拟合部分的目标改善 6,而新增叶子的成本为 2,那么净收益为 4,值得进一步考虑。
另一个分裂只改善 1,成本仍为 2,净收益为 −1,就不值得为了它增加复杂度。
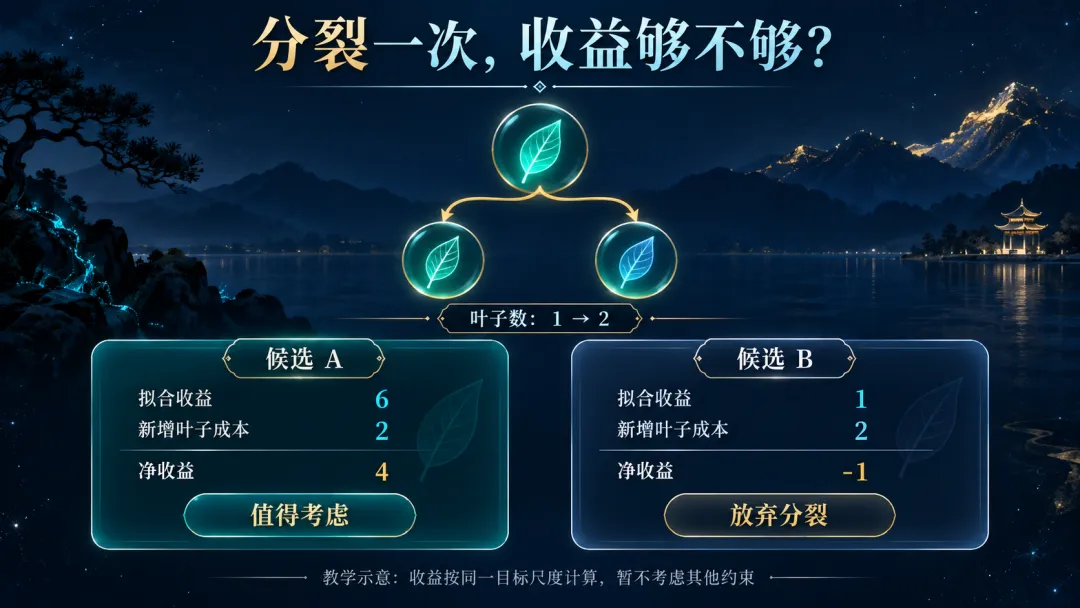
教学示例:净收益 = 拟合收益 − 新增叶子的成本。
这里的 6 和 1 是目标值的改善量,不是准确率提高了 6% 或 1%。γ 也不是“最多允许多少个叶子”。
当 λ 不为零时,分裂前后叶子输出的正则化成本也会变化,必须一起计入评分。不能只看训练误差下降,再随手减一个 γ。
04 λ:同一个叶子,修正别太猛
叶子少,并不意味着每次修正都温和。一个叶节点仍可能输出很大的正数或负数。
λ 对叶子输出的平方施加惩罚。要理解它如何起作用,我们先认识两个统计量:
G:落在这个叶子中的训练样本,其损失一阶导数之和。
H:这些样本的损失二阶导数之和。
一阶信息描述局部变化方向,二阶信息描述局部曲率。XGBoost 的这个推导用二阶近似评价一次更新;本文不展开泰勒公式。
固定叶子的样本划分,忽略 L1 与其他额外约束,并假设 H + λ 为正时,最优叶子输出为:
w = −G / (H + λ)
例如 G = −12、H = 3:λ = 0 时,w = 4;λ = 3 时,w = 2。对于同一组 G、H,增大非负的 λ,会缩小输出的绝对值。
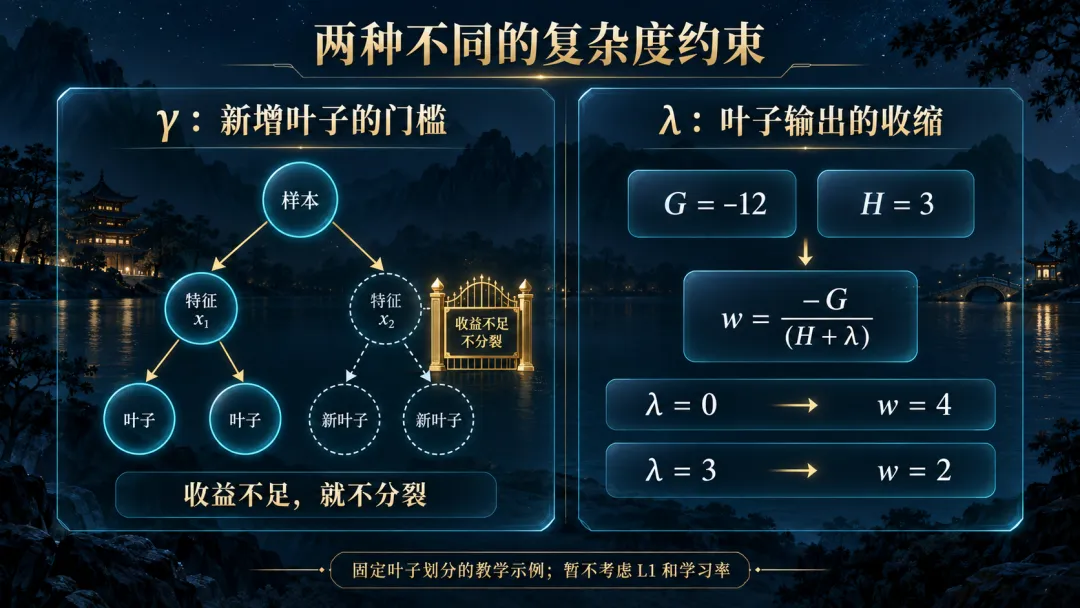
γ 约束分裂门槛;λ 约束叶子输出。
注意,这些都是乘学习率之前的叶子输出。训练时更改 λ,还可能改变最终选择的树结构,因此不能保证实际训练出的每个叶子都与原来一一对应。
复杂度项、G/H 与叶子输出公式依据 XGBoost 官方提升树教程;上述数值均为本文教学算例。
05 把叶子输出公式翻译成 Java
下面这段 Java 11 代码只验证公式,不训练模型,也没有调用 XGBoost 库。
public class LeafWeightDemo {
    static double leafWeight(
            double gradientSum,
            double hessianSum,
            double lambda) {
        return -gradientSum
            / (hessianSum + lambda);
    }

    public static void main(String[] args) {
        double g = -12.0;
        double h = 3.0;

        double before = leafWeight(g, h, 0.0);
        double after = leafWeight(g, h, 3.0);

        System.out.println(before); // 4.0
        System.out.println(after);  // 2.0

        double learningRate = 0.1;
        double prediction = 30.0;
        prediction += learningRate * after;
        System.out.println(prediction); // 30.2
    }
}
这个例子假定输入是有效的、分母为正。它表达了两个步骤:先根据正则化目标得到叶子输出,再用学习率缩放该输出的贡献。
λ 和学习率都会影响更新幅度,但它们作用的位置不同。λ 进入叶子输出与分裂评分的计算;学习率控制新树最终加入整体模型的步长。
06 为什么 H 不总等于样本数?
对于每条样本使用 ½ × (预测值 − 真实值)² 的平方损失,并且没有样本权重时,二阶导数是 1。因此,这个特例下 H 恰好等于叶子里的样本数。
但不能把这个特例当作通用定义。换成其他损失,或者加入样本权重,每条样本对 H 的贡献就可能不同。
这也解释了一个容易误读的参数:min_child_weight 通常约束的是子节点中 Hessian 的总和下限,并非通用的“最少样本条数”。
例如在常见的二分类逻辑损失中,单条样本的二阶导数与当前概率 p 有关,形式为 p × (1 − p)。它不会恒等于 1。
参数含义可查阅 XGBoost 树模型参数文档。
07 几个参数,分别在管什么?
gamma / min_split_loss:提高分裂所需的目标改善门槛。门槛较高时,收益不足的分裂会被挡住。
lambda / reg_lambda:L2 正则化强度,约束叶子输出,也影响候选树结构的评分。
eta / learning_rate:缩小每轮新树的贡献,通常需要结合训练轮数一起调整。
max_depth:限制单棵树的深度。它直接限制结构,并不等价于 γ。
min_child_weight:限制子节点中二阶导数统计量的最小总和,避免某些支持不足的分裂。
这些都是我们设置的超参数;分裂特征、阈值和叶子输出则由训练过程学出来。各接口的参数命名可能不同,应以所用接口文档为准。
08 有正则化,就不会过拟合了吗?
不会。正则化提供了一种偏好:在拟合效果和复杂度之间做取舍。它并不保证每一份数据都能因此得到更好的测试结果。
惩罚太弱,模型可能仍然追逐噪声;惩罚太强,模型又可能学不到真正有用的关系,出现欠拟合。
训练时仍要保留验证集,观察验证指标,必要时使用早停。若是按时间预测配送业务,应考虑按时间划分数据,避免把未来信息混入训练过程。
特别是预测时尚未发生的“最终配送状态”“真实到达时间”,不能提前作为特征输入。再精巧的复杂度惩罚,也补救不了数据泄漏。
封面的天平表达的是这种取舍:简单并不自动等于准确,复杂也不自动等于好。最终要用符合业务场景的验证结果判断。
09 从公式回到程序员的直觉
把一棵树看作一套条件分支,新增叶子就意味着更细的规则。XGBoost 给这些选择提供了明确的评分依据。
值得增加规则时再分裂;
需要修正预测时,也考虑修正幅度的代价。
这不是 XGBoost 的全部。它还涉及高效的分裂搜索、稀疏数据处理等实现问题。但先理解目标函数,就能知道这些实现最终在优化什么。
下一篇:《Java 程序员学习 AI(十一):训练集越来越准,为什么上线效果反而变差?》
我们会继续讲训练集、验证集、测试集与数据泄漏,把“模型看起来很准”变成一次可信的评估。