ARTICLE · 1023283
“从一道C笔试题说起:字符就是数字,字符串就是带\0的数组”——ASCII与C字符串的前世今生
【引言】
在C语言里,字符串从来不是一种“类型”,而是一种“约定”。这个约定从ASCII开始,经过BCPL、B语言的演变,最终在Dennis Ritchie手中定型。
一、一道笔试题,全部答对率不到50%
先看一道某大厂C语言笔试题:
char str1[] = "abc";char str2[] = {'a', 'b', 'c'};printf("%d\n", sizeof(str1));printf("%d\n", sizeof(str2));printf("%d\n", strlen(str1));printf("%d\n", strlen(str2));
问:以上四个输出分别是什么?
很多同学的答案:4, 3, 3, 3
正确答案:4, 3, 3, 随机值
str1是字符串,编译器自动在末尾加了'\0',所以sizeof是4;str2是字符数组,没有结束符,所以strlen会一直往后找直到遇到随机的'\0'。
这道题考察的不是语法,而是C语言对字符串最根本的设计:字符串以'\0'结尾。
要理解这个设计为什么是这样,得回到半个多世纪前,从字符编码开始讲起。
二、字符是什么?——数字与字符之间的“密码本”
2.1 字符和数字的映射:一本“密码本”
字符'A'在计算机里到底是什么?答案是:数字65。
计算机内存里只有0和1,没有字母、没有符号、没有标点。你看到的'A',本质上是内存中一个8位的二进制数01000001(十进制65)。编译器看到'A',把它翻译成65;屏幕上显示65这个值时,又被翻译回'A'。
这个“翻译”的过程,靠的是一张映射表——字符和数字之间的对应关系表。
这本质上就是加密和解密:
加密(编码):你写的字符
'A',被转换成数字65存储到内存中解密(解码):内存中的数字65,被转换成字符
'A'显示到屏幕上
没有这张映射表,同一串数字01000001可以被解读成字母'A',也可以被解读成其他任何东西——这正是1960年代末ARPANET上面临的真实困境。
2.2 从“I love you”变成乱码说起
1971年,ARPANET已经扩展到了15个节点以上。一位程序员在DEC PDP-10计算机上,通过刚诞生不久的电子邮件系统,给远在另一所大学的女友发了一封邮件:“I love you”。
但女友的IBM机器上收到的却是一串完全无法辨认的乱码符号。
问题出在编码表不统一上。DEC机器用的是ASCII表,'I'对应数字73;IBM机器用的是EBCDIC表,数字73在EBCDIC里对应的是一个完全不同的符号。同一串二进制,在两台机器上被两张不同的“密码本”解密,自然得到完全不同的结果。
“编码不统一”的本质是:双方没有约定好同一本“密码本”。 实际上,早在1969年10月,RFC 20《ASCII format for Network Interchange》就已经为网络文本交换提供了一个统一的编码规范。但直到1970年代初,ARPANET上并非所有机器都采纳了这个规范。
随着计算机之间数据交换的需求越来越迫切,一本统一的“密码本”势在必行。1960年10月6日,美国标准协会(ASA)的X3.2小组委员会召开了第一次会议,目标是制定统一的信息交换标准编码。1963年,第一版ASCII标准正式发布。
不过,ASCII只解决了美国国内的编码问题。对于欧洲语言中的重音字符(é、ñ、ü等),ASCII依然束手无策,这为后来ISO 8859、GB2312、Unicode等更广泛的编码标准埋下了伏笔。当然,那是另一个故事了。
2.3 ASCII:128个字符的“密码本”
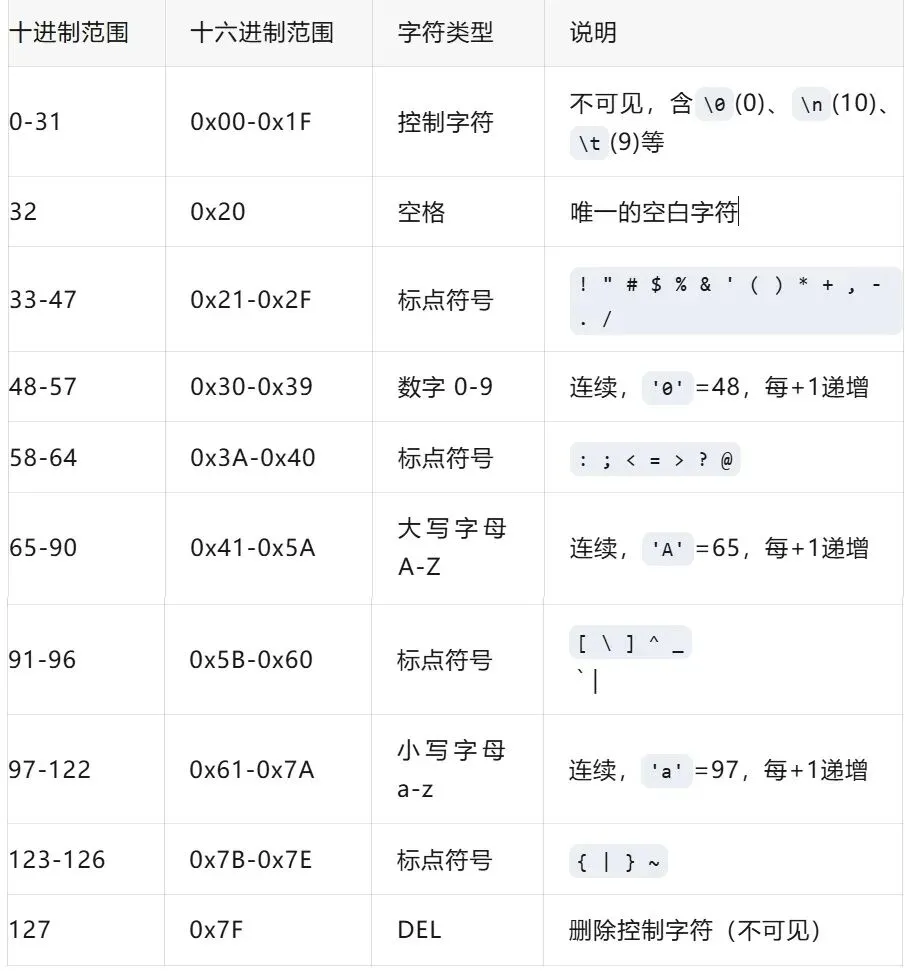
ASCII用7个比特编码128个字符,分为33个控制字符(0-31、127)和95个可打印字符(32-126)。
ASCII完整编码表:
2.4 建议背的5个ASCII值
128个ASCII值中,只有5个建议记住:
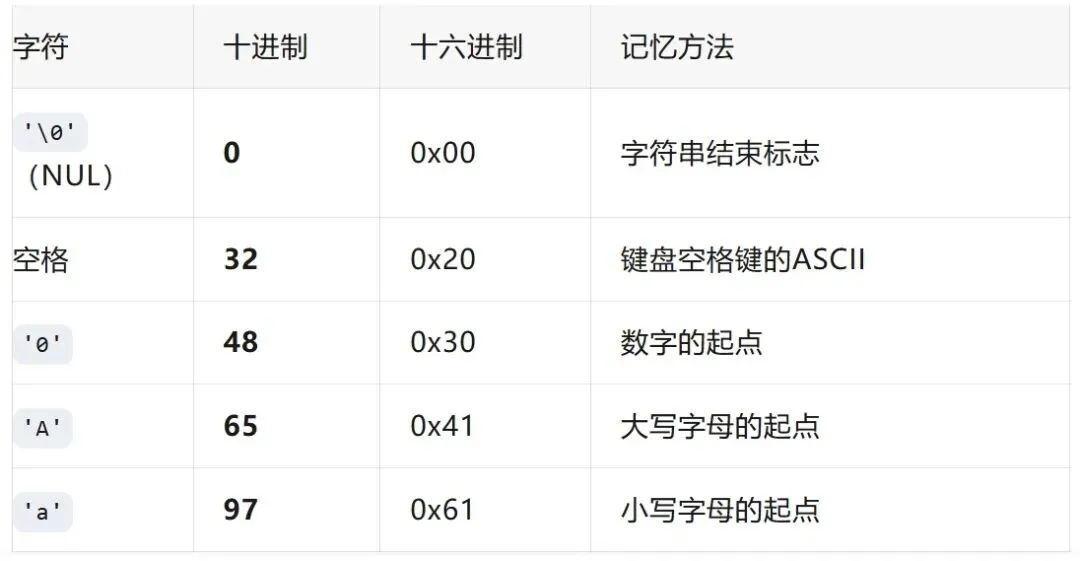
只要记住这5个数,其余都可以通过规律推导:
'A'到'Z':65~90(连续+1) → 所以'K'= 65 + 10 = 75'a'到'z':97~122(连续+1) → 所以'k'= 97 + 10 = 107'0'到'9':48~57(连续+1) → 所以'7'= 48 + 7 = 55
同一字母的大小写相差32:'A'=65,'a'=97。为什么是32?因为ASCII用7位编码,大写字母的第6位是0,小写字母的第6位是1,相差正好是2⁵=32。这就是为什么'A'+32='a'在逻辑上是成立的。
数字字符转数值(面试常考技巧):
char c = '5';int num = c - '0'; // num = 5
因为'0'到'9'是连续编码的,'5'-'0'=53-48=5。这个技巧在字符数字转整数的场景中高频出现。
ASCII码大小规律: 数字(48-57)< 大写字母(65-90)< 小写字母(97-122),可直接用字符比较运算符。
2.5 C语言的char:1字节,8比特
当Dennis Ritchie在PDP-11上开发C语言时,PDP-11是8位字节寻址的机器。char类型被定义为1个字节,在PDP-11上天然就是8位。而ASCII只需要7位,8位的char刚好能容纳ASCII的所有字符。
字符在C语言中就是一个数字。
'A'就是65,'\0'就是0。字符和整数之间的界限,在C语言里几乎是透明的。
三、字符串的诞生:从BCPL到B到C
3.1 BCPL:用第一个字节存长度
C语言的爷爷是BCPL(1966年开始设计,1967年发布)。BCPL如何处理字符串?把字符串当作整数数组,第一个字节存放字符串长度,后面跟着实际字符。
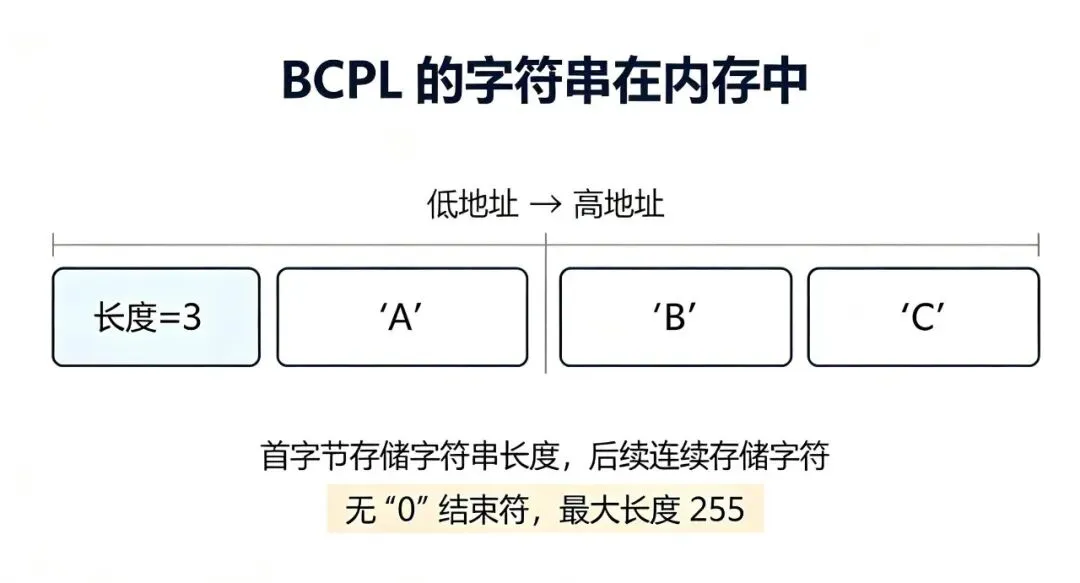
BCPL、B、C都没有在语言层面强烈支持字符数据,都只是把字符串当作整数向量,加上一些约定来补充通用规则。
3.2 B语言:Ken Thompson的“偷懒”与突破
Ken Thompson在PDP-7上开发B语言时,内存极其有限——只有约18KB。1969-1970年间,他做了一项关键改动:去掉了BCPL的长度字节,改用特殊字符*e(值为0)作为字符串终止符。
为什么改?
第一,避免长度上限。BCPL用一个字节存长度,字符串最长255个字符。在B语言中,字符串长度不再受限。
第二,维护终止符比维护长度更方便。Ritchie后来回忆说:“根据我们的经验,维护计数不如使用终止符方便。”用长度前缀的话,每次拼接、截断字符串都要手动更新长度字段,非常容易出错。
第三,终止符方案更简洁。字符串的结束标志本身就是数据的一部分,不需要额外的管理逻辑。遍历字符串时,只需检查是否遇到*e即可。
顺带一提,BCPL的长度前缀方案并没有“浪费”空间——它同样只占1个字节。B语言改用终止符,主要动机是灵活性和便利性,而非节省内存。
3.3 C语言:继承B的约定,把*e换成\0
Dennis Ritchie改进B语言成为C语言时,延续了B的终止字符约定,只是把*e换成了\0(值为0的空字符)。
Ritchie为什么坚持用空字符终止?
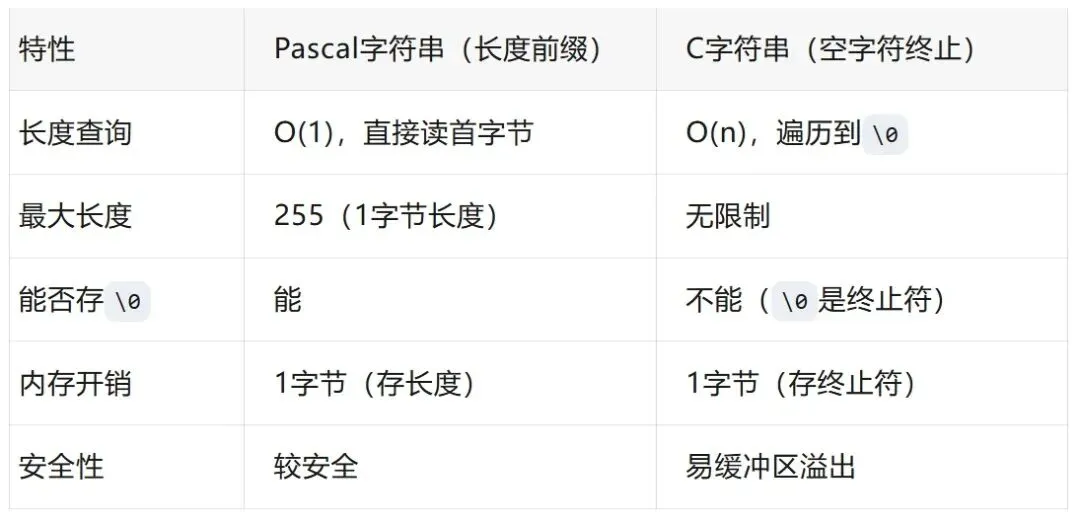
据Ritchie本人回忆,他选择空字符终止是为了避免限制字符串的最大长度,而且在他看来,维护计数不如使用终止符方便。当时也存在另一种方案——Pascal风格的长度前缀字符串(用一个字节存长度),但长度被限制在255个字符。
Pascal字符串 vs C字符串:
FreeBSD内核开发者Poul-Henning Kamp后来将C语言空字符终止字符串称为“史上最昂贵的单字节错误”。但在1970年代,这个设计是合理的选择。
四、为什么C语言没有专门的string类型?
因为C语言的设计哲学是“信任程序员,贴近硬件”。
在C语言中,数组名本质上是指向首元素的指针,数组在函数参数传递时会退化为指针。如果引入一个专门的string类型,就必须在语言层面增加额外的抽象层,这与C语言“提供底层访问”的理念相悖。
C语言不提供string类型,而是提供了一种约定:用char数组存储字符序列,用\0标记结尾。任何遵守这个约定的内存区域,都可以被字符串处理函数操作。
C语言的字符串不是一个“东西”,而是一种“规则”。
五、为什么C语言提供了strlen()等标准库函数?
既然字符串只是字符数组,程序员完全可以自己写循环遍历数组计算长度、复制内容。那为什么C标准库还要提供strlen()、strcpy()、strcmp()等函数?
第一,因为字符串操作太常见了。 每个程序员都要反复写同样的循环代码——遍历到\0、复制直到\0、比较直到差异或\0。把这些操作封装成标准函数,是提高效率的必然选择。
第二,标准库函数经过了优化。 你自己写的strlen可能逐字节比较,而标准库可能用更高效的算法(如一次检查多个字节)。
第三,可移植性。 不同平台的字长、对齐要求不同,标准库的实现会针对平台优化。
第四,历史原因。 K&R在设计UNIX时,这些字符串操作函数就已经在用了。后来ANSI C将它们标准化,收录在<string.h>头文件中。
strlen()不是“字符串类型的成员函数”,而是“对字符数组进行操作的通用工具函数”。 这正是C语言的设计思路——类型简单,函数通用。
六、面试常考的字符串知识点
6.1 核心概念类
① 字符串的结束标志是'\0',不是'0'
char s1[] = "hello"; // 6个字节(5个字符 + '\0')char s2[] = {'h','e','l','l','o'};// 5个字节,无'\0',不是字符串
② sizeof vs strlen
sizeof | strlen | |
|---|---|---|
\0) | ||
char arr[] = "hello";sizeof(arr); // 6strlen(arr); // 5
③ 字符数组与字符串常量的区别
char arr[] | const char *p | |
|---|---|---|
6.2 转义字符类
转义字符算1个字符,不是多个
strlen("c:\test\121"); // 7// '\t'是1个字符,'\121'是1个字符(八进制转义,ASCII码81)
常见转义字符:\n、\t、\b、\r、\\、\'、\"、\0、\ddd(八进制)、\xhh(十六进制)。
6.3 字符串常量 vs 字符数组
const char *p = "hello"; // p指向只读数据区,不能修改(推荐写法)char arr[] = "hello"; // arr在栈上,可以修改// p[0] = 'H'; // ❌ 编译错误!const 禁止修改arr[0] = 'H'; // ✅ 正确
6.4 常见笔试题型
题型1:字符串结束标志
字符串的结束标志是:( )A. '0' B. EOF C. '\0' D. 空格答案:C
题型2:转义字符计数
strlen("abc\0def"); // 3strlen("abc\x0aef"); // 6(\x0a是换行符,1个字符)
题型3:字符串常量修改(找错题)
voidtest() {const char *str = "hello";str[0] = 'H'; // 编译错误!const 禁止修改printf("%s", str);}
题型4:手写字符串函数
// 手写strlenintmy_strlen(constchar *s){int len = 0;while (*s++) len++;return len;}// 手写strcpychar* my_strcpy(char *dest, constchar *src){char *p = dest;while ((*p++ = *src++) != '\0');return dest;}
七、一张图总结
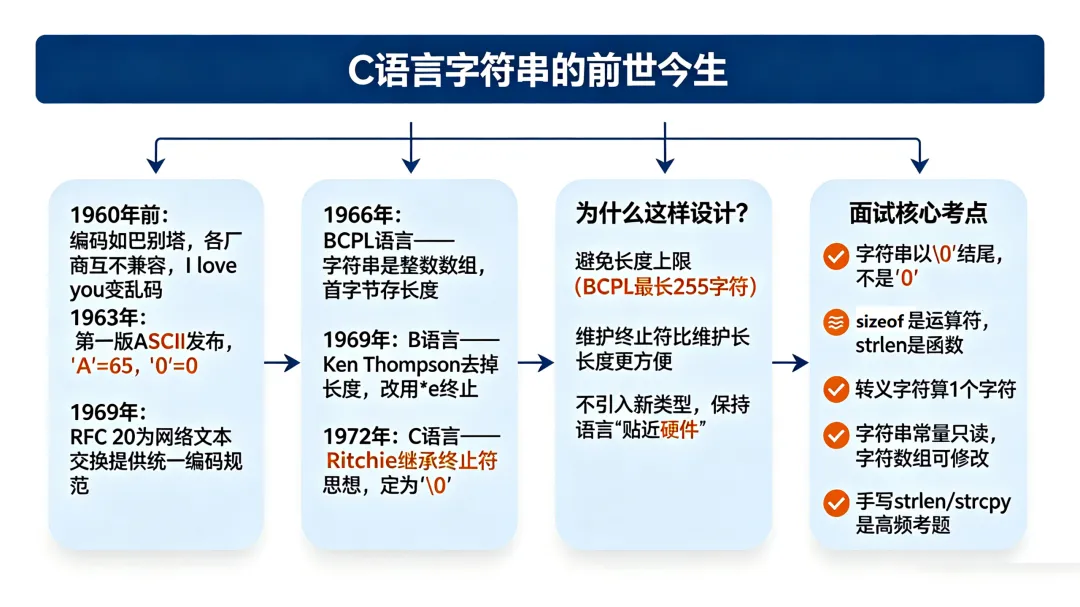
写在最后
回到开篇那道题:
char str1[] = "abc"; // 4字节:a b c \0char str2[] = {'a', 'b', 'c'}; // 3字节:a b c(无\0)sizeof(str1) = 4, sizeof(str2) = 3strlen(str1) = 3, strlen(str2) = 随机值
为什么?
因为C语言的字符串从来不是一种“类型”,而是一种“约定”——用\0标记字符串的结束。这个约定始于ASCII中的空字符(值为0),经过BCPL的长度前缀、B语言的*e终止符,最终在C语言中定型为\0。
这个设计在当时是合理的:避免长度上限、维护方便、保持语言简洁。它成就了C语言的简洁和高效,也埋下了缓冲区溢出等安全隐患的种子。
记住一句话:
在C语言中,字符串不是一个“东西”,而是一种“规则”——以
\0结尾的字符数组就是字符串。字符就是数字,字符串就是带
\0的数组,'A'+32就是'a'。
🎁 彩蛋:码农的专属表白密码
在C语言里,字符就是数字。所以,当你想对暗恋的程序员表白时,不必说“我爱你”,只要发一串数字:
53 50 48懂C语言的人会心一笑——因为'5'的 ASCII 是 53,'2'是 50,'0'是 48。连起来,就是"520"。
这大概是最符合程序员气质的浪漫了:用数字编码心意,用ASCII传递感情。
所以,下次有人给你发 53 50 48,别以为他在报错误码——他是在说“我爱你”。
关于作者:某公司嵌入式底软面试官,根据近期招聘应届生的C语言笔试反馈,总结一些 共性的问题,分享一下。回想自己刚毕业的时候,也是一样搞不清楚,逐步啃《C缺陷与陷阱》、《C专家编程》 等C语言经典书籍,才逐步入门。。。因此,花点时间写个笔记,抛砖引玉,希望让有需要的人少点弯路。不够严谨的地方也欢迎留言指正。