ARTICLE · 1023842
200张发票还在手工录Excel?这个本地工具,识别后先复核再做台账
导语:月底发票一多,最耗时间的往往不是做账,而是把同样的字段从发票反复抄进Excel。这次不聊“AI有多强”,只看一个更实际的问题:能不能先让机器把发票字段读出来,人只负责复核关键项。
发票多的时候,最烦的不是“看”,而是“抄”
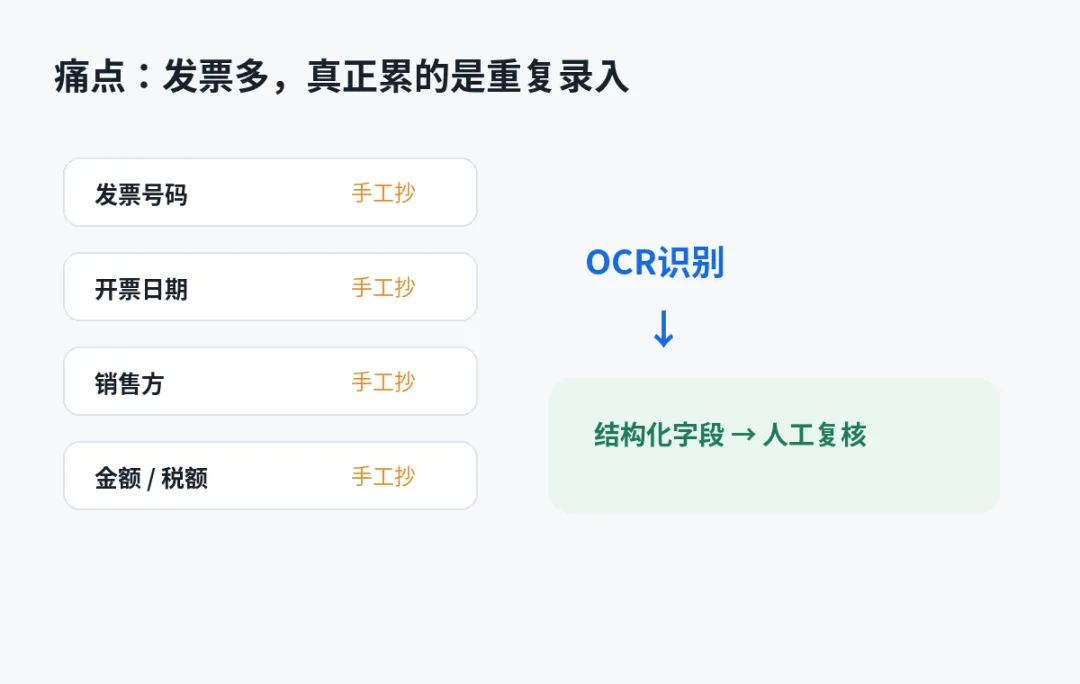
月底对账时,桌面上可能同时放着PDF电子发票、扫描件和手机拍照。真正消耗时间的,往往是把发票号码、开票日期、购买方、销售方、金额、税额、价税合计一项项录进Excel。
一两张没感觉,几十张、上百张以后,重复录入就会变成机械劳动。更麻烦的是,金额和号码一旦抄错,后面做报销、付款核对或台账汇总时还要重新返工。
这次找的办法不是让AI直接替财务“做账”,而是把最机械的一步先拿掉:让OCR先提取字段,再把有冲突的地方交给人复核。
这套方案能做什么?先说公开能力
我核验的是开源项目 Invoice Manager。它面向中文增值税发票,公开说明支持PDF、JPG、PNG批量上传,使用 PaddleOCR 提取字段,并可选接入视觉大模型做第二路识别。
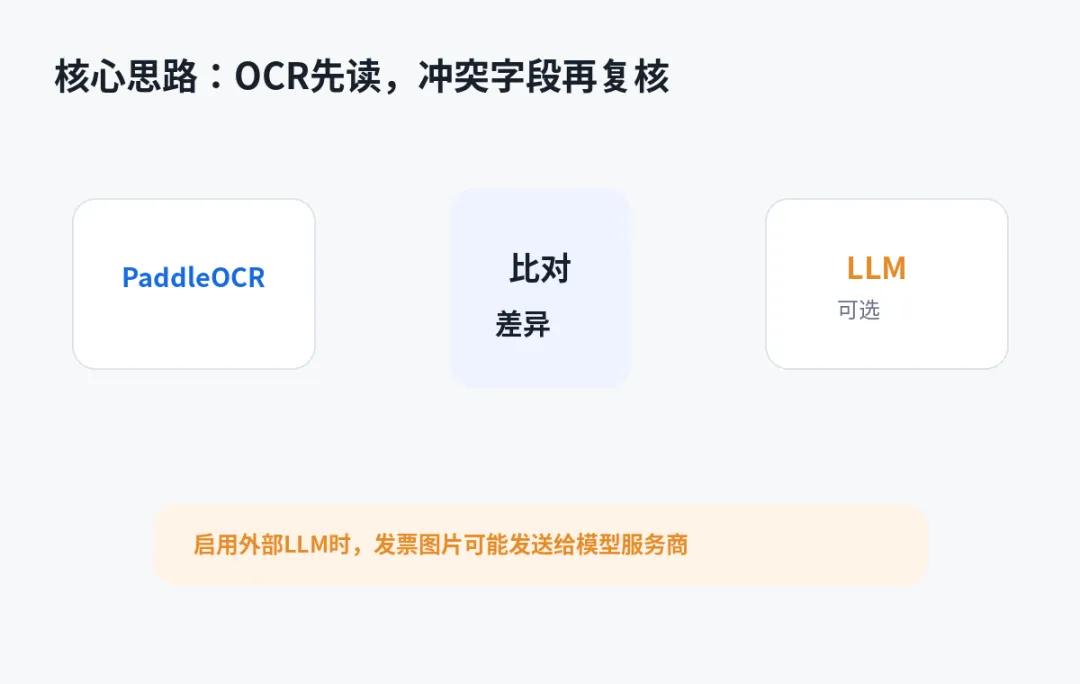
项目当前公开字段包括发票号码、开票日期、项目名称、购买方名称和税号、销售方名称和税号、金额、税率、税额、价税合计等。OCR与LLM结果不一致时,界面会把冲突字段标出来,交给人工选择或修改。
截至2026年9月16日核验,项目README标注当前版本为 v0.3.0,最近一次发布日期写为2026年1月24日,采用 MIT License。本文没有在真实企业账务环境中跑完整流程,因此这里只写公开能力,不把它包装成实测效果。
为什么我更认可“先识别,再复核”
财务数据最怕两件事:第一是人工抄错,第二是自动化以后没人检查。
单纯OCR确实可以减少录入,但发票图片模糊、方向不正、印章遮挡、版式变化,都可能让某个字段识别错误。项目的思路是让OCR和可选的LLM分别识别,再把不一致的字段单独标出来。
这样真正省掉的是“每个字段都从头手工输入”的时间,而不是取消财务人员的判断。对于金额、税额、发票号码这类关键字段,更建议保留人工确认。
如果要落地,我会先跑这4步
第一步,准备10—20张脱敏样票,最好包含电子PDF、扫描件和手机照片,不要一开始就把真实公司的全部发票丢进去。
第二步,只看几个关键字段:发票号码、日期、销售方、金额、税额、价税合计。先统计哪些字段稳定,哪些字段最容易出错。
第三步,把冲突字段人工复核一遍,再与原票抽查。只有这一步稳定,才值得扩大样本量。
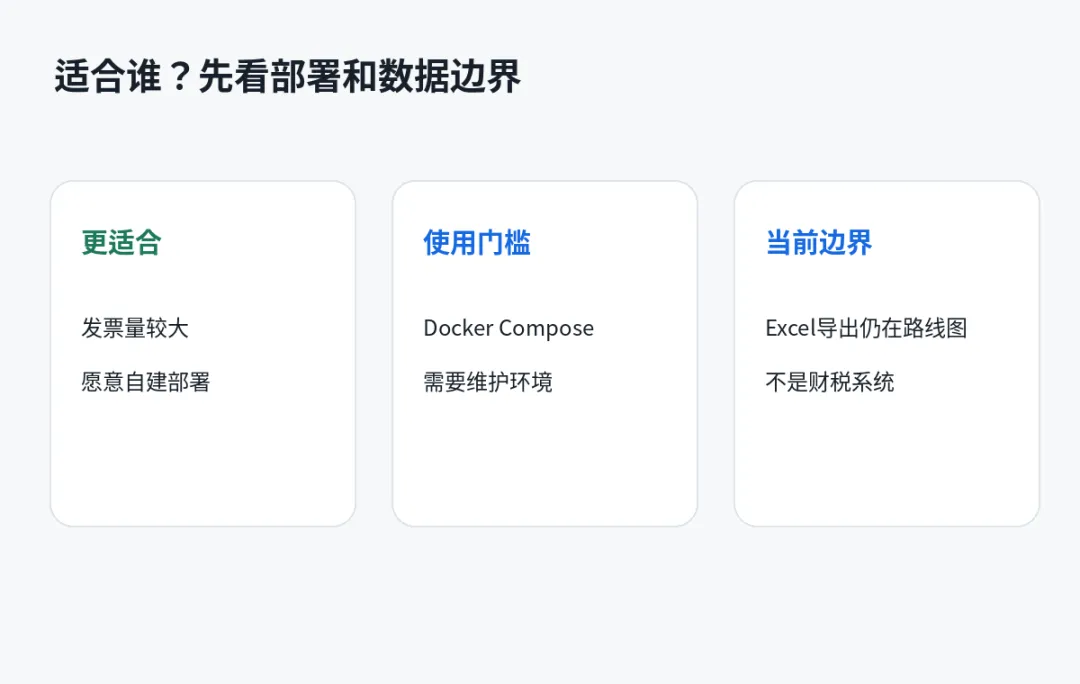
第四步,再考虑台账输出和后续对账。当前项目路线图把“报表导出(Excel/PDF)”列在后续 v0.4 计划中,所以不要把“发票管理”理解成现在已经能一键生成完整Excel台账。若核心需求就是Excel导出,需要二次开发或等待后续版本。
本地部署,不等于任何情况下都不出网
项目支持 Docker Compose 自建,README说明即使不配置LLM,也可以只使用 PaddleOCR。对重视数据控制的小企业,这是它比较有吸引力的地方。
但“本地部署”不能简单理解成“所有数据永远不离开电脑”。项目FAQ明确说明:如果配置外部LLM,发票图片会发送给相应模型服务商。因此涉及真实发票、税号、交易金额等数据时,要先确认公司的数据合规要求。
如果只是内部验证,更建议先从纯OCR模式开始。确认本地识别能解决多少问题,再决定是否有必要启用外部模型。
适合谁?不适合谁?
更适合:每月发票数量较多、重复录入明显、愿意做本地部署,而且能安排人工复核的小团队。
不太适合:只偶尔处理几张发票、没有人维护Docker环境,或者希望下载一个Windows EXE就马上使用的用户。
它也不是财务软件,更不能替代正式的会计核算、税务查验和企业审批流程。更现实的定位,是把它当成“发票信息采集层”:先把纸面或PDF里的字段变成结构化数据,再交给后面的台账、对账和财务流程。
能让工具干的,就别自己加班。