ARTICLE · 1024027
为什么90%的"AI运维助手",最后都变成了一个高级搜索框?
凌晨的2:17,你的手机震动了。
打开一看:427条告警,横跨8个服务,CPU在98%,订单接口延迟从120ms飙到5.6秒。
你打开刚上线三个月的"AI运维助手",输入:
“"数据库连接异常怎么办?"
系统很快给出一段标准答案:
“"数据库连接异常通常由以下原因引起:1.连接池配置不当 2.网络问题 3.权限问题 4.数据库负载过高……建议检查连接池参数、网络连通性……"
你盯着这段话看了三秒。
然后关掉窗口,继续手动翻日志、查监控、拉会议,用了40分钟才发现:根因是某个Redis节点网络抖动。
问题出在哪?
AI回答得很"正确",但它根本不知道此刻你的生产环境正在发生什么。
一、企业最开始都是这么想的
去年开始,大量企业启动了"AI+运维"项目。
典型路径是:
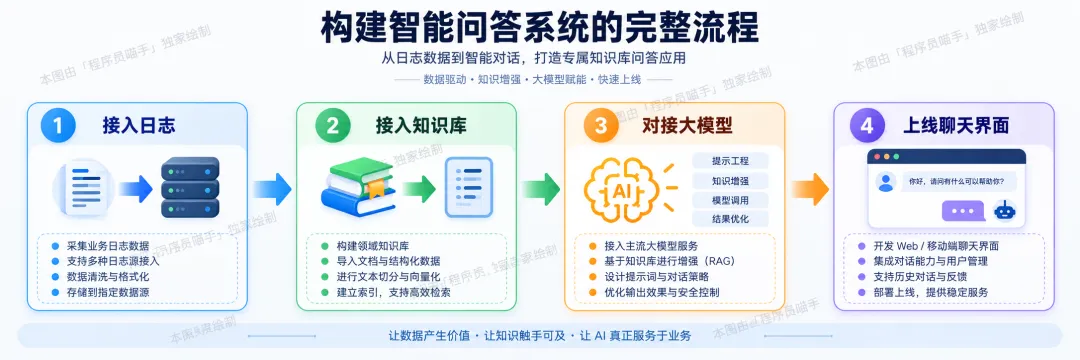
然后在内部宣传:
“"我们的AI助手可以回答所有运维问题。"
初期测试确实很惊艳。
问:Redis连接超时怎么排查?
答:检查网络、连接池、实例负载、慢查询……
问:Pod一直Pending怎么办?
答:查看节点资源、PVC状态、调度策略……
看起来什么都懂。
领导很满意,测试通过,正式上线。
然后真正的故障来了。
凌晨3点,核心交易系统出现大面积超时。
运维工程师问AI:
“"现在系统有什么问题?"
AI回答:
“"请描述具体现象,我可以帮你分析可能原因。"
工程师又问:
“"订单服务为什么这么慢?"
AI回答:
“"订单服务变慢可能由以下原因导致:数据库慢查询、下游服务超时、JVM GC频繁、网络延迟增加、缓存失效……"
这和搜索引擎有什么区别?
此时此刻,生产环境中:
1376条告警正在产生 订单服务P99延迟已经到8.2秒 Redis节点网络RT从1ms突变到120ms 支付服务开始出现连接池耗尽 数据库连接数正在逼近上限
但AI一条都不知道。
它只能基于你输入的文字,给出通用知识库里的标准答案。
二、Chatbot和Agent,差在哪里?
表面上看,两者都在"对话"。
但本质完全不同。
Chatbot的工作方式:
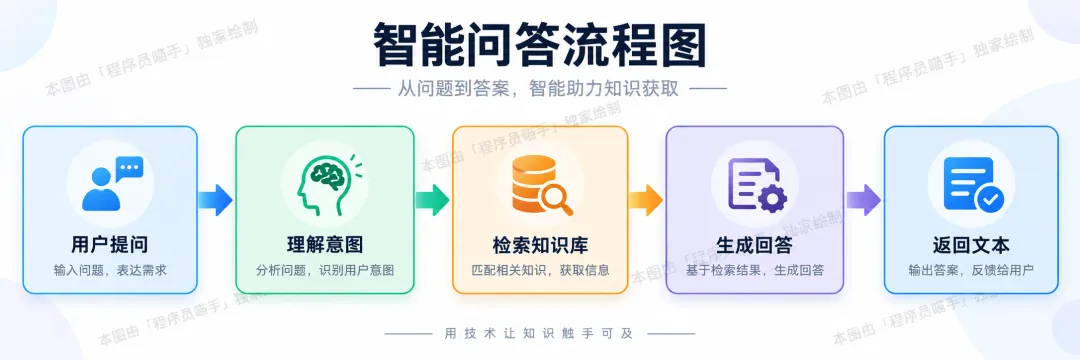
它回答问题。
Agent的工作方式:
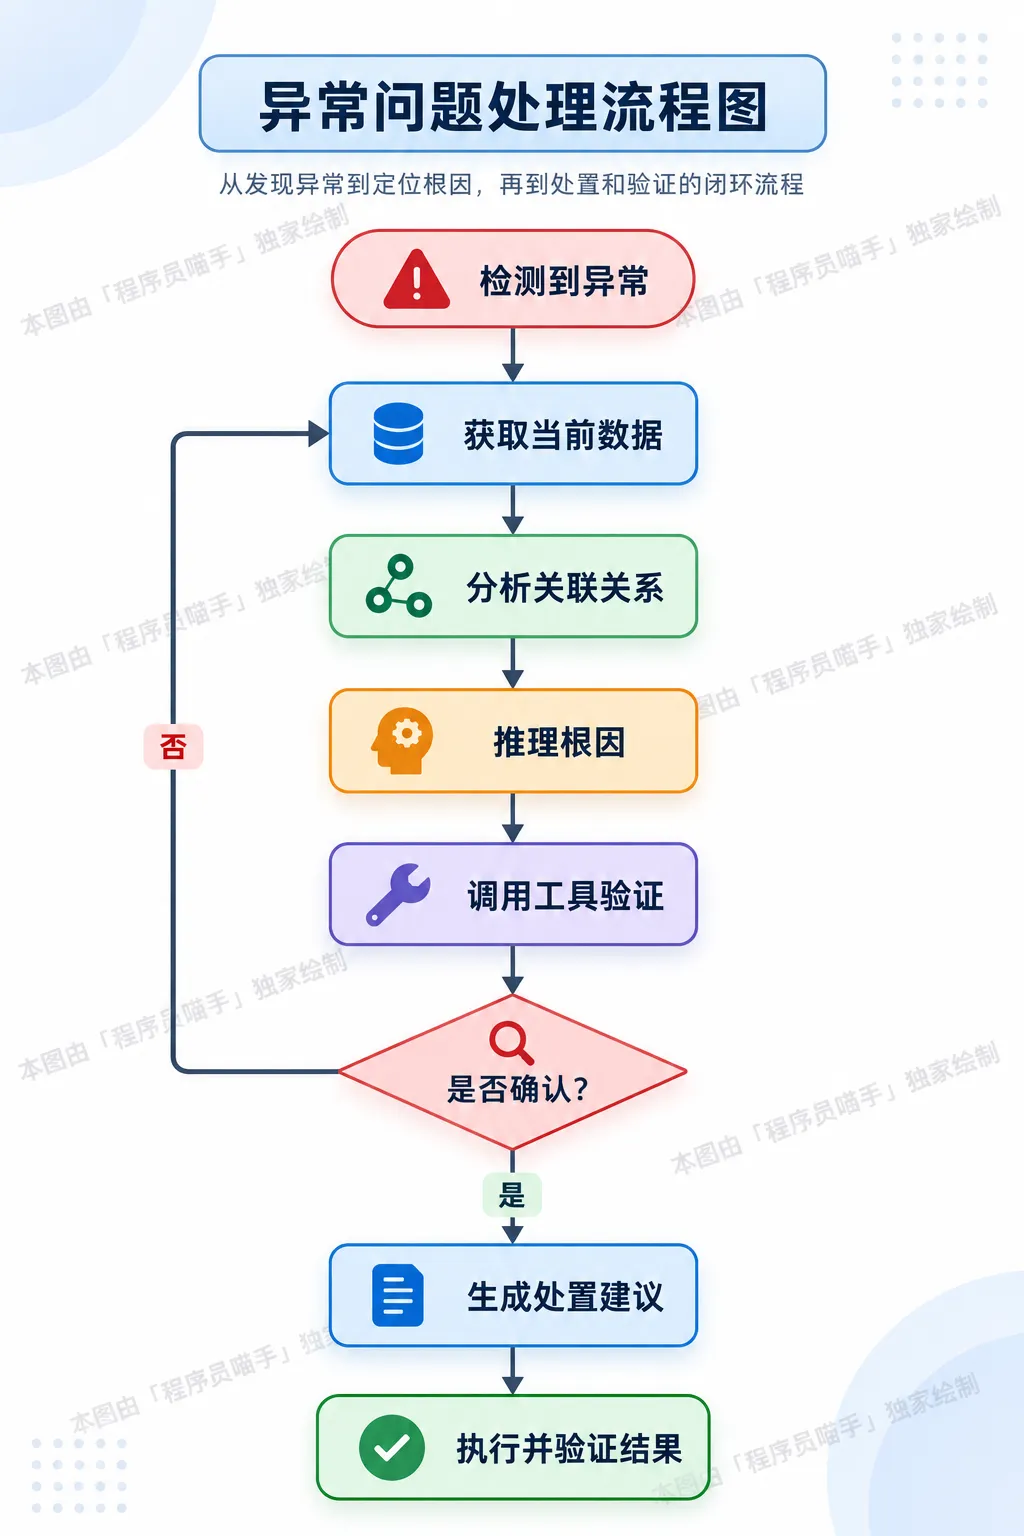
它解决问题。
举个真实对比:
场景:订单服务延迟突增
Chatbot模式:
运维:订单服务延迟很高怎么办?
AI:可能是数据库慢、缓存失效、网络问题……建议检查慢查询日志、Redis命中率、网络延迟。
运维:(关掉对话框,继续手动排查)
Agent模式:
系统自动检测到订单服务P99延迟异常
→ 获取订单服务最近5分钟的调用链数据
→ 发现90%的慢请求都卡在Redis调用
→ 分析Redis集群指标,发现节点B网络延迟异常
→ 查询CMDB,确认节点B所在物理机
→ 调用监控API,发现该物理机网络丢包率0.3%
→ 关联历史事件,3个月前该机器出现过类似问题
→ 输出结论:
“根因:Redis节点B网络抖动(置信度89%)
影响范围:订单服务、支付服务、用户中心
建议操作:将该Redis节点流量切换至备节点,联系网络团队检查物理机网络
核心差异:
Chatbot在等你描述现场。
Agent在理解现场。
三、我们模拟一次真实生产故障
假设一个典型的微服务生产环境:
30+微服务、200+Pod、10+Redis实例、5个MySQL集群。
2:17:23
订单服务P99延迟从180ms升高到4.2s,触发第一条告警。
2:18:15
应用日志开始出现大量:
RedisTimeoutException: command timed out after 1000ms2:18:47
支付服务、库存服务相继产生超时告警。
2:19:30
数据库连接池告警:active connections 95/100
2:20:00
监控平台已产生1376条告警。
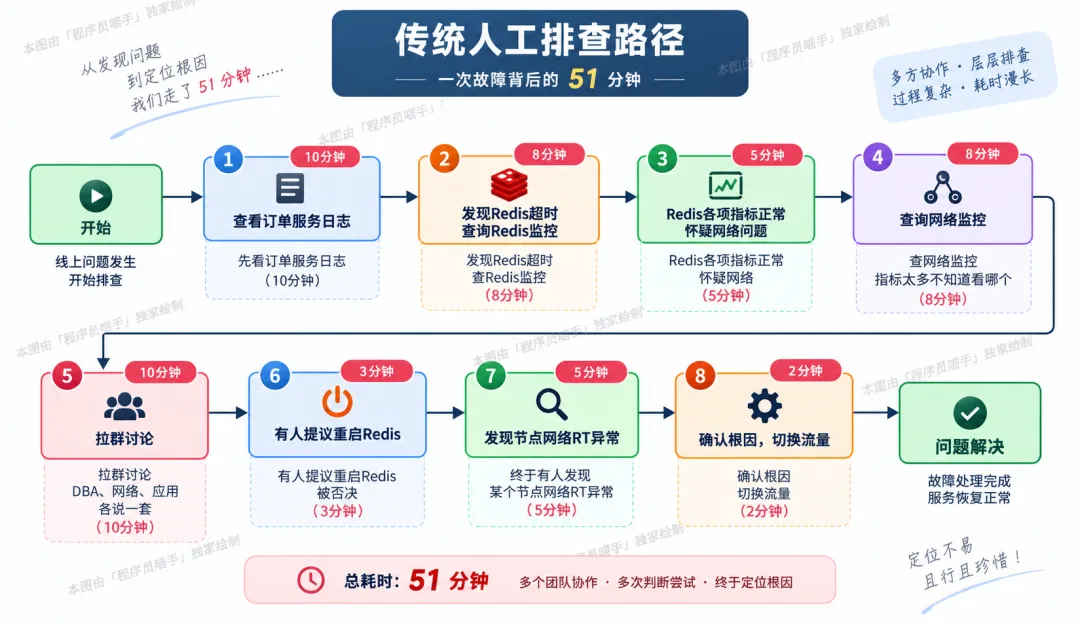
传统人工排查路径:
先看订单服务日志(10分钟) 发现Redis超时,查Redis监控(8分钟) Redis各项指标正常,怀疑网络(5分钟) 查网络监控,指标太多不知道看哪个(8分钟) 拉群讨论,DBA、网络、应用各说一套(10分钟) 有人提议重启Redis,被否决(3分钟) 终于有人发现某个节点网络RT异常(5分钟) 确认根因,切换流量(2分钟)
总耗时:51分钟
AI Agent处理路径:
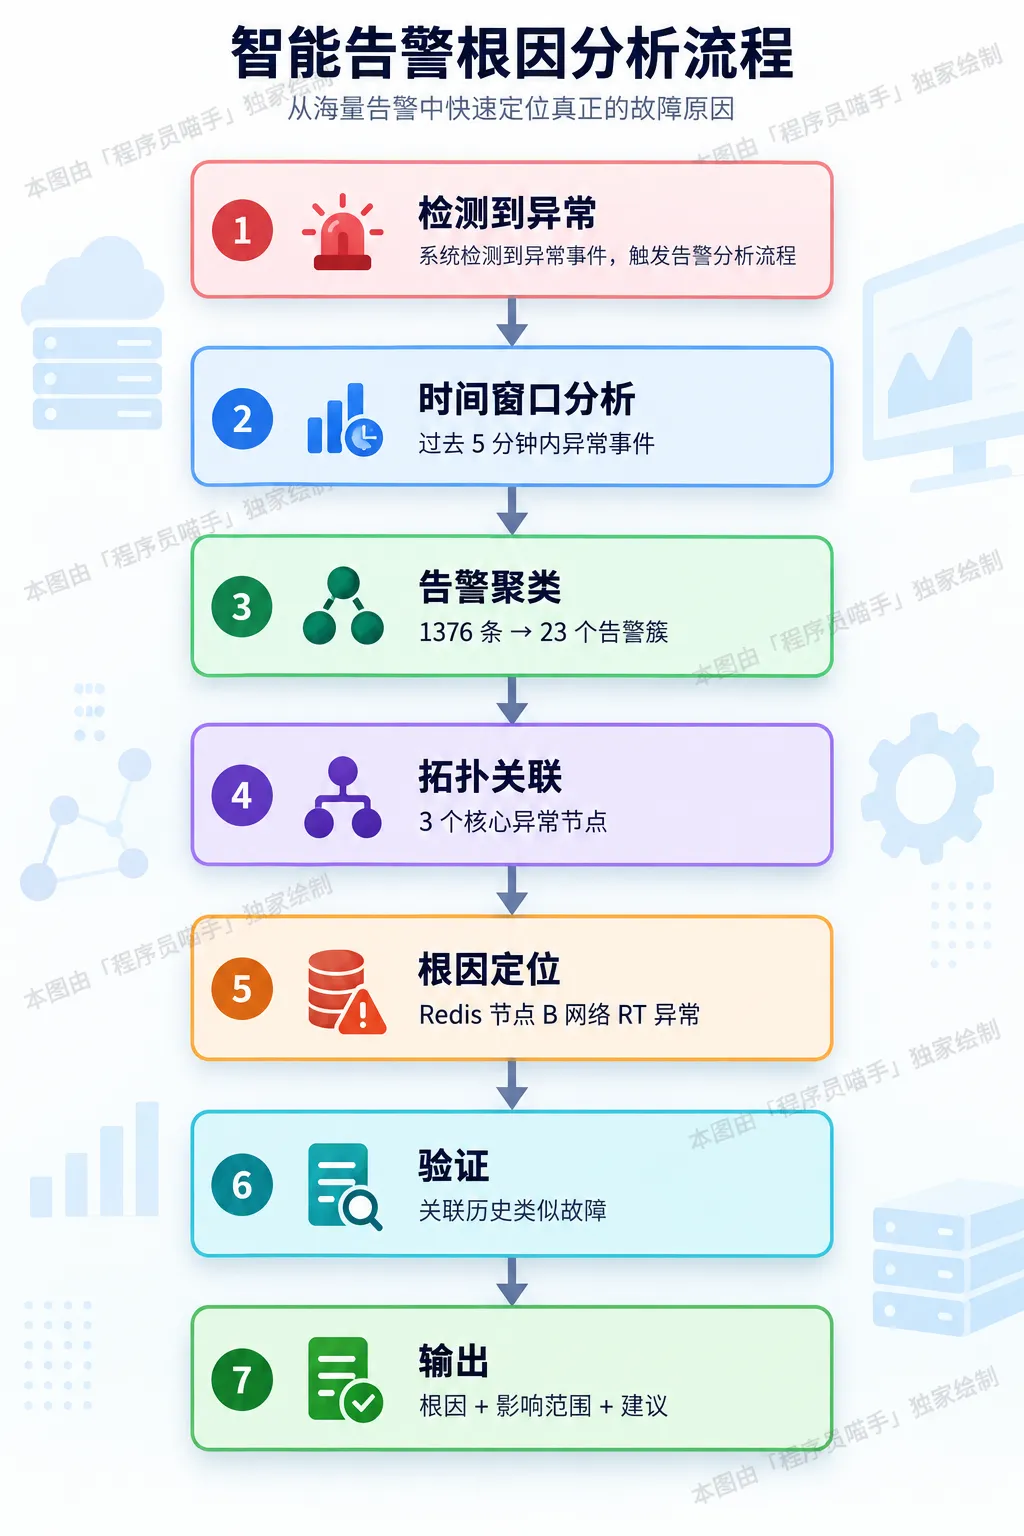
系统在2分30秒内完成:
1. 数据获取
1376条告警 8个异常服务的调用链 Redis集群所有节点指标 网络层监控数据 服务依赖拓扑
2. 分析聚类
将1376条告警压缩为23个告警簇:
订单服务超时(584条) 支付服务超时(327条) Redis连接异常(241条) ……
3. 根因推理
按时间序列还原:
2:17:18 Redis节点B网络RT: 1ms → 120ms ← 最早异常2:17:23 订单服务延迟开始上升2:18:15 Redis超时异常大量出现2:18:47 下游服务开始受影响结论:Redis节点B是根因,其他都是级联影响。
4. 置信度计算
时间序列吻合:95% 拓扑关系吻合:100% 历史相似度:82%
综合置信度:89%
5. 输出建议
“根因:Redis集群节点B(10.23.45.67)网络延迟异常
首次异常时间:02:17:18
影响服务:订单服务、支付服务、用户中心、库存服务
建议操作:
立即将节点B流量切换至备节点(预计恢复时间30秒) 联系网络团队检查物理机网卡及交换机端口 本次故障与3个月前#INC-2847类似,建议同步处理 风险提示:当前数据库连接池已使用95%,如不尽快恢复,可能触发连接池耗尽
总耗时:2分30秒 + 人工决策和执行3分钟 = 约6分钟
MTTR从51分钟降到6分钟。
四、很多人理解错了一个问题
大部分企业在建设"AI运维"时,会不自觉地把重点放在:
"模型够不够聪明?"
所以不断测试:
GPT-4还是Claude? prompt怎么优化? RAG效果怎么样?
但其实,AI运维真正的分水岭,不是模型有多聪明,而是它能不能理解"此刻的生产环境"。
一个能实时获取:
当前拓扑 当前告警 当前指标 当前日志 当前变更 当前调用链
的"普通模型",比一个只能检索知识库的"超级模型"有用得多。
换句话说:
“一个知道"现在Redis节点B网络RT是120ms"的3.5模型,
胜过一个只知道"Redis可能会超时"的4.0模型。
这就是为什么OpenTelemetry在2024年开始重点推进:
LLM调用的可观测性 Agent行为的可观测性 工具调用的标准化追踪
因为Agent的能力,本质上取决于它能"看到"多少实时上下文。
五、真正的运维Agent需要哪些能力?
如果要构建一个真正能解决生产问题的AI Agent,至少需要:
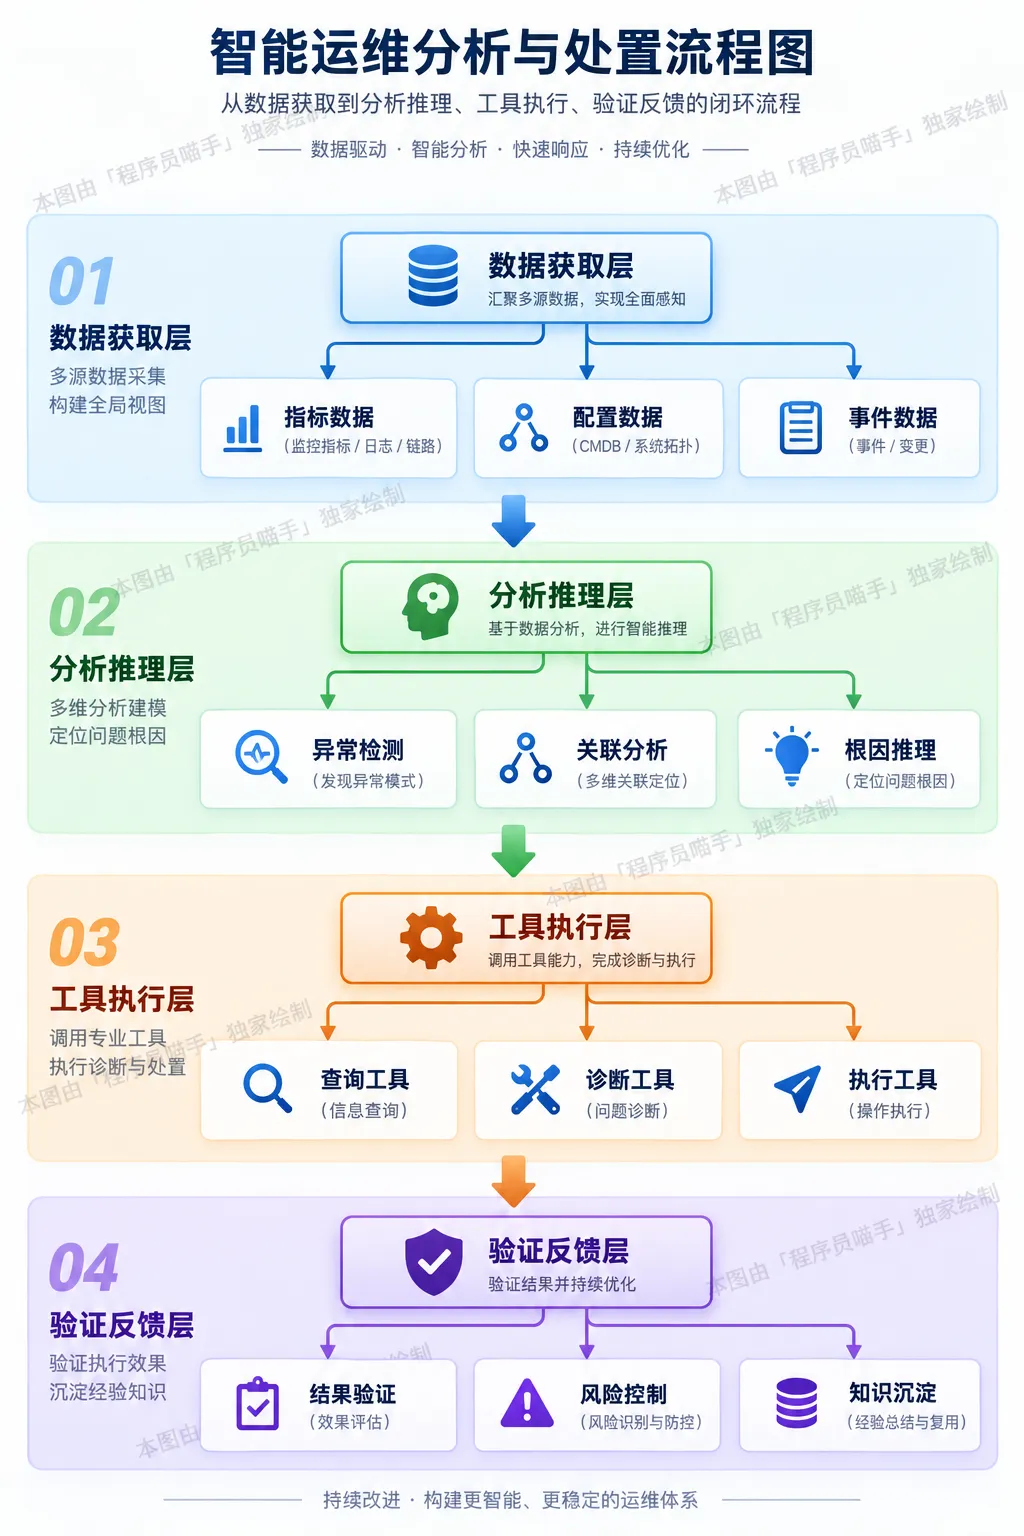
1. 数据获取能力
不是"能读日志"就够了。
需要:
实时指标(CPU、内存、网络、业务指标) 结构化日志(不只是原始文本,要有字段、级别、traceID) 分布式追踪(调用链、依赖关系) 变更事件(发布、扩缩容、配置变更) 资源拓扑(服务依赖、Pod所在节点、数据库主从关系) 历史故障(相似问题、处理方式、有效操作)
2. 关联分析能力
能够:
将告警按时间、拓扑、根因聚类 识别哪些异常属于同一事件 还原异常传播路径 过滤掉级联噪音
3. 根因推理能力
基于:
时间序列(谁先发生) 因果关系(谁影响谁) 历史经验(以前怎么处理的) 专家规则(某些组合一定意味着什么)
给出根因候选列表和置信度。
4. 工具调用能力
Agent不能只"建议"。
需要真正能:
查询Prometheus 检索Elasticsearch 调用Jaeger获取trace 查询CMDB 执行诊断命令(top、netstat、curl) 甚至在授权情况下执行修复(重启Pod、切流量、回滚配置)
5. 风险控制能力
自动化程度越高,风险越大。
必须有:
操作前置校验(当前是否有变更窗口?) 影响范围评估(会影响多少用户?) 回滚预案(如果操作失败怎么办?) 人工决策点(哪些操作必须人确认?)
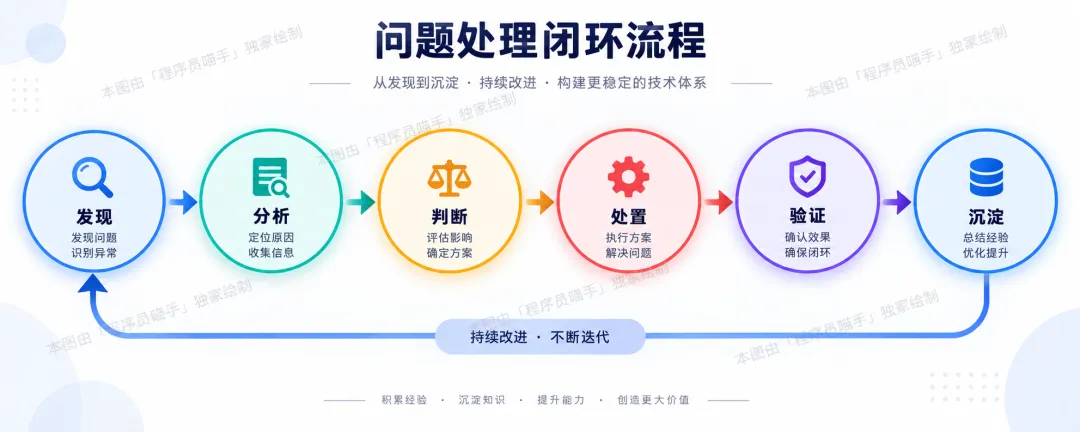
6. 结果验证和沉淀
执行完操作后:
验证指标是否恢复 确认告警是否消除 记录有效操作 更新知识库
形成完整闭环:
六、企业应该怎么落地?
不要一上来就想"我们要不要做AIOps"。
而应该问:
"我们最想解决哪个运维问题?"
第一步:选一个具体场景
不要贪大求全。
从一个痛点最明显的场景开始:
告警风暴? → 先做告警聚类和根因分析 日志分析慢? → 先做日志异常检测和关键信息提取 故障定位依赖专家? → 先做故障诊断和相似案例匹配 重复操作太多? → 先做常见操作自动化
选好一个场景,做深做透。
第二步:盘点数据基础
AI的能力取决于数据质量。
问自己:
如果数据质量不行,先治理,再智能。
第三步:设计最小闭环
不要一开始就做"全自动"。
先做"辅助决策":
阶段1:信息聚合
AI帮你把分散的数据汇总到一起。
原来要开5个页面,现在一个界面看全。
阶段2:异常识别
AI帮你标出哪些是异常,哪些需要关注。
原来1000条告警不知道看哪个,现在直接看Top3。
阶段3:根因推荐
AI给出3个最可能的根因候选。
人做最终判断。
阶段4:操作建议
AI推荐处理步骤。
人决定是否执行。
阶段5:辅助执行
AI可以执行低风险操作(查日志、重启测试环境Pod)。
高风险操作仍需人工确认。
阶段6:自主修复
在严格风险控制下,部分场景可自动执行。
但必须有完整审计和回滚机制。
第四步:建立验证机制
上线后,必须回答:
准确率: AI给出的根因,有多少次是对的? 召回率: 实际发生的故障,AI能发现多少? MTTR: 平均故障恢复时间是否下降? 误报率: AI产生了多少错误告警? 人工介入率: 多少情况下仍需人工接管?
如果这些指标没有改善,项目就需要调整。
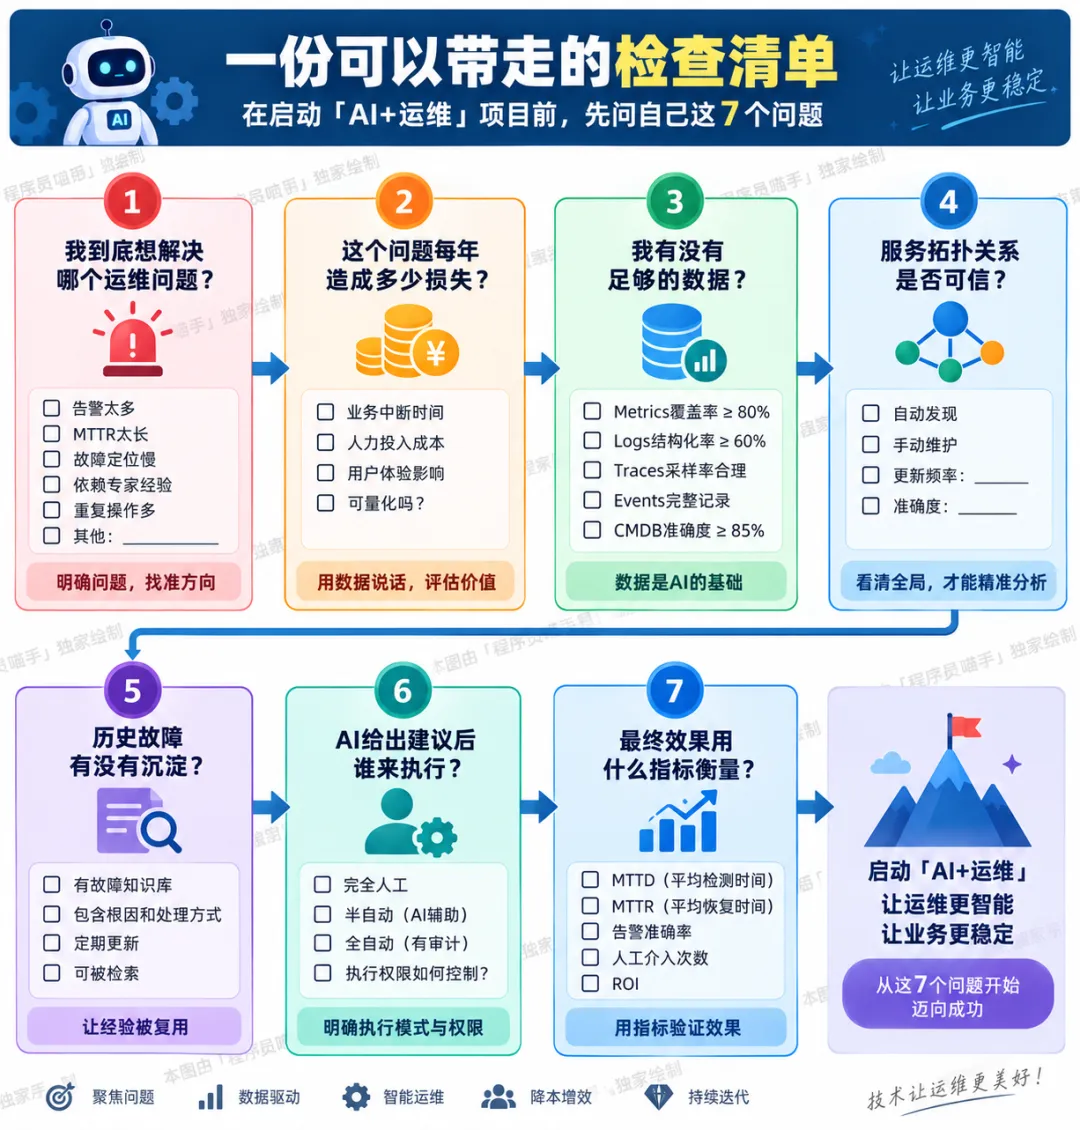
七、一份可以带走的检查清单
在启动"AI+运维"项目前,先问自己这7个问题:
✓ 1. 我到底想解决哪个运维问题?
[ ] 告警太多 [ ] MTTR太长 [ ] 故障定位慢 [ ] 依赖专家经验 [ ] 重复操作多 [ ] 其他:________
✓ 2. 这个问题每年造成多少损失?
[ ] 业务中断时间 [ ] 人力投入成本 [ ] 用户体验影响 [ ] 可量化吗?
✓ 3. 我有没有足够的数据?
[ ] Metrics覆盖率 ≥ 80% [ ] Logs结构化率 ≥ 60% [ ] Traces采样率合理 [ ] Events完整记录 [ ] CMDB准确度 ≥ 85%
✓ 4. 服务拓扑关系是否可信?
[ ] 自动发现 [ ] 手动维护 [ ] 更新频率:_____ [ ] 准确度:_____
✓ 5. 历史故障有没有沉淀?
[ ] 有故障知识库 [ ] 包含根因和处理方式 [ ] 定期更新 [ ] 可被检索
✓ 6. AI给出建议后谁来执行?
[ ] 完全人工 [ ] 半自动(AI辅助) [ ] 全自动(有审计) [ ] 执行权限如何控制?
✓ 7. 最终效果用什么指标衡量?
[ ] MTTD(平均检测时间) [ ] MTTR(平均恢复时间) [ ] 告警准确率 [ ] 人工介入次数 [ ] ROI
如果7个问题中有3个以上答不上来,建议先暂停,把基础打牢。
如下为图汇版,方便大家保存查阅:
最后
AIOps真正有价值的地方,并不是让机器替代运维,而是把原本需要人花大量时间寻找、关联和验证的信息,提前组织好。
它让"从1376条告警中找到根因"这件事,从51分钟变成6分钟。
但前提是:
AI能够理解"此刻的生产环境"。
否则,它就只是一个高级搜索框。
能回答"Redis超时怎么办",却回答不了"我的Redis现在为什么超时"。
现在轮到你了。
最后一个问题,想听听你们的真实情况:
欢迎在评论区留下你的答案,以及你最头疼的运维问题。

文章读完后,你的点赞、分享、推荐,我们都深表感谢!
欢迎点击下方公众号卡片,关注我们,一起进步!

THANKS FOR READING
关注最真实现场,也关注每一次解决问题的方法