ARTICLE · 1024247
腾讯开源 WeKnora:把一堆 PDF 扔给 AI,自动整理出会推理的知识库,一周 1.8K Star
腾讯开源 WeKnora:把一堆 PDF 扔给 AI,自动整理出会推理的知识库,一周 1.8K Star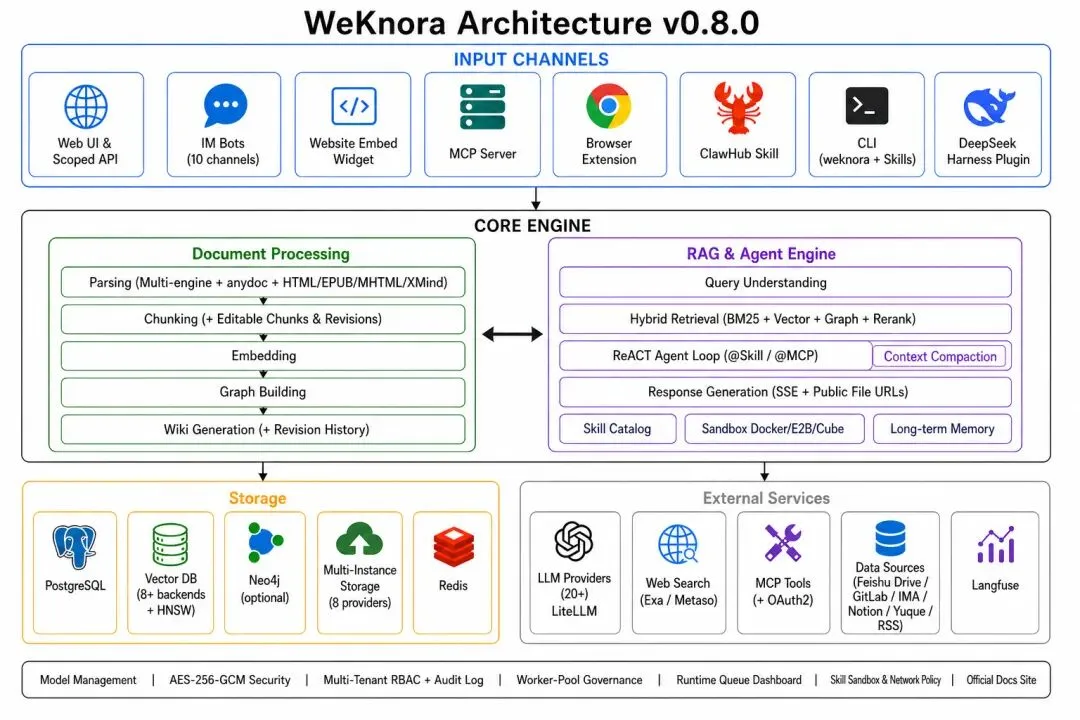
一堆散落在硬盘、飞书、Notion 里的文档,怎么才能让 AI 不仅能查,还能自己整理成一份会持续更新的 Wiki?腾讯开源的 WeKnora 给了一个答案:扔进去 PDF/Word,出来的是可查询、可推理、还能自我维护的知识库。
它是什么
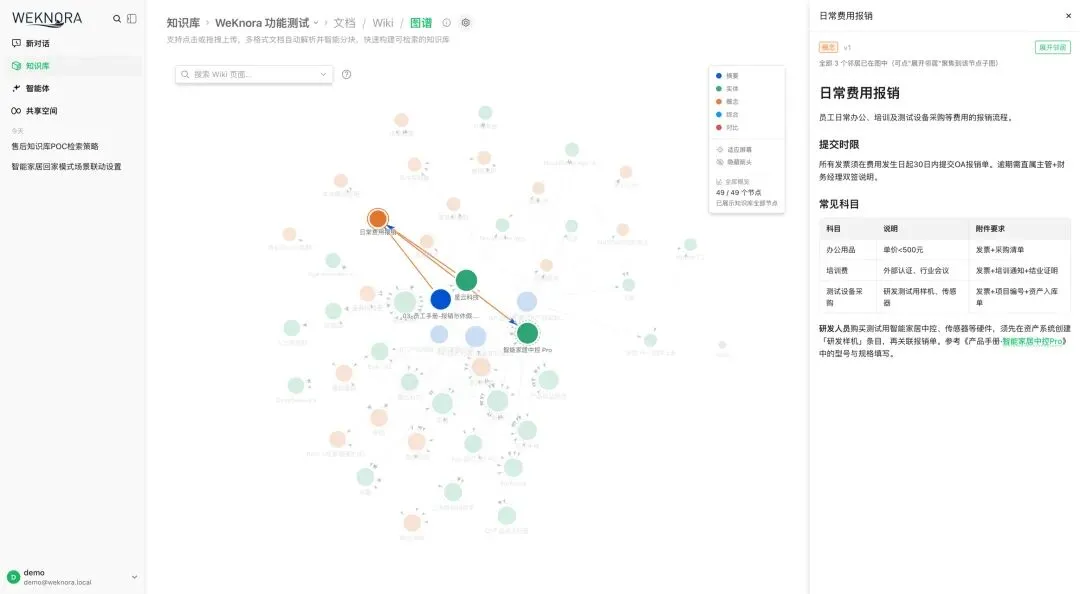
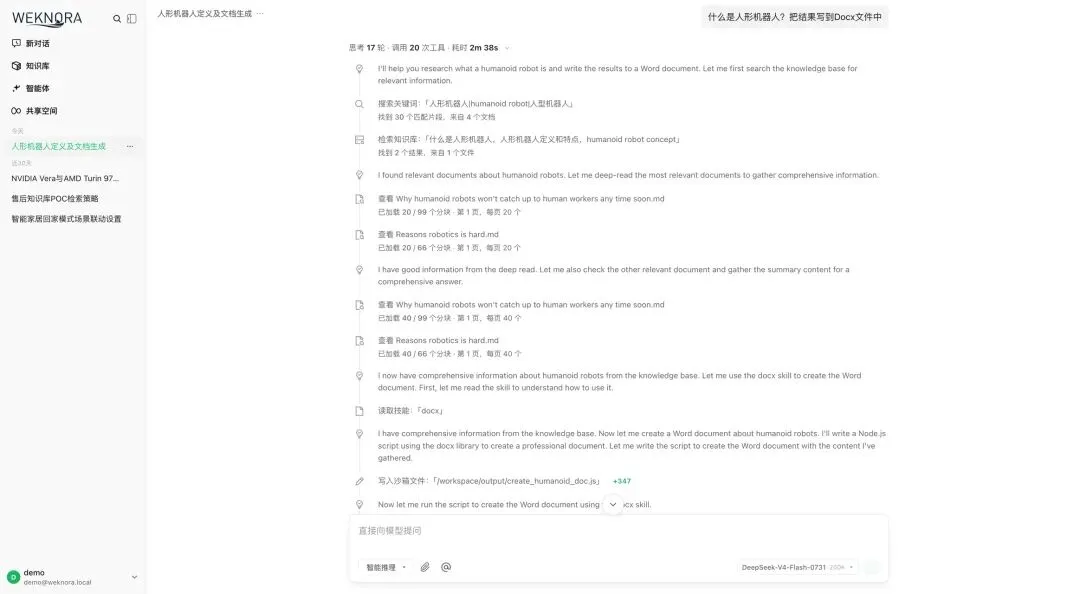
WeKnora 是腾讯开源的一个 LLM 知识框架,定位是企业级的「文档→知识」中枢。简单问题走 RAG 快速问答,复杂问题交给 ReAct Agent 自己拆解步骤去检索和调用工具,更狠的是它带一个 Wiki Mode:Agent 会把原始文档蒸馏成一份结构化、可互链、带知识图谱的 Markdown 知识库,并且支持人工编辑、版本对比和回滚——相当于让 AI 既当编辑又当作者。
技术上,它原生支持 PDF、Word、图片、Excel、XMind 等 10+ 文档格式,能自动同步飞书 Wiki/飞书云文档、GitLab、腾讯 IMA、Notion、语雀、钉钉文档、RSS 等数据源,兼容 OpenAI、DeepSeek、Qwen、智谱、Hunyuan、Gemini、Ollama 等 20+ 模型提供方,还接入了 Langfuse 做可观测性。整个架构模块化,LLM、向量库、存储后端都能换,支持本地和私有云自托管。
为什么值得看
- GitHub 周增 1,892 Star
,总 Star 已突破 2.5 万,在 RAG + Agent 方向属于腾讯自家出品的中文社区热门项目 - 三大能力合一
:RAG 快速问答 + ReAct Agent 自主推理 + Wiki Mode 自维护知识库,一条链路全打通 - 跨会话长期记忆
:它会记住「你是谁、你常问什么」,下次直接给相关答案,不像普通聊天机器人聊完就忘 - 企业级特性拉满
:多工作区 RBAC、4 级角色矩阵、按资源所有权隔离、审计日志、scoped API keys、多租户都齐了 - 完全可自托管
:数据主权在自己手里,飞书/企微/Slack/Telegram 都能直接挂上去当客服
生活和工作中能拿它干嘛
- 企业内部知识库
:把产品手册、SOP、FAQ、会议纪要全喂进去,新人入职不用再翻 10 个文件夹,问 AI 就行 - 个人/咨询资料管理
:扔进一堆行业报告、论文、白皮书,AI 自动整理成可搜索的 Wiki,下次写方案直接调 - 客服和技术支持
:把 WeKnora 接入企微/飞书群,客户在群里 @ 一下,AI 直接基于知识库回答,省一半人力
适合谁用
- 企业 IT / 知识管理负责人
:想搭一套内部 AI 知识库,又不想把数据交给第三方 - AI 应用开发者
:需要 RAG + Agent + 可观测一体的底座,不想自己从头拼 - 咨询 / 研究 / 投资从业者
:日常要处理大量报告和文档,需要结构化沉淀 - 个人知识管理爱好者
:Notion/Obsidian 用腻了,想换个让 AI 主动整理的方案 - 想做自托管 AI 客服的小团队
:能挂到企微/飞书/Slack,省一个客服的钱
亮点拆解
- RAG + Agent 双引擎
:简单问题走向量检索秒答,复杂问题 Agent 自己规划多步、调用 MCP 工具和沙盒环境,把任务拆开做 - Wiki Mode 是杀手锏
:Agent 不仅回答问题,还能把文档蒸馏成结构化 Wiki,支持人工编辑、版本对比、一键回滚,知识会持续「自己长大」 - 跨会话长期记忆 + 树状目录
:保留上传时的目录结构,chunk 编辑像改文档一样有 revision history,适合需要审计的场景 - 完全模块化 + 多 LLM 兼容
:LLM、向量库、存储后端都能换,不绑定任何一家厂商,从开源模型到商用闭源模型随便切
快速体验(30 秒)
git clone https://github.com/Tencent/WeKnora
cd WeKnora
docker compose up -d
# 启动后浏览器访问 http://localhost:8080
最小示例:进入 Web 界面后上传一个 PDF,等几秒钟解析完成,在问答框输入「这份文档的核心结论是什么?」,AI 会基于文档内容给出答案,并标注引用来源。
更详细的部署配置、API 调用和多数据源接入,请看仓库的 README.md以及 examples/目录。
用前须知
当前版本 v0.8.0,还在快速迭代,生产环境建议先小规模验证,再逐步放大 文档解析质量取决于 LLM 能力,建议选择支持长上下文的模型(比如 DeepSeek、Qwen 长文本版),效果会更稳 大量文档入库需要一定的向量库存储和 Embedding 算力,建议先用小批量跑通流程,再评估扩容方案
WeKnora 让散落的文档「自己活起来」,你怎么看这种「AI 维护 Wiki」的方向?欢迎评论区聊聊。
信息来源
https://github.com/Tencent/WeKnora