ARTICLE · 1030136
12 个 AI 概念,测试人各该验什么
12 个 AI 概念,测试人各该验什么
AI 的名词一天冒一个。Token、上下文窗口、RAG、工具调用、幻觉、智能体,隔几天换一个砸过来。
做测试的都撞过这个场面,会上有人提一个词,你跟着点头,心里没底。会后自己补课,搜出来清一色是科普,把词是什么讲明白了,没人说该拿它测什么。
我做了 14 年测试,这 12 个概念我按数据流排了三组,输入这一侧四个,中间过程四个,落地要面对的四个。每个只说三件事,它是什么,它会在哪儿骗过你,你该验什么。
先说一个贯穿全文的结论。这 12 个,功能测试的断言一个都盯不到。原因不复杂,断言盯的是它交回来的东西,而它们出错的地方,在返回值之外。
输入这一侧,四个
Token 和上下文窗口。 这两个词管一件事,你那份文档,它到底真看进去多少?模型读字不按篇读,是一小块一小块算的,这一块叫 Token。它一次能装的块数有上限,超了就得往下砍。它像一张格数固定的餐桌,菜一多,先上的那几盘就被端走。
长文档读进去的比你以为的少。上个月我拿一份真文档试,翻回原文一对,中间那几条它压根没看过。比被砍更麻烦的是它不吭声,内容少了一截不提醒你,照样答得笃定,等它说错了你才发现。
那为什么功能测试测不出来?
你写的那套检查盯的是它交回来的东西,格式对不对、字段全不全、状态码两百,这些它一样不差。可被砍掉的那页不在返回值里,日志里也不留。所以要翻它的账,先看它这回吃进去哪些字,再看日志里用掉多少、砍了哪几段。它说没有,是看过了装着说没有,还是压根没看到就往外答?一个回去改它,一个回来改你。
写用例只写三条。数一遍它实际吃进去多少字,别信界面上标的字数;把关键条款挪到文档正中间再问一次;上线前拿真实长度的文档压一遍。
提示词。 很多人以为它是咒语,写得越玄越灵。它不是咒语,是你交给 AI 的一张任务书。同一个模型,别人用着神,你用着蠢,差别在你交代的角色、给的资料、说的标准,都会被当成这一轮的全部依据。书写的歪,它照着歪的干。
它最爱在否定句上骗人。你写不要做某事,它经常照做,还做得理直气壮,同一件事正着写一遍反着写一遍,两次的表现能差出一大截。更隐蔽的是它会被用户一句话带跑,系统里明明立好了规矩,用户随口一句你先听我的,它就把规矩放下了。测提示词就盯三处,否定指令单独造一条用例,正反各写一版任务书对着看,再看用户随便一句话能不能盖掉系统提示,以及它会不会自己加戏。
检索增强,也有人叫 RAG。 它不是让模型变聪明,是让它回答之前先去翻你的资料。模型脑子里的东西是训练时灌进去的,更新不了,也不知道你公司的规矩。所以答得准不准,一半看你挑得准不准。它像开卷考试,允许翻书,翻到哪页看你自己。
两个地方容易翻车。资料切太碎,它拿着半句话就来答你;切太长,又抓不住重点。我还见过检索回来十条,对的那三条偏偏排在最后面。更麻烦的是它答错的时候你分不清哪一步错,资料压根没检索到,还是检索到了模型没看,还是看懂了答歪了。三步混在一起,你只能笼统说一句它答错了。
所以先把检索回来的那几段原样存下来,再存它带着问题递进去的那一整份,答错的时候拿这两样对。验检索固定问三句,切出来的每一段是不是句意完整,前几条里到底有没有那条对的,把答案埋进文档正中间看它捞不捞得出来。
工具调用。 它标志着一件事,AI 从只会说变成能真动手。以前它说一句我帮你查,你还得自己动手,现在它真去调了查订单的接口,把结果填回来。能力和风险是一起长的。
这也是它最危险的地方。模型碰到一个根本不存在的工具,会一本正经编一个出来,参数还凑得很像。所以我从来不比对工具名字,我比对它实际调用了什么。还有一层更少人查的,是它该不该有这个权限。它老老实实调对了工具,可那个工具本来就不该给它用,查订单的功能摸到了退款的接口,日志上看着一切正常。
验工具调用三件事。故意给它一个不存在的工具,看它老实说没有还是当场编一个;参数别用完全相等去断言;看它失败以后怎么办,是老实报错还是编个成功的返回。
中间这一侧,四个
幻觉。 它不是笼统的胡说八道,是四种完全不同的错。模型不是在资料里查答案,是按概率一个字一个字往外接,接得像人话,它的目标是让句子顺,不是让句子真。所以它答得越流畅,你越容易放松警惕。
第一种是编事实,凭空造一个不存在的东西。第二种是记岔了,把别处的信息安到这个头上。第三种是顺着你说,你问得带倾向它就顺着答。第四种最难防,格式全对,内容全错,字段名一个不差,里面那个金额就是错的。这种错自动校验全都能过,只有人拿着原文对才看得见。
四种的验法完全不一样。造事实靠埋点,把答案藏进中段看它捞不捞;顺着你说靠反问,正着问一遍反着问一遍;格式全对那种只能拿原文逐字段比。
多轮对话和记忆。 它考的不是模型看不看得懂,是它还记不记得。聊得越长,历史越长,而它能装下的就那么多,装不下只能丢,丢哪一头是平台定的。不知道它丢哪头,你就不知道它什么时候开始漏。有的从最早开始砍,你开头立下的规矩没了;有的从最新开始砍,你刚说的需求它反而忘了。
我碰到过更阴的一种。我说把刚才那个改成红色,它根本不知道那个是哪个,上一轮的东西已经丢了,这话还接着往下说,听着一点问题都没有。到底是它没记住,还是记住了没说?只能去翻每轮实际送进去的历史。
验记忆把每一轮实际送进去的历史存下来,看它到第几轮开始不再带上开头那句,那个轮次就是它真实的记忆边界。断言不能拿整句去比,中文换个说法就判不等,名字就查名字,金额就查金额。
语义相似度。 很多自动判分都拿它做底子,它不是判对错,是判像不像。让模型每次答得一模一样是不可能的,同一个问题换个说法意思不变,所以判分只能比意思接近到什么程度。这个思路没错,错在你把它当成了对错。
像和对是两回事。我在一句话里加了个不字,意思正好反过来,分数照样接近满分。这不是它坏,是这把尺子本来量的就不是这个。还有一种更隐蔽的,分数算出来了也显示了,可它压根没参与过不过的判定,报告上写着零点八九,旁边那个结论照样是通过。你盯着分数看半天,结论根本不是它定的。
用这套东西,先问那个分数有没有连到过不过上;再拿同一句话的两个写法,一个加不字一个不加,看它给的分差多少。
流式输出。 就是一个字一个字往外蹦的那种效果。它骗人的地方在于,你以为收到就是好的。等一整段答完再显示,用户要盯着屏幕干等,流式把字先送出去,看着像是快了。代价是内容被切成一小块一小块,块和块拼接的地方就多了出错的机会。
我盯着屏幕看过一段,字是往回倒的。网络一抖,同一块可能给你两遍。中间空一块的情况我也碰到过,两半拼起来就是一句病句。更气人的是接口全都返回成功,请求成功了,状态码是两百,日志上一条报错都没有。内容坏没坏,从接口这一层根本看不出来,必须把拼起来的那一整句拿出来读。
验流式只查三样,有没有重复块,有没有空块,把碎片拼起来的总长对不对。
落地这一侧,四个
智能体,Agent。 它不是聊天框的升级版,是你把目标交出去,它自己拆步骤往下走。一次问答是一问一答,过程短、看得见。智能体是自己决定下一步做什么,同一件事它可能走三条完全不同的路,路一多,你就没法拿一份固定答案去对。
自己走就容易走丢。它会在半路忘了目标是什么,会在一个失败的调用上原地打转,也会因为预算用完,交回来一个空壳。我还见过它把同一个动作重复三遍自己完全没察觉,每一步都合情合理,串起来整个任务已经跑偏了。这种错你只看最后那个答案,是发现不了的。
测智能体抓三个点。目标有没有跑偏;中途塞一个失败的接口,看它怎么绕;预算耗光的时候,它老实报错还是交个空壳。每一步调了什么必须留记录,这一步离目标是更近了还是更远了,中间有没有回头做同一件事,不留这份记录,你连它偏在哪儿都说不出来。
温度和随机性。 同一句话它每次答得不一样,不是它今天心情不好,是它本来就在抽签。它每写一个字都是在候选里挑,温度就是让它挑得大胆一点还是保守一点。写文案调高一点有灵感,写代码和做判断就该调低,让它稳住。
最容易出的事是两边不一致。测试环境调的是这一套参数,线上跑的是另一套,你测的时候好好的,上线就开始飘。我碰到过产品来找我说 AI 时好时坏,到底是模型变笨了,还是别的地方出了问题?最后查出来是两边的参数根本不是同一套,代码版本一模一样,跑出来两个性格。这种事不看参数,永远查不到。
所以参数要单点化,一处配、处处用,每次请求把实际用的参数记进日志。换了环境,第一件事是拿日志对着比一遍,比参数,不是只比代码版本。
成本和计费。 AI 的账单不是按你输入了多少定的,是按它读了多少、写了多少定的。你发一句话,它要连着提示词、历史、检索资料一起读,读的每一块都算钱,写出来的字还更贵。你估成本只算了自己输入的那点,等于只算了零头。
我拿用户输入的多少估过一回成本,结果账单高出一大截。原因有四层,没算系统提示词,没算历史对话,没算检索回来的资料,也没算那些反复来的异常流量。更亏的是重试,一次请求超时你让它重来一遍,前面读过的内容全部重新计费,重试率一高,成本悄悄翻倍,而这个数很多团队压根没有人盯。
要控成本先做三件事,把输入拆成四块分开算,系统提示词一块、历史对话一块、检索资料一块、用户提问一块;给每个功能配一条预算上限,超了自动停;重试率当指标盯起来。
评测。 它不是跑一遍看好不好,是先定好尺子,再让所有版本过同一把尺子。为什么最难,它要回答一个没有标准答案的问题,好还是不好。所以它只能自己造答案,或者让另一个模型来判,这两种办法都会把误差带进来。
一个评测系统最怕的是它不出错。尺子歪了,它给所有版本都打差不多的分,版本换了一版又一版,排名就是不动。你盯着报告以为模型没进步,其实是这套系统分辨不出来。还有一件更隐蔽的事,它偏爱长答案,同样内容写长一点分数就高,于是模型学会了把话说得很长,看起来答得更全,其实一句多的都没有。
所以我验评测系统三件事。先问分数和过不过挂上没有;再拿同一意思的长短两版,看分数偏不偏;最后放一个错的,看它敢不敢打低分。每一版都拿同一批题去跑,题不许换。分数一道道留着,两个版本的差别才追得到是哪几道拉开的。
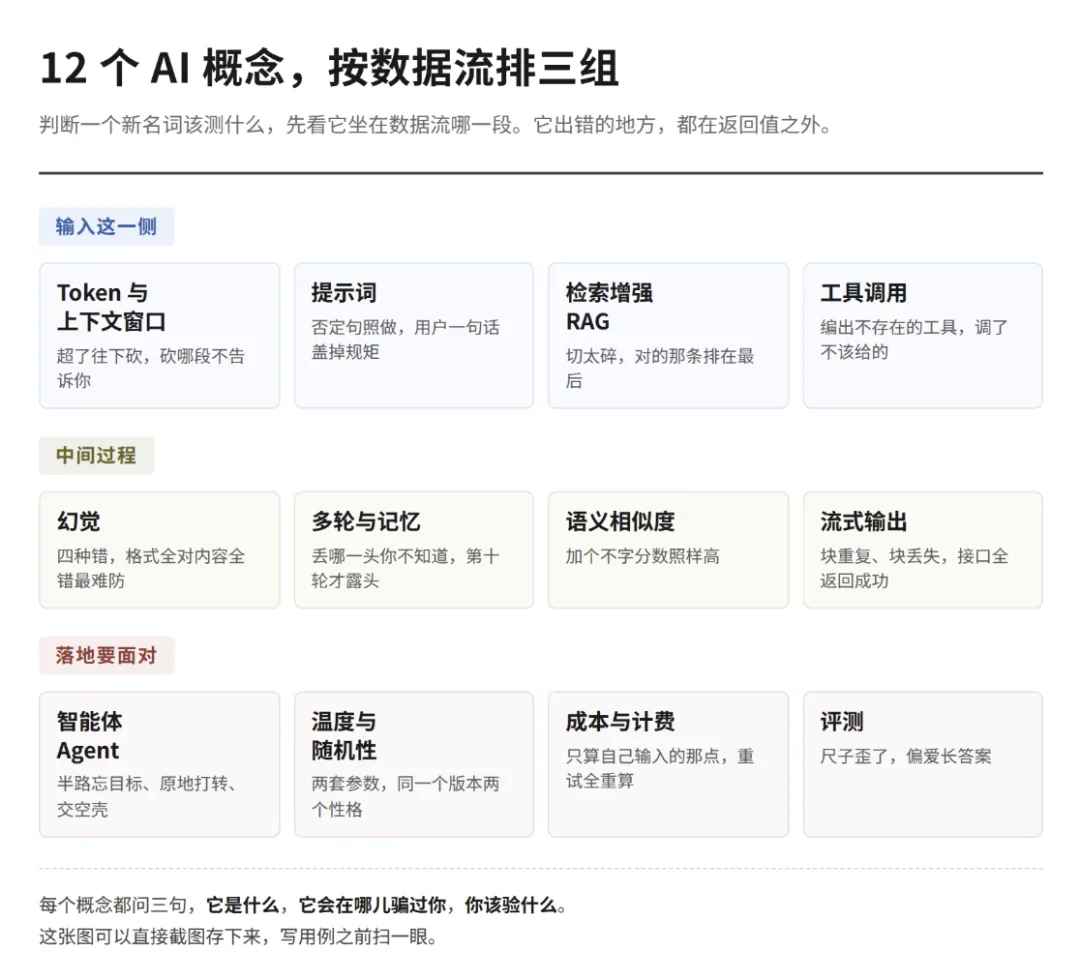
十二个,一页纸
这张表可以直接截图存下来,写用例之前扫一眼。
有它盖不住的地方。这十二条是单点的验法,真到一个完整系统里,这些错会串在一起出,比如检索没捞到,模型还顺着你的话编了一段,最后流式拼出来的句子读着通顺。分层的记录留不下来,你就只能看着一个错误的答案猜是哪一层坏的。日志和埋点是这套验法的地基,缺了这个,下面那些断言撑不住。
这 12 个我也不指望你全记住。以后再冒出一个新名词,你只问一句,它是来解决 AI 走向真实工作时哪个问题的。
这份一页纸的清单我整理成了可截图的版本,评论区回【清单】,我发你。