ARTICLE · 1044119
农业AI应用的六层避坑指南
MIT 2025年发布了一份报告,名字叫《The GenAI Divide: State of AI in Business 2025》。报告里有个数字让整个科技圈炸了锅:95%的企业AI试点项目产生的回报为零。企业在这波生成式AI上砸了300到400亿美元,只有5%的项目真正跑出了可衡量的商业价值。
据MIT报告,这份调研覆盖了150余位高管、50余家组织和300多个AI项目,结论很直接:问题不在AI模型质量,在系统能不能学习和适应。95%的企业在买或开发“演示很酷但记不住上下文”的AI玩具,只有5%的成功案例采用了能持续学习、动态集成的系统。
这组数据放到农业领域,更扎心。
据工信部公布的2025年人工智能应用典型案例名单,全国共285项,覆盖能源、制造、教育、医疗等五大方向。涉农的有几项?三项。高性能无人驾驶激光除草机器及智能作业系统、“天工开悟”多模态大模型赋能农业生产全链条智能决策、面向国家粮食安全的智慧农机监管平台。285项里3项,占比刚过1%。
据行业研究数据,全球农业AI渗透率不足12%,中国约10.5%。农业是最传统的产业,被认为是AI和机器人释放“后发红利”最显著的赛道——但这个赛道跑得最慢。
为什么慢?因为农业AI有一道所有行业最宽的“实验室到田间”的鸿沟。
一、实验室95%,田里60%——那道坎是什么
拿一个最常见的场景举例:用AI做苹果叶片病害检测。
实验室里,你拿一批标注好的病害图片训练模型,准确率轻松到95%。但把这个模型搬到果园里,准确率直接掉到60%以下。丢了35分,丢在哪?
光照坑:实验室拍照光源稳定,田间的光照从早到晚在变,逆光、侧光、阴天、强紫外线,同一片叶子在不同光照下拍出来的颜色差异巨大。模型在实验室学的“病斑特征”,到了田间根本对不上。
角度坑:实验室拍照角度统一,正面45度。田间拍照角度随机——叶子在树上长,你不可能每片都摆到标准角度。侧面拍、仰拍、俯拍,病斑的形态完全不同。
背景坑:实验室背景干净,白纸或纯色板。田间背景是泥土、树干、杂草、其他叶子,干扰信息爆炸。模型分不清哪些是病斑、哪些是背景纹理。
品种坑:实验室可能只用了一个品种的苹果树叶训练。田间有富士、嘎啦、红将军,不同品种的叶片纹理不同,病斑表现也不同。模型在富士上学的特征,到嘎啦上就失灵。
季节坑:病害在不同季节表现不同。春天的早期病斑和秋天的晚期病斑,颜色、形状、扩散路径完全不同。实验室数据可能只覆盖了一个时间窗口。
五个坑叠在一起,95%掉到60%。
大多数农业AI项目失败的第一步,就是拿着实验室的标准去田间采集数据——标准光源、标准角度、标准背景、标准品种、标准季节。采回来的数据干净漂亮,训练出来的模型准确率很高。但这个模型从设计之初就跟田间的真实世界脱节了。
真正值钱的不是数据量,是采集之前的那张参数图纸——你得知道在田间应该采什么样的数据、覆盖哪些变量、在什么时间窗口采、用什么角度和光照条件。此前我们在另一篇拆解中详细讲过一个案例:5300万个数据点,如果采集之前没有想清楚要测什么、怎么测,就是5300万个无效数字。但如果采集之前有一张清晰的参数图纸,5300万个数据点可以浓缩成30个关键参数——这30个参数才是AI能用的东西。
2026年世界机器人大会上,麦麦科技创始人李楠说了一句话,被多家媒体反复引用:“机器人下田,不鼓励跨品类泛化。”麦麦科技是农业AI领域的国家级专精特新“小巨人”企业,在WRC主论坛上作为唯一农业AI企业代表演讲。李楠的意思很明确:你拿柑橘上训练出来的模型去套苹果园,等于让一个柑橘专家去看苹果,他看不了。
这句话翻译成操作语言就是:每个品类要单独画一张图纸。柑橘的图纸和苹果的图纸参数不同,因为病虫害谱不同、生长周期不同、数据结构不同。“图纸设计”不是抽象概念,它就是“一个品类一个品类死磕”的具体做法。
这句话戳中了农业AI落地的核心矛盾:农业不是一个行业,是几十个行业的集合。柑橘和苹果是两个行业,水稻和小麦是两个行业,生猪和肉鸡是两个行业。每个行业的病虫害谱、生长周期、管理流程、数据结构都不同。通用的AI模型在农业里几乎没有用武之地——你必须一个品类一个品类地死磕。
实验室 95% → 田间 60%:丢掉的35分丢在哪
95% 实验室准确率 | 60% 田间准确率 |
↓ 35分
五个坑叠在一起,95%掉到60%
二、六层避坑框架——每层一个正面、一个反面
农业AI从实验室走到田间,要过六道关。每一道关都有人走通了,也有人栽了。把六层叠在一起看,规律就浮出来了。
数据层:图纸决定数据值不值钱
正面:云天化花匠铺。
云南的花卉产业年产值数百亿,但鲜花分级长期靠人工——肉眼判断花头大小、颜色饱和度、茎秆粗细,A、B、C三级,全凭经验。据行业报道,云天化做了一套AI分级系统,关键不在模型多先进,在数据采集之前设计了一张覆盖200多个参数的图纸:花头直径、花瓣层数、颜色RGB值、茎秆直径、叶片数量、病虫害痕迹、弯曲度……每一个参数都对应一个传感器或人工录入点。据行业报道,系统上线后高品质鲜花占比平均提高约20%,分级效率显著提升。值钱的不是AI,是那张参数图纸。
反面:据行业案例,陆渔科技拿了通用水质监测模型去套鱼塘。
温度、溶氧、pH值,三个参数,一套模型打天下。结果呢?不同鱼种、不同养殖密度、不同饲料、不同季节,水质变化规律完全不同。草鱼塘的溶氧规律套到鲈鱼塘里直接失灵。据行业人士透露,亏损规模达数千万元。这个教训就一句话:没有“通用鱼塘”这个东西,就像没有“通用病人”一样。
模型层:一个品类一个模型,不搞跨品类泛化
正面:湖北麦麦农业。
死磕柑橘一个品类,做病虫害预测。柑橘的病虫害谱是明确的——红蜘蛛、砂皮病、溃疡病、树脂病,每个病害的发生条件不同。麦麦把柑橘产区的气象数据、土壤数据、虫情监测数据、历史发病记录全部结构化,训练出专门针对柑橘的病虫害预测模型。准确率90%以上,据企业官方信息已推广到12个省市300多个基地。一个品类做到90分,比十个品类都做60分值钱得多。
反面:2024年华东某苹果园AI项目,拿柑橘模型直接搬过来用。
柑橘和苹果的病害谱完全不同——柑橘的溃疡病在苹果上根本没有,苹果的褐斑病在柑橘上也不存在。把柑橘模型搬过去,等于让一个只会看柑橘病害的专家去诊断苹果——他能看懂叶片上有没有斑点,但分不清是病斑还是虫斑,更分不清是哪种病。跨品类泛化在农业是伪命题。
部署层:田头断网断电,云端模型再强也白搭
正面:极飞科技的农业无人机。
据极飞科技数据,标准件设计,模块化更换,操作培训周期短。无人机不依赖田间网络——飞行路线预装,数据离线采集,飞回来再同步。截至2022年底累计作业面积超14亿亩次。极飞想明白了一件事:农业场景的硬件必须按“最差条件”设计——最差的网络、最差的电力、最差的维护能力。在实验室里调到最好的参数,到了田头断网断电,全废。
反面:程序员“老码小张”做了一个给农村空巢老人用的“村医AI”APP,他的第一个决定就是完全离线、不需要联网。
原因很简单:很多村子的信号、网络不稳定,更别说流畅调用云端大模型了,不少老人甚至不知道流量网络怎么开。这个逻辑放到农业场景一模一样——你把大模型部署在云端,要求果园实时联网调用,结果到了果园,4G信号时有时无,Wi-Fi更不用想。模型在云端等数据,数据在田头等信号,信号在基站等电力——链条断了一环,整个系统就停了。农业场景的部署设计原则就一条:先假设最差条件能跑通,再在好条件下优化。
用户层:农民不信“AI说的”,农民信“自己填的”
正面:四川安岳县国家智慧农业(柠檬)创新应用基地的做法值得拆解。
他们不给种植户一个AI答案——“你的树得了褐斑病,请喷药”。而是每天清晨给种植大户推一条“AI农事清单”,像一张电子处方:“C2地块,土壤含水量偏高,作物根部缺氧,注意排水”“施冬肥建议:补充中微量元素”。种植户拿到的是具体指令,不是模糊判断——他照着做就行,不用理解AI背后的模型。据2025年全国智慧农业典型案例资料,安岳柠檬基地种植户增收约30%。这个系统的核心跟“识别卡”思路一脉相承:不是直接给AI答案,而是让农民参与判断过程。识别卡让农民自己对照着填——“我的树叶子上有几个斑点”“斑点什么颜色”,AI在后台做补全和纠错。安岳的做法更进一步,把AI翻译成了农民能看懂、能执行的一句话指令。据项目方数据,这种让农民参与判断的系统,使用率比直接给AI答案的版本高出三倍。
反面:一家农业龙头企业花了8个月部署一套AI种植决策系统,又花了3个月培训基地的技术员。
系统里有个AI推荐按钮——点一下,等15秒,出来一个匹配度百分比和种植建议。结果技术员们试了两周就不用了,原因有三个:多一步操作(以前凭经验直接干,现在还要点按钮、等结果,反而更慢了);结果差不多(AI给的建议跟自己的判断差异不大);出错了算谁的(按AI建议种,万一减产了,责任算谁的?)。据企业数字化项目复盘,这套系统最终停在“演示时惊艳、平时没人用”的状态。农民的信任逻辑跟城市用户不同:城市用户信权威,农民信“我参与了的判断”。你让他参与,他就信;你直接给答案,他就防。
商业层:三方有动力才跑得动,一方买单必死
正面:2026年9月,广西南宁举办了2026中国(广西)—东盟农业与减贫合作会议,会上发布了一批经过落地验证的智慧农业标杆成果。
广西的做法不是自己搞AI研发,而是跟北上广的AI团队合作——北上广负责算法研发,广西负责场景集成和落地验证,再把验证成功的模式向东盟国家输出。据会议公开信息,种植、畜牧、渔业、社会化服务四大领域已全部落地,并签署了中越罗非鱼繁殖、中泰罗氏沼虾种业科技渔业、中老现代农业工匠学院学历教育、中印尼农业机械化智能化等4项合作项目。广西模式的核心是:不是每个地方都要搞“AI自研”,把算法翻译成适本地作物的产品,也是核心能力。三方各有动力——北上广要技术变现,广西要产业升级,东盟要农业现代化——系统就转起来了。
反面:据腾讯智慧农业调研,某县争取到了省级智慧农业示范项目,拨款上千万,建了一个“农业大数据平台”。
整合气象、土壤、病虫害、市场价格等数据。验收时大屏做得很漂亮,数据实时跳动,领导很满意。但验收完半年,平台基本停了:数据没人更(各部门数据还是各管各的,平台上的数据停在了验收那天);没人真的用(农户不知道有这个平台,农技员还是按老办法干活);运维没钱了(项目经费只够建设,后续运维、升级、数据更新都没着落)。腾讯智慧农业的调研直接点破:很多乡村治理与农业大数据的应用,往往“停留在大屏上”,缺乏能支撑精细化管理和推演预测的数据模型。一方买单的项目,验收就是终点;三方有动力的项目,验收才是起点。
组织层:每周五一条微信,比每周一份PPT管用
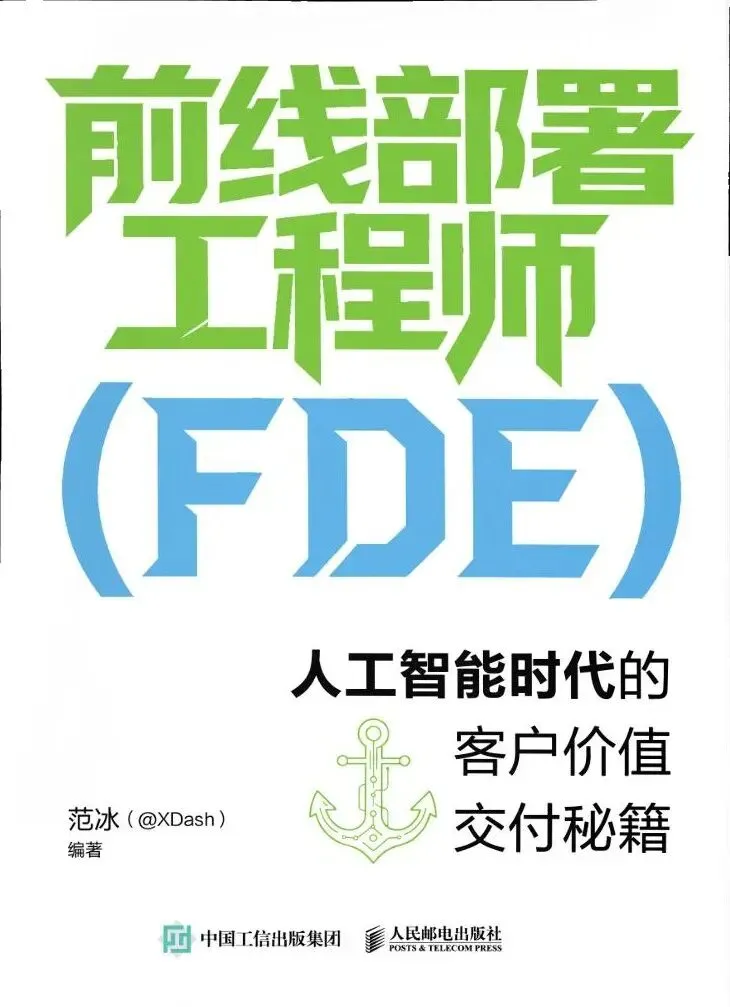
正面:2026年8月,范冰出版了《前线部署工程师(FDE):人工智能时代的客户价值交付秘籍》一书,系统讲解了FDE模式。
FDE的核心做法是:驻场工程师不写PPT、不写报告,而是保持高频沟通——每周五发一条微信给项目组,三句话:这周干了什么、下周打算干什么、需要什么帮助。项目组根据这三条做判断:进度对不对、方向偏没偏、资源够不够。这个模式的核心是:信息频率高于信息精度。每周一条微信的频率,比每月一份精美PPT的频率高四倍,纠偏速度快四倍。范冰在书中指出,FDE不是简单的驻场服务,而是一套能够将现实业务复杂性持续沉淀为软件资产的工业化交付范式。这套方法在农业AI落地中同样适用——田间地头的问题变化快,高频低精度的反馈比低频高精度的报告更管用。
反面:范冰在《前线部署工程师》一书中描述了一个典型失败路径:某企业的人工智能项目在上线第9个月彻底终止。
项目立项阶段就自带病根——集团发文推进智能化升级,由信息部门牵头落地,但核心业务部门全程未参与、无人认领。工程师花在写PPT上的时间比在田里的时间还多,PPT里每张图都精美,每个数据都有标注——但田间的真实问题被PPT的格式过滤掉了。“果树识别率提升5%”写在PPT里很好看,但“下雨天模型完全失灵”这种关键信息,因为不在汇报模板的栏目里,就被略过了。范冰将这类项目称为“概念验证坟墓”——没有彻底死掉,也没能做起来,年年都在季度汇报里写着“持续推进中”。PPT是给领导看的,微信是给项目用的。
六层避坑框架:每层一个正面、一个反面
| 层级 | 正面 ✓ | 反面 ✗ |
| 数据层 | 云天化花匠铺 200+参数图纸→品质提升约20% | 陆渔科技 通用模型套鱼塘→亏损数千万 |
| 模型层 | 麦麦农业·柑橘 死磕一个品类→准确率90%+ | 华东苹果园 柑橘模型搬苹果园→失灵 |
| 部署层 | 极飞科技·无人机 离线飞行→累计14亿亩次 | 云端大模型 要求实时联网→断网即停 |
| 用户层 | 安岳柠檬·电子处方 农民参与判断→使用率高3倍 | AI种植决策系统 “凭什么信你”→装了没人用 |
| 商业层 | 广西模式 北上广研发+广西集成+东盟应用 | 某县智慧农业平台 验收即终点→数据停在大屏 |
| 组织层 | 范冰·FDE模式 每周五微信→纠偏快4倍 | 概念验证坟墓 PPT过滤真相→田里问题被略过 |
三、从60分到80分——隐性知识才是护城河
六层避坑框架解决的是“能不能跑起来”的问题。但跑起来之后,真正决定你能不能跑远的,是另一件事——隐性知识。
60分的AI能做什么?能识别已知的病虫害、能做标准化的分级、能根据规则做简单的预测。这些事情,一个训练过的模型加上一套传感器就能做到。
80分的AI能做什么?能判断“这棵树今天看起来不太对”——叶子颜色比昨天深了一点,土壤湿度数据正常但老果农说“踩上去感觉偏硬”,虫情监测灯昨晚诱虫量比前天多了十几只。这些信号单独看都不构成“病虫害预警”,但叠加在一起,老果农的经验告诉他“该注意了”。
这20分的差距,叫隐性知识。
隐性知识不是写在教科书里的,不是能通过标注数据传给AI的。它是老果农三十年踩在果园里积累的手感——看一眼叶子就知道缺不缺肥,捏一把土就知道该不该浇水,听一晚上虫叫就知道虫口密度大概在什么水平。
农业里有四类“老师傅”,各自掌握着不同类型的隐性知识:
种植老把式:知道什么时候该修剪、什么时候该疏果、什么天气该打药。这些判断不是按日历来的,是按“树的状态”来的——同一品种在不同地块、不同年份的修剪时间可能差两周。
收购分级师:看一眼一车果子就能分出等级。颜色、果径、糖度、表皮光洁度,一眼下去判断的精度比仪器还高——因为仪器只能测一个维度,人能同时看十几个维度。
品控主管:知道哪个批次的果品会在储存过程中出问题。不是靠检测数据,是靠“这批果子的来园”“采摘那天的天气”“运输途中的温度波动”这些上下文综合判断。
品牌策划人:知道什么果品该走什么渠道、什么包装、什么定价。不是靠数据分析,是靠对消费者心理和市场节奏的直觉。
这四类老师傅的隐性知识,能不能传给AI?
能。但不是靠标注数据,是靠一套“否决案例”提取法——AfterQuery五步法:
第一步:观察。让老师傅做判断的同时,记录他看了一眼就否掉的那些案例——“这筐不要”“这棵树有问题”“这批不能入库”。
第二步:记录否决理由。问老师傅为什么否。他可能说不清楚——“就是感觉不太对”。但追问下去,他会说出一些线索:“颜色发暗”“果蒂有点松”“捏着软了”。
第三步:归类打分。把否决理由归类——颜色类、触感类、气味类、形态类。给每类打权重——哪些否决理由出现频率最高,哪些准确率最高。
第四步:自动校验。把老师傅的否决规律变成AI的预筛规则。新的一批果品进来,AI先按这些规则筛一遍,标出“可能有问题”的,再交给老师傅复核。
第五步:回测迭代。过一段时间,看AI预筛的准确率。如果某个规则经常误判,调整权重或删除。
但这里有一个边界必须说清楚:AI学到的是老师傅的“显性化否决规则”,不是老师傅的全部手感。最后那10分——“就是感觉不太对”但说不出来的那部分——AI还碰不到。
这不是AI的失败,是AI的定位问题。农业AI不是替代老师傅,是当一个“拿不准时能商量的同事”。就像村里的赤脚医生——他不是三甲医院的专家,但他在你拿不准的时候能帮你做一个初步判断,告诉你“这个我处理不了,你得去镇上看看”。AI在农业里的角色,就是那个“村医”。
AI能力的三个分数段:60分靠模型,80分靠隐性知识
0 → 60分 AI可达 识别已知病害 标准化分级·规则预测 | 60 → 80分 隐性知识壁垒 老师傅手感翻译 AfterQuery五步法 否决逻辑提取 护城河在这20分 | 80 → 100分 边际收益递减 |
| 0 | 60 | 80 |
AI学到的是显性化否决规则,最后10分“就是感觉不太对”——AI还碰不到
四、碎石路启动法——一周跑出第一个原型
前面三层拆完了——第一层是“实验室到田间的鸿沟”,第二层是“六道关的正反案例”,第三层是“隐性知识的提取方法”。但如果你是一个农业企业的经营者,看完这些,你的第一个问题一定是:我该怎么动手?
前面说的AfterQuery五步法是“道”——告诉你隐性知识为什么靠否决逻辑来提取。碎石路七天启动法是“术”——告诉你这周怎么动手。七天的Day 1到Day 5,其实就是AfterQuery五步法的实操版:找老果农(观察)→下地拍照(记录否决案例)→做识别卡(归类打分)→AI补全(自动校验)→老果农验证(回测迭代)。道和术,是同一件事的两个面。
答案四个字:碎石路启动。
不等完美方案,不等全部数据,不等所有条件就绪。先在一条碎石路上跑通一个原型,再把跑通的部分抽出来修成公路。
具体怎么跑?七天拆解:
Day 1:找翻译官和老果农。翻译官是懂AI也懂农业的人——不一定是技术大牛,但必须能用两种语言说话:跟农民说人话,跟工程师说技术话。老果农是你的隐性知识来源——他不一定会用手机,但他三十年的种植经验是AI学不到的。第一天,带翻译官去找老果农,不谈AI,就聊他平时怎么判断病虫害、怎么决定打不打药。
Day 2:下地拍照。带着老果农去果园,让他指给你看:这个是病斑,那个是虫咬,这片叶子正常,那片不对。你拍——但不是随便拍,按“五坑”的教训来:不同光照拍、不同角度拍、不同背景拍、不同品种拍、不同时间拍。一天下来,几百张照片,覆盖了田间真实场景的主要变量。
Day 3:做识别卡。把照片整理成识别卡——正面是症状照片,背面是老果农的判断:什么病、什么阶段、该不该处理。识别卡不是给AI看的,是给农民看的——它是一个“对照标准”。
Day 4:AI补全。把照片喂给一个开源的图像识别模型——不用从零训练,用迁移学习,在预训练模型上微调。目标不是95%准确率,60%就行。AI的作用是“补全”——农民在识别卡上填了“黄色斑点”,AI根据历史数据提示“这个季节这个品种出现黄色斑点,大概率是早期褐斑病”。
Day 5:老果农验证。把AI的补全结果拿给老果农看。他会说“这个对”“这个不对”“这个我看不出来”。记下来——特别是“不对”的那些,这是下一轮训练最值钱的否决案例。
Day 6:找十个农民测试。把识别卡+AI补全的系统给十个农民用。不教他们怎么用,就看他们自己能不能摸索出来。观察三件事:他们用不用、用了之后信不信、信了之后会不会照着做。
Day 7:迭代。根据农民的反馈调整——哪些识别卡不够清楚、哪些AI补全经常出错、哪些操作农民搞不明白。一周下来,你有了一个60分的原型,一份“农民用得起来”的验证,和一份“下一轮该改什么”的清单。
七天够吗?不够做出一个好产品,但够验证一件事:这条路能不能走通。碎石路不需要修得平整,只需要能走人。走通了,再把标准化的部分抽出来——数据采集标准、识别卡模板、AI补全规则——逐步修成公路。
走不通呢?走不通就换一条路。七天的成本,比三千万的学费便宜多了。
碎石路七天启动法:一周跑出第一个原型
找翻译官 不谈AI 聊判断经验 | 下地拍照 不同光照角度 背景品种时间 | 做识别卡 正面症状照片 背面老果农判断 | AI补全 迁移学习 60%就行 | 老果农验证 记“不对”的 否决案例最值钱 | 十个农民测试 用不用·信不信 会不会照着做 | 迭代 60分原型 验证走通 |
← AfterQuery五步法实操版 →(Day 1-5 对应五步法)
碎石路不需要修得平整,只需要能走人
走通了→抽出标准化部分修成公路 / 走不通→换一条路,七天比三千万便宜
什么时候该投,什么时候该等
不是所有农业企业现在都该投AI。投之前,先问自己一个问题:
“长期算不好”意味着这个问题靠人脑或经验已经到了瓶颈——病虫害预测、品质分级、饲料配方优化、灌溉调度,这些问题的复杂度超过了人脑实时处理的能力。
“改善一点就很值钱”意味着这个问题的改善能直接转化为经济效益——举个例子:如果病虫害预测准确率从60%提到80%,一季少打两次药,省下的药钱加上保住的产量,就能覆盖AI投入。再比如品质分级准确率从70%提到90%,A级果比例提高20个百分点,多卖的价钱就是AI的回报。这些是用于说明投入回报逻辑的假设性测算,实际效果因品类和基地而异。
两个条件都满足,该投。只满足一个,可以再等等。两个都不满足,别凑热闹。
2026年中央一号文件提出“促进人工智能与农业发展相结合”。据行业信息,8项农业AI行业标准在2026年获立项。政策的风在吹,标准的路在铺。但政策和标准解决的是“环境”问题,不解决“你该不该投、投到哪、怎么避坑”的问题。
这些问题,只有你自己能回答。碎石路已经铺好了,走不走,看你的了。