ARTICLE · 1063885
AI 不认字,只认编号
z
AI 不认字,只认编号
李扁舟
一步步走完这条链路,顺手标出踩过的坑。
这是「AI Agent 认知地图」连载的第 1 篇。
上周我给一个笔记助手算成本,按「1000 字一个单位」估的,觉得挺宽裕。跑起来第一天就超了预算,翻了一倍。
我盯着账单看了半天,才反应过来:我从一开始就估错了对象。我估的是「字」,它算的是「token」。
这篇就当我的第 1 课笔记。一句话,到底是怎么变成模型能懂的东西的。
一个我天天用、却从没细想的场景
我常问 AI:「我笔记里关于 XX 写了啥?」
它能答上来,这中间发生了什么?我以前从没想过。拆开看,整条链路挺长,但第 1 站特别朴素:我说的那句话,得先变成它能处理的形式。
它不认字,只认数字
你可能以为模型读的是「你好」这两个字。不是。
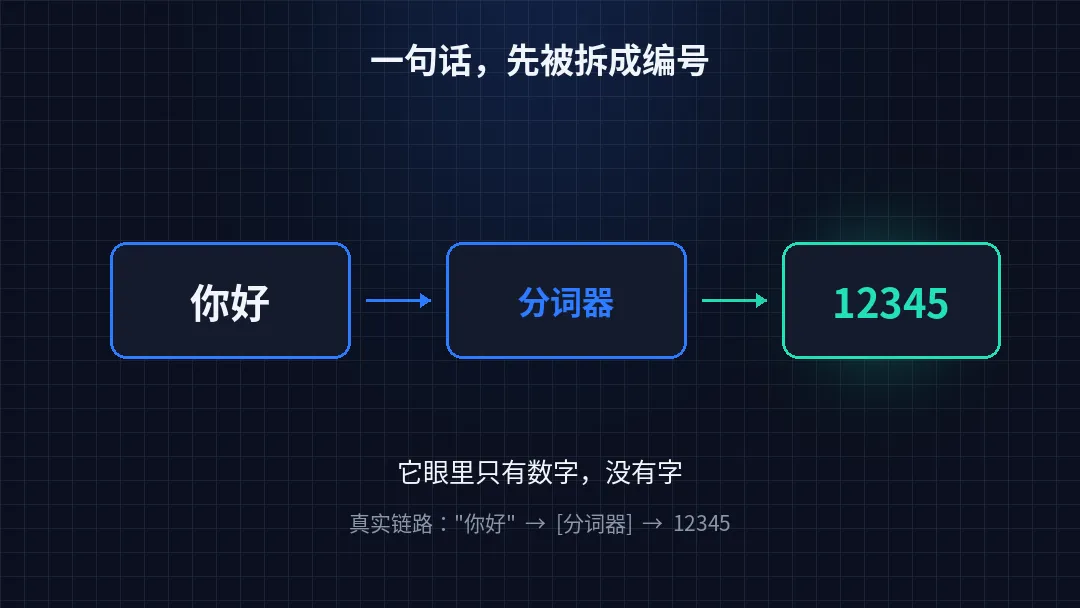
把「你好」写成一万种字体——宋体、手写体、歪七扭八的涂鸦——它一个都不认识。它既不懂汉字,也不懂英文单词。它眼里只有一串数字 ID。
真实流程大概是这样:
"你好" → [分词器] → [12345] → 模型只看到 12345
这一步叫 tokenization,中文一般叫「分词」。名字有点误导,因为它切的既不是我们理解的字,也不是词。
它按训练时统计出来的高频片段切。常见词占 1 个 token;生僻的长词会被碎成好几块,比如 tokenization 就拆成 token + ization。中文常用字,基本一个字对 1~2 个 token。
它不是语文老师那样按词典切,更像是在做统计:哪几个字经常一起出现,就打包成一块。这话我越琢磨越觉得贴切。
实测:我拿 DeepSeek 数了一遍
光听结论没感觉。我用 DeepSeek 实测跑了几段,把数字列出来:
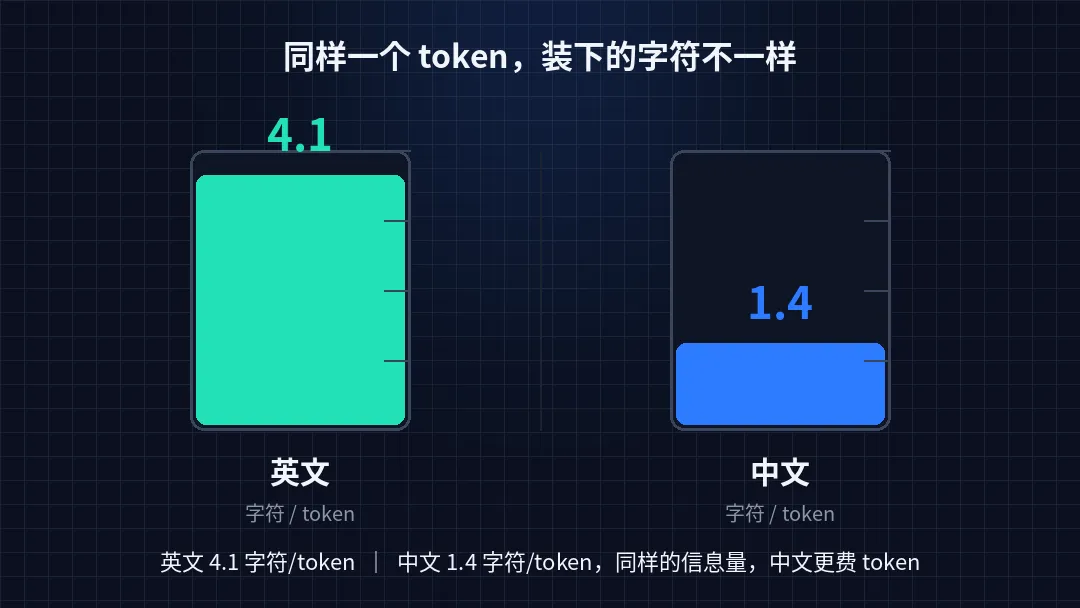
看最后两行就够了。同样一段意思,英文长句 1 个 token 能装 4.1 个字符,中文长句只能装 1.4 个。差的不是一点半点。
两条让我有点不适应的结论
第一,中文比英文「贵」。
不是中文难,是中文在 token 这个尺度上更费。英文的词能合成大 token,中文一个字常常要 1~2 个 token 去装。同样的信息量,中文吃掉的 token 更多。做中文场景的 Agent,成本天生比英文场景高一截。
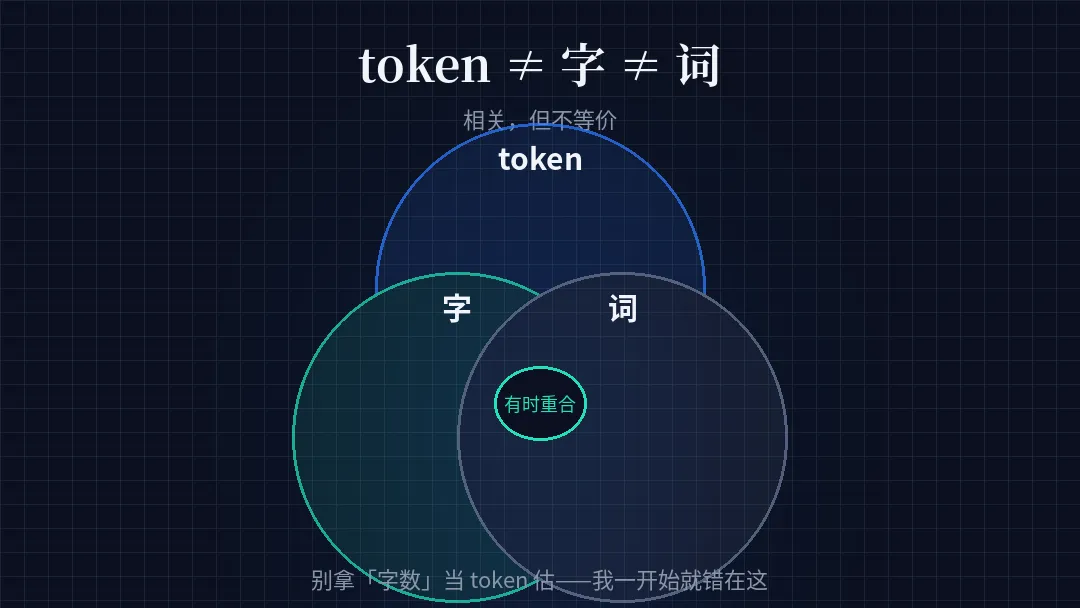
第二,token 不等于字,也不等于词。
这是我踩坑的地方。我拿「文档 1000 字」去估 token,直接估错。中文粗略要按大约 1.5 字/token 来算,也就是 1000 字差不多 650~700 token。估错一倍,预算就爆。
这一课埋下的三个坑
「token」这个词记住,后面三课都要用它,因为它是三条线的共同单位:
现在回头看,我一开始那个「1000 字一个单位」的估法,错得挺彻底——不是数错了,是根本没理解数的是什么。
下一课
第 2 课讲模型怎么吐出下一个 token,以及它为什么会一本正经地胡说。这个我更好奇,因为我被它骗过不止一次。
这是「AI Agent 认知地图」连载的第 1 篇。我的想法很简单:把每一步都走一遍,顺手把踩过的坑标出来。
如果这篇对你有用,点个「在看」,我们下篇见。
「AI Agent 认知地图」连载 · 第 1 篇