ARTICLE · 1065430
这个AI模型不聊天、不写码,只干选择、判断、打分三件事,这几天却爆火了
STRUCTURED DECISIONS2026.09
AI 模型比的就是谁会写长文吗?
不聊天、不写码,只干三件事
它却凭这登顶了 Hacker News
JEV · TypeSafe AI · 选择/判断/打分 · 结构化输出 · 置信度 · 输出免费
JEV 结构化决策模型 · 自媒笔记决策层
📦 4 Parts + Ending / 👉 滑动查看
01PART大模型的麻烦,不在「生成」在「判断」THE PAIN POINT
这两天刷 AI 圈子的帖子,你多半也撞见过一个叫 JEV的名字。它刚出来那几天,Hacker News 的热门榜直接被它顶上去了。奇怪的是,它身上没有多少「光环词」:不会陪你聊天,不会替你写代码,甚至连一句话都懒得写全。开发者却像捡到了什么宝贝一样疯狂转发。
为什么?把 AI 落地过的都知道,最磨人的从来不是「生成」,是「判断」。评论来了算好评还是差评?这条工单急不急?这个用户是不是在骂人?传统大模型干这些活是「杀鸡用牛刀」:思考半天,输出一大段话,你还得自己从里面抠出答案,再祈祷它格式没跑偏。又慢、又贵、输出还不可控——三个毛病,一个都没躲过去。
JEV 的做法很干脆:我不生成,我只做决定。
它是 TypeSafe AI推出的结构化决策模型,背后是前 OpenAI 核心研究员带队的班底,也被定位为业界首个主流的「System One 极速决策模型」。它把「判断」从大模型里拆出来单独做成了一个模型,只做三件事:选择、判断、打分。给问题和选项,它马上回一个结构化结果加概率置信度,代码直接读,不用解析一段话。速度比 chat 模型快一大截,输出格式还稳。
02PART三件事:选、判、打分THREE JOB TYPES
先给个总表,三种用法各占一块场景,后面逐个拆。
用法 1选择:把「关键词匹配」升级成「语义匹配」
不用模型的时候,这类问题通常拿关键词去挡:带「好」就是好评,带「差」就是差评。关键词是死的,人是活的,挡漏和挡错都常见。换 JEV 之后,靠的是文本语义和候选项描述的相似度去匹配。拿原文那个例子说:用户评论「体验过,也就那样」,问它「评论是什么类型」,候选给好评、中评、差评三个,它回的是中评,置信度大概 80%~90%。逻辑很顺:没有夸赞(排除好评),也没有负面吐槽、抱怨指责(不像差评),语义最贴近中性,所以落在中评。
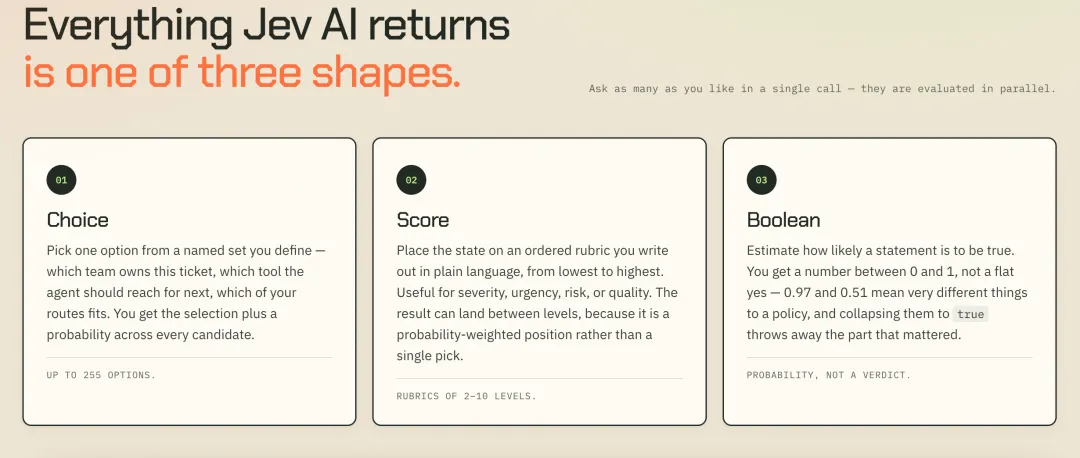
— 同一张工单:chat 模型一段话加解析器,JEV 一次直出带置信度的结构
顺手把同类场景列全:用户意图识别、工单分类、搜索意图判定、Agent 工具路由、文档段落归类、线索分级……只要问题是「在有限选项里挑一个」,都在它的射程内。
用法 2判断:只回答 True / False
判断比选择更简单,它只对单一条件做「成立 / 不成立」的判定。比如素材是一条评论「写得不错,已收藏」,问「这条评论包含辱骂、人身攻击内容?」,它回 False。这一类是风控场景的亲儿子:内容风控、稿件质检、对话识别、Agent 条件判断、文档初审、安全预检,全是「过一遍就知道留不留」的活。它也带一个风险:喂进去的是语义模糊的句子,误判概率就上来了。
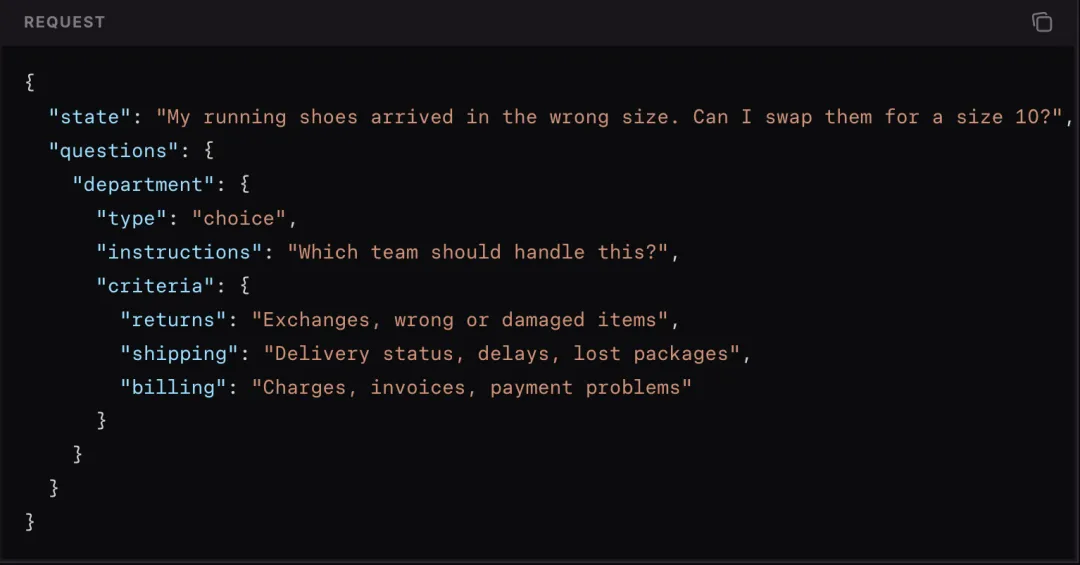
选择看候选项,判断看条件,打分看量表——三者同机,各取所需。
用法 3打分:把「程度」变成数字
前两个是「定性的」,打分是「定量的」。给个量表,比如用户满意度 0~10 分,它回一个分数加置信度。适合评估内容质量、情绪强度、风险等级、工单紧急度、意向强弱这类问题——「多急」「多深」「多强」,都能量化成能直接进系统的数字。同样提醒:模糊的判定标准会带来分数波动,量表得先定义清楚。
03PART决定生死的,是你的提示词PROMPT + OPTIONS
这一节是血泪区,坑全在这儿。JEV 的判定结果,核心影响因素就两个:Question 怎么写、候选选项怎么描述。写好了它是神,写糊了它跟着糊。
还是「好评/中评/差评」那个例子。候选项如果就仨词,太宽泛,它选的时候会出错。把选项本身写清楚,准确率立刻上一个台阶,原文给的做法是:好评 = 带夸奖、满意、推荐等正向评价;中评 = 没明显褒贬,平淡客观描述,既不夸也不抱怨;差评 = 含不满、吐槽、抱怨等负面评价。选项描述越具体,匹配语义越窄,命中越稳。
判断和打分同理。判断喂进去的是语义模糊的句子,误判概率就高——「有点意思但一般」算好评还是中评?得先拿选项把边界钉死。打分也一样,判定标准模糊会直接带来分数波动:「满意度 0~10」是笼统的,不如先定义清楚每段分数对应什么行为。一句话:它不猜,它按你的定义来,你定义得含糊,它就只能含糊地猜。
用过这类模型的人都懂:判断层的模型,天花板不在模型本身,在你的问题设计和选项措辞。把它当成「执行你定义的智能开关」来用,别当成「什么都懂的裁判」,体验才到位。
04PART价格、入口,和现在能不能用PRICE & ACCESS
算一笔账,这事便宜得有点不像 AI:输入价格每百万 Token 收 0.042 美元,约合人民币 0.28 元;输出完全免费——因为它压根不生成文本,只返回结构化决策,输出成本直接归零。
用法上,登录之后可以在线用,也可以调 API 接进自己系统里,两条路都通。入口就一个:官方站 typesafe(.)ai,注册个账号就能开始。但有个现实要摆前面:JEV 目前暂停了新用户注册,什么时候重新开放等官方通知。也就是说,现在没进门的,得先候着。
判断可以排队,需求别等——先把你的问题定义写好,门一开就是第一批。
说点实在的。这东西不会取代你的主力大模型,它补的是大模型最贵最慢的那一段——落地里的判断层。高频、琐碎、标准化的决策,本来就不该让「写作文的模型」来干。等注册重新开放,第一批进去的人,手里的「好定义」就是第一批真正的壁垒。别等热度过了才动手。
觉得有用的,帮帮忙三连:
点赞 · 推荐 · 转发,顺手把这篇转给那个还在拿 chat 模型跑风控判断的朋友。
THANKS FOR READING