ARTICLE · 1073917
6万篇AI水文一夜挤爆顶会!审稿系统彻底崩盘,华人主席通宵绝望求救
AI 研究者们亲手制造的技术怪物,终于掉头咬向了他们自己。
就在几天前,全球机器学习顶级会议 ICLR 2027 的摘要提交截止。当后台数据定格的那一刻,整个学术界彻底窒息了,大约六万篇(60,000+)摘要!知名学者 Kamilov 甚至感叹,这相当于全人类 100 家顶级科学期刊全年的产出总和。
这是什么概念?
十年前的 2015 年,ICLR 全年总投稿量只有 143 篇;一年前的 ICLR 2026,有效投稿冲到了 19,525 篇,已经把全球审稿人逼到吐血;而今年,入口流量直接向着 6 万篇 的天文数字呼啸而去!
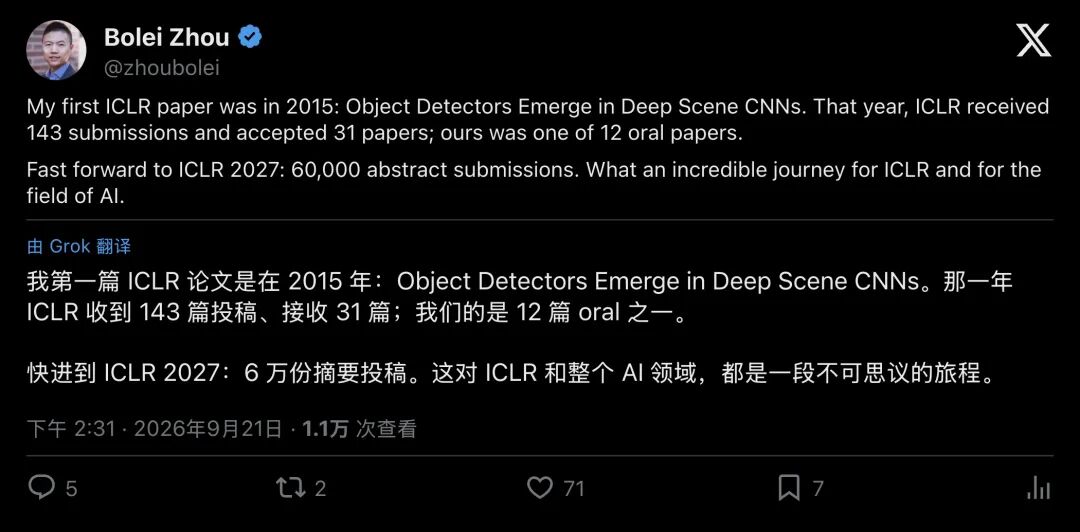
▲ UCLA 教授周博磊回忆:2015年ICLR一共才143篇投稿,而如今这个数字翻了400多倍
学术界最荒诞的一幕正在上演:一群致力于研发生成式 AI 的顶尖科学家,正被自己发明的工具所生产的“AI 垃圾(AI Slop)”彻底淹没。
整个同行评审体系,已经走到了崩塌的悬崖边缘。
01暴涨400倍的学术泥石流:你扔过来的,是一颗“水文手榴弹”
什么是 AI Slop?
在学术圈,它指向那些实验无法复现、参考文献充斥模型幻觉、作者自己都未通读核验过的“纸面制品”;即便结构齐整、公式漂亮,依然无法掩盖实质研究的空洞。
在过去,写一篇合格的学术论文需要数月的实验与数周的撰写;而今天,借助自动化 Agent 和大模型,生成一篇看似高大上的 PDF 只需要五分钟和几毛钱电费。
生产垃圾的成本降到了零,但识破垃圾的成本却高得惊人。
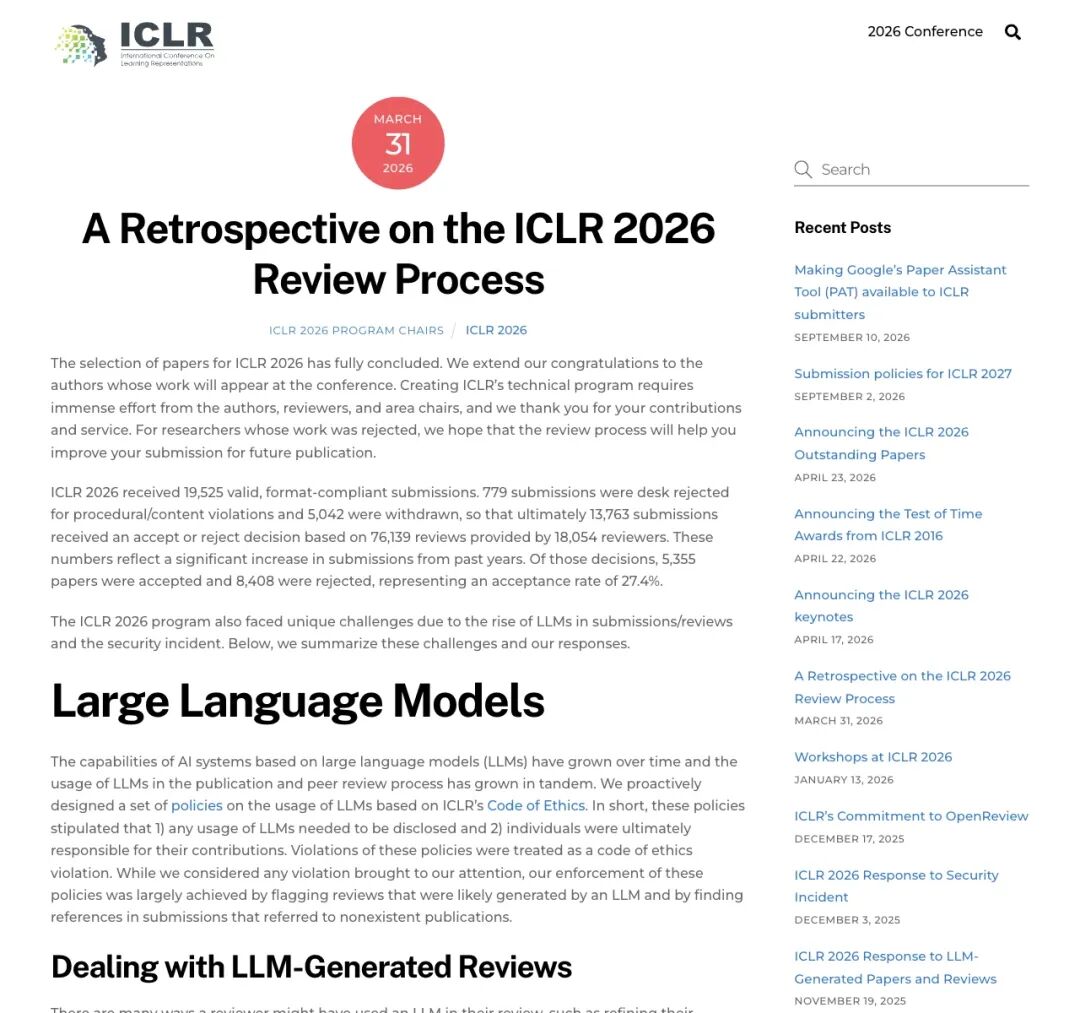
▲ 官方数据显示:上一届面对近2万篇投稿,会议动用了1.8万名审稿人,产出7.6万份审稿意见。如果面对6万篇,人类专家的时间根本不够分!
面对这股即将摧毁学术信用的洪水,隔壁另一大顶会 ICML 2027 的组织者们提前慌了。
担任下一届 ICML 大会程序主席(Program Chair)的卡耐基梅隆大学知名学者 Andrew Gordon Wilson,在社交平台上公开发帖求救,言辞之间充满了焦虑:
“我们怎样才能遏制疯狂增长的投稿和 AI 垃圾?怎样管理审稿?怎样激励高质量的原创工作?怎样减少官僚开销?”
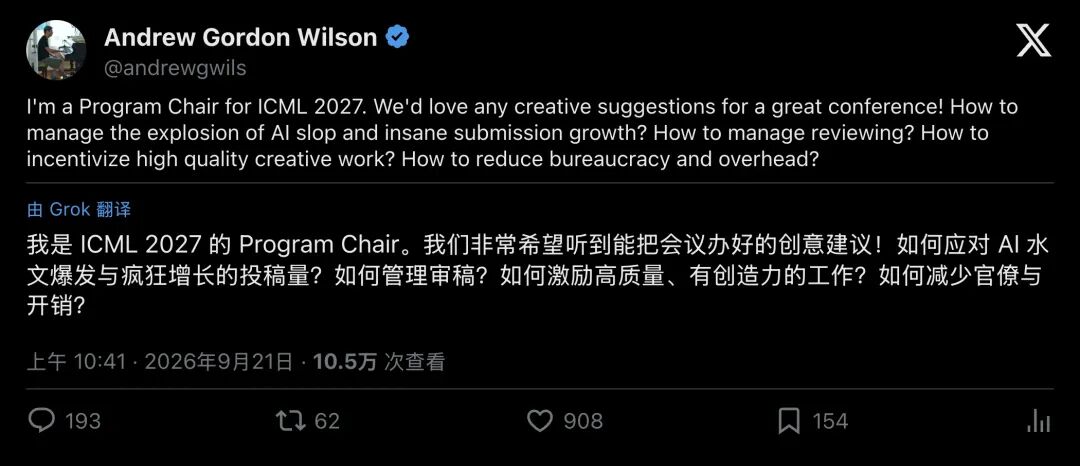
▲ ICML 2027 程序主席 Andrew 发推,向全球学界征集应对 AI 垃圾论文的救命方案
02华人女主席的“不眠生日夜”:用检测器抓水文,就是一场灾难
与 Andrew 一同担任 ICML 2027 程序主席的马里兰大学华人副教授 黄芙蓉(Furong Huang),在自己生日的当晚彻夜未眠。
她通宵敲出了一篇长文,直面这个所有人都在回避的死结。
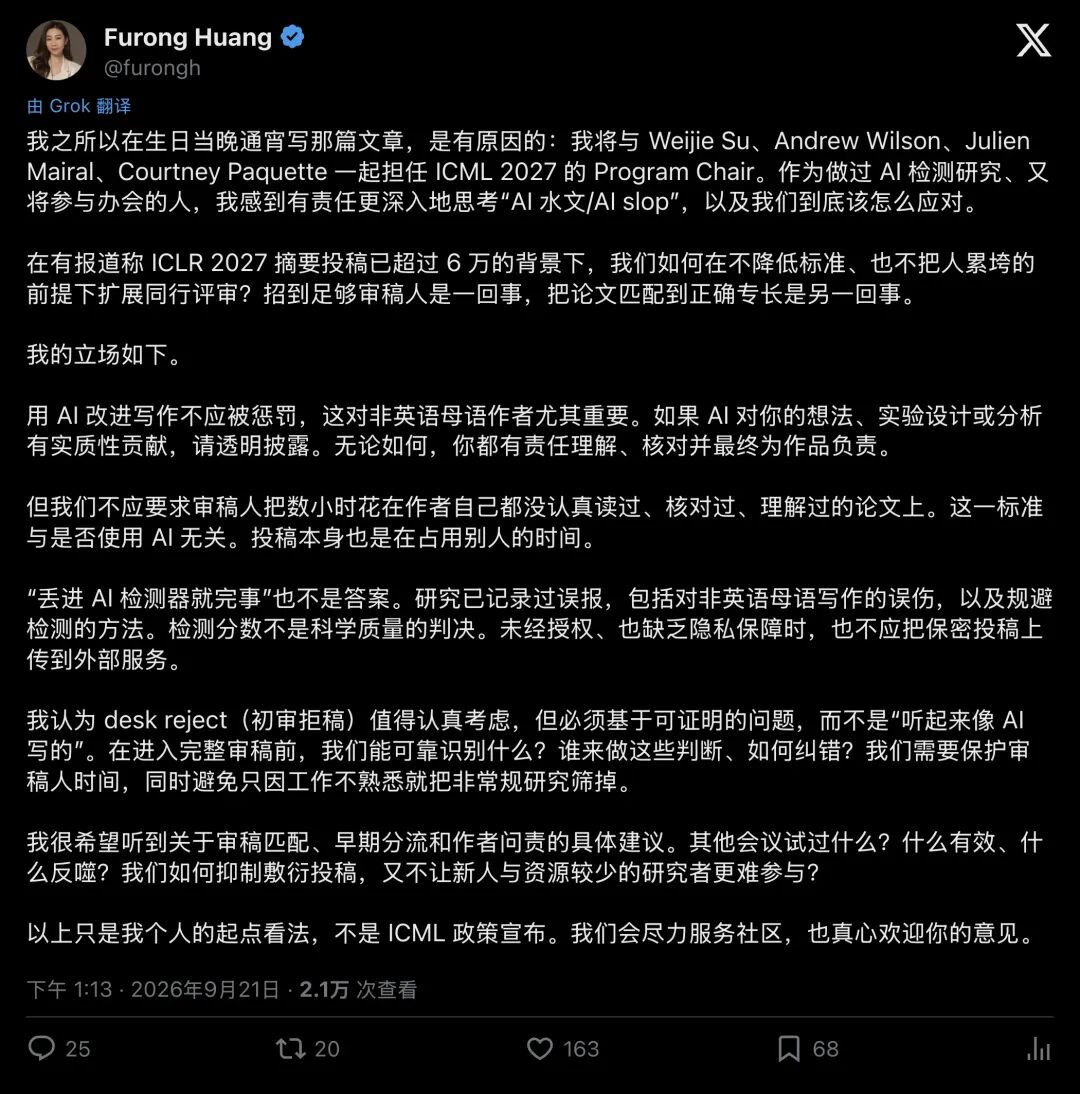
▲ 黄芙蓉教授在生日当晚通宵发文,系统阐述人机协作与论文评审的底线
黄芙蓉坦言,自己作为非英语母语者,也经常使用 AI 进行英文润色。她旗帜鲜明地提出:绝不能因为作者用了 AI 润色就惩罚他们,但审稿人也绝不该把数小时的宝贵生命,浪费在作者自己都没核实过的稿件上!
那么,直接在投稿系统里挂一个“AI 文本检测器”,给每篇论文打分,超过阈值就直接拒稿(Desk Reject)行不行?
黄芙蓉给出了坚决的否定:不行!
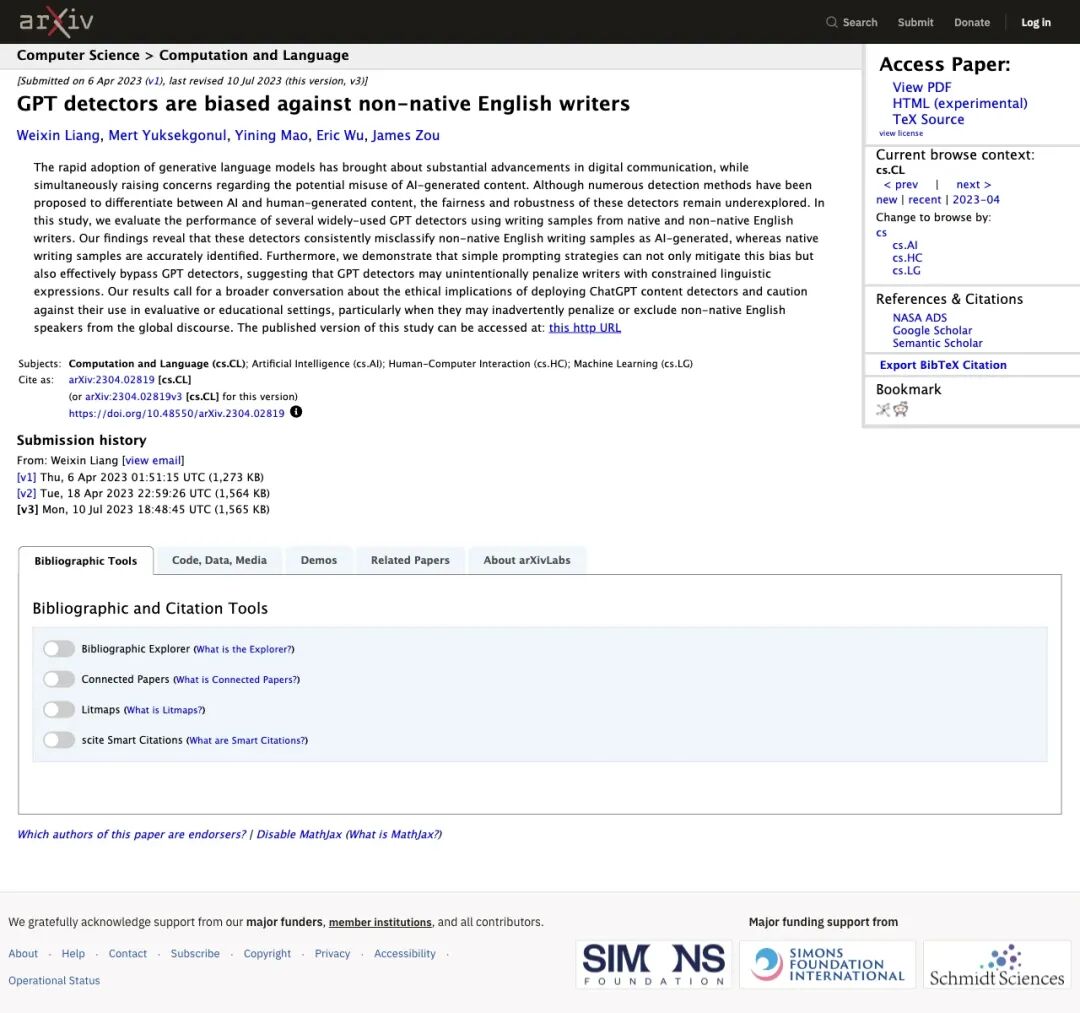
▲ 经典研究表明:市面上的 AI 检测器在非母语作者的作文中,误报率(假阳性)竟高达 61.22%
黄芙蓉引述了多项严谨的研究:
- 歧视非母语学者
:检测器对词汇简单、句式规整的文章极度敏感。在针对非母语作者的托福作文测试中,多个主流检测器的误报率竟然高达 61.22%! - 泄密与合规风险
:把学者未发表的保密投稿,随手传给第三方商业检测工具,存在巨大的隐私与学术泄密风险。 - 治标不治本
:只要稍作 Prompt 改写,检测器就会失效。同时,“用了 AI 写句子”不等于“研究作假”,“检测不出 AI”也不等于“实验真实”。
尽管随后有检测工具开发者 Jenna Russell 拿最新数据反驳,称新版算法对非母语作者的误报已大幅下降,但这同样呼应了黄芙蓉的担忧:算法规则随时调整,如果把学术命运寄托在黑盒检测器的分数上,只会带来更大的混乱与不公。
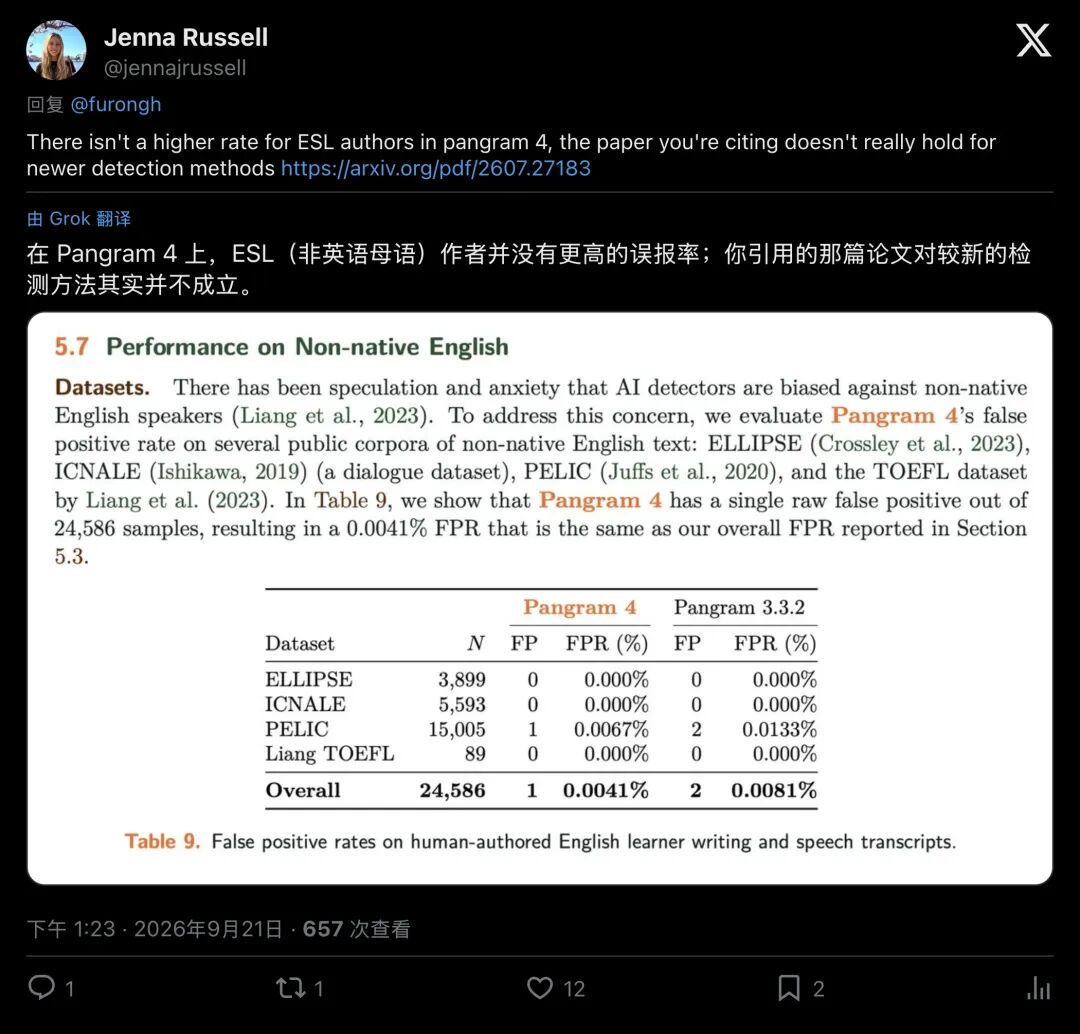
▲ 检测工具开发者与经典文献之间的争论,暴露了“靠工具抓 AI”的技术脆弱性
03思想实验:当大模型写出一篇完美的论文,“作者”还算学者吗?
前 Google Brain 核心研究员 Lucas Beyer 在回复黄芙蓉时,抛出了一个极其毒辣的思想实验:
“假设大模型独立写出了一篇完整、正确且高质量的论文。你作为审稿人,只看得到这篇 PDF。
你根本无法分辨:作者究竟消化吸收了这些知识,还是自己毫无核验,随手把一颗『水文手榴弹』扔过了篱笆?”
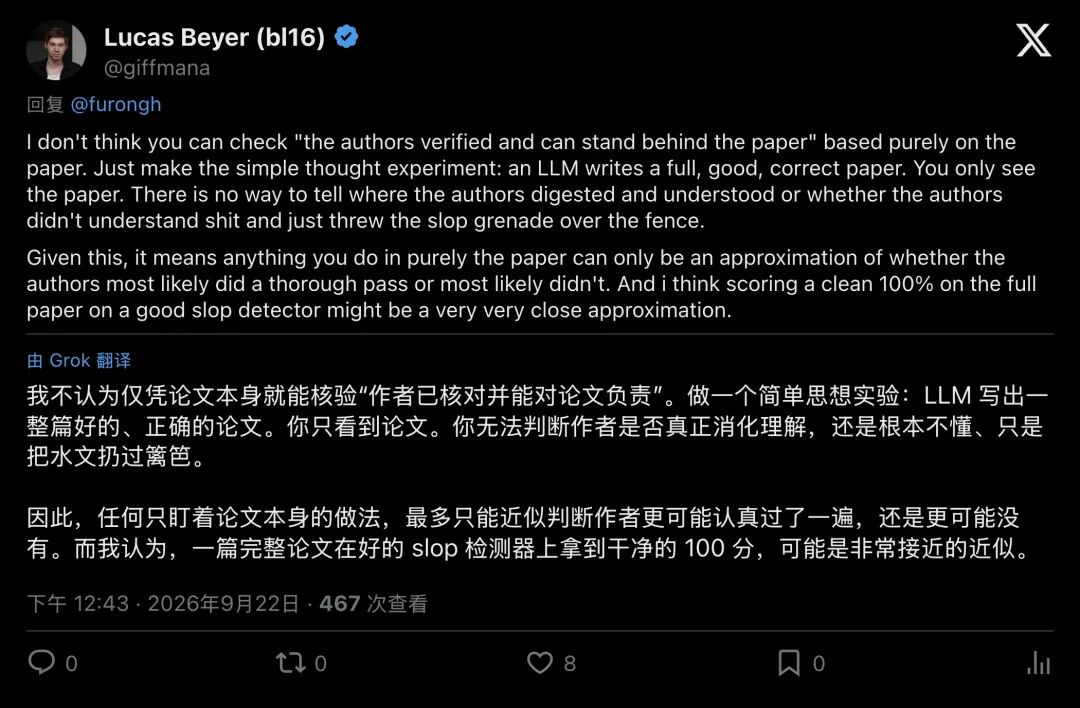
▲ Lucas Beyer 尖锐指出:仅凭一纸 PDF,人类根本无法验证作者是否具备负责的能力
这个思想实验直击学术制度的七寸
传统的同行评审,默认建立在“作者花费了巨大心血,因此会对自己的声誉负责”的君子协定之上。
但现在,当生成论文的成本变成点击一下鼠标,投机者就可以批量生成成百上千篇“像模像样”的论文。只要其中有一篇碰运气被某个疲惫的审稿人放行,投机者就赢了;而被拒掉的剩下99篇垃圾,则由整个学术界的志愿者用无偿加班来买单。
这种极其不对称的博弈,正在把严肃学者逼出审稿系统。
04顶会的自救战:限流、追杀假文献、甚至公开“游街”
为了在 2027 年的洪峰中活下来,各大顶会已经开始动用雷霆手段。
ICLR 官方在 9 月初紧急颁布了被称为“史上最严限流令”的新规:
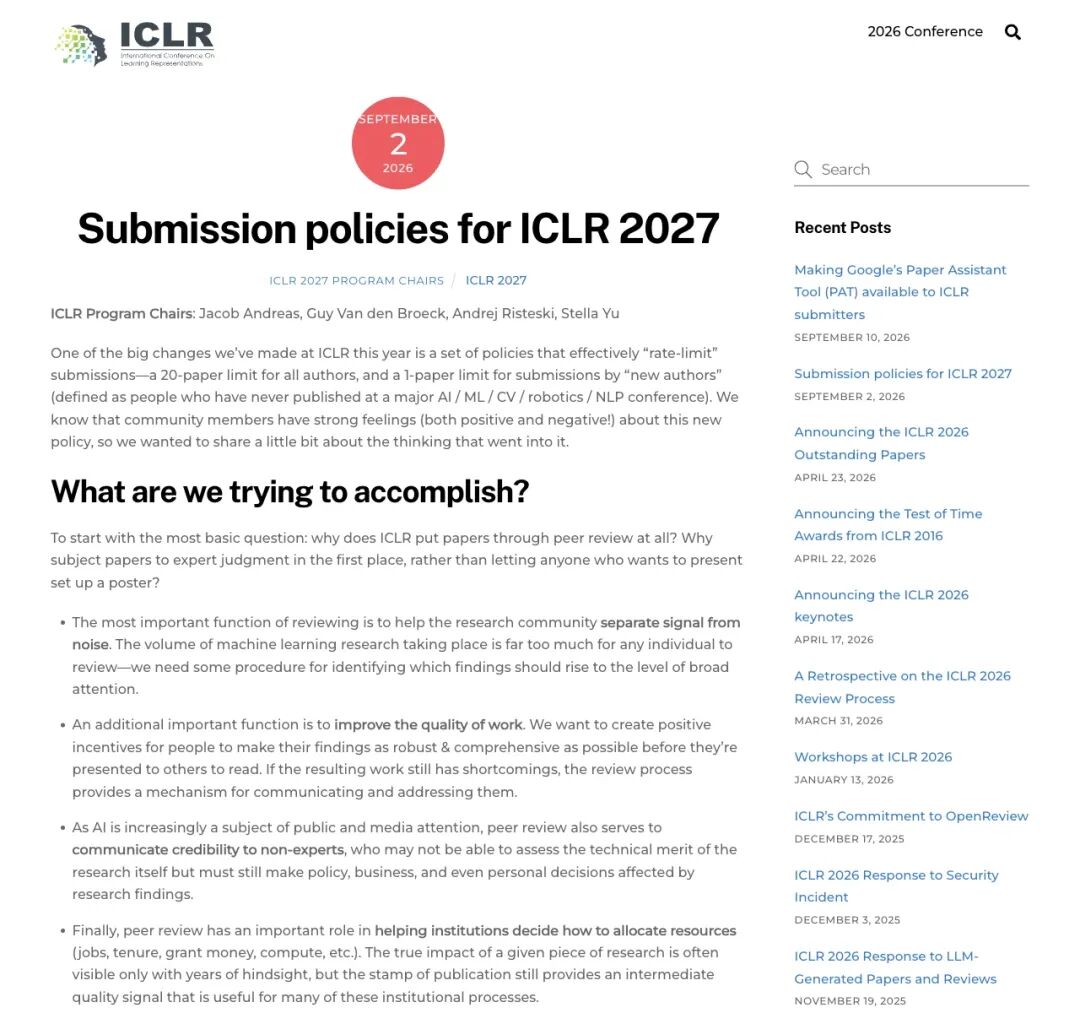
▲ ICLR 2027 官方限流政策:哪怕你是顶级实验室大牛,最多也只能挂名 20 篇
- 硬性封顶
:任何学者(无论多大牌的 PI),在本次会议中最多只能挂名 20 篇投稿。 - 新人严卡
:如果一个团队里没有任何拥有顶会发表记录的“互惠审稿人”(Reciprocal Reviewer),则每位作者最多只能投 1 篇。 - 秋后算账与实名公开
:审稿结束后,所有论文(包括被拒稿和中途撤稿的)将全部在 OpenReview 上公开作者实名!
你敢投投机水文?会议就敢让你的名字在全世界学术圈永久“裸奔”!
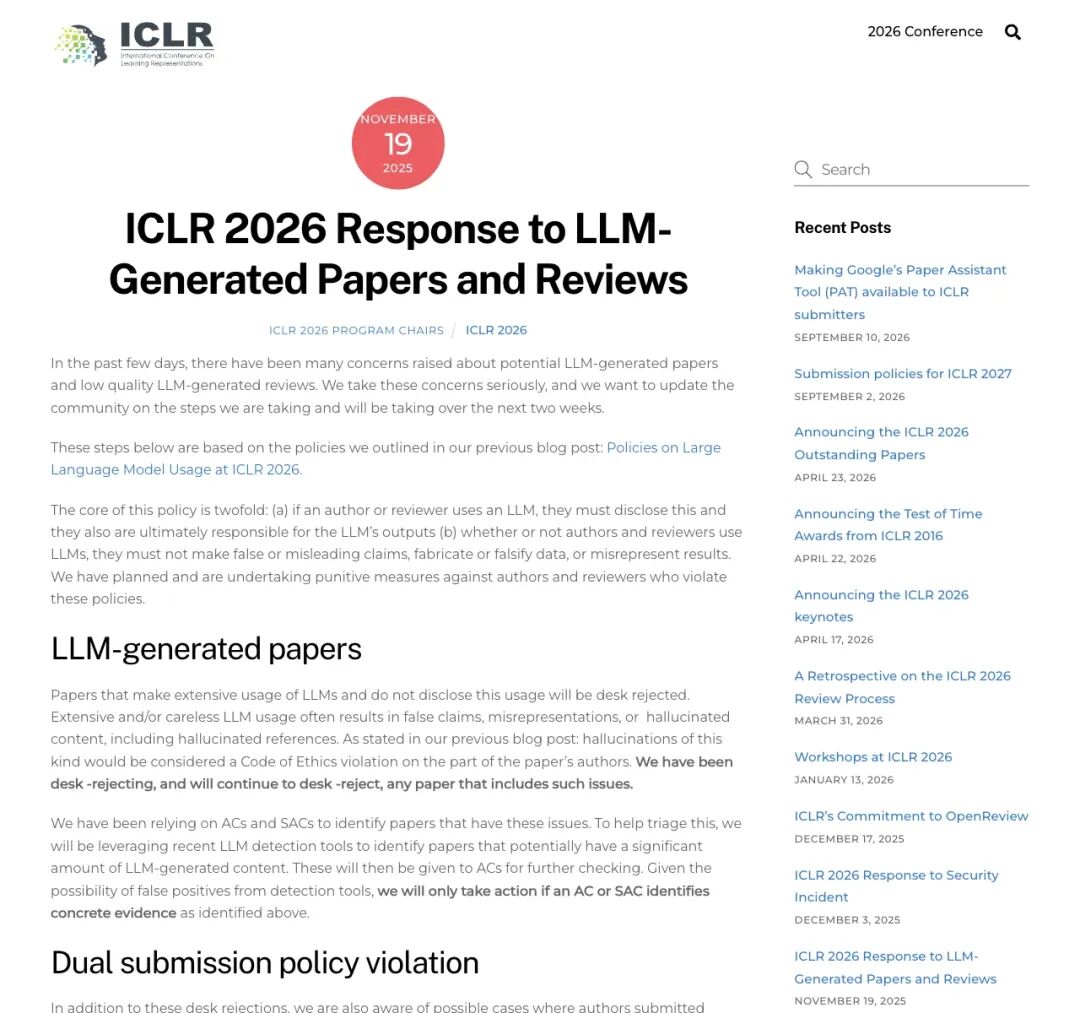
▲ 上一届会议的执法经验:通过算法与多轮人工核查,定点清除“幻觉参考文献”
上一届的实战经验更为残酷ICLR 2026 组委会曾动用自动化程序,将论文引用的所有参考文献与全球真实论文数据库进行交叉比对。
结果令人触目惊心:大量论文中出现了大模型凭空捏造的虚假学者姓名、假论文标题、假期刊卷号!对这种带有确定性造假证据的稿件,组委会毫不留情地实施了批量初审拒稿(Desk Reject)。
05毒辣洞察:学术界的“恶性通胀”,本质是注意力被抽干
面对浩浩荡荡的 6 万篇摘要,社区的药方越来越激进。
著名学者 Tal Linzen 提议:强制绑定作者的 ORCID 实名代码,对低质论文毫不手软地大比例初审秒拒(Desk reject liberally),并把被拒论文的名字直接公之于众。
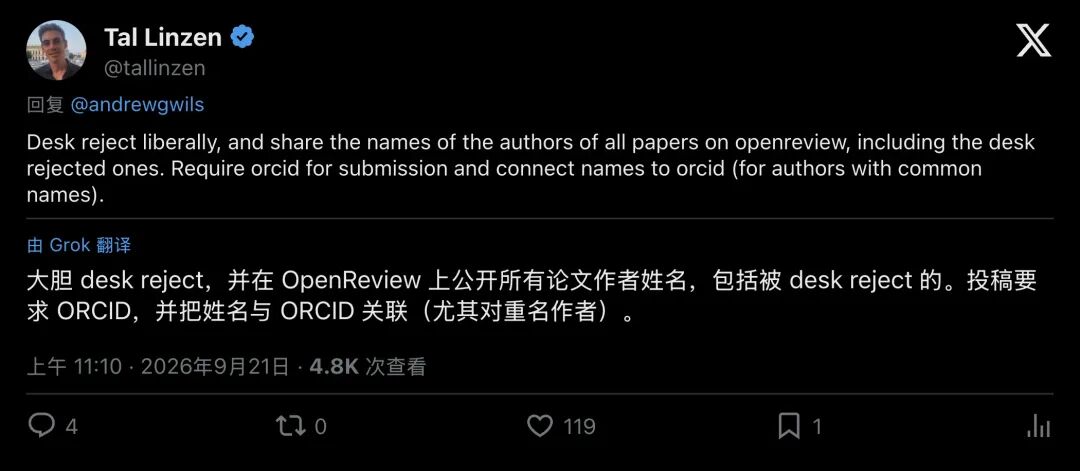
▲ Tal Linzen 的回复:用彻底的透明度和大胆的拒稿,保护审稿人的时间
机器学习顶尖学者 邢波(Eric Xing) 更是语出惊人:他认为顶级学术会议应该效仿《Nature》和《Science》,在初审阶段直接砍掉 80% 到 90% 的稿件!
邢波指出:“最大”和“最好”从来无法兼得如果不对入口实行铁血纪律,顶会作为“学术可信背书”的价值将被彻底稀释成废纸。
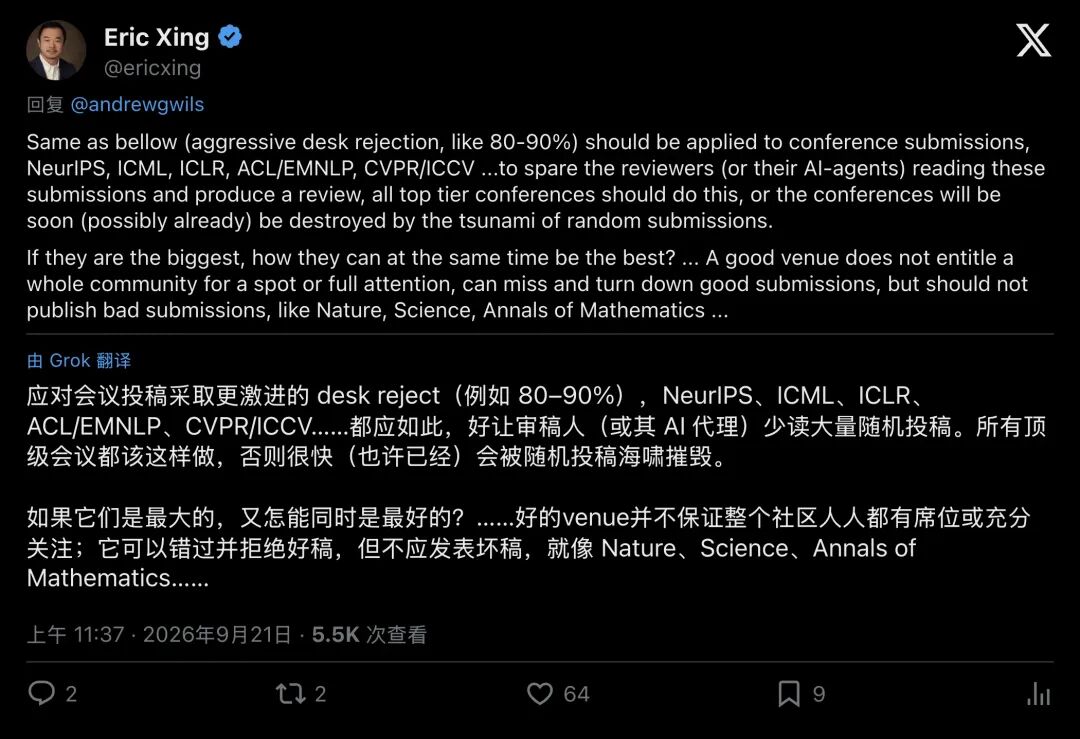
▲ 邢波直言:顶会不应该当无限制的免费垃圾场,敢于把关才是顶级刊物的底气
多伦多大学教授 Dan Roy 则一针见血地指出了这场危机的本质:
“把 PDF 上传到 arXiv 毫无门槛,学术会议的立身之本在于分配人类顶尖专家的『稀缺注意力』。”
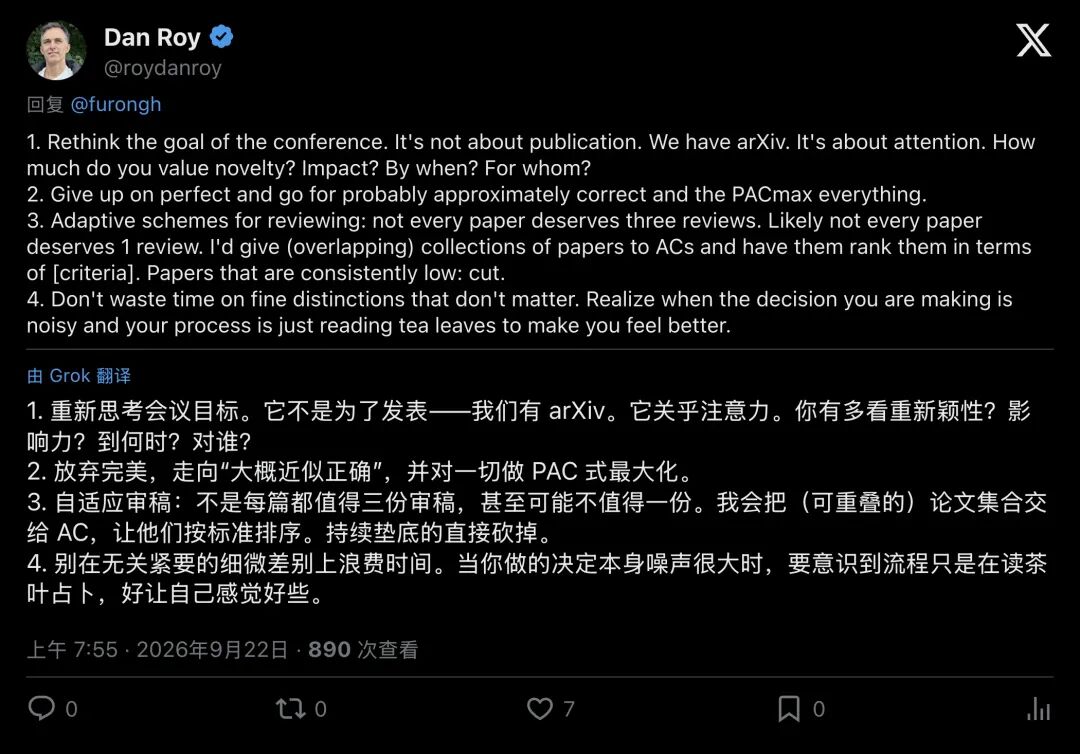
▲ Dan Roy 认为:学术会议的核心价值在于对人类专家的注意力进行有效分配
在过去,写论文的物理门槛充当了“信用质押”。而今天,大模型引发了学术文本的“超级恶性通胀”。
当任何人都能一键印钞(生成论文)时,用来为钞票背书的黄金(人类学者的评审时间)却分秒未增。
有人甚至提出了科幻般的自嘲方案:既然人类写不过 AI,审不过 AI,那干脆以后投稿强制附带代码验证接口和结构化证据链,让 AI Agent 去审 AI Agent 写的论文,人类只看最后的决策报表。
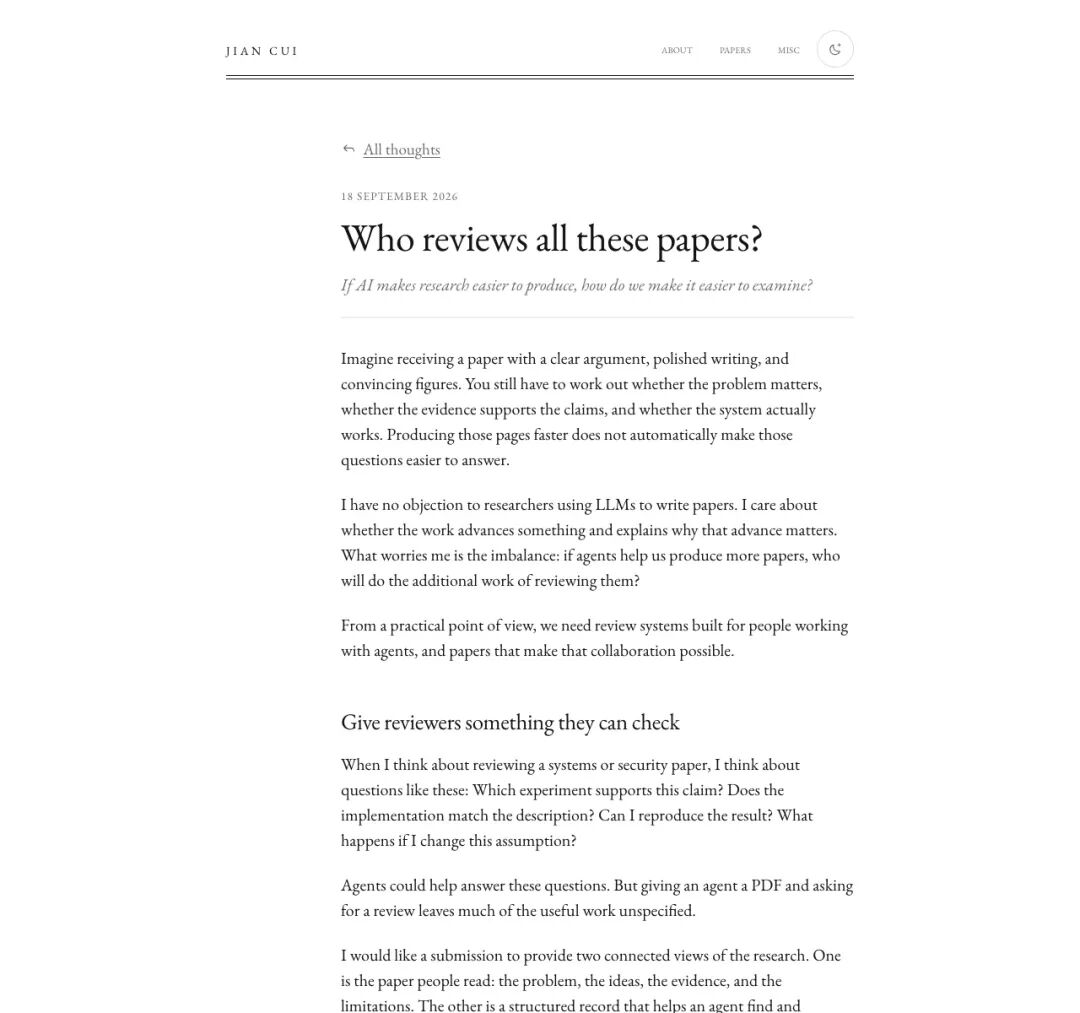
▲ 学者 Jian Cui 发问:究竟谁来读完这些论文?未来的评审是否不得不变成人机协同的证据链验证?
06淘金热退场,谁在裸泳?
从 2015 年的 143 篇,到 2027 年的 60,000 篇。
从 143 篇跃升到 60,000 篇,庞大的数字折射出学术生态的剧变。当 AI 科学家教会计算机引经据典、高谈阔论时,自己亲手搭建的学术殿堂也迅速被大量拟态噪音所淹没。
科技并未摧毁学术,却在加速淘汰平庸的研究。
当生成一篇看似高深严谨的论文变得毫无门槛,学界终于被迫思考那个最原始的问题:
在去除掉华丽的辞藻、工整的排版和复杂的公式伪装之后,你这项研究,到底为人类的认知边界贡献了什么哪怕一微米的真实推进?