ARTICLE · 1073921
改一个词AI自己重写!阶跃星辰突袭开源内部神器,大模型标注彻底变天
如果你去问任何一个大模型算法工程师,训练大模型最痛苦、最昂贵、最容易让人崩溃的环节是什么?
十个人里有九个会咬着牙吐出两个字:标注。
为了教会 AI 说人话、办人事,成千上万的标注员每天对着屏幕通宵达旦。模型胡说八道了一整段,人就得捏着鼻子从头到尾重写一遍;或者生成四五个差劲的候选答案,让人在里面矮子里面拔高个。
成百上千万元的人力消耗背后,还藏着一个技术死结:人改得越完美,写出的句子越精妙,大模型反而越学不会。 过于精致的人工造句,脱离了模型原本的概率表达习惯。
近日,国内大模型公司阶跃星辰(StepFun)联合厦门大学,正式把内部打磨沉淀两年的核心数据标注与检视工具 onPanda 开源。
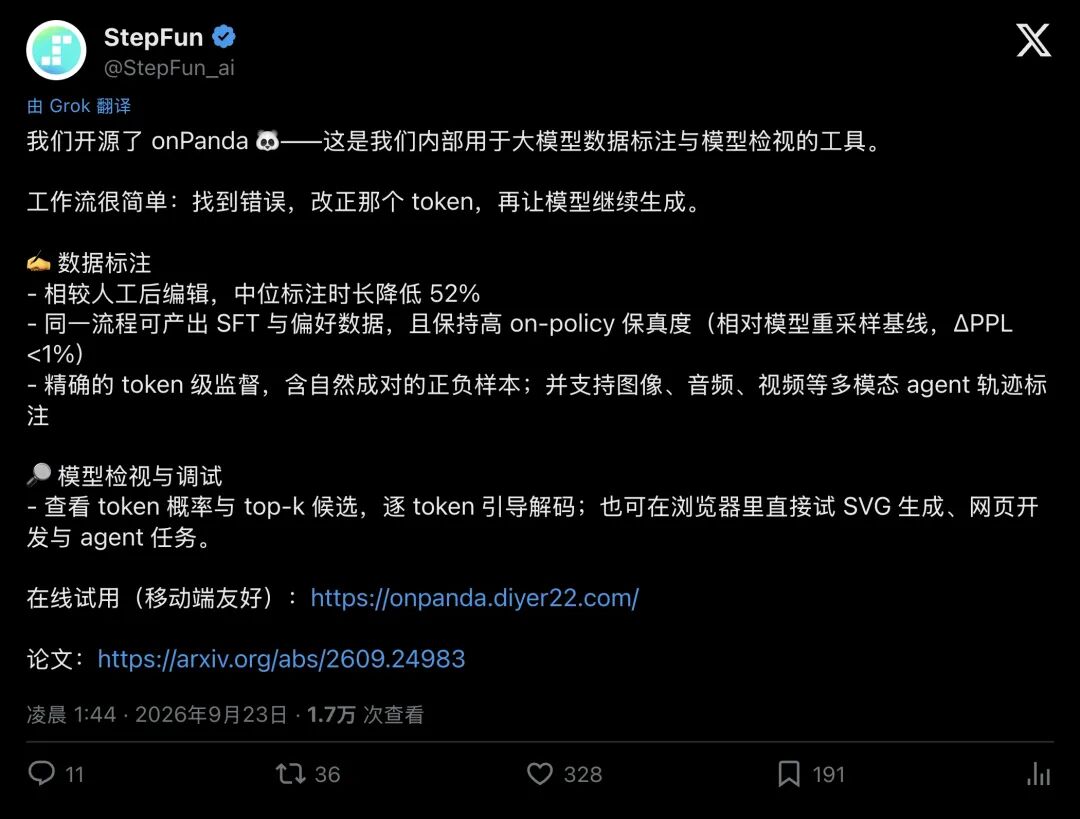
▲ 阶跃星辰官方账号公布 onPanda 开源
它的核心理念极其简单,却粗暴有效到令人发指:
人在阅读大模型的回答时,不需要重写全篇,只需要找到“第一个跑偏的词”,在候选菜单里点一下,或者手打纠正;系统立刻切断后面所有废话,让模型带着纠正后的前缀,自己重新往下编!
标注时间直接砍掉 52%,模型输出的“原汁原味度”(on-policy 保真度)困惑度偏差不到 1%。
在技术社区里,有开发者对这款工具给出了精辟概括:
“终于有一款工具,让开发者把 Token 当作前行的方向盘,甩掉了只能事后复盘的后视镜。”
01标注员的“痛苦面具”:大模型对齐的老死结
要理解 onPanda 为什么能引发技术圈的震动,必须先搞懂当今大模型训练最大的隐形暗礁。
今天我们让大模型变得听话、聪明,主要靠两条路:SFT(监督微调) 和 RLHF/偏好排序。
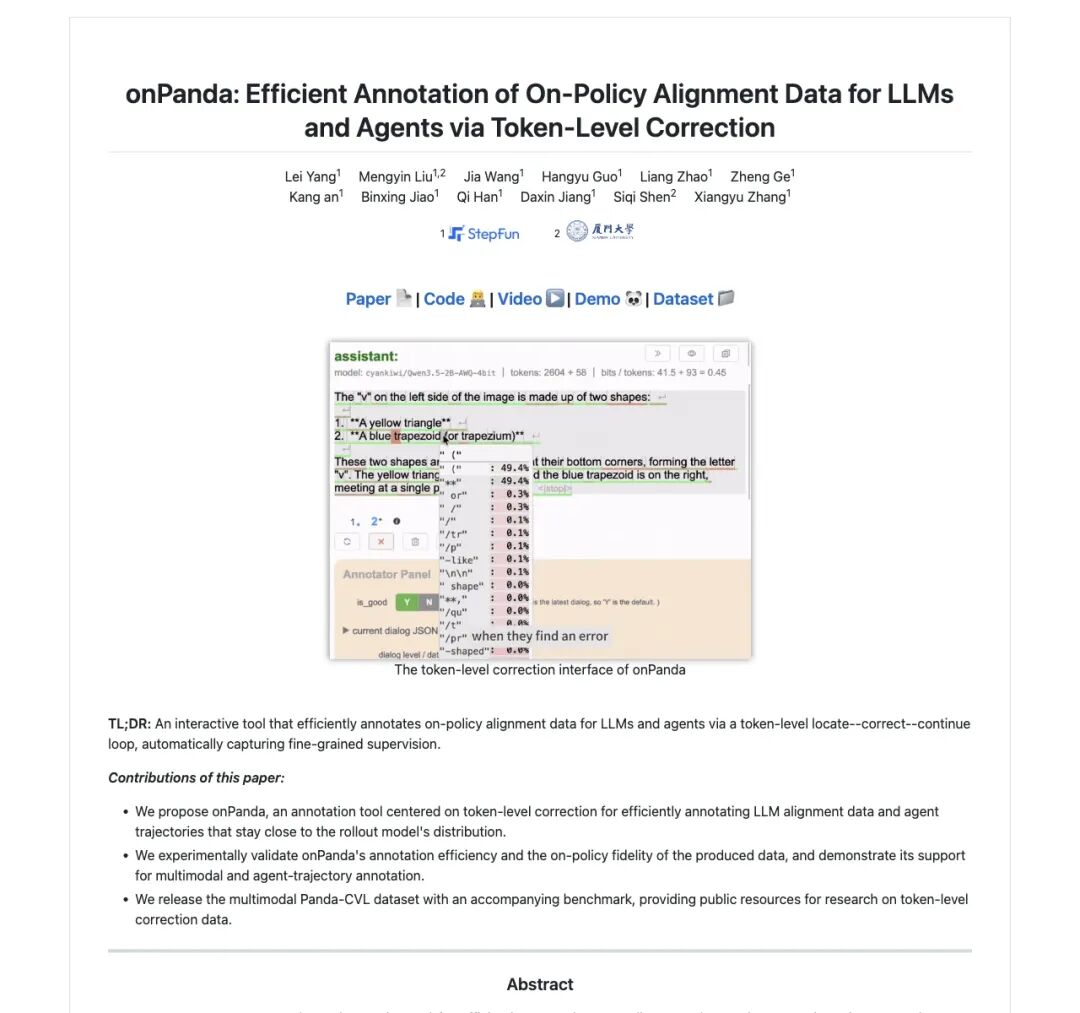
▲ onPanda 学术项目主页与论文概览
但在实际生产流水线上,这两条路几乎全是坑:
- 第一条路:人工后编辑(SFT)
模型生成了一段 500 字的回答,第 20 个字开始胡思乱想。传统的做法是标注员把剩下 480 个字全删了,或者自己手动精修。这种方式又贵又慢。 并且人类写出来的工整句子,在数学分布上属于 Off-policy(策略外数据),模型平时几乎采样不出这种表达。强行学习这类数据,容易引起混淆,后续进行强化学习时还会产生严重的分布偏移。 - 第二条路:四选一偏好排序(RLHF)
既然人写太累,那就让模型同时生成 4 条回答,让人排出好坏。成本是低了,但监督粒度太粗。模型到底是在哪一句话、哪一个字开始走偏的?标签说不清楚。而且如果模型 4 条全都答错了,标注员只能在一堆垃圾里选一个“相对不太烂的”,根本无法把模型拉出错误的泥潭。
遇到 Agent(智能体)调用工具,灾难更是翻倍。模型写代码、调 API,只要第一步参数输错了一个字母,后面的所有环境反馈全部当场报废。
人如果事后改文本,无法在真实环境里立刻重跑,整条轨迹直接作废。
阶跃星辰的研究者们花了两年时间,只为解决一个核心问题:能不能把人类的干预,压缩在少数出现偏差的词上,剩下的内容继续交给模型自主生成?
02核心交互:找错、改词、继续!
onPanda 的名字展开,叫 on-Policy Alignment Data Annotator(面向策略内对齐数据的标注器)。
它的工作台界面,长得就像给文本装上了一副 X 光透视镜。
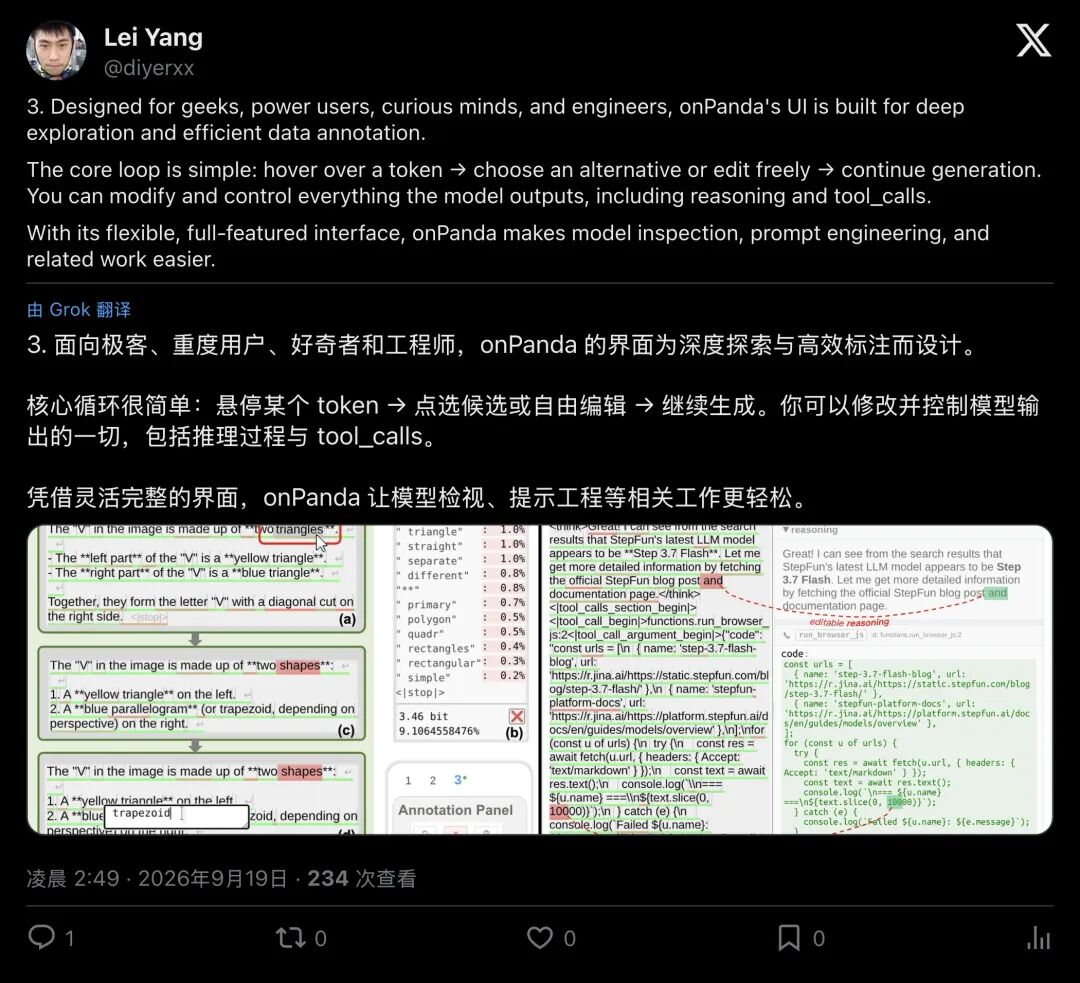
▲ 作者演示 onPanda 核心循环:彩色 Token 块与候选浮层
进入系统后,模型生成的每一句话都被拆成了一个个彩色的 Token(字词块):
- 偏绿色
:代表模型极度自信,概率极高; - 偏红色
:代表模型在这里犹豫不决,正在硬着头皮瞎猜。
标注员在阅读时,眼睛只需要跟着红绿提示走:
- 悬停定位
:鼠标停在疑似出错的字词上,立刻弹窗显示模型在该位置的 Top-K 备选词与概率; - 点选或手打
:如果备选词里有正确答案,轻轻一点即完成纠错;如果没有,双击直接手打改写; - 截断续写
:系统瞬间删掉该位置之后的所有文本,带着被纠正的前缀,命令模型立刻向后重写; - 循环往复
:直到整段输出完全合格。
▲ 知名 AI 论文博主 AK 分享 onPanda
这套流程操作顺畅,其核心价值更体现在随之生成的数据副产物上。
在这一连串“找错,改词,续写”的过程中,整个系统在后台自动生长出一棵标注树:
初始生成的错误草稿,是天生的负例; 最终合格的版本,是完美的正例; 中间每一次分叉,都在精准的 Token 坐标上,留下了位置完全对齐的偏好对与过程监督信号(Process Supervision)!
单次标注流程,就能同时沉淀 SFT 数据、偏好排序数据与 Token 级纠错监督,达成一举多得的效果。
0352% 提速与 1% 偏差:论文实测数据
在公开的预印本论文(arXiv:2609.24983)中,研究团队公布了严谨的受控对比实验。
他们找来 3 位专业标注员,抽取了 21 条图像描述任务,采用严格的拉丁方轮换实验,将 onPanda 与业内主流的后编辑平台 POTATO 以及偏好排序平台 Argilla 进行了正面对决。
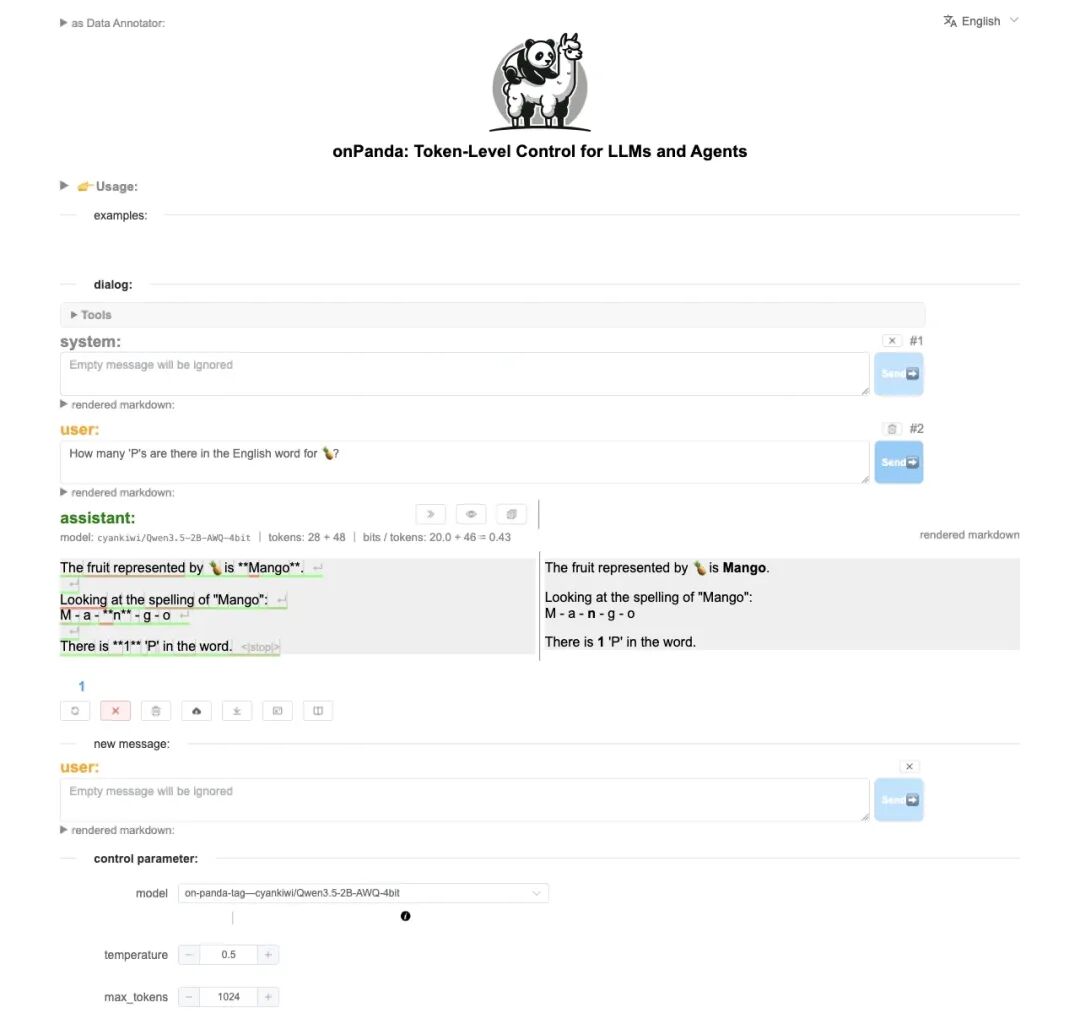
▲ 公开 Demo 工作台支持交互式测试
实验结果极其亮眼:
- 耗时腰斩
:传统后编辑中位耗时约 681 秒/题,onPanda 降到了约 330 秒/题,效率直接提升了 52%! - 保真度出众
:用模型测算生成文本的困惑度(PPL),人工后编辑会让困惑度大幅飙升,偏离模型固有的表述概率;而 onPanda 带来的困惑度变化 $\Delta\text{PPL} < 1%$,几乎完整保留了模型自身的策略分布。 - 极度稀疏的人工干预
:根据生产环境的大规模统计,在最终生成的合格回答里,97% 的 Token 依然是由模型自主生成的,人类的点选和手打加起来只占了不到 3%。
为了证明这套机制不仅能用在文字聊天上,团队还同步开源了中文多模态纠错基准 Panda-CVL,并且把支持延伸到了音频、视频、以及浏览器内直接可跑的 Browser-Agent 和代码环境。
04社区实测:有人欢呼,有人挑刺
开源之后,全球技术极客和开发者第一时间涌入了网页 Demo。
技术社区的反馈来得极快,而且非常真实地戳中了工具的毛刺与边界。
国内开发者 Hanmin Wang 直接用线上默认的小模型测了一道经典的数水果题。模型一开始把菠萝(pineapple)误认成了芒果(mango),导致后面数字母“P”全数错了。
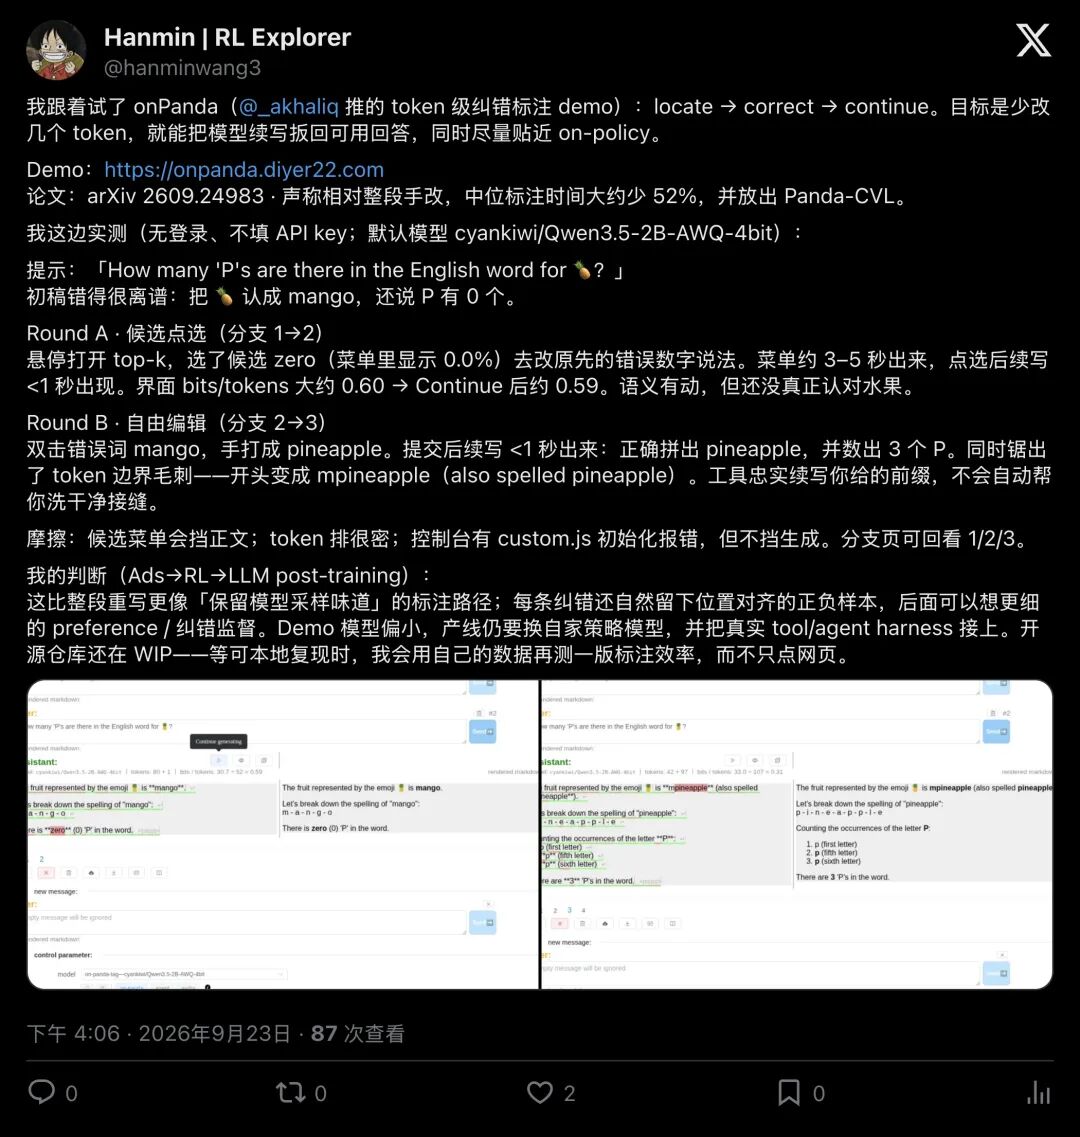
▲ 社区开发者实测:展示从错误识别到纠错续写的完整过程
实测者通过双击将 mango 改为 pineapple,模型瞬间领会意图,向后忠实续写,成功数出了 3 个字母 P。
但实测中也暴露了一个非常有趣的底层细节:如果手打时边界没对齐,模型会留下类似 mpineapple 这样的接缝毛刺。因为系统不会擅自“洗白”人工输入,而是毫无保留地从底层字节硬生生续写下去。
与此同时,推特上也出现了极具价值的学术交锋。
德国研究者 Mathias Heinke 发推提出尖锐质疑:“52% 的提速确实诱人,但论文里只有 3 个标注员和 21 条图像描述。在极其复杂的 Agent 场景下,还没有受控对比数据,在盲目乐观之前我想看到更扎实的证据。”
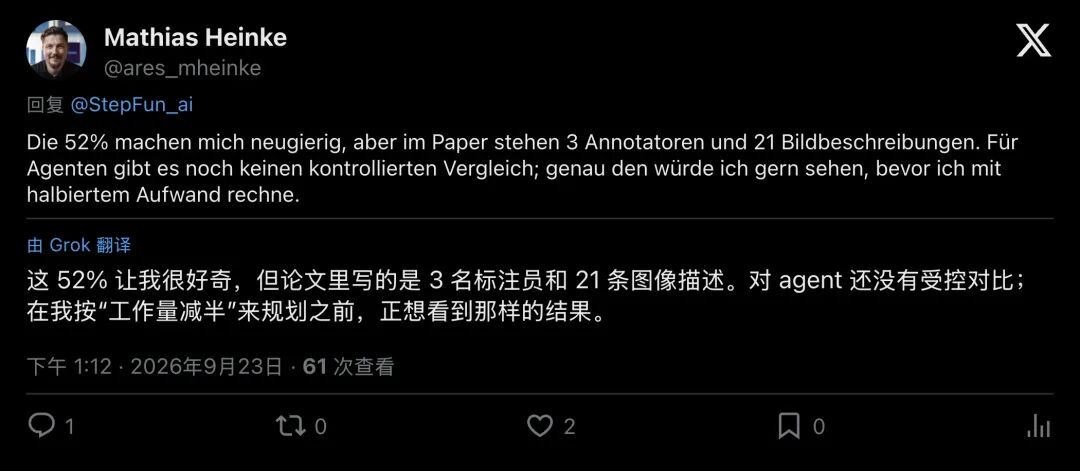
▲ 德国研究者 Mathias Heinke 在推特公开提出审慎质疑
作者 Lei Yang(@diyerxx)随后坦诚回应:Agent 轨迹标注极其复杂,目前工业界甚至很难找到一个通用的 Agent 轨迹 SFT 标注工具作为基准。但这正是 onPanda 尝试填补的空白。
这种不回避问题、直接在阳光下讨论边界的开源态度,赢得了社区的大量好感。
05深度洞察:大模型对齐的“交互式变速箱”
站在技术演进的历史长河来看,onPanda 的出现绝非偶然,它是一次深刻的技术返祖与升维。
早在十年前的 2014 年,人机交互与自然语言处理领域就曾提出过 交互式机器翻译(Interactive Machine Translation) 的构想:译员改一个错词,机器实时重写后半句。
但随着深度学习爆发,大家迷信“端到端全自动”,这个优雅的交互逻辑被雪藏了整整十年。
直到大模型撞上了 RLHF 粗放、SFT 昂贵、Agent 易崩 的三堵高墙,人们才猛然惊醒:人类无需扮演通读全篇、事后改卷的“阅卷老师”,更适合担任在路口轻轻拨动方向盘的“领航员”。
OpenAI 此前在数学领域用 PRM800K 数据集证明了“过程监督”(一步步纠错)远比“只看最终对错”更有效。但 OpenAI 的做法需要标注员额外花一轮精力专门去给步骤打分。
onPanda 的聪明之处在于,它把过程监督变成了正常标注流程下的免费副产品。
为了得到一份正确答案所付出的每一次点击、每一次修改,系统都精准记下了“模型在哪个词动了邪念,人类选了哪个正道”。
目前,onPanda 已经在 GitHub 完全开源(MIT 协议),支持用 npx -y @on-panda/serve@latest 一键本地部署,并配齐了解析工具库。
在大模型 Scaling Law 逼近数据天花板的今天,高质量、高保真、带过程监督的对齐数据正在成为新的决胜战场。阶跃星辰把自家跑了两年的生产级军火库推到台前,为所有苦于数据标注的团队送上了一把顺手的重型武器,更为行业指明了下一代人类与 AI 协同进化的标准姿态。
极具价值的技术演进,重在把人类的认知负担降到最低,让机器自主把剩下的路走完。