ARTICLE · 1073930
硅谷选读·AI|9.24 必读|Claude 生命科学、Google 基础设施更新及更多
硅谷选读
AI · 2026.09.24
这两天 AI 圈照例又有不少进展。生物和生命科学方向最近动静特别多,说实话,我也说不好这些进展是好是坏。另一个越来越大的话题是隐私。
Google 在好几个方向上慢慢往前推。它的语音合成已经很强,3.8 又往前走了一步,我自己试了,很自然,跟真人录的播客差不多。Cloud 这边,前几天它刚发了 AX(Agent Executor)的新版本,一个用来大规模跑 agent 的底层平台,现在又出了下面这套隐私方案。Google 铺基础设施的路子,和 OpenAI、Anthropic 这些做前沿模型的公司不太一样,但它盯的都是真正值得盯的事,很值得看。
写一句描述,Gemini 就能造出一个新声音
图源:Google
以前用 AI 配音,基本是在一排现成的声音里挑一个,挑来挑去总差点意思。Google 这次换了个做法:想要什么声音,直接用文字描述出来。
昨天 Google 发了两个新的语音合成模型。大一点的 Gemini 3.8 Flash TTS,比如你可以写“深夜电台的主持人,嗓音低,语速慢”,它就现场造出一个原本不存在的声音,存下来可以反复用。台词也能一句一句地导:哪句压低嗓子,哪里停一下,哪里插一声“嗯哼”。小一点的 Flash-Lite 走量,给批量配音和语音客服用。
最敏感的是克隆。给它一段 30 秒的录音,就能复刻出这个人的声音。Google 设的关卡是:必须附上声音主人亲口说的同意录音,系统核对是同一个人才放行;生成的每段音频都埋了听不出来的水印。欧洲、英国、印度和美国部分州,暂时用不了克隆。
开发者现在可以在 Google AI Studio 里试。换声诈骗这几年已经不稀奇,这道同意录音的关能不能拦住坏人,要等用的人多了才知道。
原文deepmind.google/blog/say-hello-to-gemini-38-text-to-speech
Google 想让 AI 在 cloud 上记住你,而且它自己看不到
图源:Google
AI 助手要好用,就得记得你:上周聊到哪了,你在智能眼镜上看过的组装说明,换到电脑上还能接着看。可记的东西一多,就只能存到 cloud 上,等于把自己的生活放进别人的服务器。
Google 之前推出过 Private AI Compute,让设备把复杂任务交给 cloud 上一块隔离的硬件去算。问题是它和业内类似的方案一样,任务一结束就把上下文清空,什么都不留。
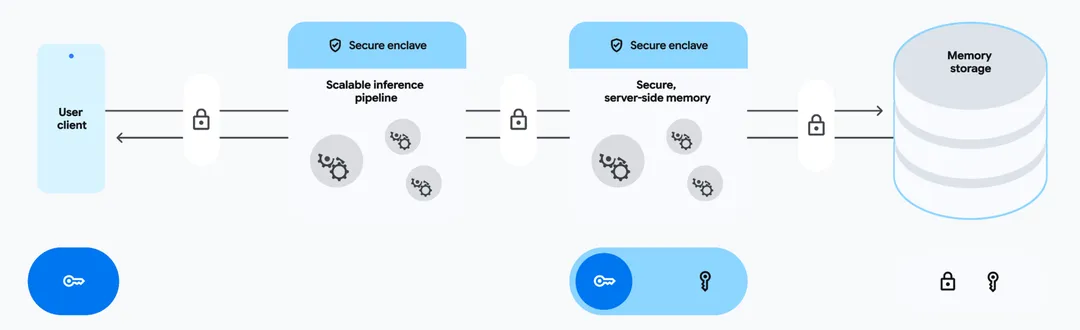
这次 Google 公布了补上记忆的办法。每个人的记忆单独加密存在 cloud 上,钥匙只放在你自己的设备里。AI 要用的时候,设备通过加密通道连进 cloud 上的隔离区,数据在里面临时解开,处理完、存好新内容,马上重新锁上。按 Google 的说法,连它自己也读不到。
为了让人信,它还公开了一份改不了的服务器软件记录,设备发数据前可以先核对软件有没有被动过,另外附了一家安全公司的独立审计。
不过这还只是技术方案。Google 没说用在哪款产品、什么时候上线。这把锁到底牢不牢,要看安全圈拿到白皮书以后怎么挑毛病。
原文deepmind.google/blog/advancing-private-ai-compute-with-secure-server-side-memory
Claude 翻 DNA 数据,找到一个长得像 CRISPR 的新系统
图源:Anthropic
生物这边,先从 CRISPR 说起。人的遗传信息写在 DNA 上,像一本很长的说明书,不少病就出在几个字写错了。CRISPR 能在指定位置把 DNA 剪开、改掉,这就是常说的“基因编辑”。它拿过诺贝尔奖,已经有用它做的疗法获批。
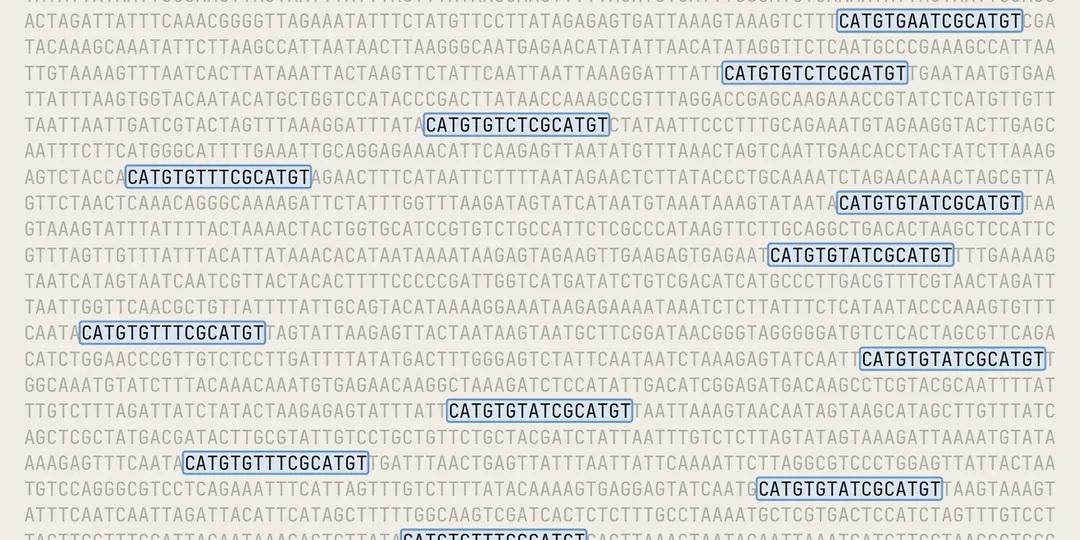
它不是人发明的,是从细菌身上找到的。最早大家只注意到细菌 DNA 里有一串怪东西:同一小段序列隔一段就重复一次,排得整整齐齐,这叫“重复阵列”。后来才弄明白,细菌靠它记住来过的病毒,下次认出来就剪掉。人把这套本事借过来,才有了基因编辑。所以生物学家一直在 DNA 数据库里翻,找这种长得不对劲的地方。专家做一轮,要几周到几个月。
Anthropic 今年春天组了个生物团队,在湾区建了自己的实验室。研究员只写了开头的 prompt,让 Claude 去找新的逆转录酶。酶是细胞里干活的蛋白质;RNA 可以理解成 DNA 的抄本,逆转录酶干的是反方向的活,把 RNA 抄回 DNA。近千个 Claude agent 翻了将近一天,其中一个盯上了一种怪酶,藏在专门感染细菌的病毒里。这个酶以前有人见过,可它旁边也有一串整整齐齐的重复片段,没人注意到。Claude 当时的原话是:“这是……像 CRISPR 的重复阵列?!”它接着数重复、量间距、查文献,确认没人报道过,才交给人复核。团队给它起名 ART。
ART 到底干什么,现在还不知道。初步实验只看到,这串重复会转成一段段短 RNA。CRISPR 正是靠这种短 RNA 认准该剪哪里,所以 ART 可能也有类似的机制。CRISPR 基因编辑的开创者之一张锋看了预印本,说这个发现确实耐人寻味,值得接着查。它能不能成为下一件基因工具,得等实验室的结果。
原文anthropic.com/news/claude-discovers-novel-enzyme-system
Kimi K3 学会少想废话,token 省了四成
图源:Fireworks AI
用过“深度思考”的人都见过:问一句,模型先自言自语一大段,才给答案。这段思考按 token 收钱。Fireworks 说,像月之暗面的 Kimi K3 这样的推理模型,生成的 token 大部分都花在了思考上,写代码的 agent 一轮轮跑下来,账单涨得很快。
最直接的办法是把思考力度调低。Fireworks 的用户试过,答案质量掉得太多。所以他们换了个思路:不让模型少想,而是教它别想废话。
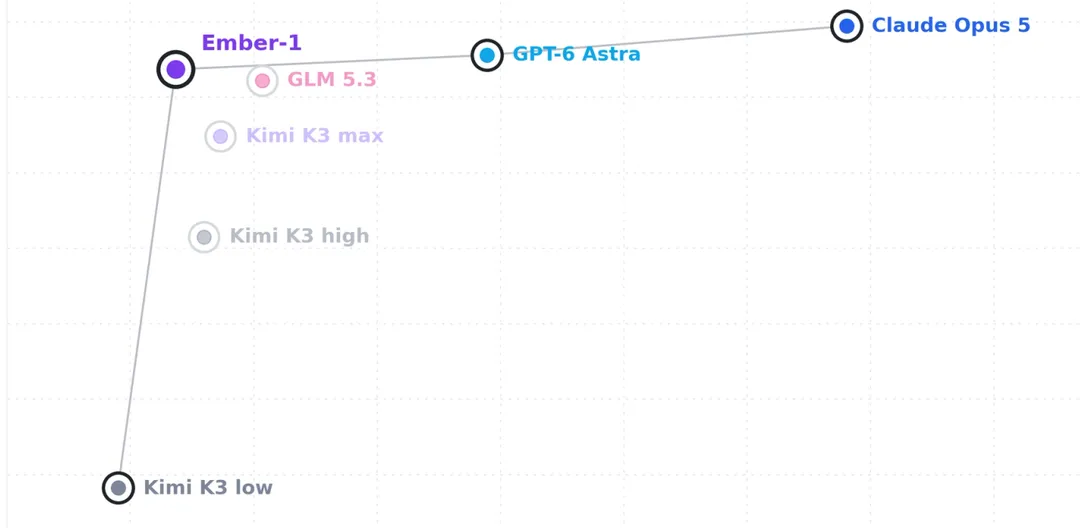
他们在 K3 的基础上接着训练,得到 Ember-1。检查假设、发现走错了回头改,这类有用的反思留着;原地打转的部分砍掉。按他们自己的测试,token 少用了四成左右,编程和 agent 任务的成绩基本持平。拿客户的真实线上流量做对比,结论也差不多。
这样看,快答和深想未必是一个开关的两头,中间有很长一段可以调。Ember-1 往快的那头挪了一大截,但它照样在推理,只是想得更干脆。
Ember-1 现在是研究预览版,放在 Fireworks 的 serverless 上限时开放,用的人多才会长期留下。上面的数字都是 Fireworks 自己测的,还没有外部复现。
原文fireworks.ai/blog/ember-1
Replit 的 CEO 觉得,大学把年轻人最值钱的东西磨掉了
AI 写代码越来越顺手,不少家长开始犯嘀咕:大学四年学的东西,毕业时还管用吗?AI 编程平台 Replit 的创始人 Amjad Masad 在硅谷风投 a16z 的播客里聊了快一个小时,他想的问题比“学什么专业”更根本。
他说,年轻人对社会最大的用处,是质疑大家深信不疑的东西,当“异端”。现在的大学正好相反,教你照它的路子走,找份工作,成家买房。可那条路已经不灵了,书读得再好,也可能背着一身债找不到工作。
要是重新上一次大学,他希望学校别规定他学什么,能旁听八竿子打不着的课,就像乔布斯当年旁听书法,后来用在了 Mac 的字体上;要是他突然扎进一个项目,学校别拿考勤把他赶走。
他也不赞成年轻人急着创业,说这就是程序员常讲的“过早优化”。他听说有投资人跑到斯坦福,给还没想法的学生开一百万美元的支票。他自己的路子是跟着兴趣走:最近迷上国际象棋,发现 ChatGPT 下棋很烂,就自学训练模型,最后琢磨出 Replit 的一条新业务线。
对谈的另一位是 a16z 新办的一所学院的负责人。这所学院不打分、不考试,Masad 也是它的支持者。
原文a16z.simplecast.com/episodes/amjad-masad-on-rethinking-college-for-the-ai-era-sOmuMQGQ
硅谷选读