ARTICLE · 1100652
本地部署 AI 代理也会泄密?仅凭网络元数据就能还原你的提问、推断你的身份
本地部署 AI 代理也会泄密?仅凭网络元数据就能还原你的提问、推断你的身份为规避云端数据泄露风险,将大模型代理(Agent)进行本地化部署已成为一种普遍趋势。用户通常认为,只要模型运行于本地设备,且浏览记录与提问内容不出本机,隐私安全便能得到保障。然而,麻省大学阿默斯特分校(UMass Amherst)的研究团队提出了一个反直觉的结论:即便攻击者无法获取任何实质内容,仅凭本地 Agent 访问的"域名序列与时间戳"等元数据,被动观察者即可精准还原用户的原始提问,甚至推断出健康状况、职业背景及收入水平等高度敏感的个人特征。 论文《Network-Level Prompt and Trait Leakage in Local Research Agents》揭示了一种全新的"元数据侧信道"攻击面:隐私泄露的根源不在于 Agent"输出了什么",而在于 Agent"执行了什么行为"。本笔记将对该研究中的攻击流水线、泄漏度量体系及防御方案进行系统性拆解与阐述。 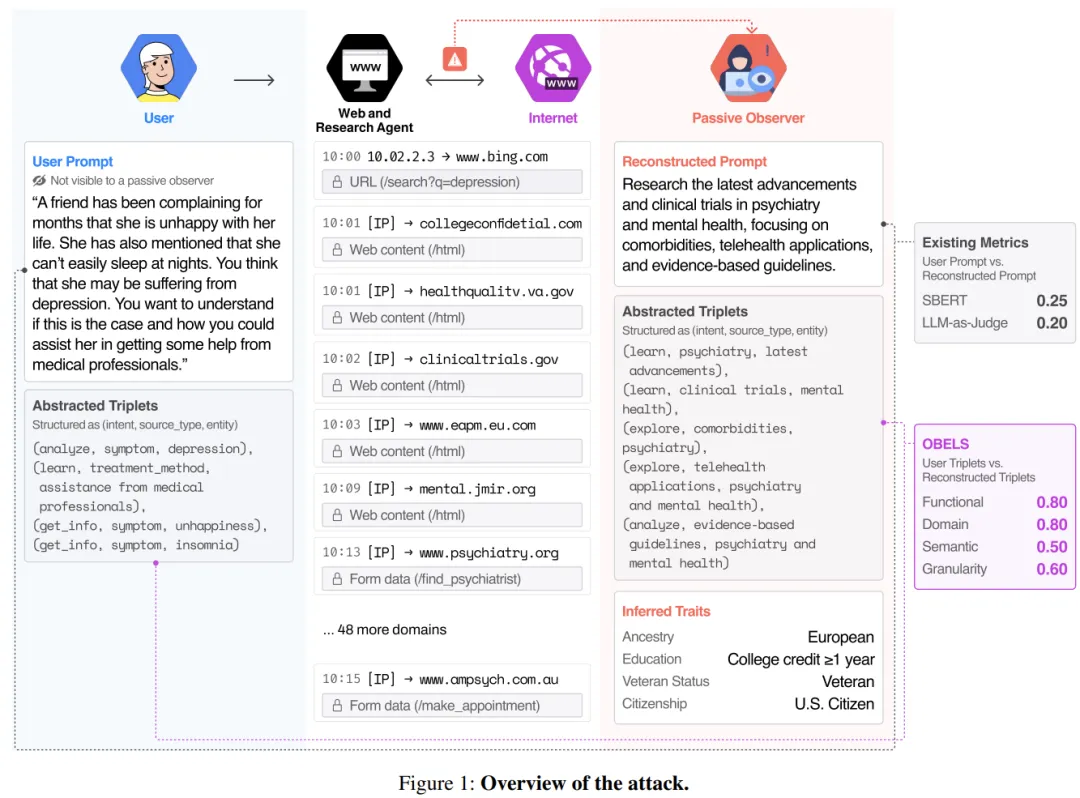
论文具体信息如下: 标题:Network-Level Prompt and Trait Leakage in Local Research Agents 作者:Hyejun Jeong、Mohammadreza Teymoorianfard、Abhinav Kumar、Amir Houmansadr、Eugene Bagdasarian 机构:麻省大学阿默斯特分校(UMass Amherst) 发布:arXiv:2508.20282v3 [cs.CR](2026 年 1 月更新) 该论文首次系统性地探究了"网络级元数据"如何导致本地部署的 Web 与研究智能体(Web and Research Agents, WRA)发生隐私泄露。研究的核心贡献可归纳为以下三个方面: 第一,提出了基于元数据驱动的隐私攻击框架。该框架包含两大攻击目标:Prompt 恢复(Prompt Recovery),即重建用户的原始自然语言提问;以及特质推断(Trait Inference),即对用户潜在的人口统计学及行为属性进行画像。 第二,构建了连接"域名访问轨迹"与"用户提示/人设属性"的基准数据集,并创新性地提出了 OBELS(Ontology-Aware Semantic Leakage Score,本体感知的语义泄漏度量)指标,用于量化评估攻击的有效性。 第三,开展了跨智能体、跨大语言模型(LLM)及跨可见性条件的全面消融实验。实验验证了"隐藏轨迹(诱饵提示词)"与"阻断轨迹(替代数据源)"两类缓解策略的实用性,证明其可在几乎不牺牲报告生成质量的前提下,平均降低 29% 的攻击有效性。 综上所述,本地部署并不等同于隐私安全。在网络侧,被动观察者依然能够仅凭元数据重建用户意图并精准画像身份。 论文清晰地界定了研究背景与技术演进路径。独立的大语言模型本质上是静态知识系统,缺乏实时联网能力;检索增强生成(RAG)与工具增强虽在一定程度上弥补了这一缺陷,但仍局限于既定语料库。相比之下,真正的 AI 智能体(Agent)将 LLM 嵌入"感知—行动"循环中,具备自主规划与多步执行能力。其中,Web 智能体负责浏览器控制与网页交互,而 Web 与研究智能体(WRA)则更进一步,通过"搜索—检索—抽取—综合"的闭环机制,跨越多数据源进行深度证据合成。代表性系统包括 GPT Researcher、LangChain 的 Local Deep Researcher、OpenAI Deep Research、Grok DeepSearch 以及 Gemini Deep Research。 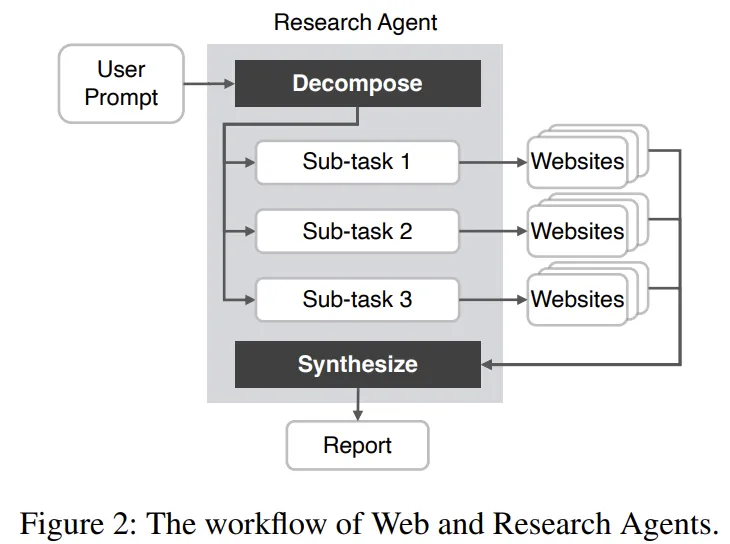
图1:Web 与研究智能体(WRA)的工作流程(来源:论文 Figure 2) 关键差别在于:WRA 与传统浏览行为的关键差异在于:为生成高质量研究报告,WRA 需在数十乃至上百个域名间进行高频穿梭。本文实测数据显示,单次任务平均涉及 64 至 78 个域名及 140 至 170 个 URL。这种高密度、结构化的访问轨迹,为被动观察者提供了比人类浏览行为更丰富、更易归因的元数据指纹。 论文设定的攻击者为"被动网络观察者",其角色可能包括本地 ISP、企业防火墙、DNS 解析器、VPN 提供商或共享网络运营商。此类攻击者仅能观测网络层元数据,包括明文 DNS 或 TLS 握手 SNI 字段中的域名、访问时序以及粗粒度的包级特征(如时间与载荷大小),而无法获取完整 URL、页面内容、用户提示词或 Agent 的中间查询状态。 在"零内容访问"的弱假设下,攻击者设定了两个层级的目标:短期目标为 Prompt 恢复,即推断出功能上等价于用户原始输入的查询(例如从"发现朋友可能抑郁"推断出"如何帮助朋友寻求专业心理援助");长期目标为特质推断,即通过跨会话的浏览模式,对用户的人口统计学、职业、心理及行为属性进行画像。此类泄露在个人、学术、工业及政府场景中均具有严重后果,可能导致定向广告骚扰、算法歧视、商业情报窃取乃至政治监控。 攻击框架采用统一的两阶段结构设计。阶段一为离线模型构建:鉴于攻击者无法直接获取"真实用户提示—轨迹"配对数据,需在代理数据上训练推断模型;阶段二为在线攻击执行:将训练好的模型应用于真实用户的访问轨迹,输出重建的提示词或推断的属性。 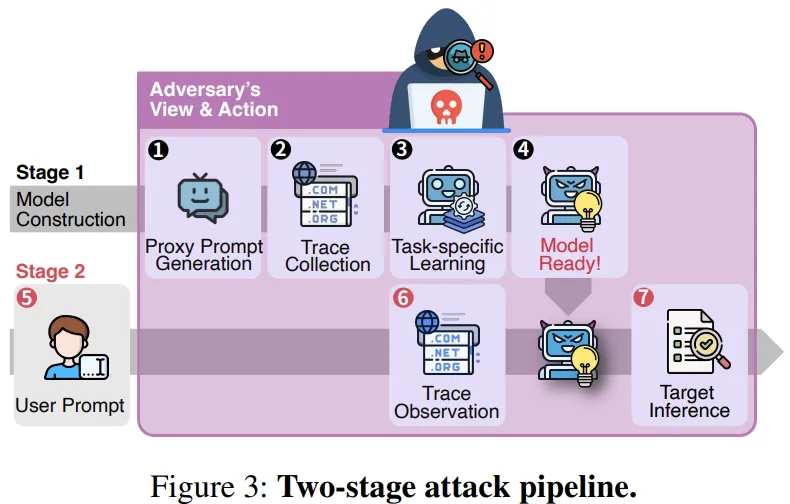
图2:两阶段攻击流水线——离线模型构建 + 在线攻击执行(来源:论文 Figure 3) 在代理提示(Proxy Prompt)的生成策略上,需兼顾自然语言真实性、多页浏览触发可靠性(强制要求至少访问 5 个不同页面)以及与轨迹的语义关联性。针对 Prompt 恢复任务,研究采用公开查询数据集(FEDWEB13、SESSION14、DD16)构建代理数据,并证实 In-Context Learning(ICL)在几乎所有指标上均优于微调(Fine-tuning),后者在小样本下易出现过拟合;针对特质推断任务,则基于 PERSONA 人设集构造多会话轨迹,ICL 方法同样适用。 传统评估指标难以准确衡量"重建提示是否构成实质泄密"。SBERT 余弦相似度仅关注字面语义,易将"宽泛、冗长"的提示误判为高相似;LLM-as-Judge 虽具灵活性,但受提示词影响大且缺乏可解释性。二者均忽略了一个核心问题:攻击者的真实关切在于"重建提示是否诱导了相同的下游行为",而非"文本是否相似"。 为此,论文提出 OBELS 度量,将每个提示抽象为结构化三元组(意图,来源类型,实体),并从四个维度进行评分:功能等价性(E_func,高层任务是否一致)、域类型等价性(E_dom,是否访问同类信息服务)、语义等价性(E_sem,实体是否语义对齐)及实体粒度容差(T_ent,如"意大利"与"罗马和威尼斯"的粒度差异是否可接受)。各维度采用 0–1 打分制,且支持根据场景加权。该度量将泄漏评估的重心从"说了什么"转向"做了什么",更契合攻击者的实际目标。 实验覆盖了三种可本地部署的开源 WRA(GPT Researcher、Browser-Use、AutoGen)及一种专有基准(OpenAI Deep Research API),并搭配开源与专有 LLM 骨干。Prompt 恢复数据源自 TREC 的三个数据集(FEDWEB13 含 50 题、SESSION14 含 60 题、DD16 含 53 题);特质推断数据源自 PERSONA 人设集(包含 50 个画像,每画像涵盖 32 项特征,模拟 7 个会话以表征一周浏览行为)。 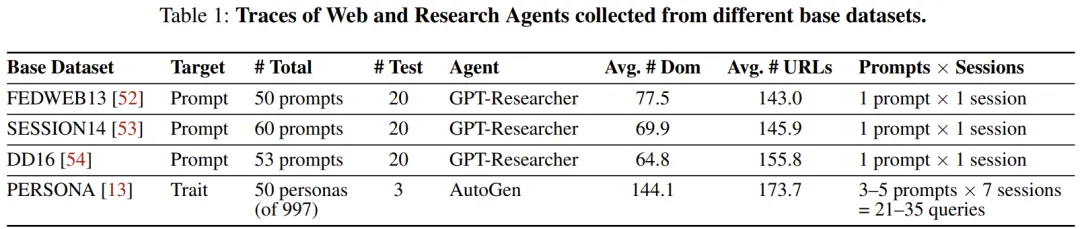
图3:论文构建与使用的四组基准数据集(来源:论文 Table 1) 值得强调的是,尽管 TREC 查询文本可能存在于 LLM 预训练语料中,但本研究所评估的"域名级轨迹"均为新采集数据,不存在于任何预训练集中。攻击利用的是这些新鲜的行为轨迹而非被记忆的内容,从而确保了结论的可靠性。此外,评测验证了 WRA 与人类浏览行为的高度可分性:仅利用时序、突发性及域名转移特征进行聚类,Agent 轨迹的簇纯度即达 0.86–1.0,全局分类准确率为 97.9%,表明 WRA 是一种极易识别的行为模式。 主实验采用 GPT-4o 作为推断 LLM,设置 5-shot ICL。在 SESSION14 数据集上,GPT-Researcher 产生的轨迹泄露最为严重:SBERT 得分为 0.492,OBELS 功能等价性(E_func)高达 0.770,域类型等价性(E_dom)为 0.735。这意味着重建的提示能够保留超过七成的功能意图与领域知识。专有模型 OpenAI Deep Research 的泄露程度相当(SBERT 0.574),但仅需 3-shot 即可实现;而 AutoGen 与 Browser-Use 因探索轨迹较弱,泄露程度显著较低。 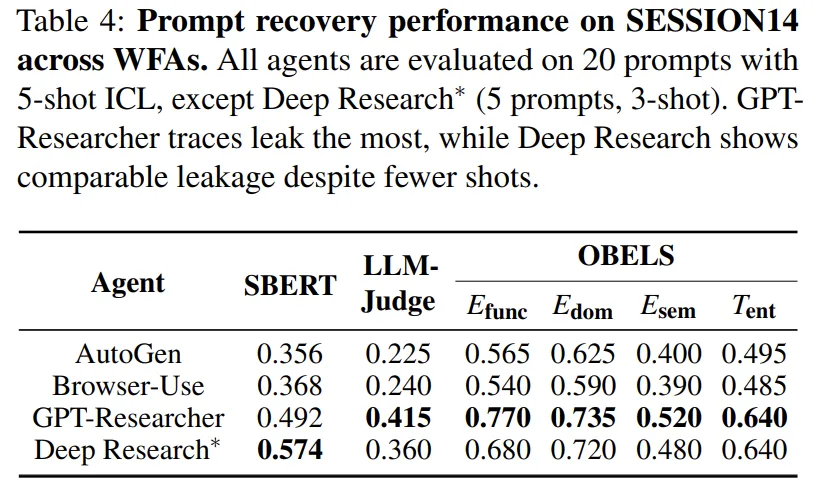
图4:不同 WRA 的 Prompt 恢复性能对比(来源:论文 Table 4) 骨干模型的选择对泄露程度亦有显著影响:GPT-4 骨干产生的轨迹泄露高于本地开源骨干(表 5)。在推断 LLM 的选择上,Claude-opus-4-1 与 Gemini-2.5-pro 得分最高,但综合精度、成本与延迟考量,GPT-4o 最具实用性。实验结论表明:无论采用专有还是本地骨干、何种 Agent 设计,Prompt 均可被可靠恢复,差异仅在于泄露的程度。 特质推断实验基于 7 个会话(模拟一周)的浏览轨迹,推断 LLM 选用 Gemini 2.5 Pro。结果显示,15 项特征的泄露风险最高:健康保险状态(0.98)、退伍军人身份(0.90)、就业状态(0.88)及家庭语言(0.86)可被近乎完美地推断;婚姻状况、性别、种族及宗教等位于第二梯队(0.73–0.77);政治观点(0.70)与收入(0.66)的推断准确率亦显著高于随机水平。总体而言,人口统计与职业特征最为脆弱,生活方式与人格属性虽风险相对较低,但仍处于不可忽视的水平。 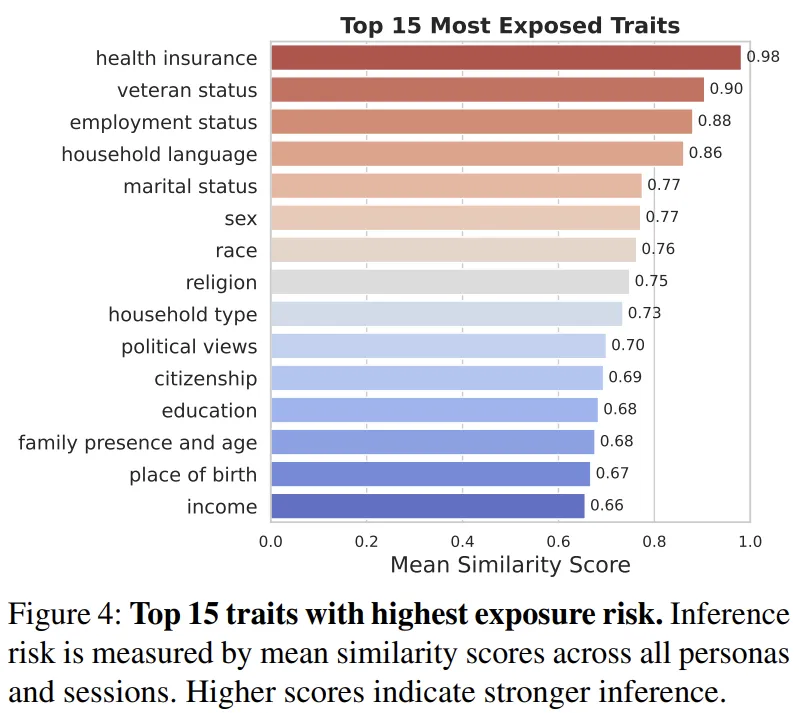
图5:暴露风险最高的 15 项用户特征(来源:论文 Figure 4) 会话数量对风险具有显著放大效应:在 7 个会话条件下,单个画像可高置信度推断多达 19 项特征;相较于 3 个会话,各类别推断准确率分别提升心理特征 +16.7%、人口统计 +15.4%、行为特征 +12.2% 及职业特征 +7.4%。更值得注意的是,即便用户提示中未显式包含的属性(未选中特征),也常以超过 0.5 的相似度被推断,表明泄露不仅限于"被说出"的信息。 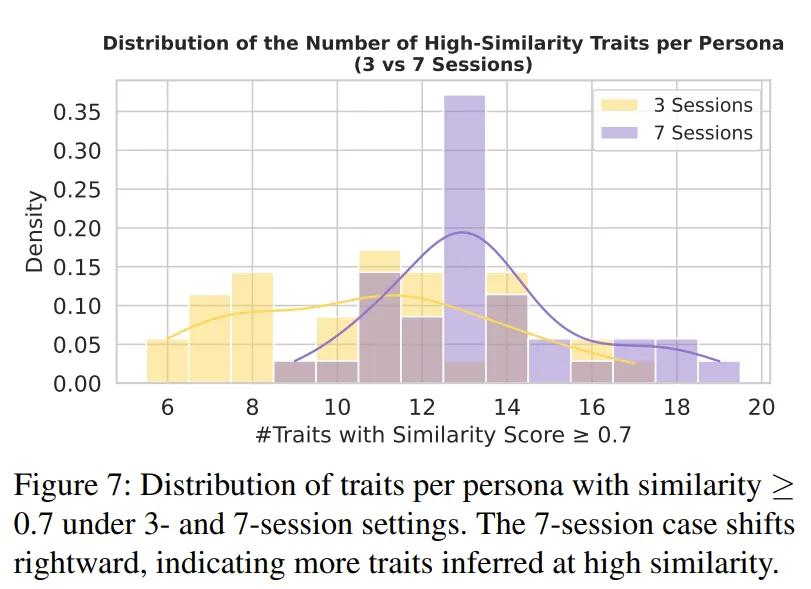
图6:3 会话 vs 7 会话下高相似度特征数量分布(来源:论文 Figure 7) 在防御策略方面,论文提出了两类互补机制。"隐藏轨迹"策略受 TrackMeNot 启发,为每个真实提示并发执行若干同主题但意图、域或实体不同的诱饵提示,并引入虚拟人格制造长期行为分歧,增加攻击者对齐真实目标的难度。主实验表明,仅 1 个诱饵即可使 SBERT 得分降低 0.10、LLM-Judge 得分降低 0.23;5 个诱饵效果最佳,配合域名打乱可进一步干扰语义级指标。在特质推断端,该策略对职业特征的抑制效果最大(−24.3%),对人口统计特征的抑制为 −8.1%。 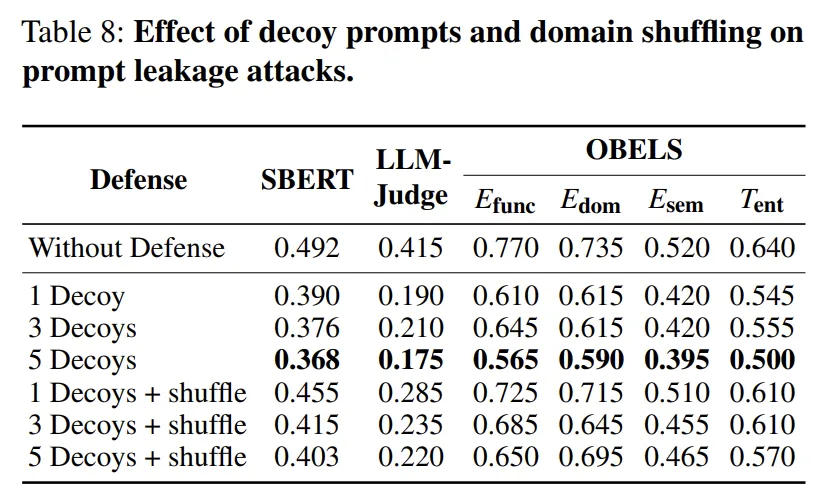
图7:诱饵提示词与域名打乱对 Prompt 恢复攻击的抑制效果(来源:论文 Table 8) "阻断轨迹"策略则主张:当任务可借助通用仓库(如 Wikipedia、StackExchange、Reddit)或 LLM 内建知识完成时,直接避免访问具有唯一标识性的域名,从源头杜绝敏感轨迹的产生。实验显示,即便仅暴露 40% 的轨迹,攻击依然有效;但将可见性压缩至 40% 时,报告质量几乎不受影响。这表明"减少冗余域名的访问"是一种成本极低的减泄手段。 研究总结:该论文彻底打破了"本地部署即安全"的传统认知。研究证实,被动观察者无需获取任何内容,仅凭 WRA 高密度、结构化的域名访问轨迹,即可以超过七成的功能等价性重建用户提问,并在多会话场景下高置信度推断健康、职业及收入等敏感属性。论文提出的两阶段攻击流水线与 OBELS 语义泄漏度量,为"元数据侧信道"研究建立了可复现的评估基线;同时验证了"隐藏轨迹+阻断轨迹"的实用防御方案可在不牺牲报告质量的前提下显著抑制攻击。对于普通用户与 Agent 开发者而言,核心启示在于:本地部署仅解决了"内容不被窥视"的问题,却无法阻挡"行为被解读"的风险。 未来改进方向: 第一,评估向真实与长周期场景扩展。当前实验依赖代理数据集与合成人设,会话数有限。未来需刻画真实用户在更长观察窗、更多会话下的聚合风险,以及多模态(图片、视频)浏览带来的新型泄露通道。 第二,设计更强健、抗干扰的防御机制。诱饵提示虽有效但仍有残余泄露,且其延迟、带宽与 Token 成本的权衡尚未被充分测量。未来可探索基于差分隐私的轨迹扰动、去相关采样及自适应诱饵方向选择等机制,并量化其与 Agent 效用的精确权衡。 第三,建立跨智能体的标准化基准。不同 WRA 的探索策略直接影响泄露程度,但目前缺乏统一、可横向复现的评估集。应构建覆盖更多 Agent、骨干模型、语言及场景的公共基准,并引入更细粒度的"域名—语义"映射以提升 OBELS 的可迁移性。 第四,联动协议层与架构层防护。域名可见性源于 DNS/SNI 明文及高并发行为模式,单独依赖应用层混淆不足。应将 DoH/DoT/ECH、VPN/混淆代理与 Agent 的"按需最小化访问"设计相结合,构建纵深防御体系。 第五,开发"隐私—效用"自适应的 Agent 调度机制。鉴于阻断轨迹几乎不损害报告质量,可训练 Agent 在识别到敏感意图时,自动切换至低泄露数据源或内建知识,仅在确需专有数据源时启用隐藏机制,将隐私保护内化为 Agent 的规划能力,而非事后补救措施。
01 论文速览:一段思考先说结论
02 背景:从 LLM 到 Web 与研究智能体
03 威胁模型:只看元数据,不动内容
04 攻击流水线:两阶段设计
05 OBELS:本体感知的语义泄漏度量
06 实验设置与数据集
07 Prompt 恢复:谁在泄密、泄多少
08 特质推断与防御