ARTICLE · 1113615
超简单豆包工作,从入门到做出文档·图片·视频,再批量扒取抖音爆款
各位看官今天来聊豆包工作,学完你也能把一个抖音博主的视频,连逐字稿一起扒下来。
先说结论:这件事不需要写一行爬虫代码。
不过扒抖音只是其中一段。这篇从装客户端开始,中间走一遍做文档、生图片、出视频,最后拉一张表把对标账号的家底翻干净。
前面几节是地基。急着扒抖音的,直接跳第七节。
目录
- 一、豆包工作是什么
—— 一个能自己拆任务的智能体办公软件 - 二、下载和装
—— 一个入口、三档价格,装完先改两个设置 - 三、界面认一遍
—— 怎么开第一个任务,工作界面里的几块区域 - 四、做文档和 PDF
—— 生成、转格式、拆分合并、水印、全文翻译 - 五、生成图片
—— 办公任务里调「创意设计」,能改能抠能仿 - 六、生成视频
—— 创意视频 skill 调 Seedance,从一段文案到成片 - 七、扒抖音爆款视频
—— 四个输入、11 列字段、逐字稿的分页坑 - 八、坑集锦
—— 十个会卡住的地方 - 九、Trae / Seedance / 豆包 到底是什么关系
- 最后
一、豆包工作是什么
豆包工作不是豆包:是一个能自己拆任务、调工具、把活干完的智能体办公桌面软件。
豆包通常指手机端下的 APP,或者豆包大模型。
2026 年 8 月 25 日,字节把这个办公 Agent 单独拎出来做成独立品牌,叫「豆包工作」,和飞书打通。往前四天,8 月 21 日,它的技能系统上线,已上架 200 多个技能和连接器。
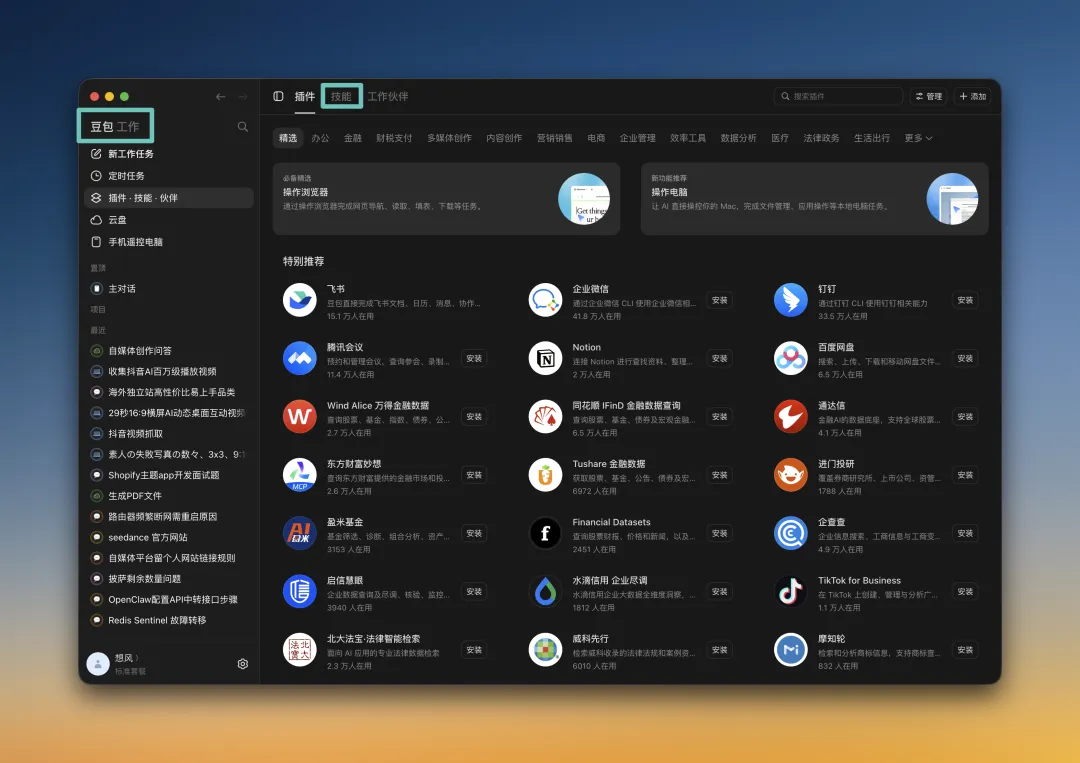
和普通豆包比,差别在这三行:
关键差别在最后一行。
聊天框里的答案,复制粘贴三遍就散了。 落进表格的东西能排序、能筛选、能攒起来,下次直接在上面接着干。 所以本文这套流程,重点不在「AI 能读懂视频」,而在结果落到一张能长期用的表里。
还有一层身份要提前说清:图片和视频是模型出的,不是豆包工作自己出的。 豆包工作是个调它们的壳。这几个名字到底谁是谁,第九节展开。
二、下载和装
只有一个入口:https://www.doubao.com/work 豆包电脑版。 这里有个坑,豆包工作下载后,文件竟然占近2g,着实震惊了我,怎么这么多东西的,把所有的好东西都封装好了吗?
从豆包官网下载装上,打开就是工作界面,最新版不用再切模式。
登录支持飞书账号、手机号、微信、抖音四种。飞书账号登录会关联企业权限和知识库,个人用手机号就行。
目前注册送一个月额度,奇怪可能是推广优惠期,我目前送到10月底多送了一个月。
免费额度用完就要付费,三档,按连续包月算:
免费版不取消,基础问答照旧能用。
第四节到第六节那些活儿,免费额度大多撑不住。 先拿送的额度把第四到第六节走一遍,确认真能省你的事,再决定上不上付费档。
装完先做两件事,不做后面天天烦。
一是把「图片及本地文件打开方式」改成「豆包工作应用内」。 改完之后生成的文件能在侧边栏直接看,不用每次跳到系统里去开。
二是去「AI 生成水印管理」里把水印关掉。 文档、表格、PPT、图片、视频的水印都能关,导出成果干净得多。
第一次用会提示授权本地电脑。 建议先单独建一个文件夹,比如 D:\豆包工作,授权的时候指定这个目录,别把整个硬盘交出去。
三、界面认一遍
3.1 怎么开第一个任务
打开客户端,点「新建办公任务」。第一次可能会要授权本地电脑,点允许。
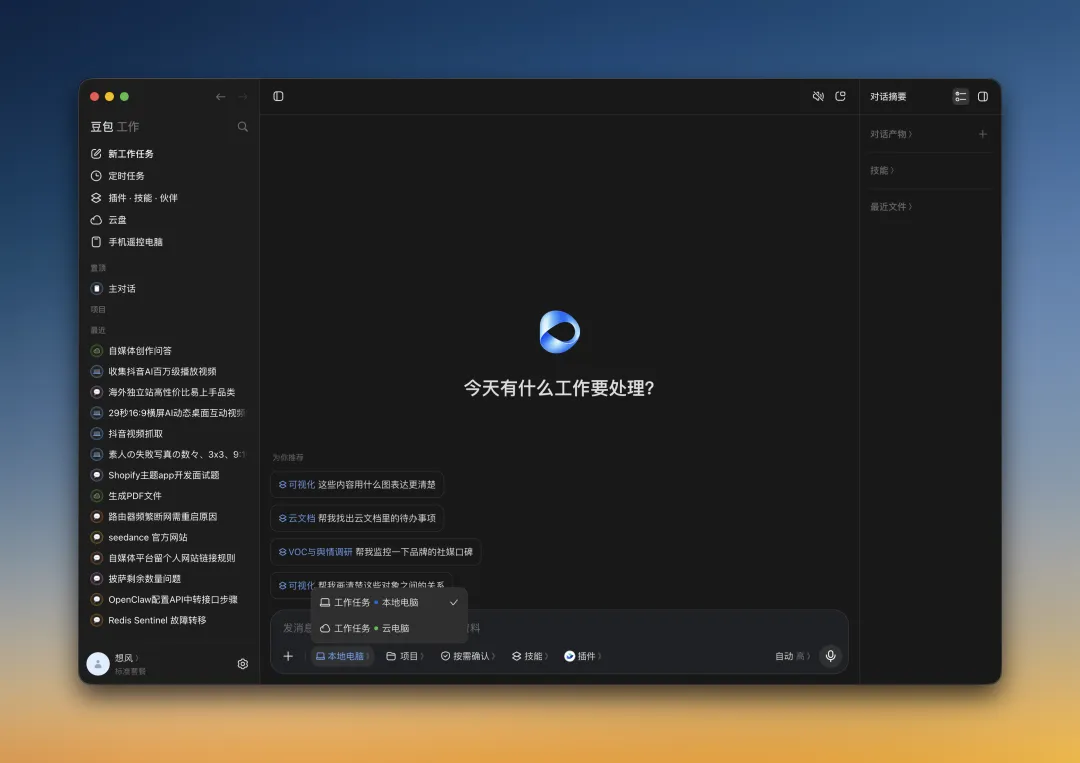
工作任务界面里有这几块:
「按需确认」建议一直开着。 高风险操作动手前先问一句,比事后收拾便宜。
3.2 本地电脑和云电脑
活儿是跑在「环境」里的。
选本地电脑,它能读写你授权过的文件夹,适合处理本机上的素材。
选云电脑,活儿跑在云端,适合长任务。比如第六节那套动画视频的流程,从头到尾都在云电脑里跑,关掉电脑也不影响。
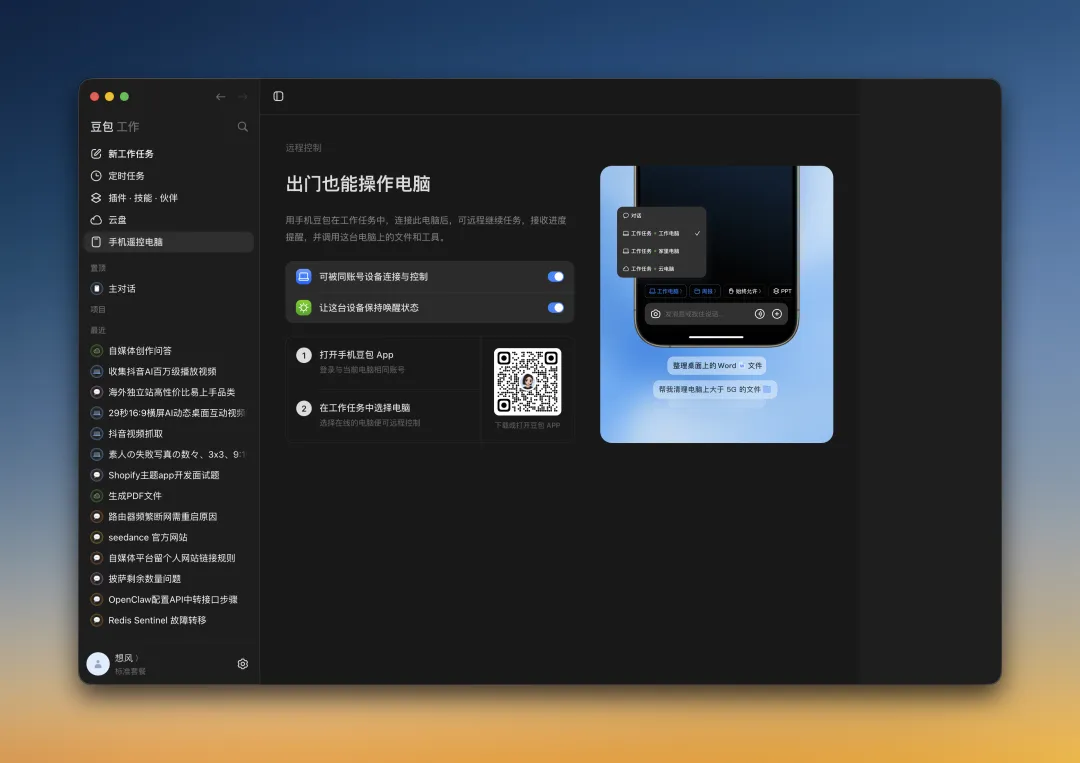
3.3 手机豆包可以控制桌面豆包工作
四、做文档和 PDF
4.1 生成一份文档
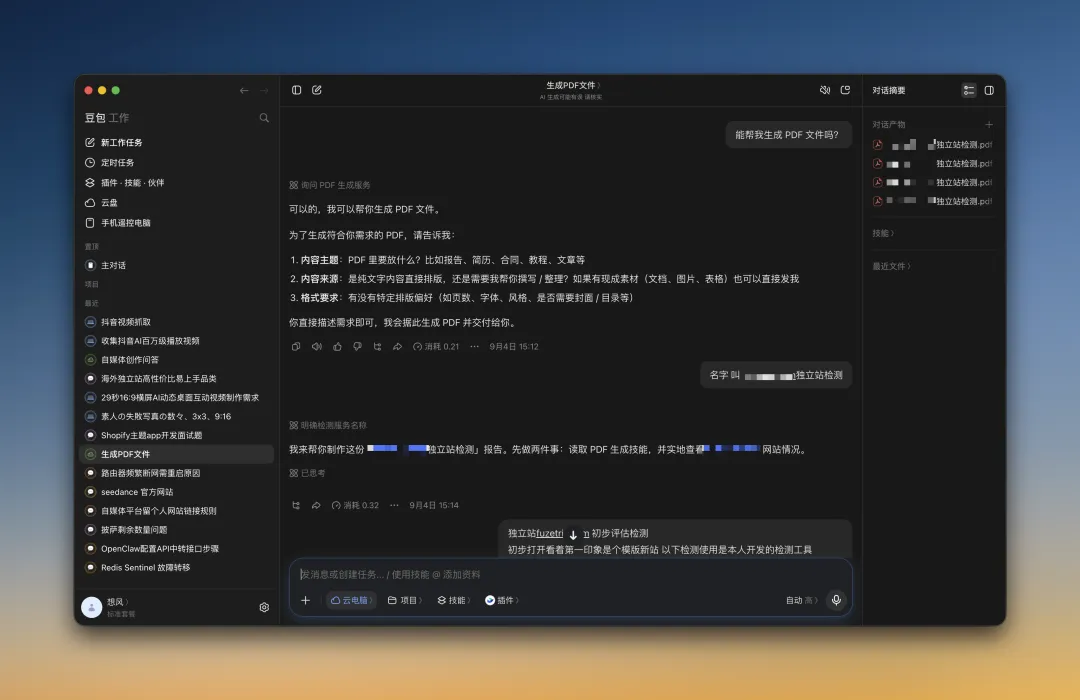
对话里把要什么说清楚,它生成完,点「转为文档编辑」,再导出成 Word 或 PDF。
需求里写清三样,出来的东西才不空:给谁看、要包含哪几部分、大概多长。
4.2 PDF 上能做的活儿
除了生成,上传一份现成的 PDF 也能加工。常见的是这几类:
全文翻译有个更顺的走法:用豆包工作的内置浏览器打开 PDF,边看边问。 比等它整篇译完再读快得多。
4.3 一个实际用法
官方资料里那个例子挺说明问题:丢一份日文 PDF 进去,让它接连产出官网、社交媒体素材、视频宣传片和双语 PPT。
这类连串任务的用法是——不要一件一件提,一次把整条链说清楚。 它自己能拆步骤。
五、生成图片
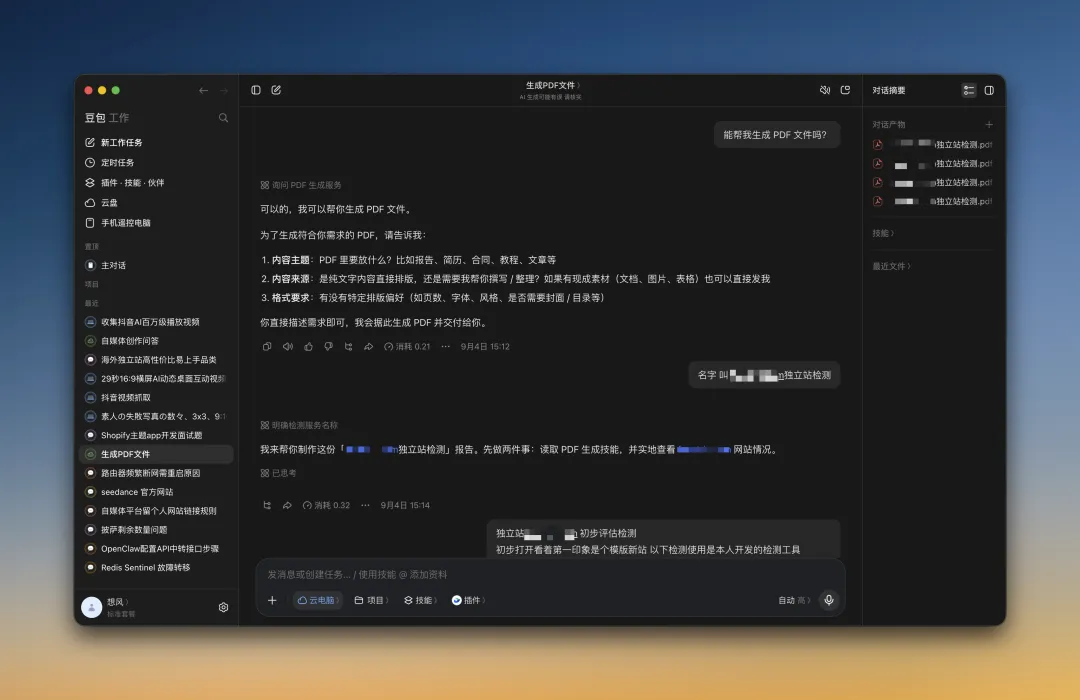
这一块倒是比较简单,直接开口就好,或者按住技能后使用!
5.1 前提:模型选对
图片和视频的活儿,免费档大多调不动。
模型手动切到 豆包 2.1 Pro 或者 Seed-2.1-pro。 默认是「自动」,多图融合、材质替换、IP 姿势生成这些高级能力,自动档调不出来。
5.2 先把授权放行
这一步不做,底部那个「创意设计」按钮会是灰的。
进「设置 → 隐私与安全 → 本地设备权限」,把这三项打开:
访问文件系统 控制浏览器 运行本地应用
第一次调用设计类 Skill,浏览器会弹一个授权浮层,点「始终允许」。 再去地址栏右侧点豆包扩展图标,选「授予当前网站完整控制权」。
抠图、批量导出、本地联动这几个功能,全靠这层授权撑着。
5.3 三种调用方式
- 直接说需求
。比如「把这张产品图生成 8 种不同材质的渲染效果」「复刻这张海报的排版和配色,换成夏季主题」,它会自己去「创意设计」里挑对应的子能力 - 点底部 Skills 快捷栏
里的「创意设计」,展开选子技能——反推提示词、批量抠图、多艺术家风格 - 结果不满意时,长按那条回复
,让它重做一遍,它会重新走一遍技能链
5.4 它具体能干什么
摘掉形容,是这几类:
批量抠图那条最实用。 做电商图、做素材库,几十张图一次过,比手抠省掉一整个下午。
5.5 第三方 Skill 也能生图
除了内置的,还能让豆包工作去装别人写的 Skill 来生图。
一句话就行,不用配环境:
帮我到 GitHub 下载 xxx 的 xxx skill,并调用这个技能处理我上传的图或者直接给地址:
使用这个 Skill:github.com/xxx/xxx装完它会出现在技能列表里,之后当普通技能用。
六、生成视频
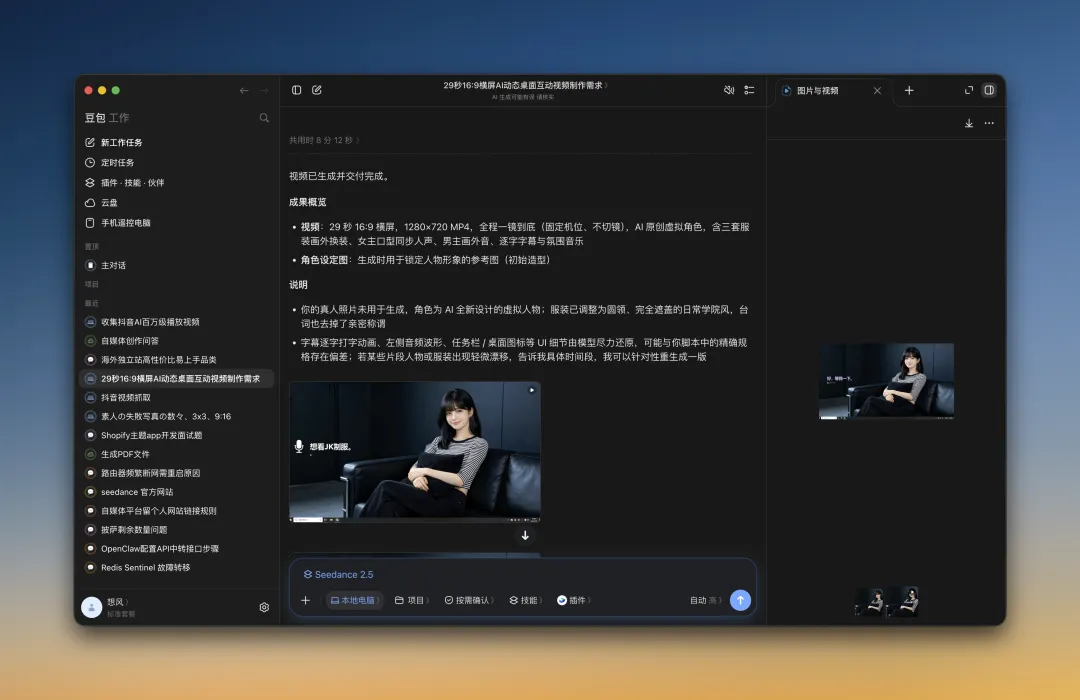
这个 主要看你的提示词和选择的模型能力了, 目前优选seedance 2.5
6.1 先分清模型和产品
视频是 Seedance 这个模型出的。豆包工作是能调它的产品之一。
所以有两条路:一条在豆包 App 里用,一条在豆包工作里用。这篇讲后者。
这条路同样要付费套餐,加强版或高级版。
6.2 两条入口
办公任务模式里,技能里找到「创意视频」,告诉它用 Seedance 2.5 直接进「视频生成」入口,选 Seedance 2.5,输入文案或者首帧图片
6.3 文案是成败的关键
写一段 100 到 300 字的文案,至少交代三件事:主题、场景和情绪、必须出现的关键元素(品牌名、口号这类)。
做口播或者动画类,先把逐字稿写完、配音,再把每句的时间码抽出来。 后面排画面要拿这个时间轴当基准,不然音画对不上。
6.4 出片
把脚本丢过去,说一句「用 Seedance 2.5 做一条宣传片」。
Agent 会自己拆任务,还能顺手联动图片模型出画面——第五节那套生图能力,在这儿是当配料用的。
几个规格记牢:单段最长 30 秒,成片最长 60 秒;默认 720p,支持 480p、720p、1080p;时长 4 到 30 秒。 比例可选 9:16 竖屏或 16:9 横屏。
6.5 定稿
导出 1080p MP4。
哪一镜不满意,改对应的那句文字重新生成就行,不用整条重来。
要加标题、字幕、BGM、封面,还是扔进剪映做。 豆包工作负责把画面出出来,精修那步交给剪辑软件更顺手。
6.6 想做完整的动画短片
五步:
写逐字稿、配音、把每句的时间码抽出来 拆镜头、锁画风,让它输出镜头表和统一的画风描述 按镜头出图,逐镜检查首尾帧 生成视频,出剪辑方案 进剪映合成,加标题、字幕、BGM、封面,导出
全程可以在工作任务的云电脑里跑。
七、扒抖音爆款视频
先看成果一句话直出三十条爆款视频,不过抖音并没有公开视频浏览量,它通过点赞数反推的!你也可以发链接给豆包工作,让他爬某个博主的视频资料。暂时还不支持直接下载视频
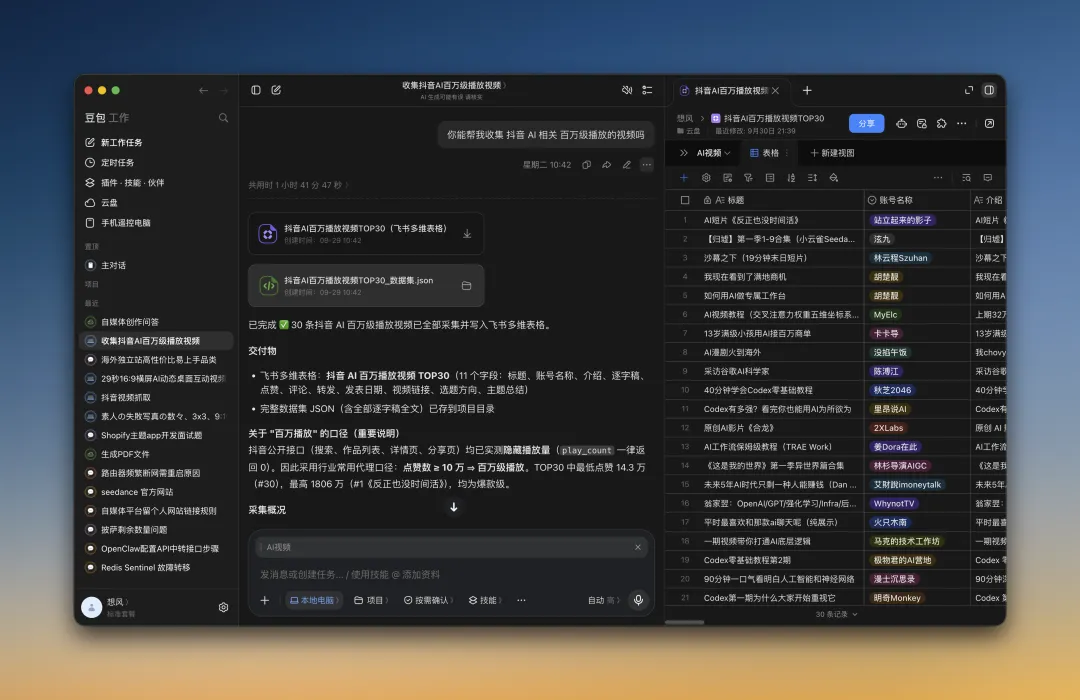
7.1 先看清整条链路
先把全景摆出来,后面每一步都在这个框里:
抖音博主主页 ↓ 豆包工作内置浏览器(需登录抖音) 视频链接列表 ↓ 逐条进详情页 标题 / 文案 / 点赞 / 评论 / 转发 / 日期 ↓ web.fetch 抓口播 完整逐字稿 ↓ AI 读逐字稿 选题方向 + 一句话主题总结 ↓ lark-cli 写入 飞书多维表格
三个环节各有一个容易翻车的地方,后面分别讲。 登录没做好,主页读不出作品列表;逐字稿会被截断,不分页读就只拿到半截;字段类型对不上,写进去就是烂的。
7.2 动手前的三样准备
第一样:能用豆包工作的账号。 这个 Skill 只能在豆包工作里跑。 逐字稿靠的是豆包工作内置的能力,换到别的 Agent 里没有这个工具。
第二样:一个抖音小号。 采集博主主页的公开视频信息时,Skill 会打开豆包工作内置浏览器,需要登录抖音。 建议专门开个小号,这个账号只用来读公开主页的视频信息,不下载视频,逐字稿的获取也不依赖它。 第一次运行会弹出浏览器,没登录就人工接管登一下,登完把控制权交回去。
第三样:一张飞书多维表格。 新建一张空表就够了,字段不用手建,缺的列 Skill 会自己补。 如果不想用飞书也行,明确说一句「不用表格」,结果落到本地文件,见 7.8。
7.3 装 Skill
用的是一个开源 Skill:douyin-transcript-exporter,来自 GitHub 仓库 jinchenma94/social-media-data-tools。
装法是一段话,不是点按钮。 在豆包工作的对话里,把这句原样发过去:
请打开下面的 GitHub 仓库,找到其中的 douyin-transcript-exporter Skill,阅读相关文件并完成安装:https://github.com/jinchenma94/social-media-data-tools安装完成后,请告诉我安装结果。
它会自己去读仓库、读 Skill 文件、把技能挂上。 装完让它报一句结果,确认挂上了再往下走。
这里有个和普通软件不一样的地方: 豆包工作的 Skill 并不会告诉你文件路径在哪里,只会显示在技能列表上。想调用它,通过对话就行;想新增,也是通过对话,另外还支持上传文件的形式。
7.4 下指令:四个输入
这一步是全文最省事也最容易踩空的地方。 给 Agent 的其实就是四件事:
| 默认只扒最新 5 条 | ||
两个「默认」要记牢: 数量不写就是 5 条。 扒完发现只有 5 条,先别怀疑博主没更新,八成是这个默认值没改。 表格链接不给,它会先问一句,想存本地就明确说「不用表格」。
分享短链也能用,丢一个 https://v.douyin.com/xxxxx/ 过去,它会先用浏览器打开短链,拿到跳转后的真实地址再开工。 一段能直接用的指令长这样:
帮我采集这个抖音博主的视频:https://www.douyin.com/user/xxxxx最新 20 条,要完整逐字稿,写入这张飞书多维表格:https://xxx.feishu.cn/base/xxxxx?table=tblxxxxx
7.5 它到底抓了什么
一共 11 列,9 列是从抖音页面直接抓的,2 列是 AI 读完逐字稿生成的。
基础采集字段(9 列):
web.fetch | ||
/video/xxxxx |
AI 扩展字段(2 列):
采集顺序是这样的:先开博主主页,滚动加载全部作品,从 DOM 里抓出所有 /video/xxxxx 链接和基础信息。 再逐条进详情页,补评论数、转发数、发表日期。 首页列表上的数字和详情页可能对不上,以详情页为准。
点赞、评论、转发,这三个数只适合拿来排序,别当质量信号。 拿它当内容好坏的判据会跑偏。 一条讲得清楚但没投流的视频,数据一定难看。
7.6 最大的坑:逐字稿被截断
这一节是全文最值钱的部分。 豆包工作抓逐字稿靠 web.fetch,而它单次返回的内容有长度上限。
第一次调用返回的东西里,会带两个字段:end_offset 和 total_length。 end_offset 等于 total_length,这一条抓完了。 end_offset 小于 total_length,内容被截断了。
被截断的时候,必须带着上一次的 end_offset 继续读下一页,一直读到 end_offset >= total_length,再把几页拼成完整文本。
不分页会怎样?拿到半截逐字稿,而它看起来是正常的。 有开头、有句子,只是突然停住了,不逐条核对根本发现不了。
Skill 里写了四道完整性判断,满足任何一条就算不完整。 逐字稿正文不足 50 字。 内容在句子中间断掉,末尾不是句号、问号、感叹号这类结束标点。 返回内容里出现「完整内容」「web.fetch」「已通过」这类占位符文字。 调用失败或返回空。
抓不到就走回退路径:飞书妙记。
真的抓不全,还有一条备选链路:
# 加载 doubao-video-extract skill 后执行python3 scripts/minutes/social_video_to_minutes.py "<视频URL>" --run-lark
这条路的流程是下载音频 → 上传飞书妙记 → 转写。 准,但慢。 每条 1 到 3 分钟,20 条就是半小时起步,适合抽查,不适合批量。 回退还是失败,那一条的逐字稿就留空,并在结果里标注失败原因。
这里有一条红线:逐字稿字段绝不允许写占位符。 「完整内容已通过 web.fetch 获取」这种话,一个字都不能有。 抓不到就留空、就标注失败,不能拿一句听起来完成了的话顶上——空着是信息,假话是污染。
7.7 AI 自动打标签、写总结
拿到逐字稿之后,AI 会补两列,这一节有个硬约束,不知道会翻车。
选题方向:只能从表格已有的选项里挑,不许自己新增。 流程是先用 lark-cli base +field-list 读出目标表格「选题方向」字段现有的选项列表。 然后从里面选 1 到 3 个最贴合的。
为什么不许新增? 因为标签一旦能自由生成,几十条视频跑完,表格里会冒出十几个近义标签。 「AI 教程」「AI 入门」「AI 学习」各占一列,筛选直接废掉。
主题总结:一句话,30 到 80 字。 要求提炼本质,不重复标题,不写「这条视频讲了……」这种废话开头。 生成方式是批量一次性交给 AI,不是逐条调用。 逐字稿还会按长度截断,1500 字以内的短视频用全文,超过 1500 字的长视频截到前 2000 字。
这两列是可选的。 目标表格里没有这两个字段,Skill 默认不新建,直接跳过。
7.8 不写飞书表也行,推荐豆包表格
明确说一句「不用表格」,结果就落到本地或者直接用豆包表格(www.doubao.com),豆包工作就能打开,无须用飞书插件连接配置比较麻烦(飞书后台不熟悉会有些复杂) 目录结构是这样:
douyin_data/└── {博主昵称}_{采集日期}_{视频数量}条/ ├── 01_{视频ID}.md ├── 02_{视频ID}.md ├── ... └── _all.json # 汇总,可选
一个视频一个 Markdown 文件,内容分五段:
# {视频标题}## 基本信息- 账号名称 / 发表日期 / 视频链接- 点赞 / 评论 / 转发## 介绍/文案## 选题方向## 主题总结## 逐字稿
同时会存一个 _all.json 汇总,每条视频的所有字段都在里面,方便后面写脚本处理。 落到本地的好处是不受表格字段限制,坏处是不能筛选、不能多人协作。 一个人做调研够用,团队最好还是走飞书。
八、坑集锦
十个坑,这部分值回票价。
坑一:数量不写,只扒回来 5 条。 默认最新 5 条,指令里必须写清「最新 N 条」。
坑二:逐字稿被截断,看起来却是完整的。end_offset 小于 total_length 就得继续读。
坑三:用 curl 或 requests 直连抖音 API。 反爬会拦,必须走真实浏览器。 登录态是拿全数据的前提。
坑四:拿测试账号跑 lark-cli。 沙箱环境里的 lark-cli 可能登录的是测试账号,对目标表格没权限,会报错 131006。 优先用系统装的,Mac 上默认在 /opt/homebrew/bin/lark-cli。
坑五:想删掉飞书表格的第一列。 多维表格的主字段不能删,只能改名,默认的主字段叫「文本」且是空的,把它重命名成「标题」就行,不要想着删掉重建。
坑六:表格里已经有了重复记录。 Skill 会拿已有记录的「视频链接」跟本次采集的对比,只写新记录,想全量覆盖得明确说。
坑七:生图生视频调不动,以为是功能没有。 多半是两件事:没上付费套餐,或者本地设备权限没放行。
坑八:忘了关水印。 生成的文档、PPT、图片、视频默认带水印,导出前先去设置里关掉。
坑九:授权本地电脑时图省事,把整个盘交出去。 单独建一个文件夹再授权,出问题好收拾。
坑十:看完就没下文。 采集本身不是目的。 跑完 20 条,从里面挑 3 条能改的,把那 3 条的开头钩子逐句读一遍,下周的选题就出来了。 表格是素材库,不是奖状。
九、Trae / Seedance / 豆包 到底是什么关系
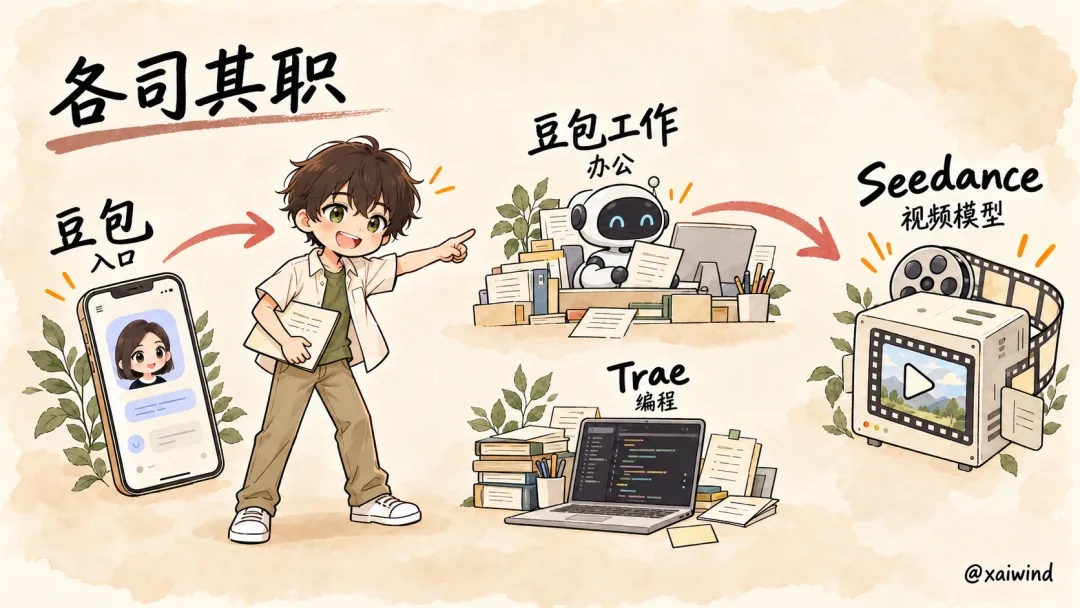
第一节留了个话头,这里收掉。
先各自定位:
- 豆包
是牌子,字节的大模型品牌,也是面向大众的那个 APP,国内 AI 原生应用里月活第一。 - 豆包工作
是干活的。办公 Agent,2026 年 8 月 25 日发布。 - Trae
是写代码的。2025 年初发布的 AI 编程工具,在中国 AI 编程市场里份额第一。 - Seedance
是出视频的模型。没有独立 APP,靠别的产品承载。
2026 年 8 月那次整合是分水岭。
在那之前,Trae、扣子、豆包是三拨人、三个产品,各打各的。8 月 24 日合并团队,第二天发布豆包工作这个品牌。
整合之后,Trae 的两条线走向不同:
- TRAE Work
——面向全员的工作台,并进了豆包工作 - TRAE IDE / CLI
——面向开发者的编程工具,作为豆包品牌下的产品线继续做
所以在今天再问「Trae 和豆包工作选哪个」,问题本身就过时了。面向办公的那半边已经是一家。
那 Seedance 呢?
它是模型,不是竞品。豆包 APP 调它,豆包工作也调它,即梦和火山引擎都能调。同一个模型,换不同的壳。
图片那边也一样——第五节那些生图能力,底层是字节的图片模型,豆包工作负责把 Skill 串起来。
一句话收:豆包是入口,豆包工作是桌面上的那个工位,Trae 是里面的编程工具,Seedance 是它能调的一个视频模型。
豆包大模型 2.1 系列的能力梯度,从强到弱、从贵到便宜依次是:
| 2.1 Pro | ||
| 2.1 Turbo | ||
| 2.1 Lite |
最后
整套流程跑通,大概一个下午。中途也遇到了卡顿:
## 📌 关于扒博主视频的波折,简要说明中途确实绕了一段弯路:按技能文档默认走了飞书妙记链路,结果撞上妙记令牌限流 + 上午 5 小时沙箱故障,一度卡在逐字稿上。最后发现技能里其实有 `web.fetch` 抖音快速路径(**不占用妙记令牌**),5 分钟就把剩下的 7 条逐字稿全部补齐了。这个经验下次可以直接用,不会再卡。
真正花时间的不是装 Skill,也不是写指令——是第一次跑通和想清楚要扒谁、扒完干嘛。 这个想不清楚,扒一万条也是躺在表里的数字。
前面几节是同一个道理。生成文档、出图出视频这些活儿,快得不值一提;难的是先想清楚要什么,再把它说明白。
采集的是公开主页信息,请只处理有权访问和使用的内容,并遵守平台规则。#豆包工作
我是想风@xaiwind,一个关注出海与AI 、AIGC的创作者。
本文基于AI辅助与个人实践融合创作,如果文章对你有帮助,欢迎点赞、收藏、关注,
本人文章包售后欢迎联系或者评论区见,每天进步一点,我们终会到达目的地!
附录·本文参考
豆包工作官方站(doubao.com/work)与客户端内的功能说明 字节跳动 AI 办公产品整合公告:TRAE、扣子并入豆包,统一品牌「豆包工作」 Seedance 模型说明:豆包大模型团队出品,通过豆包、即梦、火山引擎调用 开源 Skill: jinchenma94/social-media-data-tools里的douyin-transcript-exporter