ARTICLE · 1113622
【开源】文档再多也找得到,它让 AI 自己查
【开源】文档再多也找得到,它让 AI 自己查
公司里最贵的东西,往往不是服务器,而是那些「明明写过、却死活找不到」的文档。产品手册、复盘纪要、接口说明、三年前的部署记录,全堆在一个角落。你想查一句配置,得先想清楚它大概在哪份文件、哪一页。
这不是你记性差。是大多数工具只能告诉你「这个关键词出现在第 4 页」,至于答案对不对、过没过期,它不管。
腾讯最近开源了一个叫 WeKnora 的项目,想解决的正是这件事:它不是又一个搜索框,而是让 AI 自己进文档里去检索、推理、甚至调用工具,把一堆散乱的原始材料变成能持续用的知识。
一、RAG:不止给你答案,还把出处一并递上来
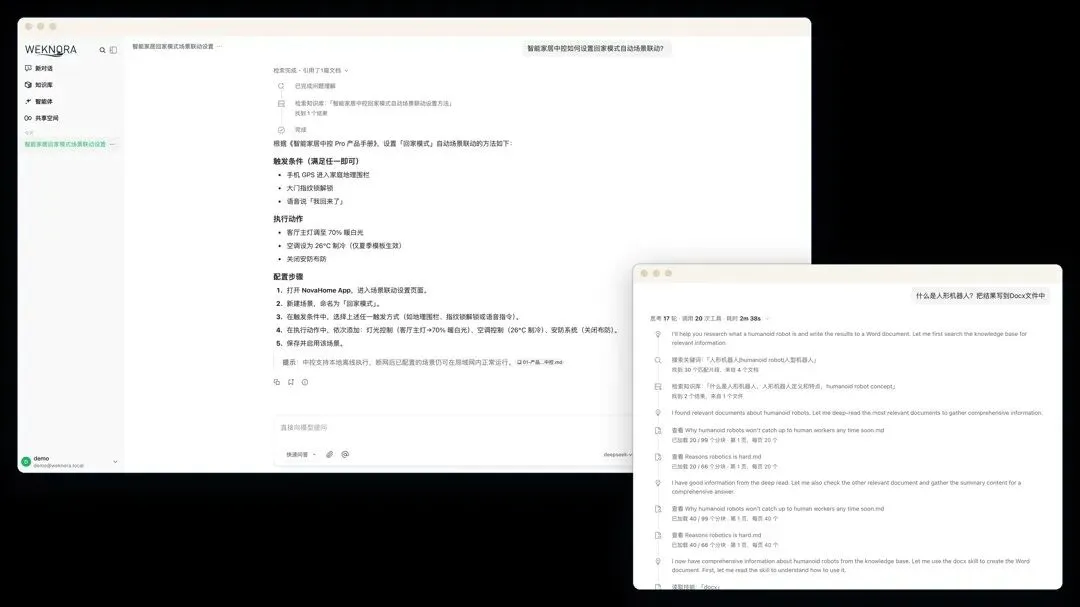
传统搜索的终点是「命中页数」,RAG 往前走了一步,终点是「一段能读的答案」。但 WeKnora 的 RAG 更较真:每句话都带引用。它用混合检索(向量 + 关键词)在全文里找,PDF 里的图表、Word 里的表格、Excel 里的数据都能一并解析,最后把答案和来源钉在一起。
你看到的不是「据我所知」,而是「据这份 2024 部署文档第 4 步」。
这听起来像小事,实际是信任问题。团队敢不敢把知识库交给 AI,关键就看它会不会瞎编。引用可追溯,答案才站得住。
对比同类纯问答插件,WeKnora 把「可核查」做成了默认项,而不是高级开关。你要的不是一个自信的模型,而是一个说得清出处、查得到原文的知识助手。
实际用起来,混合检索的价值在长文档里尤其明显:纯向量检索容易被近义词带偏,纯关键词又抓不住语义,两者叠加后,「超时」和「响应慢」、「宕机」和「不可用」这类说法都能被归到同一类问题。文档越多,这种兜底越值钱。
二、Agent:真正的杀手锏,是让 AI 自己动手
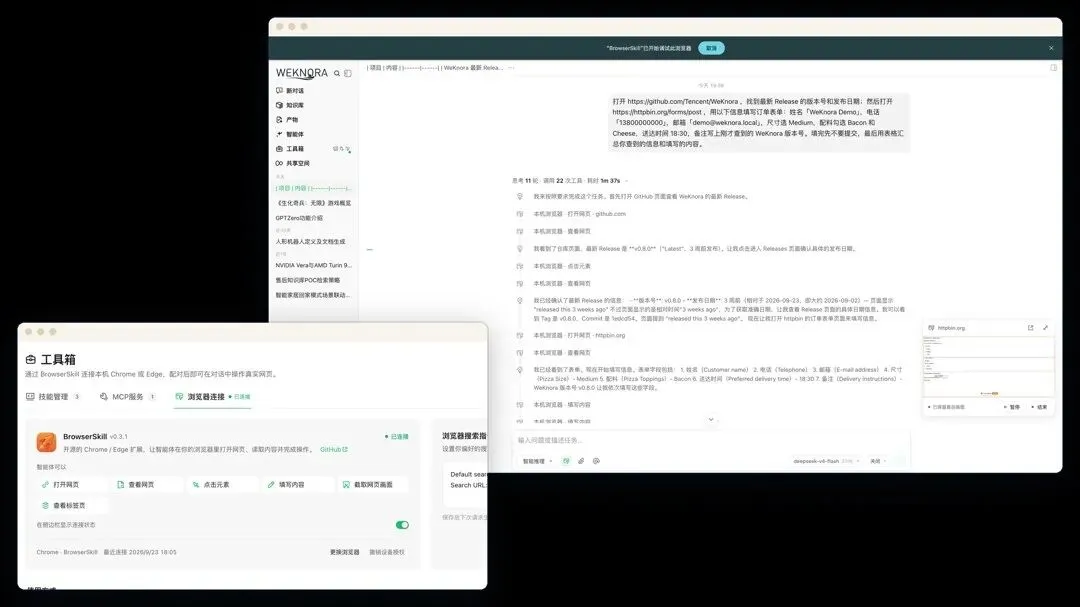
如果只是问答,RAG 就够了。WeKnora 真正往前迈的那一步,是 Agent 模式:AI 不再只回答问题,而是自己规划多步任务、调用工具、跑代码、操作浏览器。
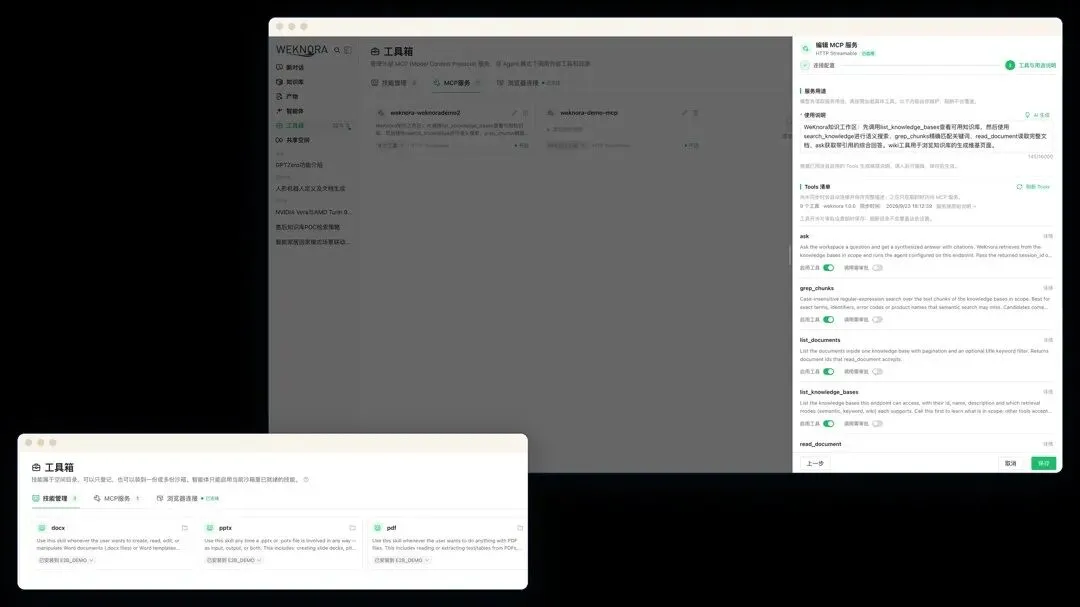
它自带一个「工具箱」:可以从 ClawHub、SkillHub、Git 或 ZIP 安装技能,在 Docker / E2B / Cube 沙箱里隔离运行;通过 BrowserSkill 直接操作你自己的 Chrome 或 Edge;还能把外部的 MCP 服务(支持 OAuth)一个一个接进来,按需启用。
这意味着什么?你问一句「帮我把上季度所有客户工单里提到『超时』的整理成表」,它不会只回一段文字,而是真的去检索、过滤、生成表格,甚至把结果写回你的知识库。
# 用作用域 API Key 调 WeKnora,让 Agent 自己检索并出报告importrequestsurl="http://localhost:8080/api/v1/chat"headers= {"Authorization": "Bearer <你的SCOPED_KEY>"} data= { "kb_id": "kb_prod_docs", "message": "汇总近 30 天工单中提及超时的条目", "mode": "agent", # 走 Agent,而非纯 RAG"tools": ["search", "code_runner"], } r=requests.post(url, json=data, headers=headers) print(r.json()["answer"])
同类方案大多停在「问一句答一句」,WeKnora 把「问完还能动手做」补上了——这才是「让 AI 自己查」这句话的分量。
一个典型场景:客服知识库里散着几百条历史工单,新同事问「上个月物流投诉怎么处理的」,Agent 会先检索相关工单,再调取当时的处理 SOP,最后把结论和对应工单号一起返回。整个过程不需要人去翻,也不需要把数据导到第三个系统。
三、Wiki:把一堆原始文档变成活的知识库
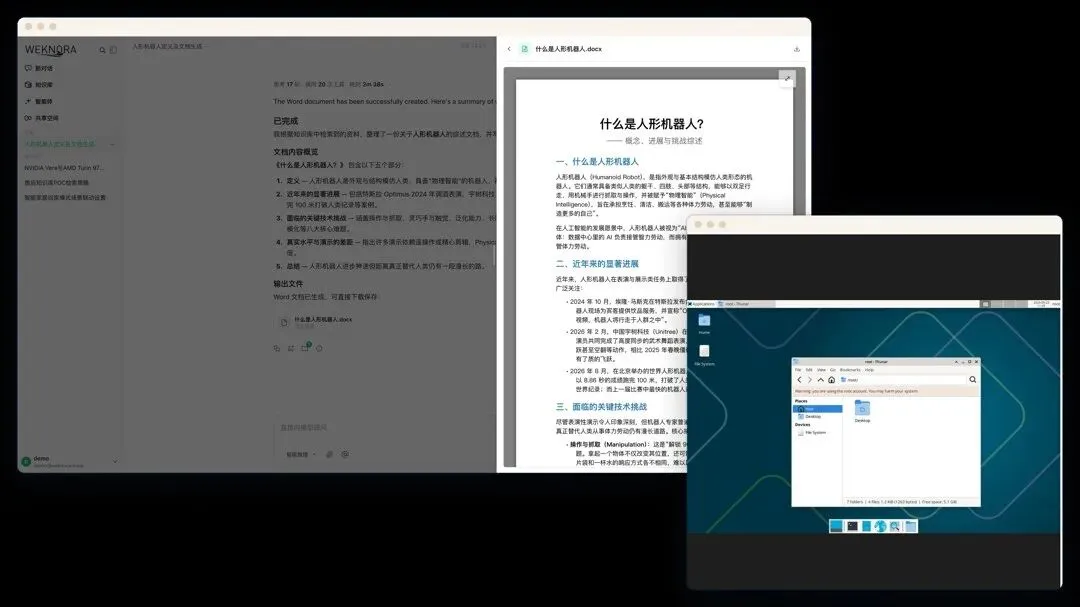
文档最怕两件事:放进去就没人动,以及放进去就再也没人信。WeKnora 的第三块能力 Wiki,专门治这个。
它把散落的资料自动组织成一套带知识图谱的 Wiki,关键是你改了原始文档,Wiki 能跟着更新;某次整理搞砸了,还能回滚到上一版。检索到的片段也能直接编辑、对比差异,而不是改完就覆写、再也回不去。
对团队来说,这等于给知识库装了版本管理。新人进来不再面对一堆日期混乱的 PDF,而是一张能顺着点下去的关系网。
更关键的是,Wiki 不是一次性导出。它和原始文档保持联动——你修正了一处接口说明,相关条目会自动跟着改,而不是留下一份永远过期的快照。对那种「文档写完就没人敢动」的团队,这等于把维护成本从人力挪到了系统。
四、同一份知识库,三种模式随便切
RAG、Agent、Wiki 不是三套系统,而是长在同一份知识库上的三种用法。你上午用 RAG 查个参数,下午让 Agent 跑个分析,晚上 Wiki 自动把新文档归纳好——数据只存一份,能力各取所需。
更让人放心的是部署:大模型、向量库、存储后端全都能换,可以跑在本地,也能上私有云,数据始终留在你自己的环境里。对金融、医疗这类对出网敏感的行业,这点几乎是一票否决项里的救命条款。
模型层面也够开放:内置 27 家厂商,OpenAI、DeepSeek、通义千问、智谱、混元、Gemini、MiniMax 到 Ollama 本地模型都能接,不必被某一家绑死。
换句话说,今天用 DeepSeek 跑推理、明天换混元,对上层业务几乎无感;向量库从 Milvus 切到 pgvector,也只是改个配置。这种可替换性,是它敢叫「框架」而不是「应用」的底气。
快速上手:从 clone 到第一次跑通
门槛比想象中低。只要装好 Docker 和 Git,几条命令就能把整套服务拉起来:
git clone https://github.com/Tencent/WeKnora.git cd WeKnora cp .env.example .env # 按需改模型与路径 docker compose pull # 拉取最新镜像 docker compose up -d # 启动核心服务
启动后打开 http://localhost 跟着引导走就行。想用本地模型,先 ollama serve 把 Ollama 跑起来,再在 .env 里填上 embedding 模型名和 OLLAMA_BASE_URL,数据不出本机。
如果嫌自己折腾麻烦,还有两条更省心的路:直接走微信对话开放平台在线管知识库,或从腾讯云轻量应用服务器的应用模板一键部署。三种方式,数据所有权都在你手里。
跑起来后常见的几个坑先说在前:一是 80 端口被占用,改 .env 里的 WEB_PORT 就能避开;二是忘了配模型 Key,页面能打开但问答报错,先回 .env 核对 MODEL_* 字段;三是数据默认落在 ./data 目录,重装前记得备份,别把知识库一并清掉。官方文档 weknora.weixin.qq.com/docs 把每一步都配了示例,照着走基本不会卡。
架构与设计哲学
WeKnora 的设计哲学可以一句话概括:让知识从「存起来」变成「用起来」。它没有把 RAG、Agent、Wiki 做成三个孤岛,而是共用同一层知识底座——检索、推理、整理在底层打通,上层才分模式。
这种架构的好处是复利效应:你每往里丢一份文档,三种能力同时变强;而不是今天喂给搜索、明天再单独训练一个问答机器人。对企业来说,省下的是重复建设和长期维护的成本。
落到工程上,它把解析、嵌入、检索、推理拆成可插拔的模块,每个都能单独替换或横向扩展。任务队列带 worker 池治理,Agent 的每一步还能接 Langfuse 做链路追踪——这对要上生产的团队很重要:你不仅能用,还能看清它每一步在干什么、花了多少 token。
据 README,该项目已有 3.1 万 Star,采用 MIT 协议,Go 语言编写,迭代到 v0.8.2。生态也在长:飞书文档、Confluence、GitLab、Notion、语雀、钉钉文档、RSS 都能自动同步,PDF、Word、图片、Excel、XMind 等十多种格式直接解析;还能接企业微信、飞书、Slack、Telegram,甚至给 Cursor、Claude 这类 AI 工具开一个内置 MCP Server。
结尾
如果你也受够了「文档写了一堆、关键时刻找不到」的循环,WeKnora 值得花一个晚上 clone 下来试试。它不一定适合所有团队,但「让 AI 自己检索、推理、整理」这条路线,大概率是知识库接下来的样子。
如果这篇对你有用,点个 Star 让更多人看见,也欢迎在评论区聊聊你们团队是怎么管知识库的——踩过的坑,往往比方案本身更有价值。