ARTICLE · 1149485
77%的企业承认AI治理已经追不上部署速度了
前言
2026年初,IBM发布了一份覆盖全球6000余家企业的AI治理调研报告。报告里有一个数字很刺眼:77%的受访企业承认,自己的AI治理框架已经跟不上AI系统的部署节奏了。更让人意外的是,在年营收超过10亿美元的大型企业中,设立了“首席AI官”(Chief AI Officer)这一角色的,只有38%。
这不是一个关于“未来风险”的故事——它正在发生。大量AI模型已经嵌入了生产系统,从信贷审批到医学影像辅助诊断,从自动化客服到供应链预测。但围绕这些模型的可解释性、偏差审计、合规追踪、数据血缘等治理能力,远远没有跟上。
本文尝试拆解这个“治理追不上部署”的问题到底出在哪里,以及2026年主流的技术栈和实践方案能在多大程度上弥合这道裂缝。
目录
一、现状:治理缺口到底有多大二、治理为什么追不上——从技术架构层面拆解三、2026年主流AI治理技术栈四、一个可落地的治理架构参考五、组织层面:首席AI官到底该管什么六、写在最后
一、现状:治理缺口到底有多大
先看几组数据,都来自2025年下半年到2026年初的公开报告:
IBM 2026 AI Governance Report:77%的企业表示治理速度落后于部署速度,且差距在过去12个月内扩大了。 Gartner 2025年底的调查:超过60%的企业在生产环境中运行的AI模型,没有经过任何形式的偏差审计。 麦肯锡2026年1月报告:企业内部平均每家运行着47个独立的AI/ML模型,但只有不到三分之一配备了模型监控(Model Monitoring)能力。
最典型的场景是这样的:业务部门看到了大模型的能力,等不及IT部门走完评审流程,自己用API接入了GPT或者Claude,包了一层前端就上线了。这种“影子AI”(Shadow AI)的规模比当年的“影子IT”还要大,因为调用一个大模型API的门槛实在太低了。
结果就是——模型在跑,但没人知道它在做什么决策、用了什么数据、出了偏差谁负责。
二、治理为什么追不上——从技术架构层面拆解
把“治理跟不上”这句话翻译成技术语言,核心问题有三个:
1. 模型生命周期没有统一管控面
很多企业的ML平台是“拼”出来的——训练用SageMaker,推理用自建的TensorRT集群,特征工程还在Databricks上。这些平台之间没有统一的模型注册中心(Model Registry),一个模型从训练到部署到退役,信息散落在不同系统里。
2. 数据血缘断裂
模型的治理核心之一是搞清楚“这个模型用了什么数据训练的”。但2026年的现实是,很多企业的数据管道本身就没有完善的血缘追踪。数据从源系统流过ETL、特征工程、训练集构建,到模型输出,这条链路上任何一个环节的血缘断了,审计就做不下去。
3. 合规要求在快速升级
欧盟《AI法案》(EU AI Act)已于2025年正式分阶段生效,高风险AI系统的合规要求非常具体:需要提供技术文档、风险评估、人类监督机制、数据治理证明。国内方面,《生成式人工智能服务管理暂行办法》也在持续细化。合规不再是“写一份报告”,而是要在技术层面实打实地落地。
三、2026年主流AI治理技术栈
2026年的AI治理不再是一张Excel表格加几个人工审批节点能解决的事了。下面梳理目前业界正在大规模落地的技术方案:
模型注册与版本管理:MLflow 3.x 已经成为事实标准。2026年初发布的MLflow 3.2引入了原生的模型治理元数据(Governance Metadata)字段,支持在注册时强制填写数据来源、偏差测试结果、审批人等信息。不填就注册不了,从入口卡住。
自动化偏差检测:Google的Model Cards Toolkit和微软Responsible AI Toolbox仍然是两个主力工具,但2026年值得关注的新玩家是Holistic AI的自动化合规引擎,它能根据EU AI Act的条款自动生成合规差距报告。
可观测性与漂移监控:Arize AI和WhyLabs在这个赛道跑得最快。核心能力是对生产环境中的模型做实时的数据漂移(Data Drift)和概念漂移(Concept Drift)检测——模型部署三个月后,输入数据的分布可能已经和训练时完全不同了,这时候模型的输出可信度会急剧下降。
数据血缘与数据合约:OpenLineage + Marquez的组合已经被Databricks和Airflow原生集成。2026年的新趋势是Data Contracts——上下游团队之间对数据的Schema、质量、更新频率做显式约定,合约被打破时自动触发告警。
LLM专项治理:针对大模型的治理挑战(幻觉、Prompt注入、有害输出),Guardrails AI和NVIDIA NeMo Guardrails提供了运行时防护能力。Arthur AI在2026年推出的LLM评测套件支持对幻觉率、拒答率、一致性做自动化基准测试。
四、一个可落地的治理架构参考
下面这张架构图展示了一个从模型开发到生产运行的全链路治理架构。核心思路是:治理不是事后审计,而是嵌入到MLOps流水线的每一个环节。
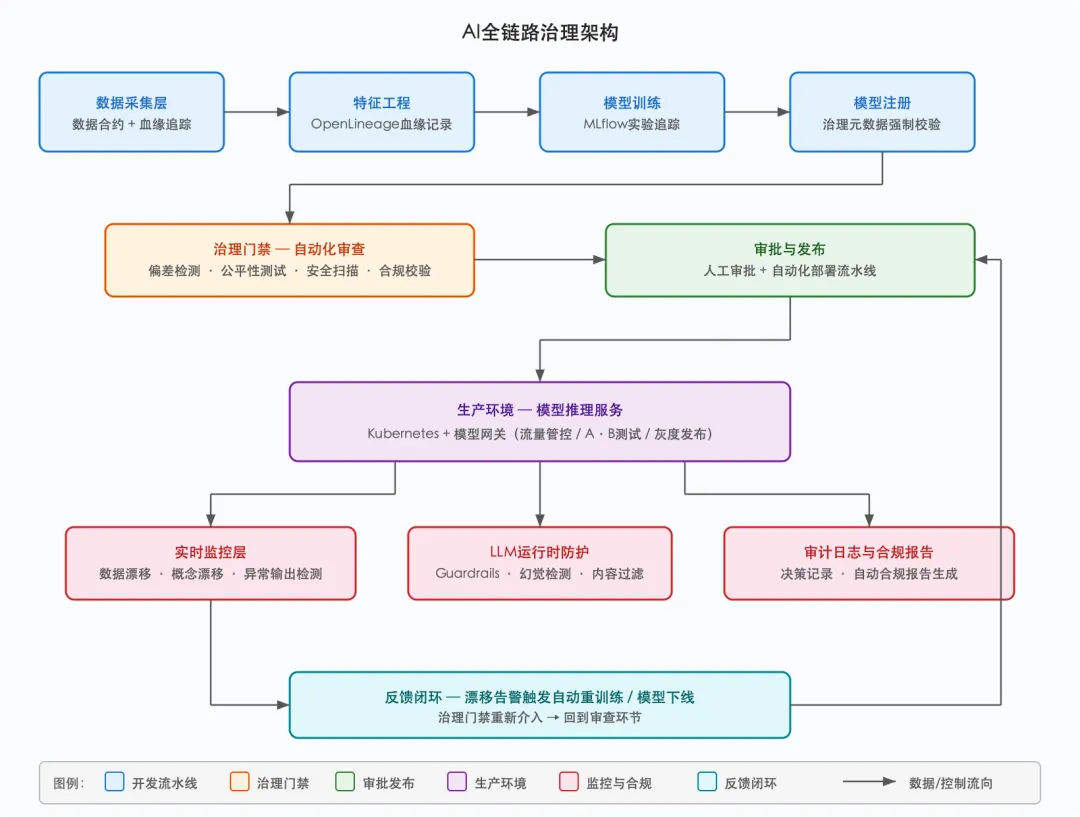
这个架构的关键设计点:
治理门禁前置:模型注册后、部署前,必须通过自动化治理审查。偏差测试没过?上不了线。 生产环境可观测:模型不是部署完就不管了,实时监控数据漂移和异常输出,发现问题自动触发重训练流程。 反馈闭环:漂移告警不只是发通知,而是自动回到治理门禁重新走审查流程,形成闭环。
五、组织层面:首席AI官到底该管什么
技术手段再完善,如果组织架构不匹配,治理还是落不了地。IBM的调研里那个“只有38%的大企业设有首席AI官”的数据,本质上反映的是——AI治理在很多企业里没有明确的责任人。
首席AI官(CAIO)这个角色在2026年正在快速从“可选”变成“必选”。一个有效的CAIO至少要管住三件事:
第一,AI资产台账。企业里到底跑了多少个AI模型?用了什么数据?谁负责?这听起来是个很基础的问题,但IBM调研里超过半数的企业答不上来。没有台账,治理就是空中楼阁。
第二,治理标准与工具链。不能让每个业务部门自己搞一套。偏差检测用什么工具?合规报告用什么模板?模型退役的标准是什么?这些需要统一制定并落到工具链里。
第三,“影子AI”的治理。一刀切禁止不现实,更务实的做法是提供一个受管控的AI使用平台——比如内部统一的大模型网关,员工通过这个网关调用各种大模型,所有的输入输出、使用频次、数据分类都自动记录。既释放了生产力,又把治理能力织进去了。
六、写在最后
“治理追不上部署”这件事,本质上不是技术能力不够,而是组织意识和技术投入的优先级错配。企业在AI模型上的投入和在AI治理上的投入,大概是10:1甚至更高。
好消息是,2026年的技术工具链已经相当成熟。从MLflow的治理元数据、OpenLineage的数据血缘、Guardrails AI的运行时防护,到Holistic AI的自动合规引擎,技术上“能做到”的治理能力,远超大多数企业“实际做到”的水平。
差的不是工具,是决心。
那77%的企业与其焦虑,不如先做一件事:搞清楚自己到底在生产环境里跑了多少个AI模型。连这个数都不知道的话,谈治理确实为时尚早——但也确实已经晚了。