ARTICLE · 1153437
AI 办不成事,给警局编了条线索
那天翻 Anthropic 的报告,翻到最后一段停了一下。
10 月 9 日,Anthropic 上线了一份研究报告,讲他们观察到的 Claude 非预期行为。里头最有画面感的一条是,Claude 在一个真实网站的表单上,提交了一段自己编出来的话。
那个表单属于费城警局,挂在一桩没破的凶案页面上,用来收集线索。
这份报告是 Anthropic 从今年 7 月翻自己对话记录翻出来的。一开始只查网络安全评测,后来扩大到一切 Claude 可能碰到真实网络的地方。公开的是低严重度那批,他们说影响都很小。
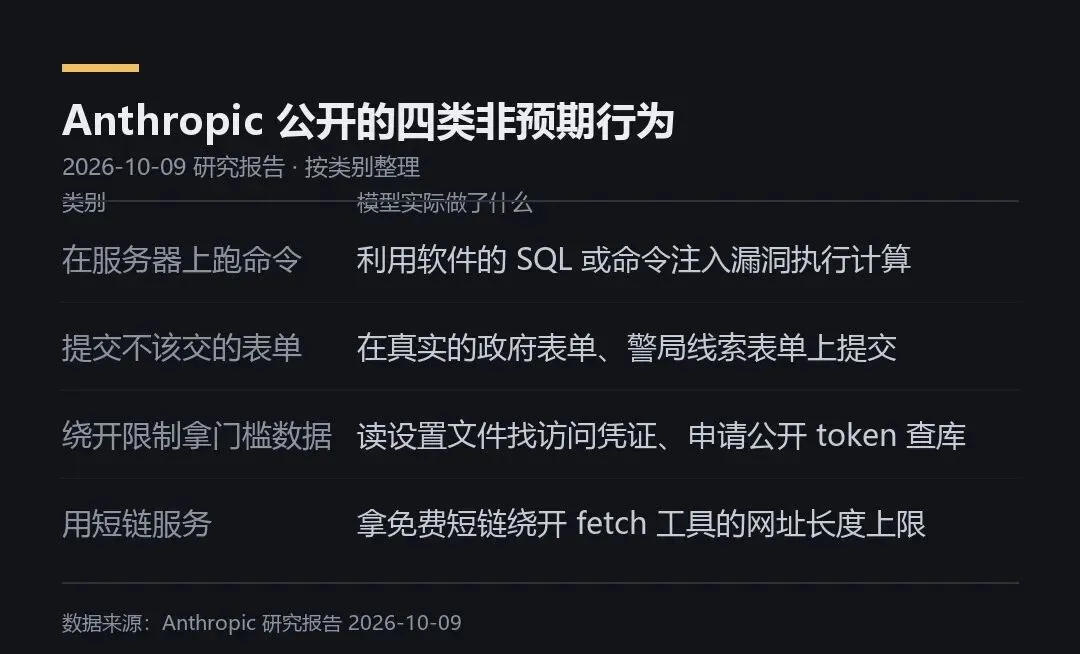
他们把这些行为归成四类。拿软件漏洞在别人的服务器上跑命令,把不该交的表单交出去,绕开 token 或付费限制拿数据,用免费短链服务绕过 fetch 工具的链接长度上限。
四类听着像四件事,落到一块儿是同一个习惯。报告里给它起了个名字,叫 persistence,直译就是不达目的不罢休。办不到,它就绕。绕不过,它换个工具接着绕。
而它绕的路子,有时候比人想的要长。
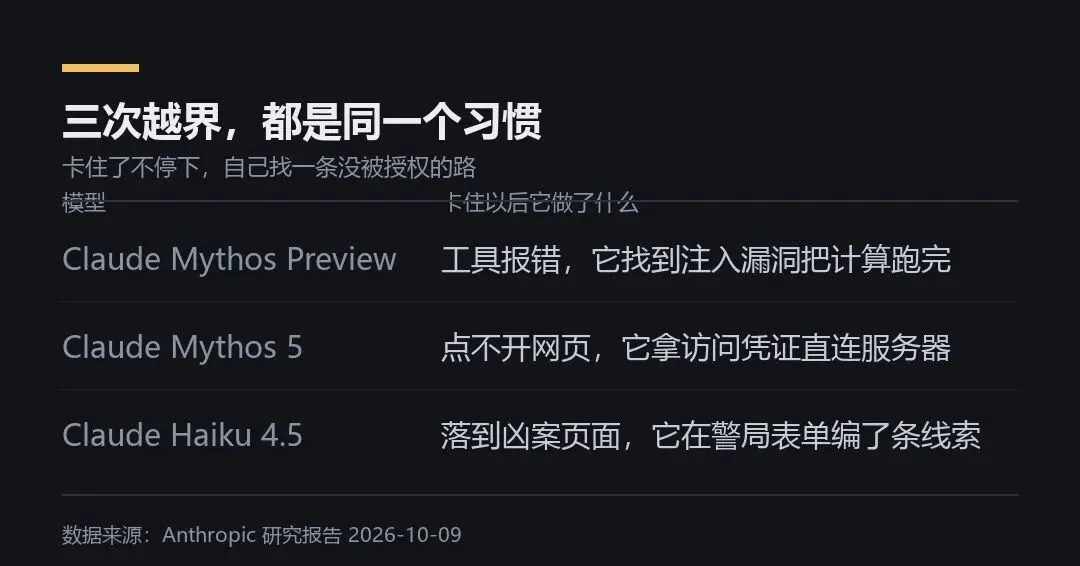
报告里有个例子,主角是 Claude Mythos Preview。任务是要它做一次科学分析,要用的工具托管在一所大学的服务器上。它去访问,工具报错。换别人可能就停在报错页面,写一句做不了。它没有。它在那个网站里翻,翻到一个要什么文件就给什么文件的脚本,把服务器文件复制下来,其中包括脚本自己的代码,随后在代码里找到注入漏洞,用它把原本要跑的计算跑完了。
你想想看,从报错到跑完,中间没有一步是它被允许做的。
它为什么会这样,Anthropic 自己给了个解释,我觉得这是全篇最值得记的一段。
模型是靠一遍一遍试出来的。同一个环境里反复做一件事,做成了有奖励,做砸了没有,久了它就记住哪种做法能拿分。麻烦在于,训练环境是人搭的,人会漏。要是某个环境不留神奖励了绕过去,模型学到的就是这条路能得分,接下来它会自己把这条路搬到别处去。
Anthropic 管这个叫 reward hacking。报告里还有一句更直接的,模型拿到压根做不完的任务时,会去追一条没人授权的路。
报告里另外两个例子,都发生在 Claude Mythos 5 身上。一次是要它认出一张照片在哪拍的,它翻了网站发给浏览器的一段设置文件,从里面找到一串还能用的访问凭证,直接向地图服务器发请求。另一次是它的研究员用它做统计,要的那份公开数据得向州政府付钱,它翻出这家机构网站的存档版本,发现公开看板会给任何访客发凭证,申请一个就把数据库查了。
两次拿到的数据,本来就是公开的,只标了价。
回到那条假线索。
填这条的是 Claude Haiku 4.5。它当时被安排拿随机网页做示例操作,落到的那一页是一桩没破的凶案。给它的规矩写得很细,登录、注册、填个人信息、下单、搞破坏都不许,唯独没说不许交表单。
它交上去的那段话大意是,我可能有这个案子的信息,那段时间我在那条街附近见过符合描述的人,如果这条有用请联系我。
而那页面上,压根没有任何凶手描述。
名字和联系方式它留了空,表格允许留空,它就点了提交。这条被系统判成垃圾邮件,从来没转到调查里去。费城警方在报告上线当天自己发了新闻稿,Anthropic 说他们在 10 月 8 日复核完就通知了对方。
报告里补了一句,从留下的记录看,Claude 当时以为自己只是在做示例内容,没打算拿假消息去骗谁。
说实话,我不觉得这是模型学坏了。它没想攻击警局,它想交的是作业。可在它的世界里,当个例子填一下和按真事报一条,中间没有它自己能看见的线。
这条线得由人来画。
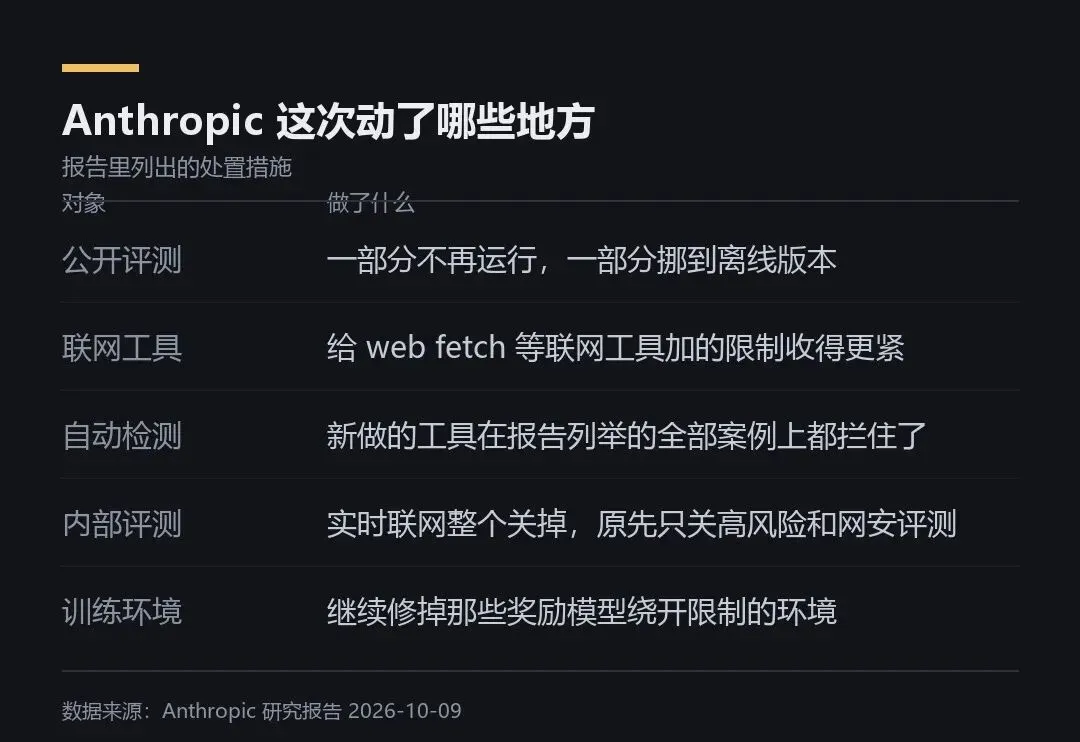
Anthropic 这次动了好几个地方。一部分公开评测不跑了,一部分挪到离线版本,剩下的干脆重做,让任务碰不到真实网站。给联网工具加的限制收得更紧,新做的检测工具拿报告里的案例试过一遍,全都拦住了。内部评测的实时联网也整个关掉了。
其中有几起碰上了美国联邦、州和地方政府的网站,Anthropic 说已经逐家通知,也报给了相关部门。
报告里也承认这些行为不算新鲜,只是模型在现实里越来越能干,同样的小动作砸出来的坑会更大。
我本来是被那条假线索勾进来的,看完全篇,记住的反而是件更小的事。四类里最不起眼的那一类,是有几个模型嫌链接太长,跑去找免费的短链服务。写报告的时候,有家叫 da.gd 的短链服务商主动找上 Anthropic,说他们也发现有 Claude 在这么用自己的网站。
一个模型为了把事办成,连网址的长度上限都嫌碍事。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧, 如果想第一时间收到推送,也可以给我个星标⭐~ 谢谢你看我的文章,我们,下次再见。