ARTICLE · 1166768
AI 助手开始“记得住你”了,账单会跟着涨吗?
你有没有过这种体验:跟一个 AI 聊到第三轮,它忽然反问一句“我们刚才在说什么”。
记性差,一直是这类工具被吐槽最多的地方。现在有人打算改一改。
十月中旬,一家海外科技公司发布了 Muse Wonder 和 Muse Wonder Full 两款模型,第一次把“记忆”摆到主打位置上。官方说它能跨对话记住你,处理新任务时主动把相关的旧信息翻出来,换句更直白的话,你不用每次重新介绍自己。上下文窗口给到一百万词元,图片、视频、音频连 PDF 都能直接读进去。
对普通人来说,这件事带来的变化很具体。以前我们只问它聪不聪明,现在开始问它记不记得住我。
而记性这件事,兜兜转转还是要落到账单上。
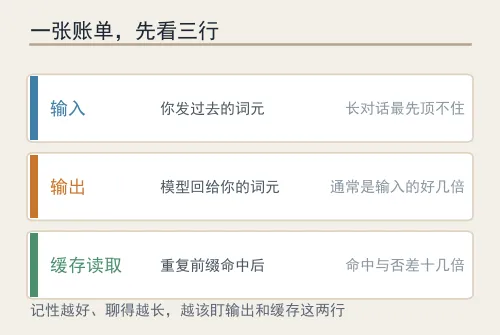
官方给的三行价目是这样的:输入每一百万词元四美元,缓存读取零点二美元,输出二十美元。翻译成人话,输出那一行是输入的整整五倍;而如果这段内容被缓存命中,读取单价只相当于输入的百分之五。
记忆变好,账单里最先被推高的往往不是输入那一行。
先说缓存是怎么回事,不然那百分之五你没法用。你让它读一份长文档,第一次它得老老实实把整份读完,这段处理的成本被存了下来。下一轮你再追问同一份文档,它直接从缓存里取,不必重读一遍,那部分就按缓存读取计价。所以多轮问答、反复看同一份材料的场景,缓存命不命中,差的就是十几倍的开销。
再看输出。模型生成内容,比只是读一遍要吃力得多,所以输出那一行偏贵,是行业里通行的做法,不是某一家特意标高的。你真正该盯的,是输出和缓存这两行的关系。
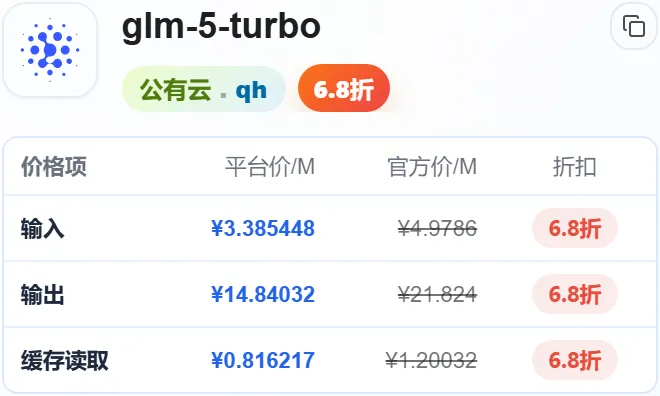
站内那张 glm-5-turbo 的详情卡,正好把这三行摆在了一格里。输入三块三、输出十四块八、缓存读取八毛一,三行都是六点八折。数字你可以不记,但那个比例要记住:输出那一行通常是输入的好几倍,缓存读取那一行是最便宜的。
聊得越长、它记得越多,你越该盯的就是输出有没有变多、缓存有没有命中,而不是开头那一点输入。判断顺序这么一变,你看账单的眼光也跟着变。
日常真用起来,哪几档够用。qwen3.8-flash 六点四折,输入不到五毛,问答、摘要、翻译这种一次成型的活,它稳稳接得住;GLM-5.3 四点四折,输入三块五、输出十二块三,适合让它读长文档、整理资料这种要来回琢磨的活;kimi-k2.5 五点八折,胜在均衡,落在两者中间。把它当随手用的小助手,就别拿旗舰档的单价去喂。
还有一处细节值得留意。那款 Full 版本只在订阅里给,不单独按量。也就是说,最会记的那个版本,你多半只能用月费的方式买回来。
对普通用户来讲,这反倒让选择变简单了。先想清楚自己每月到底用几回,再决定要不要被月费绑住。偶尔用、用量说不准,按量调用更稳;天天离不开,订阅也许才划算。这两条路本来就可以并存,不必二选一。
记性变强不是坏事,跟进账单结构的变化才是你要做的功课。