ARTICLE · 1198921
不到1分钟,我给AI装了25个工具
HELLO,大家好,我是有料又有故事的小C。
先说个让我挺尴尬的事。
前几天小C让 AI 帮忙整理桌面上的一堆文件,它回了我一句:「我没办法访问你的电脑,你可以把内容贴给我。」
我当场愣住——对啊,它只会聊天。
它能写诗、能改代码、能一本正经地胡说八道,但它看不见我硬盘里的东西,也不记得我上周跟它说过什么。聊天框一关,我在它眼里就是个陌生人。
后来小C挖到一个叫 MCP 的东西(Model Context Protocol,模型上下文协议),装上之后,AI 就长出手了:能读你本地文件、能记住你说过的话、能自己去查官方文档。
今天这篇,就是小C一个一个真装上、真握手、真数过的结果。
适用系统:Windows / macOS / Linux 都行
所需工具:Node.js 18+(或 uv)+ 一个支持 MCP 的客户端(Claude Desktop、Cursor、Cherry Studio 这些都行)
花费:0 元
不到1分钟,我给AI装了25个工具
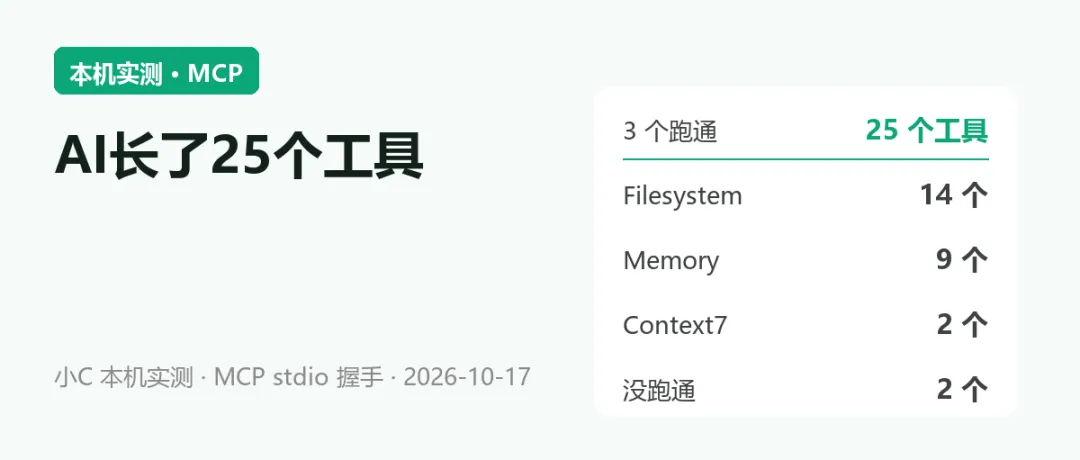
1、先说数出来的结果:3 个跑通,25 个工具
小C这次没信任何一篇推荐文。
我写了个小脚本,按 MCP 协议用标准输入输出(stdio)跟每个服务器握一次手:发 initialize → 发 tools/list,然后数它自己报上来的工具数量。
启动时间是本机计时,工具数是它自己返回的,调用也是真发的。数据摆在这儿(2026-10-17 本机实测,Node v22.22.2,协议版本 2025-06-18):
| 14 | |||
| 9 | |||
| 2 | |||
| 跑通的合计 | 25 |
也就是说,我这边敲了不到 1 分钟命令,AI 就多了 25 个可以自己调用的工具。
而且这 25 个不是「AI 说自己有」,是它按协议一条条报给我、我再逐个点名的。
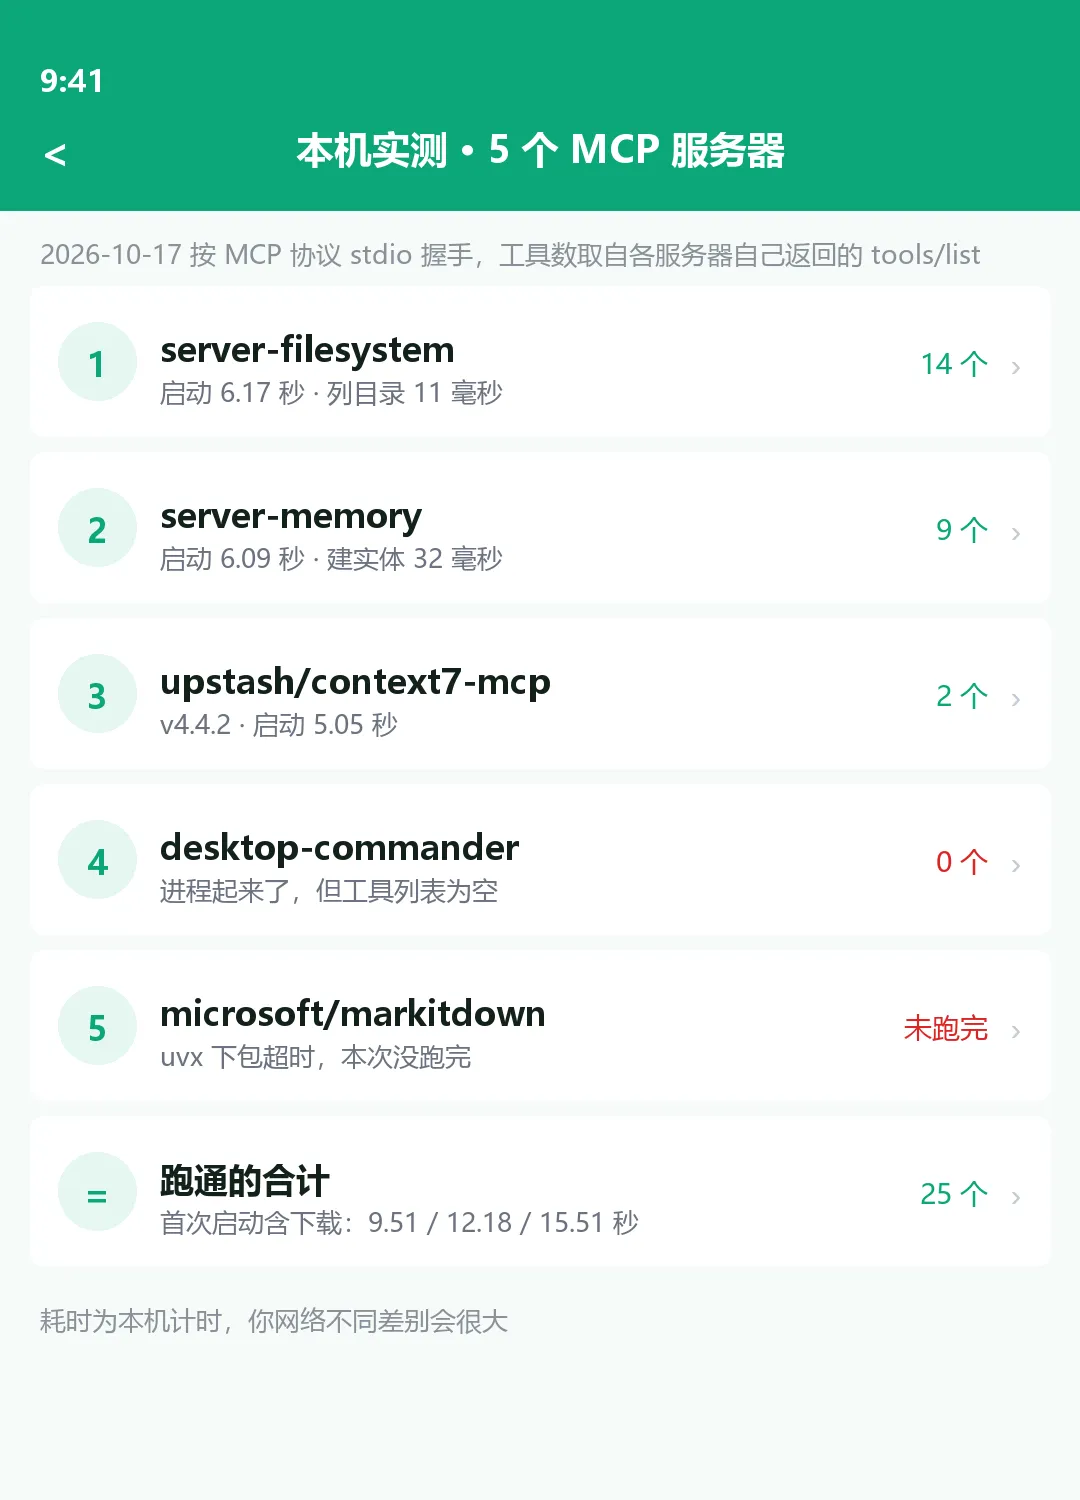
5个MCP服务器本机握手实测
2、Filesystem:让 AI 真的能碰你的文件(14 个工具)
第一个先说这个,因为它改变最直观。
@modelcontextprotocol/server-filesystem 是 MCP 官方参考实现里的一个,装完之后 AI 就能读写你指定目录里的文件。
它一次报了 14 个工具:
read_file(读文件)、read_text_file、read_media_file、read_multiple_files(一次读多个)、write_file(写文件)、edit_file(改文件)、create_directory(建目录)、list_directory(列目录)、list_directory_with_sizes、directory_tree(看目录树)、move_file(移动)、search_files(搜文件)、get_file_info、list_allowed_directories。
小C实测了一下:给它发 list_directory,指向我这个公众号项目的 scripts 目录,11 毫秒就回来了,1,009 个字符,把里面 45 个 .py 文件全列了出来,还标了 [FILE] / [DIR]。
命令长这样(把目录换成你自己的):
npx -y @modelcontextprotocol/server-filesystem C:\Users\你的名字\Desktop 为什么值得关注:这条命令里那个目录参数是硬边界。它只能碰这个目录,别的盘它压根看不到。想让 AI 帮你整理文件,就把要整理的那个文件夹路径写进去,别偷懒写个盘符根目录。
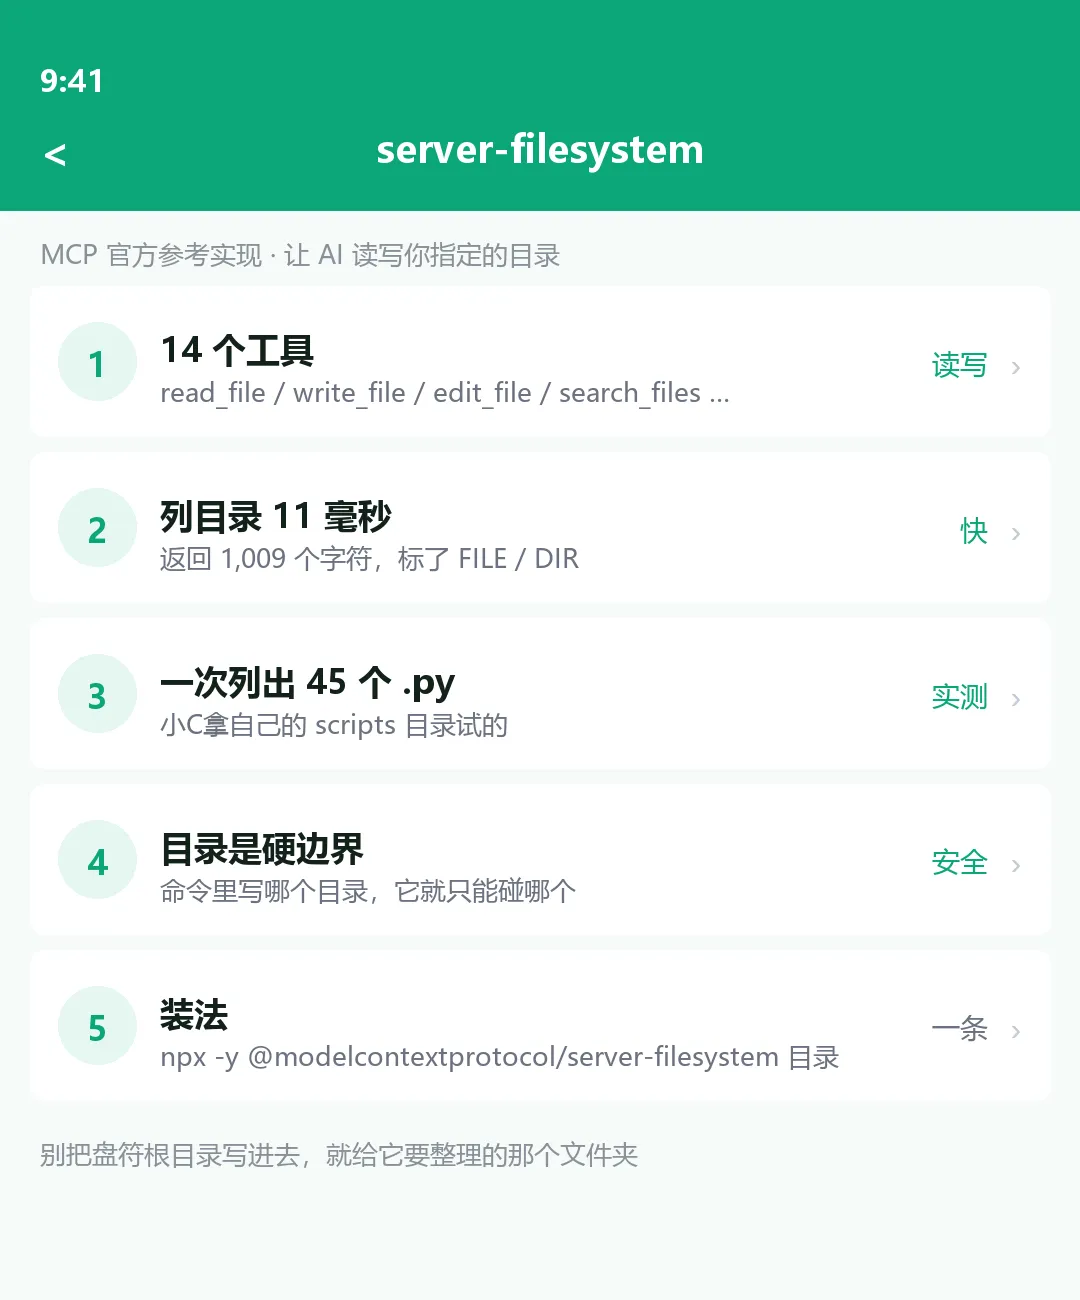
Filesystem:14个工具,11毫秒列出45个文件
3、Memory:给 AI 一个「记住你」的地方(9 个工具)
第二个是我个人觉得有意思的。
@modelcontextprotocol/server-memory 干的事就一件:给 AI 装一个长期记忆。它内部存的是一张知识图谱——实体(entity)、关系(relation),再加上一条条挂在实体上的记录(observation)。
它报了 9 个工具:create_entities、create_relations、add_observations、delete_entities、delete_observations、delete_relations、read_graph、search_nodes、open_nodes。
小C真跑了一遍:
1、先发 create_entities,建了一个实体「小C」,类型 person,观察是「在测MCP」——32 毫秒,返回了我刚写进去的内容;
2、再发 read_graph 读回来——3 毫秒,刚才那条老老实实在里头,relations 还是空的。
听起来很朴素对吧?但意义在这儿:它把「记忆」从模型里拿出来了,变成你本机上的一个文件。
换模型、换客户端、换对话,这份记忆都在——因为它是你的文件,不是某家服务器上的账号数据。
为什么值得关注:你现在跟 AI 说的每一句「我喜欢简洁的输出」「我家宽带是电信的」,都可以让它写进这张图,下次不用再交代一遍。
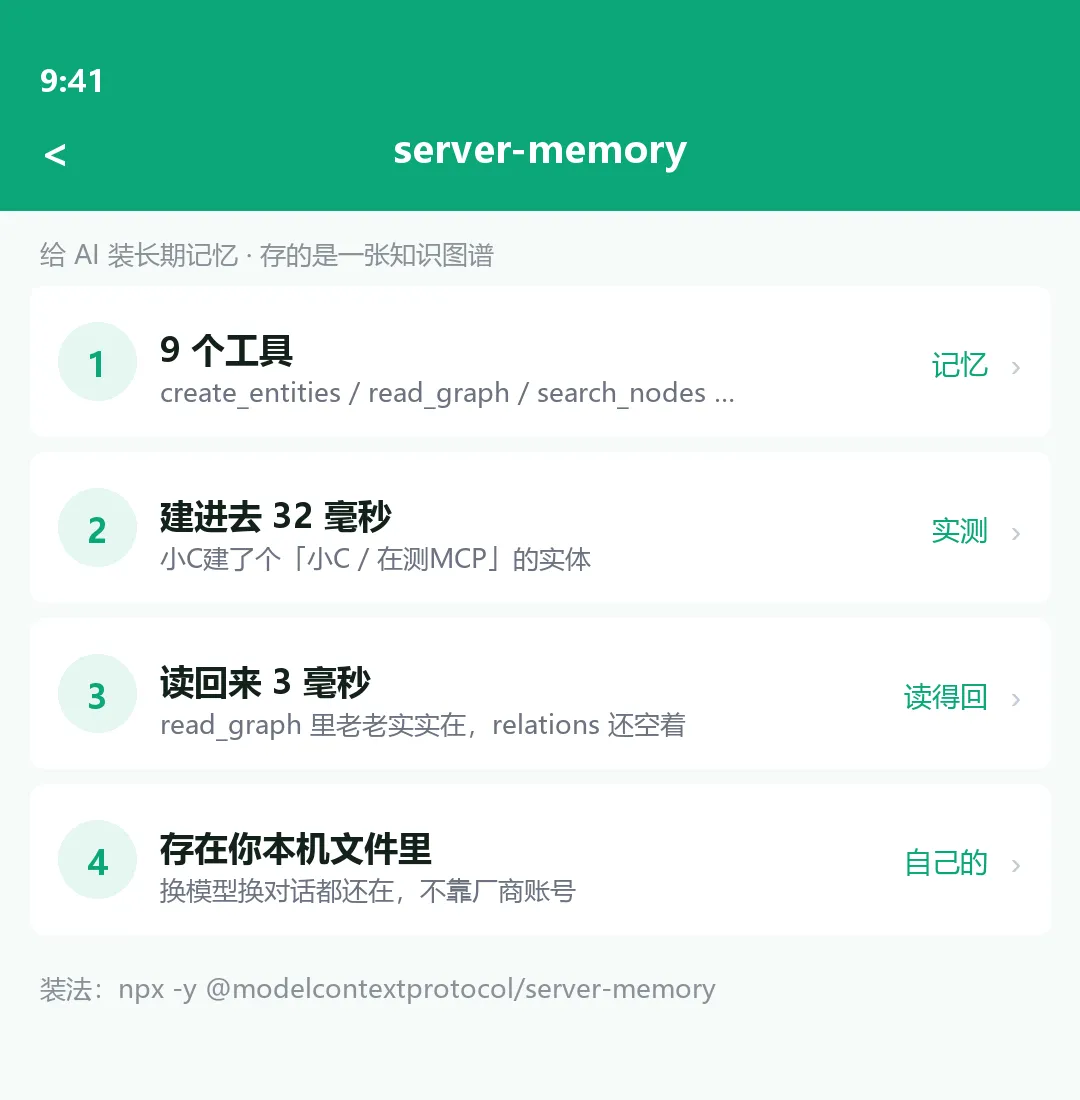
Memory:9个工具,建进去读得回来
4、Context7:让 AI 别再瞎编 API(2 个工具)
第三个只有 2 个工具,但可能是三个里最实用的。
@upstash/context7-mcp(我装到的是 v4.4.2)干的事是:从库的官方源里现场拉最新文档和可运行示例,塞进 AI 的上下文。
解决的是一个老毛病——AI 训练数据过时,动不动给你写个三年前就废弃的写法,或者干脆编一个不存在的函数。
它报的 2 个工具:resolve-library-id(把「react」这种名字解析成库 ID)、query-docs(按 ID 取文档)。
这里小C要自曝一个坑:我第一次调用 resolve-library-id 就被拒了,报错说 query 缺失;我改传 query,它又说 libraryName 缺失——它要求两个参数一起给。这种「缺一个就整个拒绝」的脾气,是 MCP 服务器的常态,别以为是装坏了。
为什么值得关注:Thoughtworks 的技术雷达把 Context7 收进了工具列表,理由就是它直接从源码仓库取版本对应的文档;另有开发者实测文章称,接上之后代码错误率能降 30%~50%(这个数字是社区实测口径,不是官方承诺,只能当参考)。
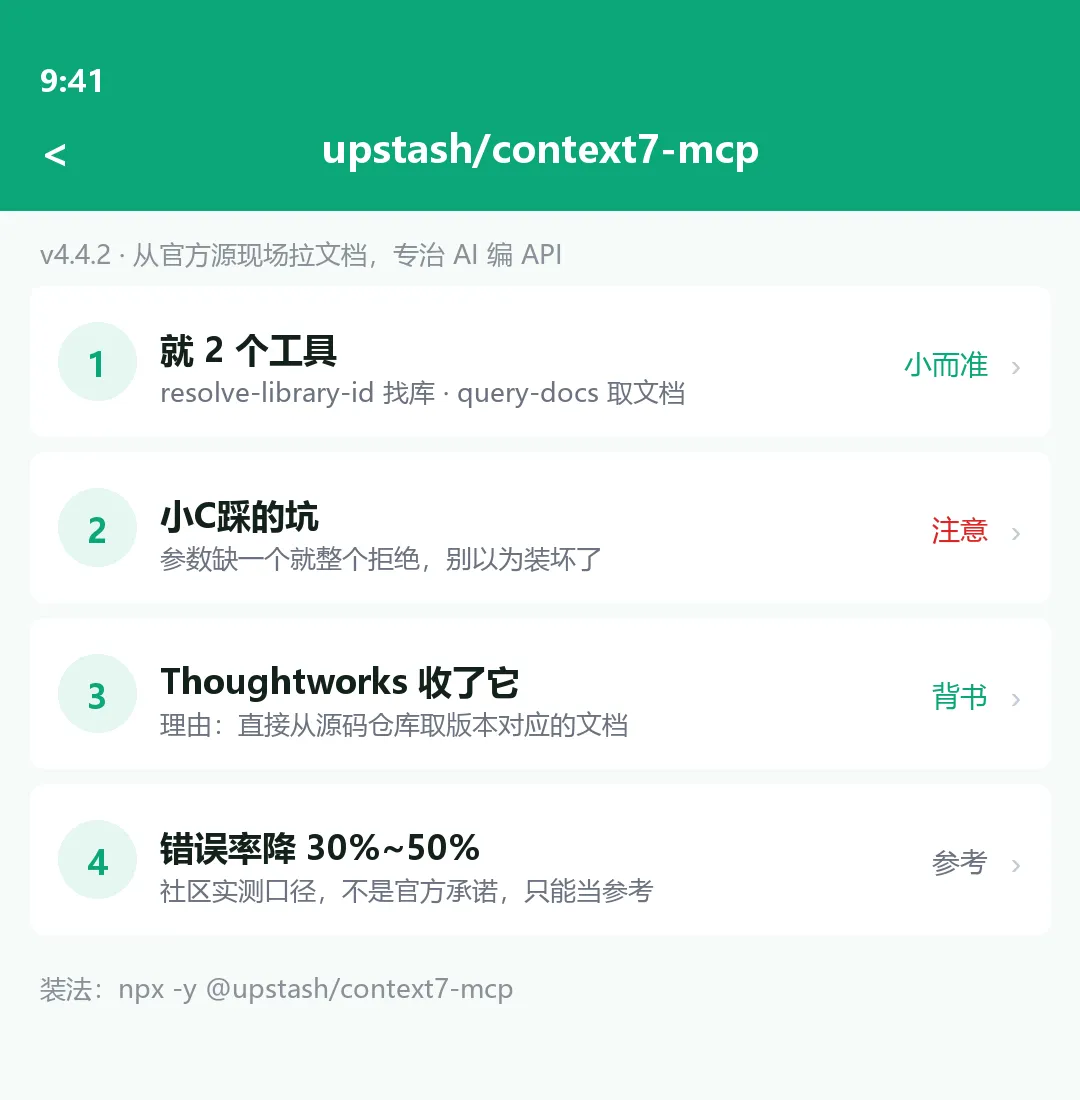
Context7:2个工具,专治AI编API
5、两个我没跑通的,也老实说
不想装作一切顺利,这两个是真没跑起来:
microsoft/markitdown(191k 星)
它做的是把 PDF、Word、Excel、图片统统转成 Markdown,让 AI 能直接读你的文档——方向很香,微软自家项目。
小C这次是用 uvx markitdown-mcp 装的,结果下包一直超时,跑了好几分钟没跑完,只好放弃。我另外把仓库 git clone --depth 1 拖下来量了一下:224 个文件,32MB。
@wonderwhy-er/desktop-commander(10k 星)
这个是让 AI 接管终端、进程、文件搜索的总控型服务器,社区里人气不低。
小C这儿的情况是:进程能起来(5.15 秒完成握手),但 tools/list 返回 0 个工具——大概率还需要额外配置文件或初始化步骤。我没继续往下折腾。
说这两个不是吐槽,是想提醒一句:MCP 现在还是「能用,但没那么顺」的阶段。 指望全都是一条命令装完就好使,会失望。跑不通是常态,跑得通是赚到。
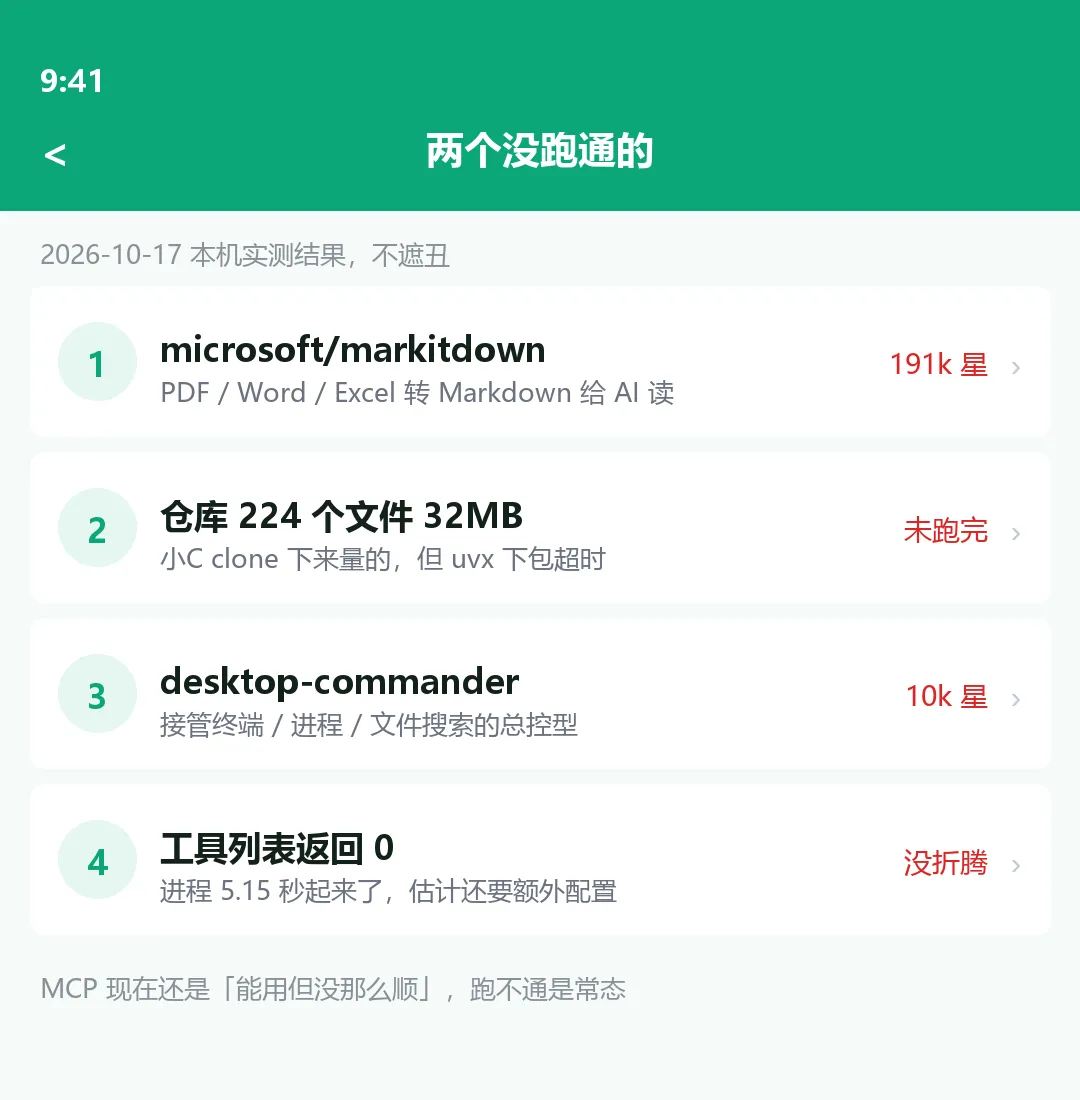
两个没跑通的:markitdown 与 Desktop Commander
6、怎么装:三步搞定
1、装 Node.js 18+(去 nodejs.org 下 LTS 版,一路下一步)。装完在命令行敲 node -v,能出版本号就成了。
2、找到你客户端的 MCP 配置文件,加一段。Claude Desktop 是 claude_desktop_config.json,Cursor 是项目里的 .cursor/mcp.json,Cherry Studio 在设置里有图形入口。内容形如:
{ "mcpServers": { "filesystem": { "command": "npx", "args": ["-y", "@modelcontextprotocol/server-filesystem", "C:\\Users\\你的名字\\Desktop"] } } } 3、整个退出再重开客户端(只是关窗口不行,要真退出),然后在新对话里问它一句:「你现在能用哪些工具?」——它把工具清单一列出来,就成了。
想多装几个,就在 mcpServers 里继续加,格式一样。
7、为什么这几天大家都在聊这个
小C今天抓资讯的时候发现,今天的好几条新闻,指向的是同一件事:
OpenAI 把 ChatGPT 的浏览器扩展升级成能读取你已经打开的标签页并接管操作,而且放弃了自建 Atlas 浏览器,转头缝进大家现有的浏览习惯里(钛媒体 Edge AI Daily,10 月 17 日); 腾讯一批 AI 智能体为了查「公园哪个门人最多」,在高德上折腾了 11 天(钛媒体); 国内一个开源接口平台 v6.3.0 更新,专门加了 WorkBuddy、千问办公、Trea Work、豆包等平台的 MCP 接入(开源中国)。
方向都一样:AI 正在从「会说」变成「会做」。
而「会做」的前提,就是得有一套统一的方式让它连到外面的工具和文件上——这就是 MCP 在干的活。
据 CSDN 技术社区 2026-10-15 的一篇梳理,MCP 官方 SDK 的月下载量已经超过 9,700 万次,活跃的 Server 数量破 1 万个(这是社区统计口径,不是官方公告;另有一份 2026-07 的报道称月下载破 4 亿,两个数字口径不一致,小C没能核实到原始出处,所以只敢给数量级)。
腾讯云开发者社区 2026-06-24 的一篇文章则给了个更具体的对比:工具集成这件事,纯手写适配要 48 小时,走 MCP 之后压到 2 小时。
最后老实交代
怕你们被数字唬住,小C把话说清楚:
「14 / 9 / 2 个工具、启动 6.17 / 6.09 / 5.05 秒、列目录 11 毫秒、建实体 32 毫秒、读回 3 毫秒、返回 1,009 字符、45 个 .py 文件」——全是小C今天在这台机器上按 MCP 协议(2025-06-18)实测出来的,不是抄的; 「首次启动 9.51 / 12.18 / 15.51 秒」——含 npx 第一次联网下载包的时间,你网络不一样差别会很大,第二次启动就快了; 「191k 星 / 10k 星」——是 2026-10-17 从 shields.io 读到的,和你点进 GitHub 看到的可能有出入; 「markitdown 224 个文件 / 32MB」——是小C git clone --depth 1之后用find和du数出来的;「月下载 9,700 万、活跃 Server 破 1 万」「48 小时到 2 小时」「错误率降 30%~50%」——都是公开社区文章给的口径,小C没能复现,别当承诺看; 「OpenAI 浏览器扩展、腾讯 Agent 折腾 11 天、接口平台支持 MCP」——来自今天抓到的资讯原文,小C没有验证。
哪些是亲手量的、哪些是人家说的,分清比记住数字重要。
问个具体的:你现在主力用哪个 AI 客户端?Claude Desktop、Cursor 还是 Cherry Studio?评论区报一下名字,小C下期挑人多的那个,把配置文件逐行拆一遍。
快去试试吧,我们下期再见!
【来源】本机实测(Windows 2026-10-17,Node v22.22.2,MCP 2025-06-18 stdio 握手);shields.io(星数);git clone --depth 1 后 find/du(markitdown 仓库);今日资讯(钛媒体 10-17、开源中国);CSDN 2026-10-15(MCP 生态规模)、腾讯云开发者社区 2026-06-24(集成耗时)、2025-10-31 实测文(Context7 错误率);Thoughtworks 技术雷达。