ARTICLE · 1199518
AI测试27:给AI一份文档,四类用例一次出齐
AI 测试 · 第 27 篇
AI测试27:给AI一份文档,四类用例一次出齐
一份文档丢给 AI,四类测试用例能不能一次出齐?拆一个真实 Skill 的设计:默认策略进主文件,四类专用标准进 references 按需加载。
给AI一份文档,接口、功能、性能、自动化四类测试用例,能不能一次出齐?
能。但前提是那份 Skill 里,「什么叫一条好用例」被拆成了四层,各管一段。
先把答案给你:
一份 Skill 只干一件事,但「干好这件事的标准」可以分层:默认策略写进主文件每次必守,四类专用标准放进 references 按需翻,列名不写死、模板说了算。
这篇拆一份真实的设计文档——doc-based-testcase-generator,干的就一件事:从需求文档、PRD、接口文档里,生成结构化的测试用例。
先说清楚这篇在合集里的位置:02 讲过 Skill 是什么,15 手把手从零搭过一个,24 讲该从哪条路来,25 讲生成用例之前要把哪几条规则写死,26 讲写完了不生效怎么往回查。那五篇讲的都是「怎么写、怎么修」。这篇只做一件事:拿一份现成的设计文档,看「任务单一、标准分层」具体长什么样。
再说这篇材料的来历:文档不是我的,是改编来的,已获授权,文末有说明。选它的原因很实在——它的结构,跟我自己产线用了三个星期的那个 Skill 是同一路数,所以下面每讲一层,我都能拿自己这边对照一遍。
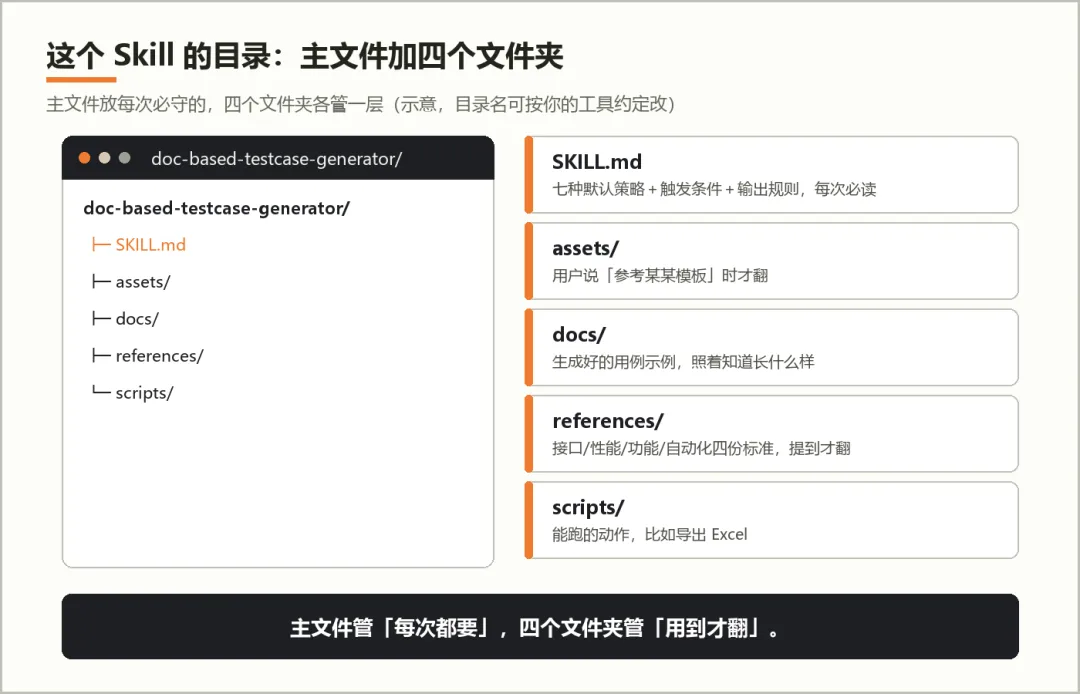
我这边管公众号长文的那套 Skill,主文件只有三十七行,只放三样东西:什么时候用、按什么步骤做、出了错拿什么判。真正干活的全在旁边的 skills/ 目录里——发布、排版、审稿、配图、写作、蒸馏,六个模块各管一段;「用到才翻」的细则,放进 references/。
26 篇排障时我总结过三个卡点:规则是形容词不是判据、没说做完长什么样、一份文件塞了三件事。回头看,这套结构治好了第三个——主文件只管「从文档出用例」一件事,四类标准拆进 references;也治了第二个的一半——输出必须体现哪几个字段写死了,长什么样交给模板;唯独第一个治不了,分层分得再清,每条标准仍得是判据。这件事第六章我还会说。
(下面出现的文件片段、目录结构和用例都是示意,用来说明设计,不是某个工具的真实界面;换成你自己业务的时候,判据得你自己定。AI 给你的任何产出,也必须人工抽验过才能进流程。)
STEP 01
什么时候触发:description 里那句话
Skill 的「户口页」就两行,杠杆全在这儿:
---
name: doc-based-testcase-generator
description: 基于需求文档、PRD 或接口文档自动生成结构化测试用例文档。默认采用通用测试用例设计策略(正向、反向、边界值、等价类等);当用户提到参考 Excel/Word 模板时从 assets 加载模板,提到接口/性能/功能等专用标准时从 references 加载对应说明。适用于从各类文档设计功能、接口、性能及自动化候选用例。
---
name 是名字,description 是「什么时候用它」——写窄了永远不被叫醒,写宽了什么破事都来找它。这行 description 干了两件事:一句说「做什么」(从文档生成结构化用例),一句说「什么时候加料」(提模板走 assets、提专用标准走 references)。触发场景还列了四种原话:「请根据下面这份 PRD 生成测试用例」「根据这份接口文档,帮我设计接口测试用例」「从这段需求说明里整理出测试用例」「按你熟悉的写法写一份用例」。
(description 的写法 24 篇专门讲过:同义词要列全,别让用户换了个说法就触发不了。这里不展开,只提醒一句——这四句原话就是它的触发词;你写自己的 Skill 时,先把用户可能说的原话穷举一遍。)
文档进来先过一层预处理:通常是直接粘贴的文本;用户说「这是截图」,它会先请人把图中文字转成文本——不跟图片较劲,因为后面所有步骤都吃文本。然后判断文档类型(业务需求、接口说明、性能指标,或混合型),提取功能模块、关键流程、接口列表(路径、方法、参数、返回、错误码)、约束与边界、性能与安全要求。把「必填可选、取值范围、长度格式、状态流转、权限角色、错误码、性能指标」拉成一张关键约束清单。
这张清单是后面所有用例的地基。漏提取一条约束,七种方法全在地基缺的那一块上白干。
STEP 02
默认策略:七种设计方法,每次必守
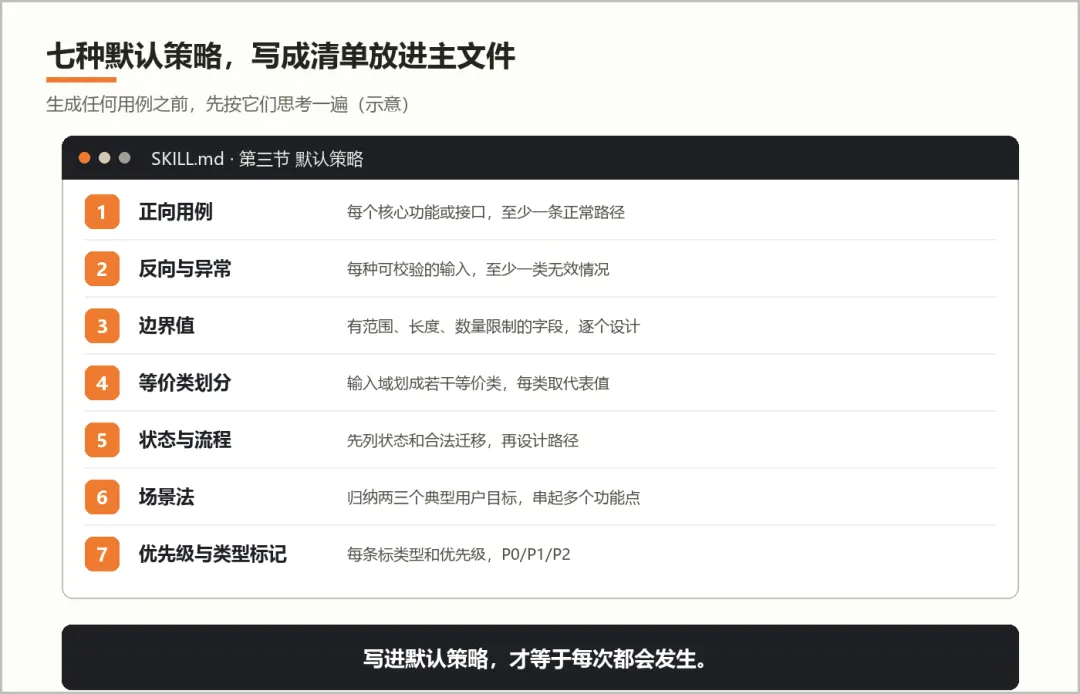
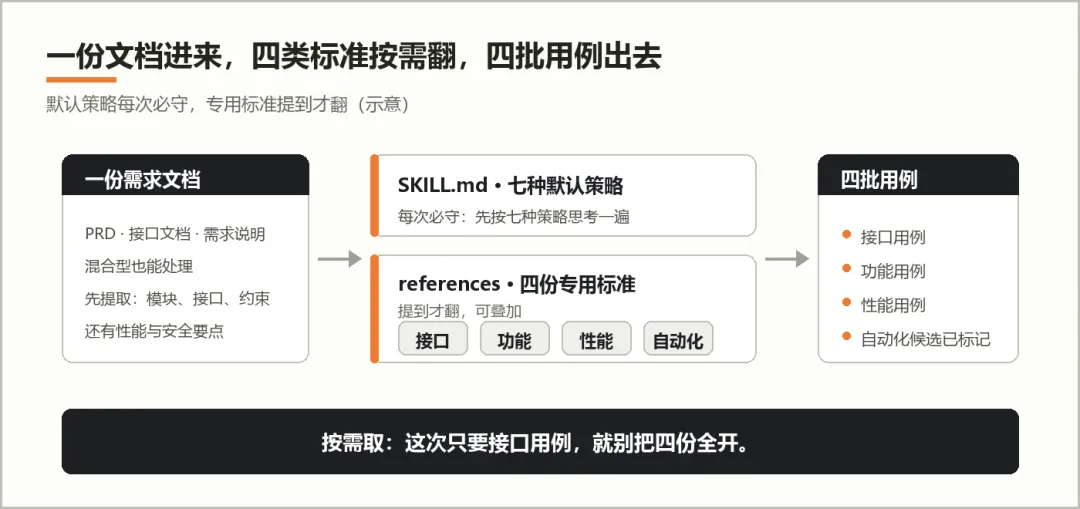
主文件的第三节是整套设计的地基:七种默认策略,生成任何用例之前,先按它们思考一遍。
七条一条不能少——少一条,产出就缺一整类坑。
这里有个几乎所有人生成用例都会撞上的现象:AI 默认只覆盖正向。 你把需求丢过去,回来的十条里八条是正常流程;负向、边界、非功能,你不显式要求,它不会主动写。这不是某个工具的问题,是被反复验证过的默认倾向。25 篇的结论很直接:「六种设计方法里 AI 通常只覆盖正向,其余五种得由人写进规则。」(这份文档列了七种,多出来的是优先级标记。)
这份文档的解法,是把七种方法全部立成默认策略——不是「建议覆盖」,是「生成任何用例前,先按以下策略思考与覆盖」。写进默认策略,才等于每次都会发生。
(刚转行的同学(P1)注意:等价类、边界值、场景法都是标准黑盒设计技术,名字先记住,练手就从自己手头的功能开始。)
STEP 03
四类专用标准:放进 references,按需翻
地基之上,是这份设计最漂亮的一层:「什么叫一条好用例」按测试类型分成四份,放在 references/ 里,提到才翻。
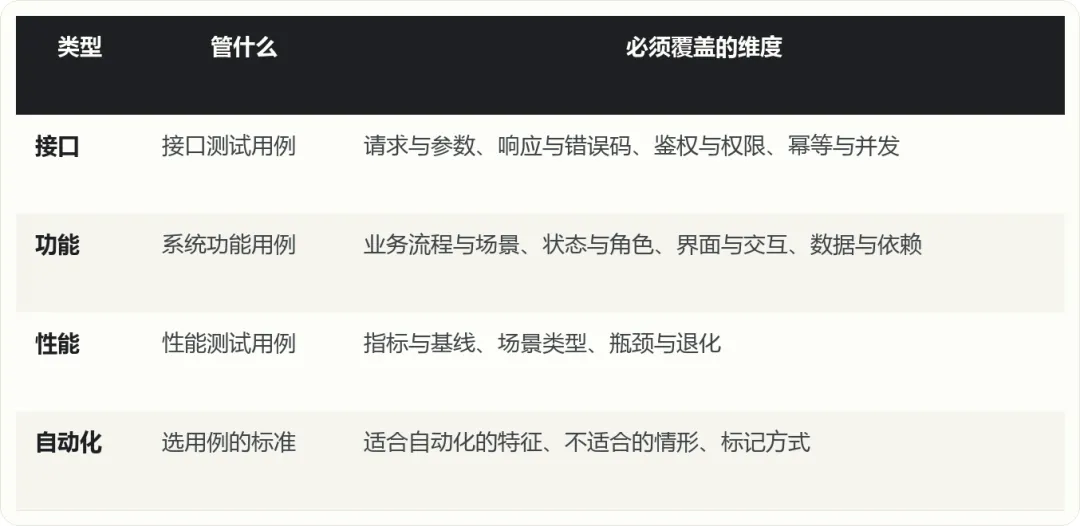
四份标准不是简单并列,末尾都带一节「与通用策略的关系」——互相咬合,而不是各写各的。 比如接口标准里,正向用例对应「正常请求加成功响应」,反向对应「参数校验失败、鉴权失败、错误码覆盖」;自动化标准则明确:在按正向、反向、边界生成用例之后,再对每条做一次「适不适合自动化」的判断并标记。
挑几处表格装不下的硬要求说:
自动化标准的全文就干一件事:从通用用例里筛出适合自动化的,打上标记。
适合的有五条特征:
不适合的有四类:
标记方式也定了:在「类型」或「备注」里标「自动化候选」,能分层再标高、中、低,可选写上建议实现方式、断言要点、数据环境要求。
(做了两三年功能测试的(P2):你们组里那份「评审必挑」的用例规范,其实就是一份没写成文件的功能标准——缺的只是「必须覆盖哪些维度」这一层,补上就能直接当 references 用。)
STEP 04
输出约定:只规定「必须有什么」,不规定「列名叫什么」
接下来这条最反直觉,也是整份文档里我最喜欢的一条:SKILL 本身不规定具体表格列名,也不规定 Markdown 表格样式。
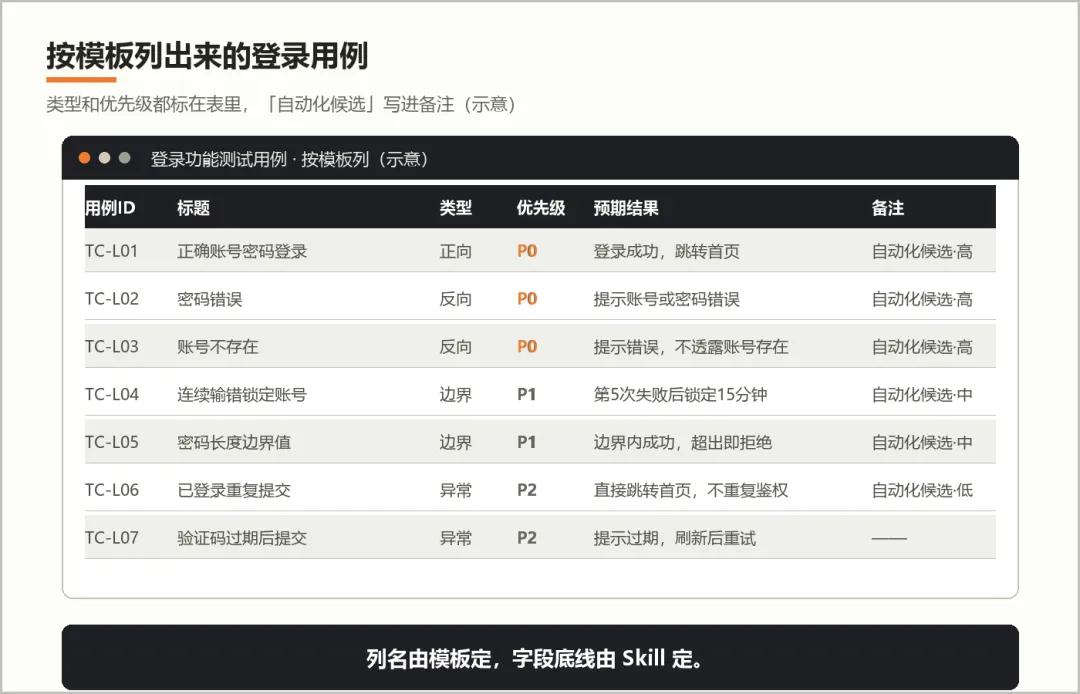
它只规定底线——输出里必须能体现这些:用例标识、标题、所属模块或接口、用例类型、优先级、前置条件、步骤、预期结果,外加可选的数据要求和备注。至于列叫什么名、排什么顺序,以 references 里的标准或 assets 里的模板为准。
用户说「参考某某模板」,它就去 assets/ 里找那个模板,按模板的列组织输出;模板某一列刚好对应某份标准的要求,就同时满足两边。
为什么这么设计?拆开看是两句话:
「列名全部写死,换个模板就得改 Skill」
「只规定必须体现的字段,列名交给模板」
判据写死,偏好留白
「必须有什么」是判据,「长什么样」是偏好。 判据写死,因为它错了会出事——缺了「预期结果」这一列,整份用例就没法验收;偏好留白,因为模板天天换,今天用这份、明天换那份,写死了每换一次改一遍 Skill。
但留白不是没底线:上面那九个字段就是底线,缺一个就不叫结构化用例。反过来说,全写死也不行——那是拿灵活性换稳定性,而模板变的概率比标准变的概率高得多:模板跟着项目和客户走,标准跟着方法论走,后者几年才动一次。
STEP 05
跑一遍:从登录文档到用例表
五步工作流,文档里写得很直白:
拿登录功能走一遍(文档自带的例子)。一份登录 PRD 粘进去,它识别出这是「业务需求加接口说明」的混合型,按七种默认策略生成思路;你补一句「接口部分按接口标准来」,它加载接口标准,补齐错误码和鉴权用例;你说「按模板出」,它从 assets 找到模板,按列组织。最后自检六问过一遍,想要 Excel,就跑 scripts/ 里的导出脚本。
自检六问也给你,输出前逐条过:
使唤它的话术可以照这个套路说(这是讲法模板,括号里的内容换成你自己的文档和场景):
「根据下面这份 PRD 生成测试用例,默认用全量设计策略;接口部分按接口标准补错误码和鉴权用例;通过标准的用例标上『自动化候选』;按我给的模板列输出。」
还有一条落盘规矩值得学:默认不主动写盘。 生成的东西直接输出在对话里,你说「存到某某路径」它才写;只说了目录没说文件名,就用「测试用例加模块名加日期」兜底。不过度动作,这点很多工具反过来。
STEP 06
边界:分层不是万能
最后说三句扫兴的话,不然容易用力过猛。
第一,references 不是越多越好。 四份标准之间有重叠——功能和接口都涉及状态流转——它可能翻出四套说法来。这份文档每份标准末尾的「与通用策略的关系」,就是为了防这个。标准之间要互相引用,不能各写各的。
第二,「一次出齐」不等于「一次出对」。 四类标准叠加,产出的长度和噪声同步叠加。按需取——这次只要接口用例,就别把四份全开。全开不是严谨,是浪费。
「把四类标准全写进一个文件,这样最全。」 真这么做,就回到了 26 篇的第三个卡点。
第三,分层治不了「判据是形容词」。 标准分得再清,每条仍要能判对错;26 篇那三个卡点,一分层不治,该缺的判据还是缺。结构是骨架,判据是肉,两回事。
顺带说个联动:面试被问「哪些用例值得自动化」,刷题合集里有一篇专门讲这道题。这里把自动化标准里的判断依据拆成一张表,建议存下来——
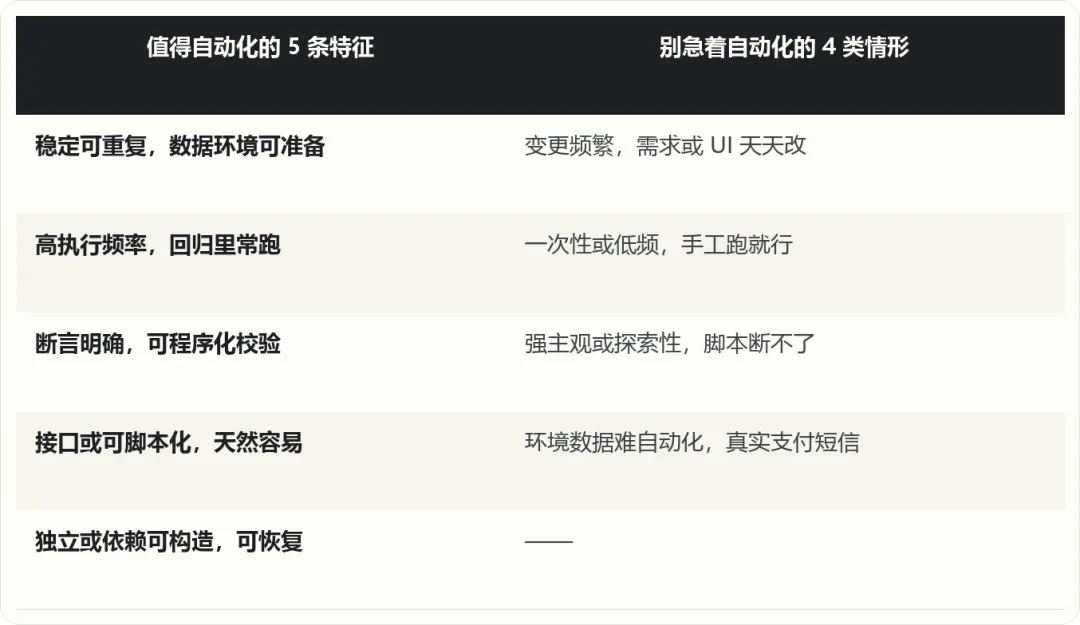
(准备跳槽的同学(P3)注意:面试答「哪些用例值得自动化」,别背概念,拿这张表对着说——频率、稳定性、断言、环境、依赖,五条各举一个你项目里的真例子,比任何定义都管用。)
把今天这些收成一句:任务要单一,标准可以分层;判据写进默认策略,偏好留给模板。
来源说明:本篇改编自《doc-based-testcase-generator》Skill 设计文档,改编已获授权;文中目录结构、文件片段与用例均为示意,AI 产出须经人工验证后才能进流程。
我是阿蔡