夜雨聆风学习资料网

ARTICLE · 1200127

药物经济学|不使用VBA在Excel中进行单因素敏感性分析(OWSA)
药物经济学|不使用VBA在Excel中进行单因素敏感性分析(OWSA)
背景
单因素敏感性分析(One-Way Sensitivity Analysis,OWSA)是药物/卫生经济学成本效果模型中常用的敏感性分析方法,通过在合理的取值范围内逐一改变模型参数,评估参数不确定性对模型结果的影响。在大多数基于Excel搭建的卫生经济学模型中使用VBA宏实现OWSA,即将某一模型参数基础值依次替换为下限和上限值,每次重新计算模型并记录结果,随后恢复参数的基础值。通过在Excel VBA宏中将上述操作编写为循环程序,即可完成多个参数的OWSA。
然而,使用VBA宏开展OWSA存在一定局限性。除了常见兼容性问题外,随着模型复杂度和参数数量的增加,宏代码的编写、调试与维护难度随之提高,增加了潜在的编码错误(Baio & Heath, 2016)。此外,频繁的VBA与工作表交互,以及代码中不必要的模型重算逻辑都可能显著延长OWSA的运行时间(Medland et al., 2023)。
本推送用于记录两种无需VBA、分别基于Excel What-If Analysis和动态数组函数(Dynamic Array Functions)实现批量OWSA的方法。第一种方法利用Scenario ID将不同参数的上下限取值映射为独立的分析情景,通过What-If/Data Table批量计算模型结果,再使用动态数组函数自动整理和排序。第二种方法则通过LAMBDA()将模型的计算过程封装为可重复调用的函数,结合MAP()等动态数组函数直接完成各参数上下限情景的模型计算、结果整理及排序。最后生成飓风图(Tornado Diagram),用于展示不同参数对成本效果分析结果的影响。
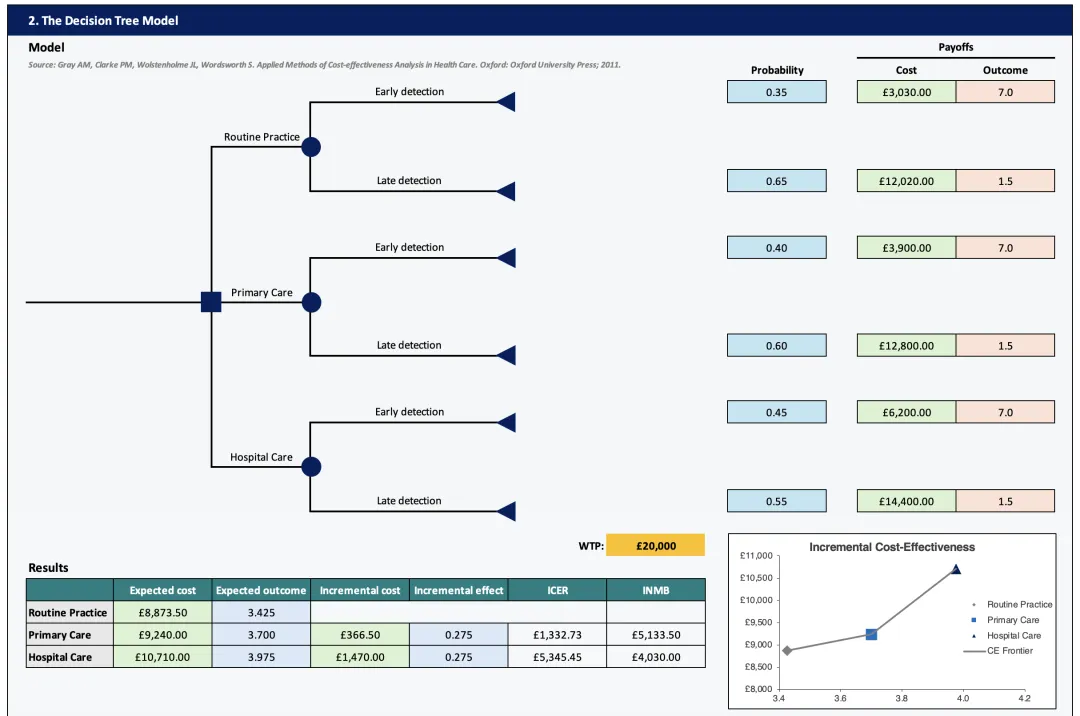
本推送将以一个决策树成本效果模型作为演示案例。模型取自 《Applied Methods of Cost-effectiveness Analysis in Health Care》第8章:Decision analytic modelling: decision trees中的练习案例,该模型分析三种策略:Routine Practice(常规实践)、Primary Care(初级医疗)和 Hospital Care(医院医疗)。模型计算各策略的期望成本和期望健康产出,并开展增量成本效果分析。本推送中额外在原模型基础上为各参数设置基础值±10%的区间,同时设定£20,000/QALY的支付意愿阈值(Willingness-to-Pay Threshold,WTP),用于计算净货币收益(Net Monetary Benefit,NMB)及展示 OWSA 结果。
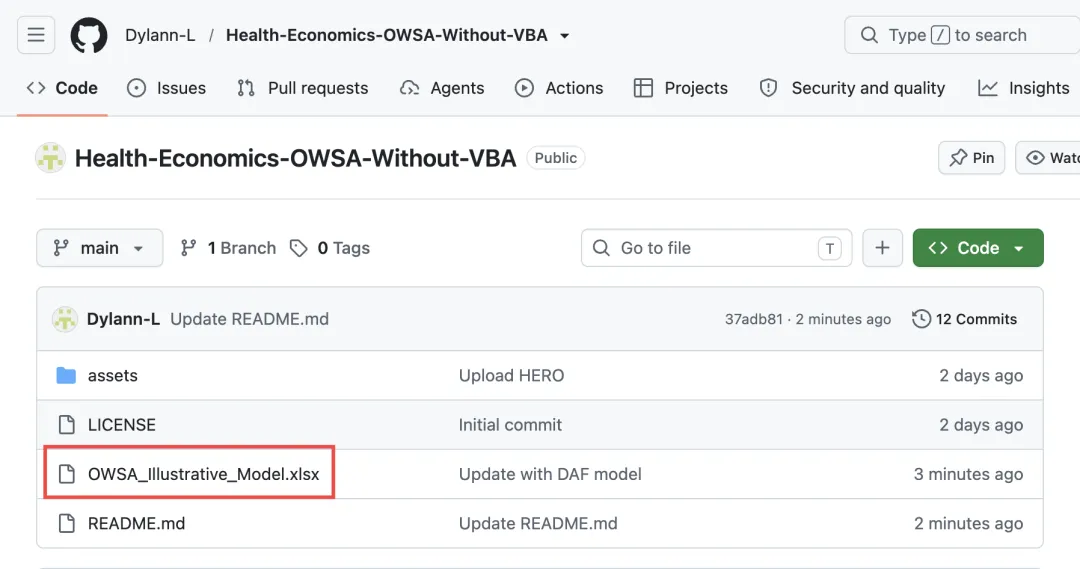
本推送使用的Excel模型已上传至GitHub,可通过点击文章底部“阅读原文”访问,点击模型文件OWSA_Illustrative_Model.xlsx,再点击右侧的下载图标。(访问可能需要网络设置);也可以在公众号后台回复“OWSA”自动获取下载链接。
一、使用What-If分析功能实现OWSA
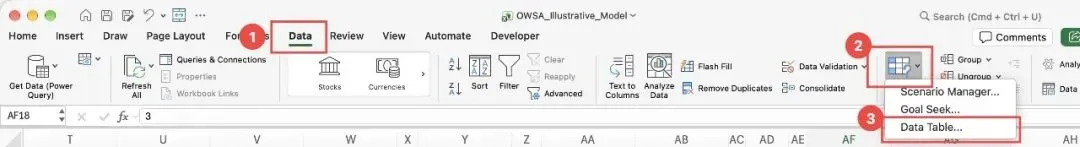
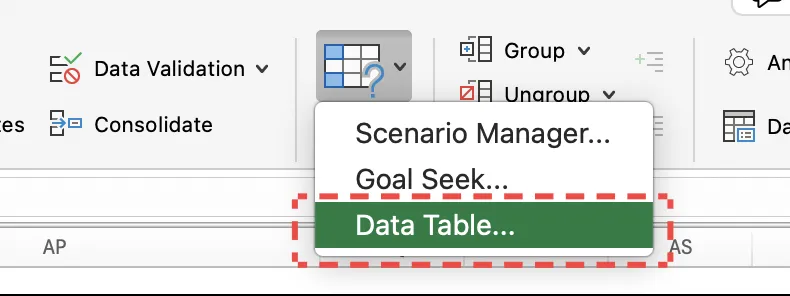
Excel内置的What-If Analysis(模拟分析)是一种通过改变输入单元格的数值,观察其对公式计算结果影响的分析工具。其中,Data Table(模拟运算表)功能可自动将一组预设数值依次代入指定单元格,并记录相应的计算结果。What-If分析功能支持Windows和Mac版Excel,并支持近代大多数Excel版本。在Excel 365版本的路径为:数据(Data)> 模拟分析(What-If Analysis)> 模拟运算表(Data Table)
该方法常用于金融模型的敏感性分析,例如计算不同利率或贷款期限所对应的还款。此外,在2022年的Vital卫生经济学建模Workshop中,也有对如何使用What-If分析在卫生经济学模型中运行OWSA的说明 (https://vchem-vital-workshop-2022.netlify.app/case-studies/cs_one-way-sensitivity) ,然而该Workshop中给出的方法仅能对单个参数进行上下限的替换,需对每组参数分别建立计算表并手动整理到结果表中,然而卫生经济学模型的OWSA通常需要对多个不同参数依次进行上下限替换,并对结果影响的大小程度进行排序,导致该方法的使用存在一定限制。
步骤一:参数表与模型
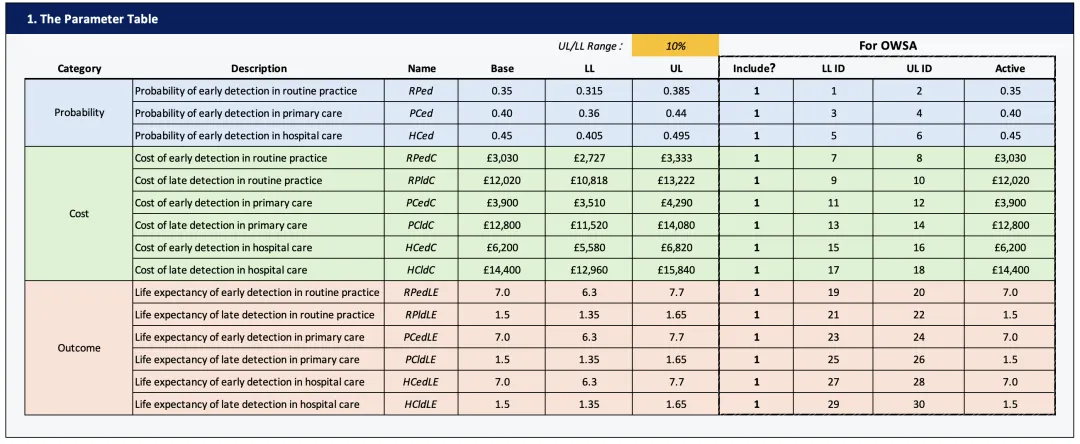
根据教材中的决策问题,复现了决策树模型,包括参数表及模型两部分:
在示例文件的 1. The Parameter Table 部分,参数被分为了概率(Probability)、成本(Cost)、产出(Outcome)三类。与常规模型参数表相同,每个参数记录的信息包括:Description(参数描述);Name(参数名);Base(基础值);LL(Lower Limits,低值);UL(Upper Limits,高值)。
此外,参数表中还包括四列辅助列:
  • Include?:取值1/0,输入1表示将该参数纳入OWSA,0则表示不纳入;
  • LL ID/UL ID:根据Include?的取值,为每个纳入OWSA的参数自动分配唯一的Scenario ID,分别对应下限和上限;下限使用奇数编号,上限使用偶数编号;每个参数的上限ID等于下限ID+1。例如,第一个参数的 LL ID 和 UL ID分别为1和2,第二个参数分别为3和4,以此类推。由以下函数实现:
(K21,下限) =IF(J21=1,COUNTIF($J$21:J21,1)*2-1,"")
(L21,上限) =IF(J21=1,COUNTIF($J$21:J21,1)*2,"")
  • Active:模型实际调用的参数值,命名对应Name列。根据当前ID,自动选择对应参数的LL、UL或Base。由以下函数实现:
(M21)=IF(ID=K21,H21,IF(ID=L21,I21,G21))
其中,ID用于控制参数取值的Scenario ID(情景编号),对应模型中用于What-If Analysis的输入单元格(AG11)。
Active 列通过IF函数判断当前ID(AG11)是否匹配该参数的LL ID或UL ID:
  • 当ID等于LL ID时,Active列代入该参数的下限取值(LL),模型计算结果为该参数取LL时的结果;
  • 当ID等于UL ID时,Active列代入该参数的上限取值(UL),模型计算结果为该参数取UL时的结果;
  • 当ID不等于LL ID或UL ID时,Active列保持该参数的基础值(Base)。
例如,当ID=3时,第二个参数的Active返回下限,其余参数均保持基础值;当ID=4时,第二个参数切换为上限。由此,每个Scenario ID对应一个独立的参数变化情景,且每次只有一个参数偏离基础值。
在示例文件的 2. The Decision Tree Model 部分复现了教材中的示例决策模型。概率、成本及产出参数引用参数表的Active列,由此使Data Table改变ID即可实现所有参数上下限情景的模型计算,并记录相应结果。
步骤二:运行What-If Analysis
完成参数表及模型设置后,接下来使用Excel的Data Table功能批量计算不同Scenario ID对应的模型结果。
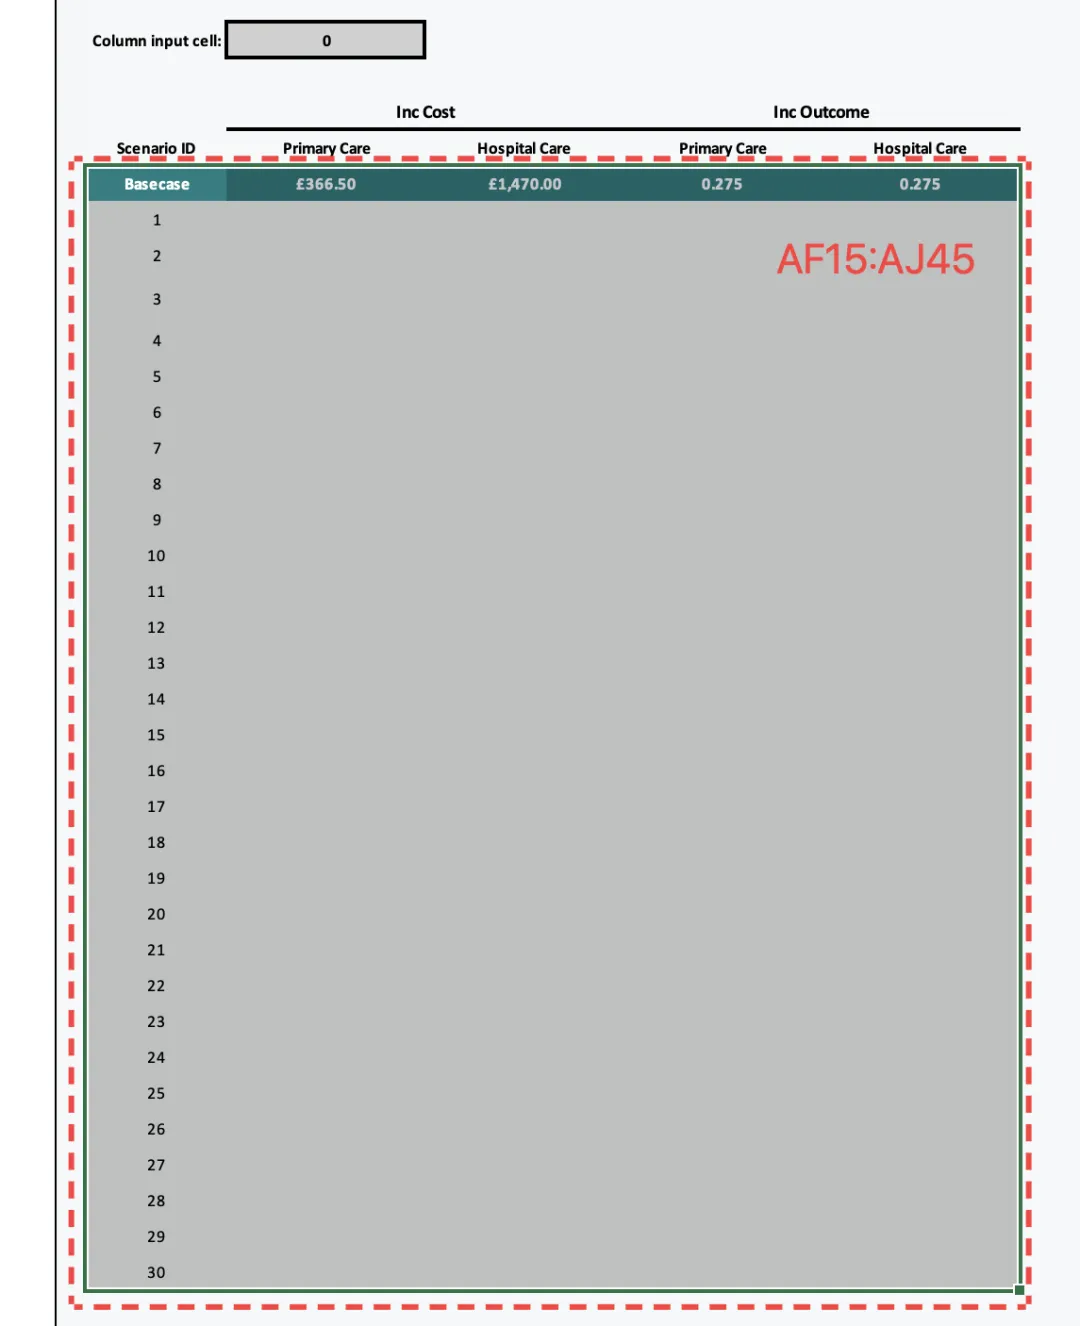
示例文件的 3. The Sensitivity Analysis | OWSA 部分包含以下内容:
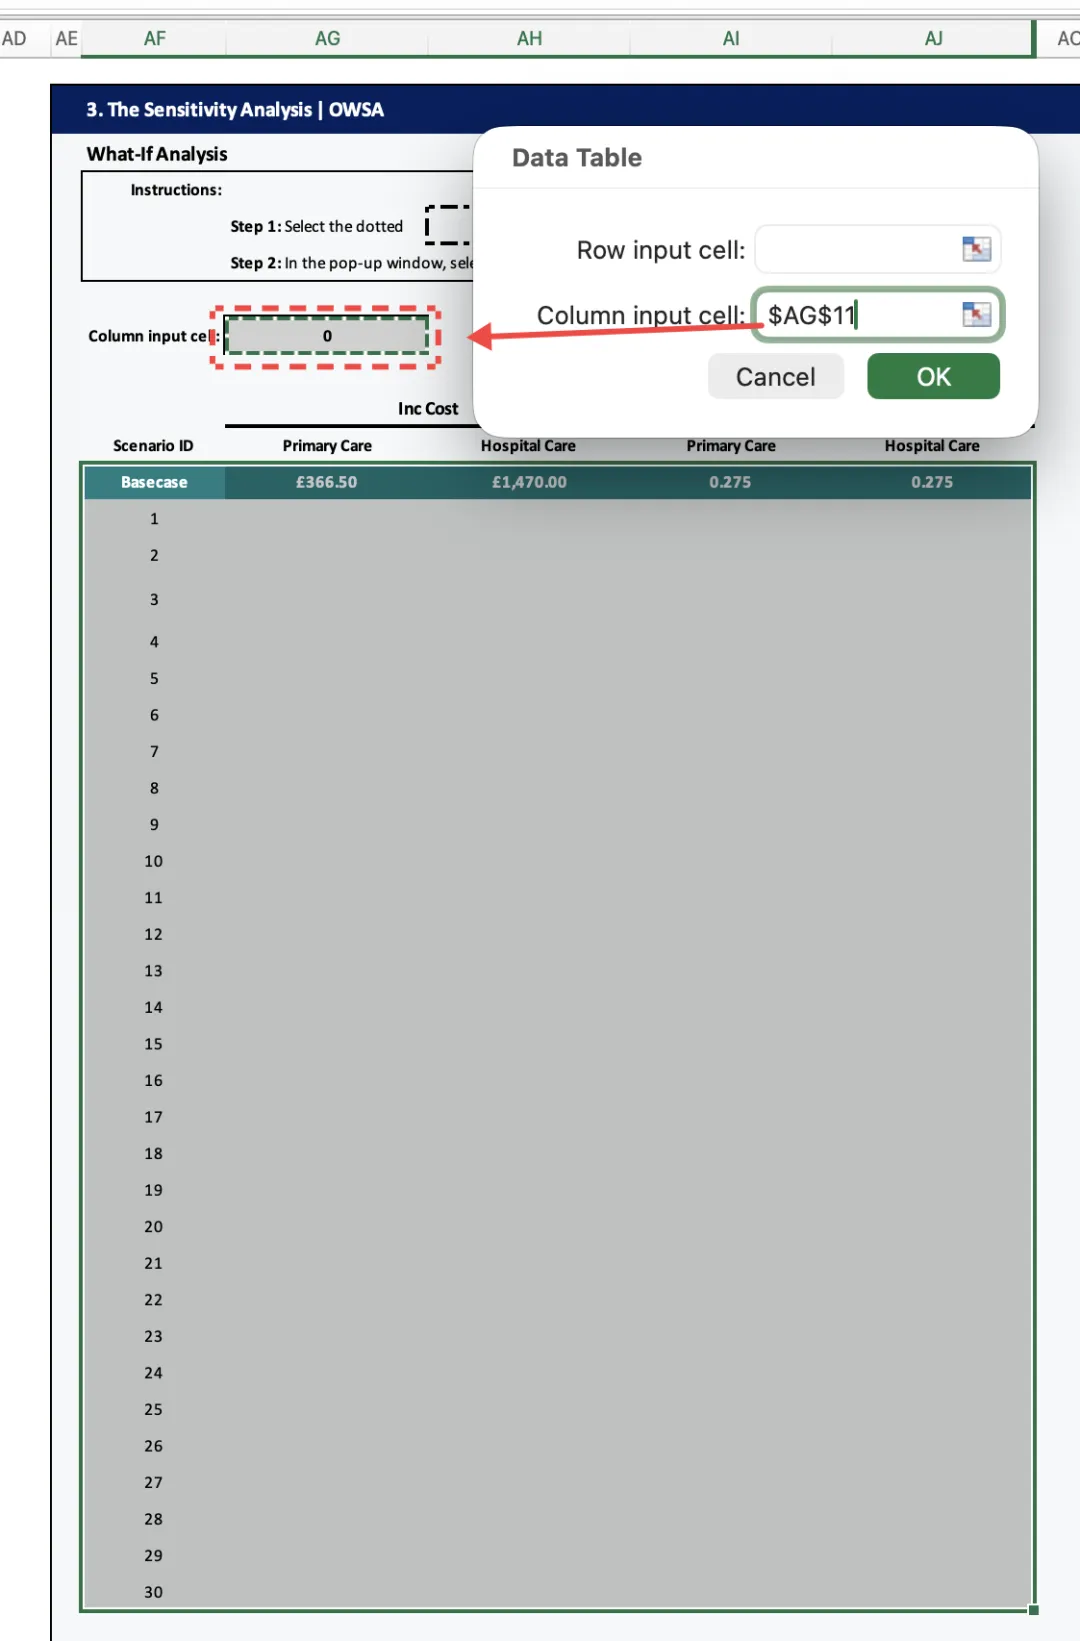
Scenario ID控制单元格(AG11):作为What-If Analysis的Column input cell,用于接收各参数的Scenario ID,并控制模型中各参数的取值。
虚线框中的计算区域(AF15:AJ45):
  • 基础结果行(Basecase):引用基础情景下的模型计算结果,包括两组策略比较的增量成本及增量产出,同时作为 Data Table 的输出公式。当ID=0时,所有参数采用基础值;
  • Scenario ID(AF 列):依次列出所有分析情景的编号。What-If Analysis 将这些编号逐一代入 ID 控制单元格(AG11)。
  • Incremental Cost(AG、AH 列)与 Incremental Outcome(AI、AJ 列):分别记录各情景下两组策略比较的增量成本和增量产出,用于后续计算 ICER 和 INMB。
执行以下步骤:
  1. 选中整个计算区域:AF15:AJ45;
2. 点击 Data > What-If Analysis > Data Table;
3. 在弹出的窗口中,保持Row input cell为空,将Column input cell设置为AG11,即Scenario ID的控制单元格。
4. 点击 OK。
Excel会自动依次将AF列中的Scenario ID代入AG11,并根据Active列的公式替换相应参数。每次替换后,模型重新计算,Data Table将对应的增量成本和增量产出记录在AG:AJ列。计算完成后,即可获得所有纳入OWSA的参数在上下限取值下的模型结果。
当需要将某参数排除OWSA计算时,只需将参数表中Include?列的取值从1改为0,LL ID和UL ID将自动重新编号。随后手动相应调整AF列的Scenario ID范围,也可以使用Excel的SEQUENCE()函数,根据LL ID和UL ID的最大编号自动生成连续的Scenario ID:
=SEQUENCE(MAX(K21:L35))
(注意:SEQUENCE()仅适用于Excel 2021后续版本。此外,SEQUENCE()只能自动更新情景编号,Data Table 的计算区域仍需根据实际情景数量进行调整)
至此,已经使用What-If Analysis/Data Table计算了所有纳入OWSA的参数在上下限取值下的增量成本和增量产出。接下来,需要将这些计算结果进行整理,计算相应的ICER和INMB,并按照参数对模型结果的影响程度进行排序。
步骤三:结果整理&排序
使用Excel动态数组函数,将参数匹配、结果计算、筛选及排序整合在一个公式中,实现OWSA结果的自动整理。
在示例文件的 4. OWSA Results | Sort 部分,分别针对两组策略设置结果整理动态数组函数。以Primary Care vs Routine Practice为例:
# 注意:Excel公式不支持直接使用注释,复制到Excel前需删除注释。=LET(    name,$F$21:$F$35,         # 参数名称    desc,$E$21:$E$35,         # 参数描述    idLL,$K$21:$K$35,         # 下限Scenario ID    idUL,$L$21:$L$35,         # 上限Scenario ID    scenario,$AF$16:$AF$45,   # Scenario ID    dc,$AG$16:$AG$45,         # 增量成本    de,$AI$16:$AI$45,         # 增量产出    wtp,$W$28,                # 支付意愿阈值    label,desc&" ("&TEXT($H$21:$H$35,"#,##0.###")&", "&TEXT($I$21:$I$35,"#,##0.###")&")", # 生成参数描述及上下限标签    icer,IFERROR(dc/de,NA()),        # 计算各情景的ICER    inmb,wtp*de-dc,                  # 计算各情景的INMB    llI,XLOOKUP(idLL,scenario,icer), # 匹配下限情景的ICER    ulI,XLOOKUP(idUL,scenario,icer), # 匹配上限情景的ICER    llN,XLOOKUP(idLL,scenario,inmb), # 匹配下限情景的INMB    ulN,XLOOKUP(idUL,scenario,inmb), # 匹配上限情景的INMB    data,HSTACK(label,llI,ulI,ABS(ulI-llI),llN,ulN,ABS(ulN-llN)), # 合并结果并计算上下限绝对差值    result,FILTER(data,($J$21:$J$35=1)*(LEFT(name,2)<>"HC")),         # 筛选纳入 OWSA 且属于当前策略比较的参数    SORTBY(result,CHOOSECOLS(result,7),-1)                            # 按 INMB 上下限绝对差值降序排序)
对于第二组策略比较 Hospital Care vs Primary Care,采用相同的计算方法,仅需调整增量成本、增量产出的引用区域及参数筛选条件。
通过上述函数,当Data Table的计算结果更新后,各参数的上下限结果匹配、ICER/INMB计算及排序均可自动更新,无需手动整理,为下一步绘制龙卷风图提供数据。

步骤四:可视化

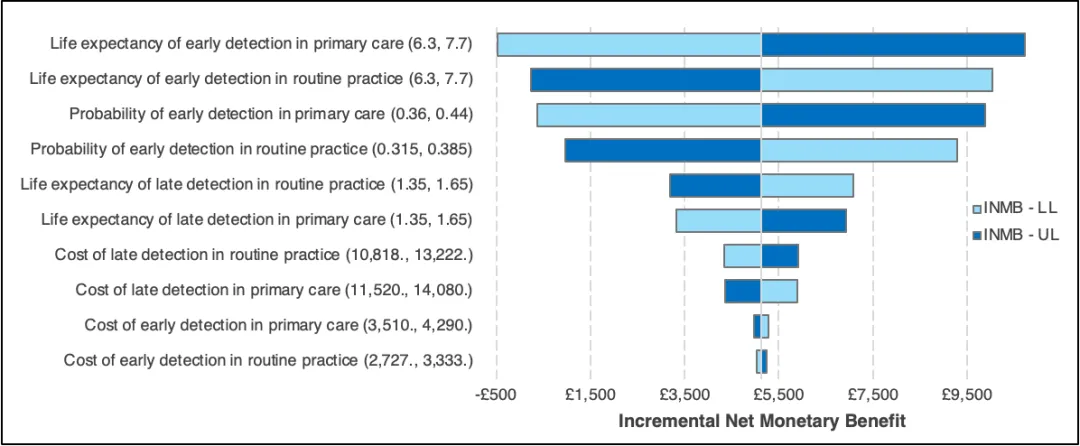
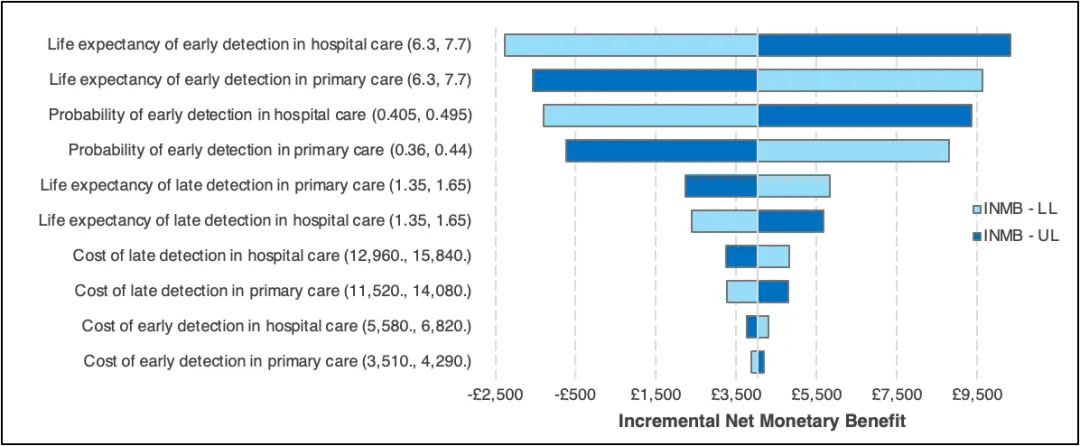
完成OWSA结果整理后,使用Excel图表功能,分别针对Primary Care vs Routine Practice和Hospital Care vs Primary Care的INMB绘制龙卷风图(Tornado Diagram),以直观展示不同参数对成本效果分析结果的影响。
二、使用动态数组函数实现OWSA
近年来,Excel引入了LET()、LAMBDA()、MAP()、HSTACK() 和 VSTACK() 等动态数组及相关函数,使用户能够在单元格中定义复杂的计算逻辑、批量处理数据,并将计算结果自动扩展至多个单元格,而无需依赖VBA。Paulden(2026)在PharmacoEconomics发表的《A Modern Approach for Constructing Decision Analytic Models in Microsoft Excel》中,系统介绍了如何利用现代Excel动态数组函数构建卫生经济学决策模型;此外,Blissett等(2025)在《Patient-Level Health Economic Modeling in Excel Without VBA: A Tutorial》中,也展示了使用LAMBDA()、REDUCE() 等函数,在不使用VBA的情况下构建患者水平离散事件模拟模型(DES)的完整方法。具体可见本账号其他推送:
药物经济学|不使用VBA的现代Excel建模方法(一)
药物经济学|不使用VBA的现代Excel建模方法(二)
基于上述思路,如果将原有卫生经济学模型的计算过程封装为可调用的函数,则可以直接利用动态数组函数实现批量OWSA,无需通过What-If Analysis逐一替换工作表中的参数。
与What-If Analysis方法相比,动态数组函数方法能够在参数发生变化时自动完成重新计算,且无需调整Data Table的计算区域。不过,此方法需要将原始模型重新封装为函数,因此更适用于结构相对简单、能够方便地进行函数化表达的卫生经济学模型。

本方法参数表沿用模型的 1. The Parameter Table,包括各参数的 Description、Name、Base、LL、UL 和 Include?。其中,Base、LL 和 UL分别表示参数的基础值、下限和上限,Include?用于控制是否将对应参数纳入 OWSA。该方法无需通过Scenario ID控制参数替换,因此不需要使用LL ID、UL ID 和 Active列。

步骤一:将决策树模型封装为函数

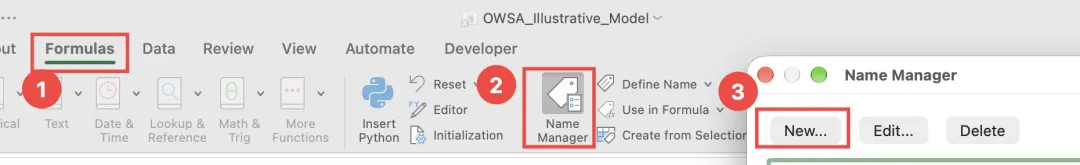
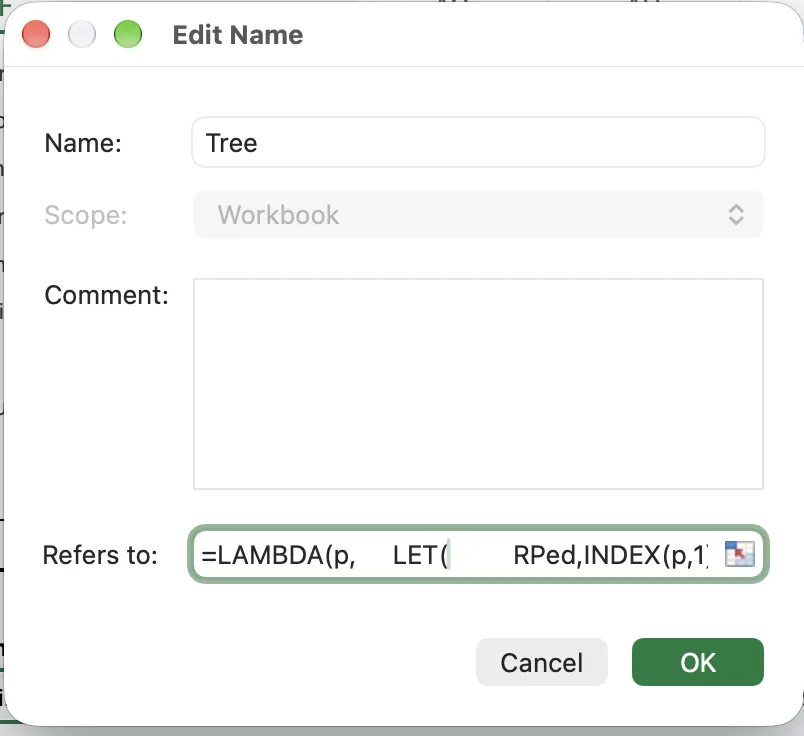
首先,使用LAMBDA()函数将决策树模型封装为一个可重复调用的函数,使其能够直接接收参数数组并返回模型结果。在Excel中选择 Formulas > Name Manager > New,将 Name 设置为 “Tree”,Scope 选择 “Workbook”,并在 Refers to 中输入以下公式 :
=LAMBDA(p,    LET(        RPed,INDEX(p,1),        PCed,INDEX(p,2),        HCed,INDEX(p,3),        RPedC,INDEX(p,4),        RPldC,INDEX(p,5),        PCedC,INDEX(p,6),        PCldC,INDEX(p,7),        HCedC,INDEX(p,8),        HCldC,INDEX(p,9),        RPedLE,INDEX(p,10),        RPldLE,INDEX(p,11),        PCedLE,INDEX(p,12),        PCldLE,INDEX(p,13),        HCedLE,INDEX(p,14),        HCldLE,INDEX(p,15),        rpCost,RPed*RPedC+(1-RPed)*RPldC,        pcCost,PCed*PCedC+(1-PCed)*PCldC,        hcCost,HCed*HCedC+(1-HCed)*HCldC,        rpEffect,RPed*RPedLE+(1-RPed)*RPldLE,        pcEffect,PCed*PCedLE+(1-PCed)*PCldLE,        hcEffect,HCed*HCedLE+(1-HCed)*HCldLE,        dcPC,pcCost-rpCost,        dcHC,hcCost-pcCost,        dePC,pcEffect-rpEffect,        deHC,hcEffect-pcEffect,        icerPC,IFERROR(dcPC/dePC,NA()),        icerHC,IFERROR(dcHC/deHC,NA()),        inmbPC,dePC*DSA_DAF!$W$28-dcPC,        inmbHC,deHC*DSA_DAF!$W$28-dcHC,        VSTACK(            HSTACK(rpCost,rpEffect,0,0,0,0),            HSTACK(pcCost,pcEffect,dcPC,dePC,icerPC,inmbPC),            HSTACK(hcCost,hcEffect,dcHC,deHC,icerHC,inmbHC)        )    ))
函数中的 “p” 表示传入的模型参数数组(parameters),“Tree()” 根据以上数组完成模型计算,并返回3行*6列的结果,分别对应三种策略的期望成本、期望产出、增量成本、增量产出、ICER 和 INMB。通过定义函数,决策树的计算逻辑只需单次定义,后续可以向 Tree(p) 传入不同的参数数组,直接计算相应情景下的结果。
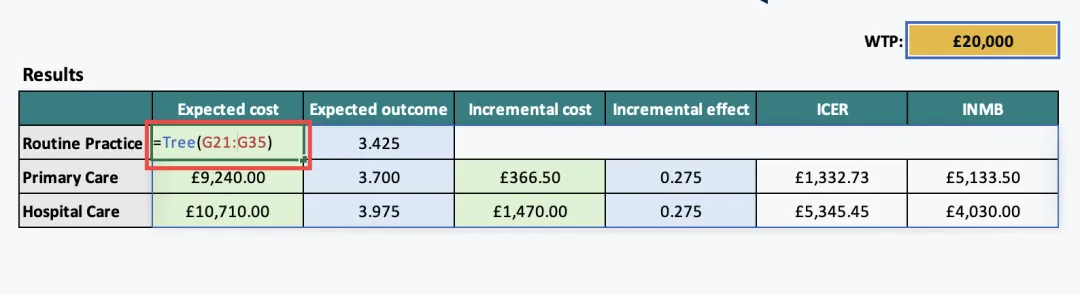
基础分析模型在第二部分 2. The Decision Tree Model 的(左上角单元格R31)输入:
=Tree()
G21:G35为15个参数的基础值,对应的模型结果将溢出至R31:W33,可见返回的结果与原模型的Result表一致。(注意溢出的目标单元格中需要为空&不含有合并单元格)。

步骤二:使用动态数组函数实现OWSA

完成模型的函数封装后,使用动态数组函数直接调用 Tree(),批量计算各参数上下限对应的ICER和INMB,并自动完成结果筛选与排序。
在示例文件的 3. OWSA Results 部分,对两组策略分别设置两个动态数组公式:

Primary Care vs Routine Practice

在AF10输入以下公式(复制时删去注释):

=LET(    names,F$21:F35,                 # 参数名称    desc,E21:E35,                   # 参数描述    base,G21:G35,                   # 参数基础值    low,H21:H35,                    # 参数下限    high,I21:I35,                   # 参数上限    inc,J21:J$35,                   # 是否纳入 OWSA    idx,SEQUENCE(ROWS(base)),       # 生成连续参数编号    label,desc&" ("&TEXT(low,"#,##0.###")&", "&TEXT(high,"#,##0.###")&")", # 生成包含上下限的参数标签    llI,MAP(idx,LAMBDA(i,           # 逐一替换参数为下限,计算 ICER        INDEX(Tree(IF(idx=i,INDEX(low,i),base)),2,5)    )),    ulI,MAP(idx,LAMBDA(i,           # 逐一替换参数为上限,计算 ICER        INDEX(Tree(IF(idx=i,INDEX(high,i),base)),2,5)    )),    llN,MAP(idx,LAMBDA(i,           # 逐一替换参数为下限,计算 INMB        INDEX(Tree(IF(idx=i,INDEX(low,i),base)),2,6)    )),    ulN,MAP(idx,LAMBDA(i,           # 逐一替换参数为上限,计算 INMB        INDEX(Tree(IF(idx=i,INDEX(high,i),base)),2,6)    )),    data,HSTACK(                    # 合并 ICER、INMB 及其上下限绝对差值        label,llI,ulI,ABS(ulI-llI),        llN,ulN,ABS(ulN-llN)    ),    result,FILTER(data,(inc=1)*(LEFT(names,2)<>"HC")), # 筛选纳入 OWSA 的参数,排除 HC 专属参数    SORTBY(result,CHOOSECOLS(result,7),-1) # 按 INMB 上下限绝对差值降序排序)

上述公式首先使用 SEQUENCE() 和 ROWS() 根据参数数量自动生成连续编号,随后通过 MAP() 和 LAMBDA() 依次遍历各参数,将当前参数替换为下限或上限,其余参数保持基础值,并将替换后的参数数组传入 Tree() 函数,重新计算对应情景下的决策树模型结果。通过 INDEX() 提取各情景的 ICER 和 INMB,即可完成所有参数的上下限分析。最后,使用 HSTACK() 合并参数名称及计算结果,通过 FILTER() 筛选纳入 OWSA 的参数,再使用 SORTBY() 按照上下限 INMB 的绝对差值降序排列,自动生成 OWSA 结果表。当参数基础值、上下限或纳入范围发生变化时,公式将自动重新计算并更新排序结果。

公式返回7列结果,与原模型的OWSA Results表保持一致:
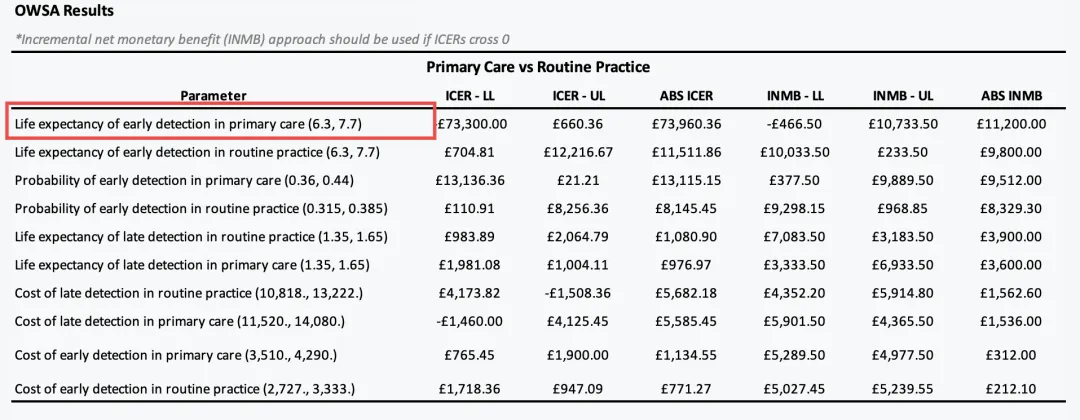
Hospital Care vs Primary Care

与上一组类似,在AF36输入以下公式:

=LET(    names,$F$21:$F$35,    desc,$E$21:$E$35,    base,$G$21:$G$35,    low,$H$21:$H$35,    high,$I$21:$I$35,    inc,$J$21:$J$35,    idx,SEQUENCE(ROWS(base)),    label,desc&" ("&TEXT(low,"#,##0.###")&", "&TEXT(high,"#,##0.###")&")",    llI,MAP(idx,LAMBDA(i,        INDEX(Tree(IF(idx=i,INDEX(low,i),base)),3,5)    )),    ulI,MAP(idx,LAMBDA(i,        INDEX(Tree(IF(idx=i,INDEX(high,i),base)),3,5)    )),    llN,MAP(idx,LAMBDA(i,        INDEX(Tree(IF(idx=i,INDEX(low,i),base)),3,6)    )),    ulN,MAP(idx,LAMBDA(i,        INDEX(Tree(IF(idx=i,INDEX(high,i),base)),3,6)    )),    data,HSTACK(        label,llI,ulI,ABS(ulI-llI),        llN,ulN,ABS(ulN-llN)    ),    result,FILTER(data,(inc=1)*(LEFT(names,2)<>"RP")),    SORTBY(result,CHOOSECOLS(result,7),-1))
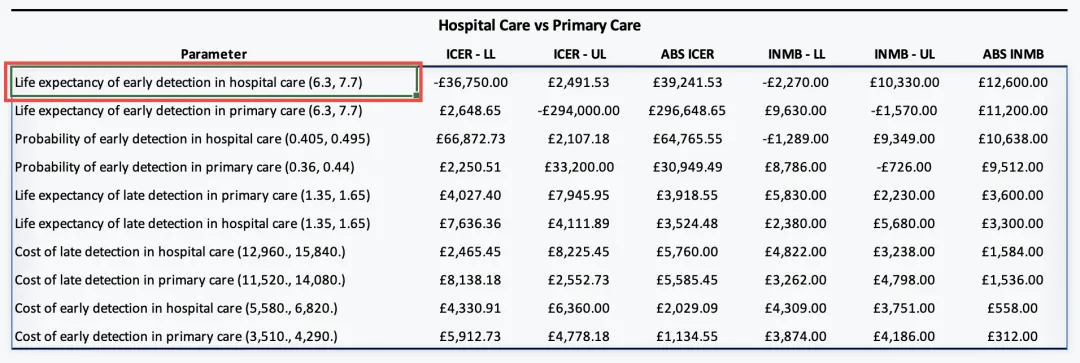
步骤四:结果可视化
完成OWSA计算后,使用Excel图表功能,针对Primary Care vs Routine Practice和Hospital Care vs Primary Care分别绘制龙卷风图(Tornado Diagram)。
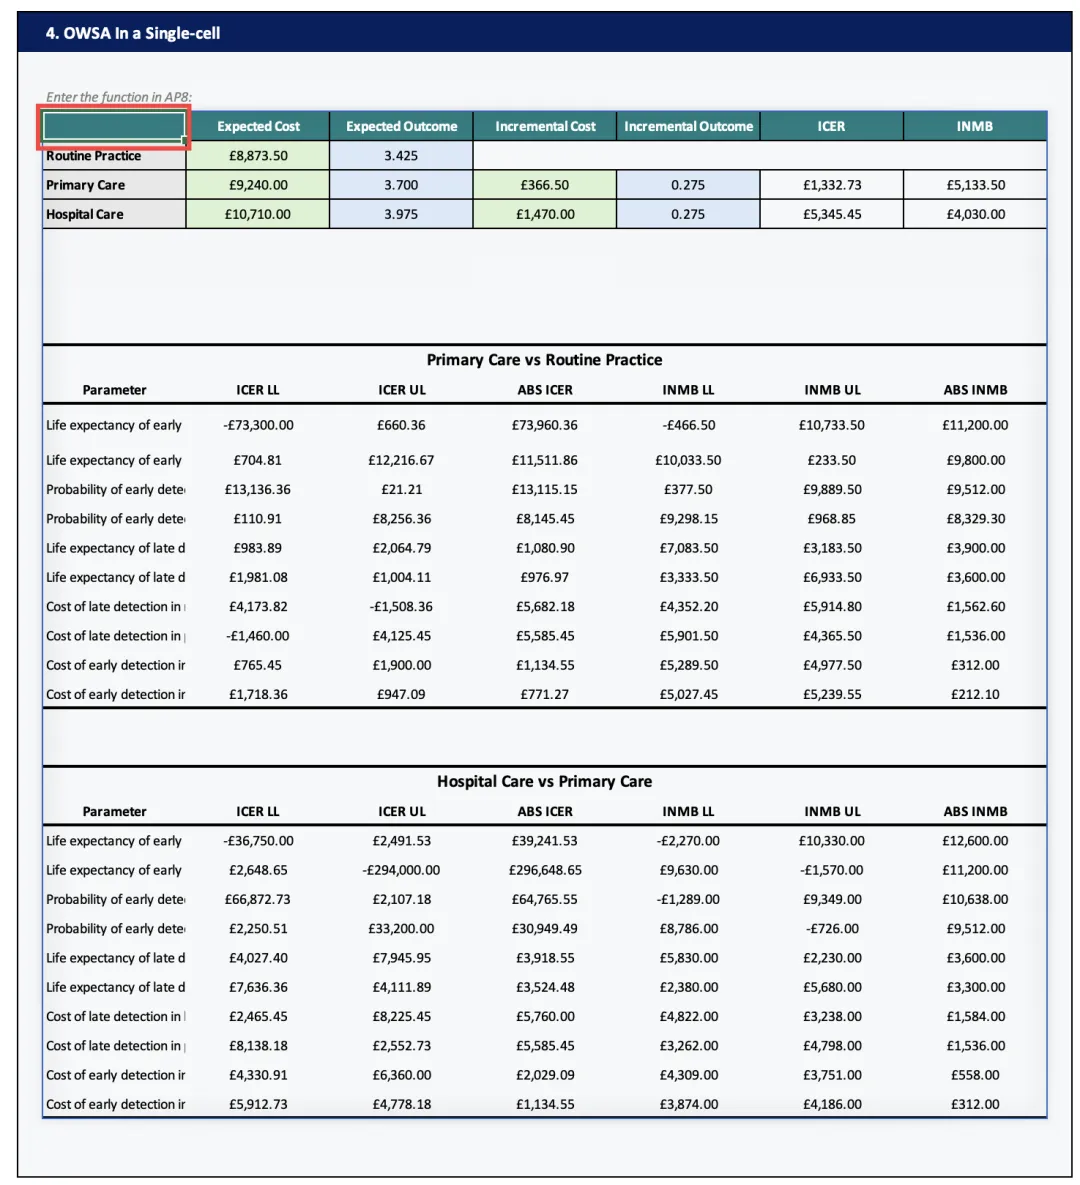
此外,还可以进一步将决策树模型计算、参数上下限替换及OWSA结果排序整合至单个动态数组公式,将整个模型及OWSA流程放在单个单元格中。在任意单元格输入以下函数:
=LET(    names,$F$21:$F$35,    desc,$E$21:$E$35,    base,$G$21:$G$35,    low,$H$21:$H$35,    high,$I$21:$I$35,    inc,$J$21:$J$35,    idx,SEQUENCE(ROWS(base)),    OWSA,LAMBDA(rowNum,exclude,        LET(            label,desc&" ("&                TEXT(low,"#,##0.###")&", "&                TEXT(high,"#,##0.###")&")",            llI,MAP(idx,LAMBDA(i,                INDEX(Tree(IF(idx=i,INDEX(low,i),base)),rowNum,5)            )),            ulI,MAP(idx,LAMBDA(i,                INDEX(Tree(IF(idx=i,INDEX(high,i),base)),rowNum,5)            )),            llN,MAP(idx,LAMBDA(i,                INDEX(Tree(IF(idx=i,INDEX(low,i),base)),rowNum,6)            )),            ulN,MAP(idx,LAMBDA(i,                INDEX(Tree(IF(idx=i,INDEX(high,i),base)),rowNum,6)            )),            results,HSTACK(                label,                llI,                ulI,                ABS(ulI-llI),                llN,                ulN,                ABS(ulN-llN)            ),            selected,FILTER(                results,                (inc=1)*(LEFT(names,2)<>exclude)            ),            SORTBY(selected,CHOOSECOLS(selected,7),-1)        )    ),    resultBase,Tree(base),    resultPC,OWSA(2,"HC"),    resultHC,OWSA(3,"RP"),    blank4,MAKEARRAY(4,7,LAMBDA(rowNum,colNum,"")),    blank2,MAKEARRAY(2,7,LAMBDA(rowNum,colNum,"")),    headerBase,HSTACK(        "Strategy",        "Expected Cost",        "Expected Outcome",        "Incremental Cost",        "Incremental Outcome",        "ICER",        "INMB"    ),    headerOWSA,HSTACK(        "Parameter",        "ICER LL",        "ICER UL",        "ABS ICER",        "INMB LL",        "INMB UL",        "ABS INMB"    ),    VSTACK(        headerBase,        HSTACK(            {"Routine Practice";"Primary Care";"Hospital Care"},            resultBase        ),        blank4,        HSTACK("Primary Care vs Routine Practice","","","","","",""),        headerOWSA,        resultPC,        blank2,        HSTACK("Hospital Care vs Primary Care","","","","","",""),        headerOWSA,        resultHC    ))

结果将溢出结果表以及两组排序后的OWSA Results,可在函数中进行参数更新。
相关学习资料