ARTICLE · 1216833
AI 写的 PR 插件满屏乱码?锅不在 AI,在字符集
用 AI 开发了一个 Premiere/AE 美颜插件,磨皮、美白、去油光、锐化全都能跑,13 项自动化测试一项不落全部通过。结果一打开效果面板——满屏乱码。
前后换了两种编码都没救回来,最后发现真凶一直在眼皮底下。这篇把排查过程、修复参数和绕不开的代价讲透,做插件的你迟早用得上。
下面所有数据、时间与截图,来源:2026-10-17 至 10-19 的开发实录。
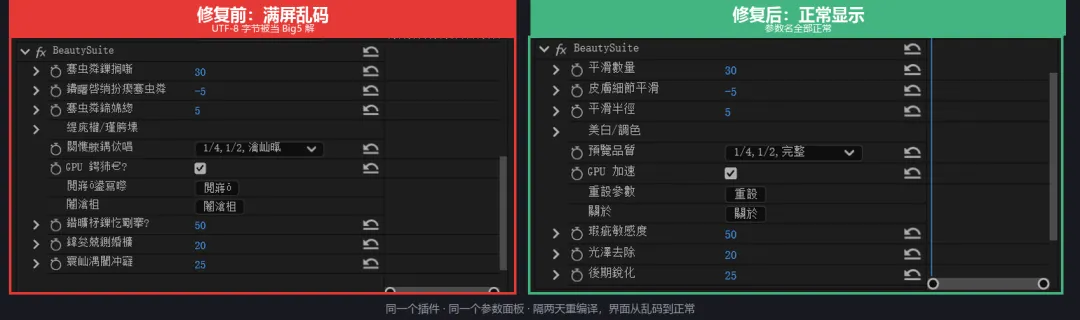
• 图注:同一个插件、同一个面板,修复前后的样子。左边那屏"字",你能认出几个?
一、插件本身:AI 写美颜插件靠谱吗
先说结论:算法和工程部分,比我想象的靠谱。
这个插件叫 BeautySuite,走 Adobe 的 C++ SDK,一个 .aex 通吃 PR 和 AE。功能面板里有平滑数量、皮肤细节平滑、美白/调色、瑕疵敏感度、光泽去除、后期锐化,外加 GPU 加速开关和四档预览品质。
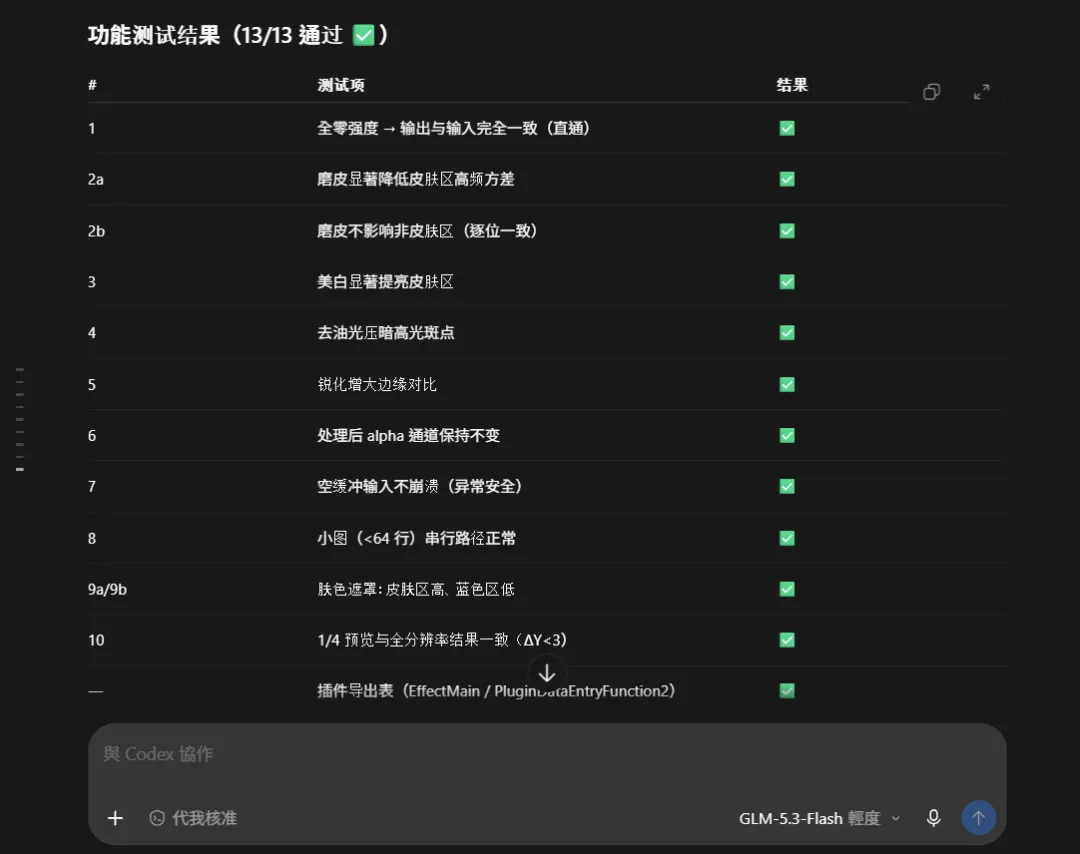
• 图注:AI 自己跑的功能测试,13 项全过——从磨皮有效性到 alpha 通道保留,再到异常输入不崩溃。
开发用的是 Codex,模型选的 GLM-5.3-Flash。我把需求拆给它:皮肤区域高频方差降低算磨皮、亮度提升限制在肤色遮罩内算美白、引导滤波做平滑(O(1) 复杂度,跟半径大小无关),再叠一层频率分离防止"塑料感"。
它还主动写了 13 项测试覆盖进 tests/test_backend.cpp:零强度必须逐像素直通、非皮肤区不许被牵连、空缓冲输入不能崩、1/4 预览和全分辨率结果误差 ΔY<3。这些边界条件,我手写的时候十有八九会漏掉一半。
算法不糊弄,测试也齐全,看起来万事俱备。
然后我把它装进了 Premiere。
二、满屏乱码:一打开就是天书
效果装上了,参数也能调,但面板上的中文全是天书:
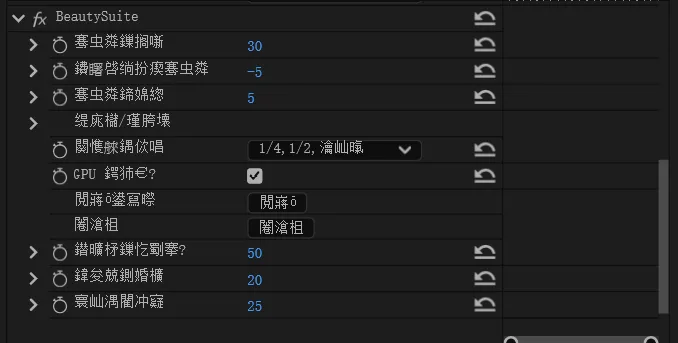
• 图注:第一版乱码。"CPU 縛拴?""關路?鑒溫"——每个字都认识,连起来完全不认识。
"平滑数量"变成"霙虫鏡鏡捐斷","重设参数"变成"閉路?鑒溫",下拉菜单里的"1/4, 1/2, 完整"更是面目全非。参数值 30、-5、50 这些数字倒是活的,说明插件逻辑没死,死的只是字符串。
我的第一反应是编码错了。让 AI 改成 Big5(繁体中文字符集)重新编译——装上,还是乱,而且乱得更花哨:
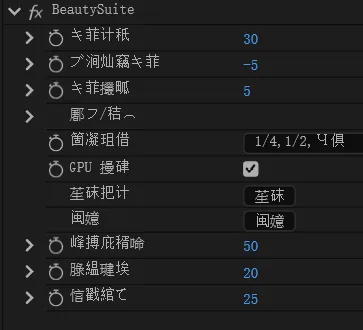
• 图注:第二版乱码,混进了一堆日文假名。"ピ菲计袛""グ洵灿颍",比第一版还离谱。
UTF-8 乱,Big5 也乱。这时候很容易怀疑人生:难道 AI 把字符串写坏了?
其实字符串一直好好的,坏的另有其人。
三、真凶:Premiere 在用 GBK 读字符串
AI 把两次乱码的截图翻出来对比,给出了关键证据:下拉菜单里弹出的"1/4, 1/2, …俱",正是 Big5 字节被 GBK 解码后的样子。
也就是说,不管我往插件里编进 UTF-8 还是 Big5,Premiere 都只认一种解码方式——简体中文版 Premiere 用 GBK(代码页 cp936)解析插件的字符串。字节对不上,就随机组合成你看到的天书。
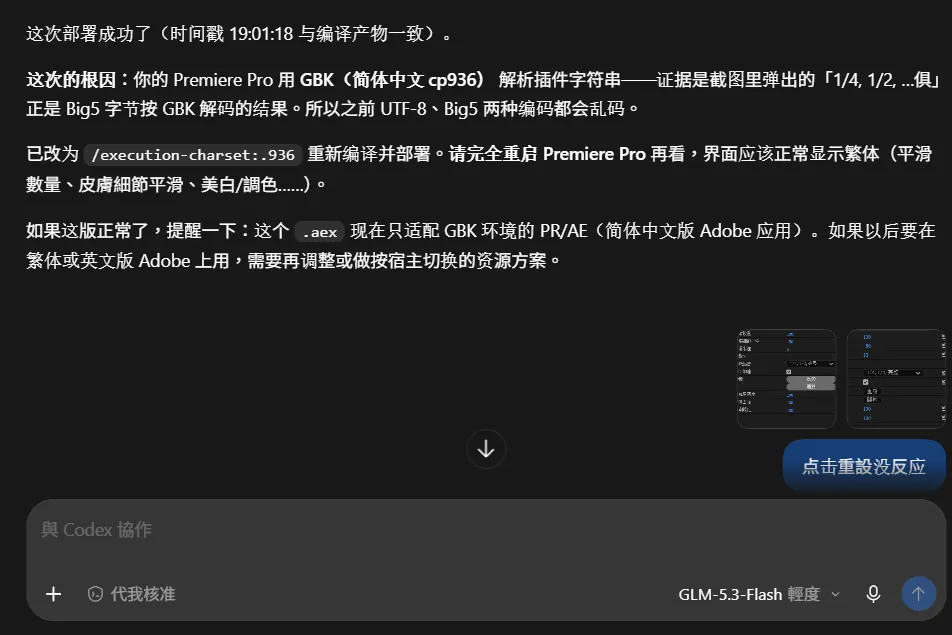
• 图注:AI 给出的根因分析和修复方案,最后一句还主动提醒了兼容性代价。
原理拆开看不难。Windows 简体中文系统的代码页是 936(GBK),Adobe 全家桶的界面按这个代码页解释插件的 ANSI 字符串。而 MSVC 编译器默认也是按系统代码页处理字符串——听起来应该正好对上,坏就坏在我的源码文件是 UTF-8 保存的,编码链路里多了一道弯:
1. 源码是 UTF-8,编译器得先加 /source-charset:utf-8 才能正确读懂它;
2. 编出来的字符串字节却进了 .aex,格式还是 UTF-8;
3. PR 拿 GBK 去解 UTF-8 字节——乱码。
Big5 那次更直接:字节本身就不是 GBK,怎么解都是乱的。
修复方案就一行编译参数:
/execution-charset:.936
让字符串在编译进插件的那一刻,就按 GBK 编码落地,正好对上宿主的解读方式。重新编译,完全重启 Premiere(不是最小化,是彻底退出再开),面板里的"平滑數量""美白/調色""光澤去除"全部恢复正常。
四、顺手修掉的两个真 bug
乱码之外,这轮排查还揪出两个隐蔽 bug,都是只有真机测试才能暴露的那种:
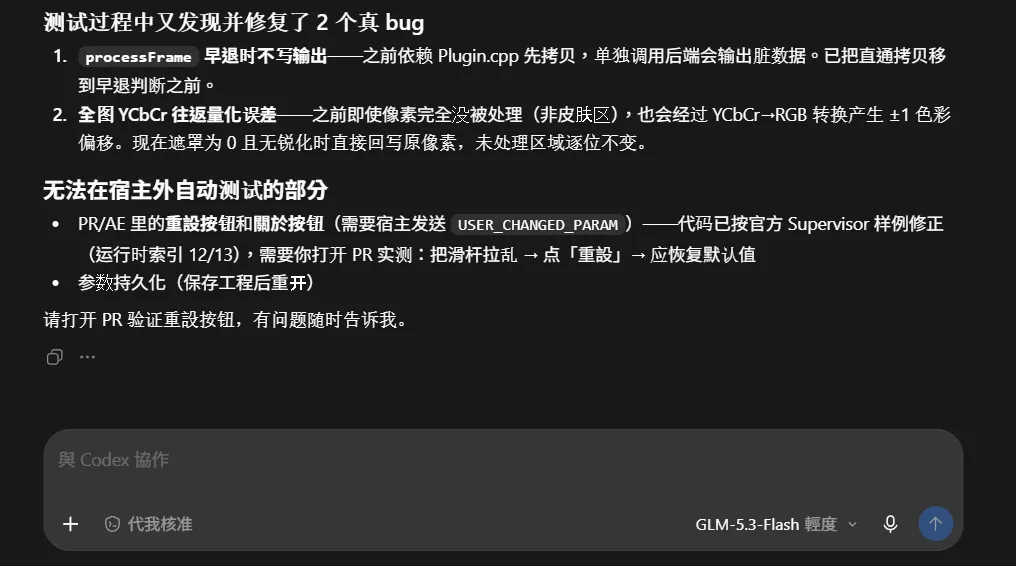
• 图注:AI 自己复盘的两个 bug,都和"看起来能跑"的边界情况有关。
一个是 processFrame 早退时不写输出。之前直通拷贝依赖宿主侧的 Plugin.cpp 先做,单独调用就会输出脏数据。修法是把直通拷贝挪到早退判断之前。
另一个更刁钻:全图 YCbCr→RGB 往返转换有 ±1 的量化误差,连完全没被处理的像素(非皮肤区)都会被殃及。现在遮罩为 0 且无锐化时直接回写原像素,未处理区域逐位不变。
这两个 bug 的共同点是:单元测试都过,但画面会说谎。
还有个小插曲。重设按钮一开始点了没反应,根因藏在 Adobe SDK 的一个反直觉设计里:PF_UserChangedParamExtra.param_index 传的是参数注册顺序索引,不是磁盘 ID。官方样例拆成两个枚举就是为此——注册时用磁盘 ID,回调比较用运行时索引。之前错拿 ID(6)去比对,而重设按钮实际排在第 12 位,怎么比对都对不上。
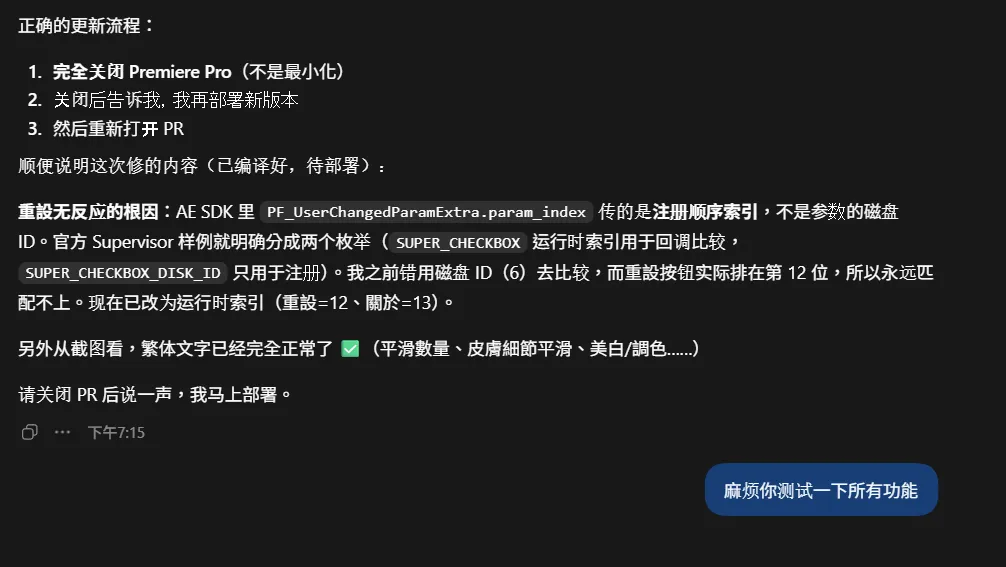
• 图注:修复后还剩两处只能在宿主里手测:重设/關於按钮和参数持久化。
五、代价:这份乱码-free 是有条件的
修复当天截图验证,AE 和 PR 两边面板全部正常:
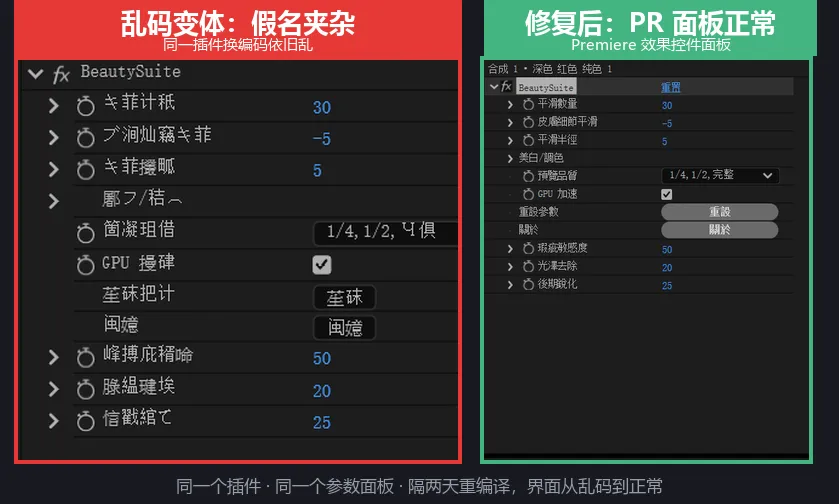
• 图注:Premiere 效果控件面板,参数名、按钮、下拉菜单全部正常。
但 AI 最后那句提醒值得单独立一段:这个 .aex 现在只适配 GBK 环境——也就是简体中文版的 Adobe 应用。
拿去繁体中文版或者英文版宿主里跑,字符串又会乱回去,因为那些宿主不用 cp936 解码。想全平台通用,得做按宿主代码页切换的资源方案,或者干脆走 Unicode 资源加载。这是下一个版本的事了。
回头看整个排查,有几条经验值得记下:
1. 乱码先查解码方,别急着怀疑编码方。 字符串能被"稳定地乱",说明读的一方规则是固定的。
2. 编译链路里每一层字符集都要点名。 源码用 /source-charset,落地用 /execution-charset,缺一层就多一个乱码机会。
3. 改完编码必须彻底重启宿主。 PR 对插件的缓存比想象中顽固,最小化重开不算数。
4. AI 能替你写代码,替不了你认乱码。 真机截图 + 人的眼睛,依然是最后一道质检。
这四条,每一条都对应 2026-10-17 当天的实际翻车记录。
项目收尾时让 AI 做了整体评估:三层架构(plugin / backend / utils)、引导滤波加频率分离的算法选型、分块多线程且小图自动退串行、防御性编程兜底直通结果。这些它做得确实好。(评估原文见 2026-10-17 会话截图)
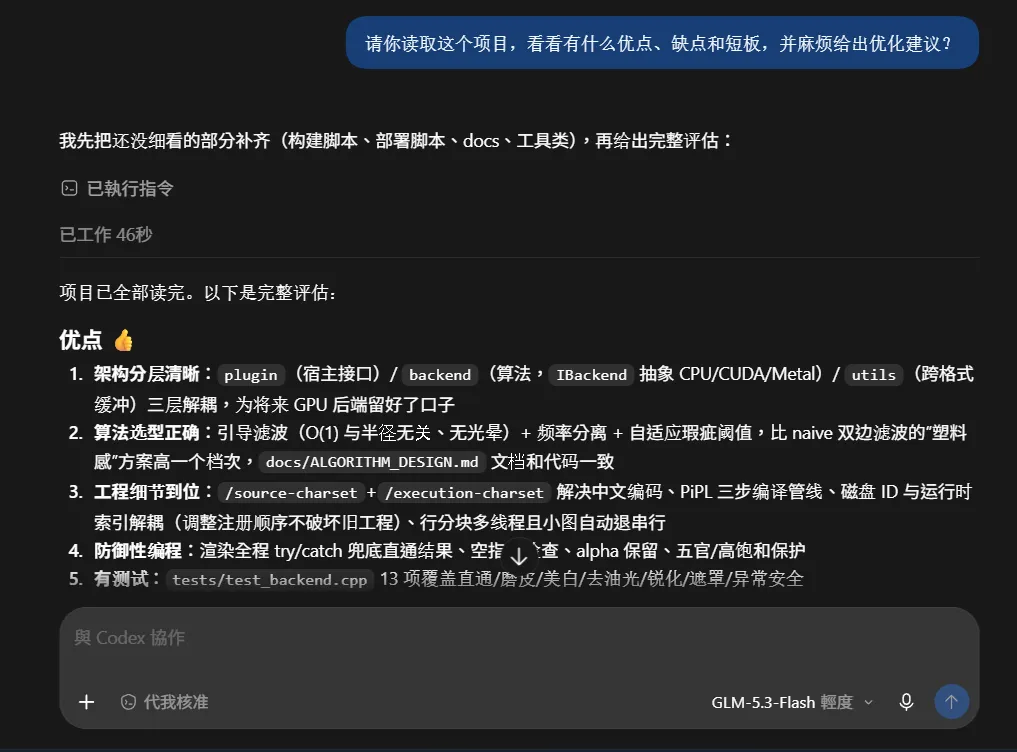
• 图注:AI 对整个项目的评估——优点说得具体,不是那种模板化吹捧。
写在最后
这次最意外的收获,反倒不是插件本身。
以前总觉得乱码是玄学,重装软件、换字体、碰运气。这次跟着 AI 把"源码字符集 → 编译执行字符集 → 宿主解码字符集"整条链路走了一遍,发现乱码的规则简单到近乎无聊:每一层怎么编码、下一层就怎么解码,对不上就是天书,没有第三种答案。
AI 编程这两年被说得很多,但这次体验更像是"结对调试":它出假设、出证据、出修复参数,我出真机、出截图、出最终判断。分工清楚,谁也不越界。
如果你也在写 Adobe 插件,或者被任何乱码问题困住——先把这条链路画出来,答案往往就藏在两层编码的接缝里。
觉得有用的话,点个在看,下一篇聊聊这个美颜插件的算法细节:引导滤波为什么比双边滤波更适合磨皮。
声明: 文中截图均为实际开发过程记录,测试数据来自插件自动化测试与真机验证。
— 完 —
#PR插件#AE插件#AI编程#乱码#C++SDK