ARTICLE · 1241214
【AI工具实测】你手机里有 3 个 App 在抢同一份知识
上周同事在群里问你:"上个月整理的那份客户需求清单还在吗?"
你明明存过。于是开始翻——微信收藏里有半版,电脑D盘"新建文件夹(2)"里有一版,手机备忘录里还记了几条。翻了十几分钟,最后发现最新那版躺在邮箱附件里。
这不是记性的问题。是你的知识,被三个工具各抢走了一块。
更亏的是下一件事:你把资料存了这么多地方,可等你真去问AI的时候,它一份都看不见。
先搞明白:这两类工具到底差在哪
做知识管理的工具,现在基本分成两派。
一派人把"东西放哪"当第一问题,代表是 Obsidian。笔记就是你电脑里的普通文本文件,关掉软件文件还在,不联网也能打开,插件随便装,数据完全归你自己。
另一派人把"能不能问"当第一问题,代表是 ima。资料传上去,它自己把内容挂到大模型上,你直接问它,还给你原文出处。
这两者不是替代关系。它们回答的是两个不同的问题:一个管"东西归谁",一个管"东西能不能被问"。
所以真正要解决的不是"选哪个",而是"谁管什么"。
操作步骤:花半小时做一次知识分工
第1步:把"落脚点"数清楚。 拿张纸,把你现在存资料的地方全列出来——微信收藏、企业微信文件、手机相册截图、电脑桌面、某个网盘、邮件附件。不用整理,先列出来就行。多数人列到最后会发现超过 5 个。
第2步:用三个问题分流。 对每一类资料问自己三句话:
这份东西丢了,我心疼吗?(心疼 → 放本地) 里面有客户名单、报价、图纸吗?(有 → 放本地) 我经常需要"就着它问问题"吗?(是 → 放云端AI库)
三句话过完,分工基本自己浮出来了:核心资产、敏感内容、要长期沉淀的,进本地库;参考资料、会议记录、行业文章这类"要反复翻、经常问"的,进云端库。
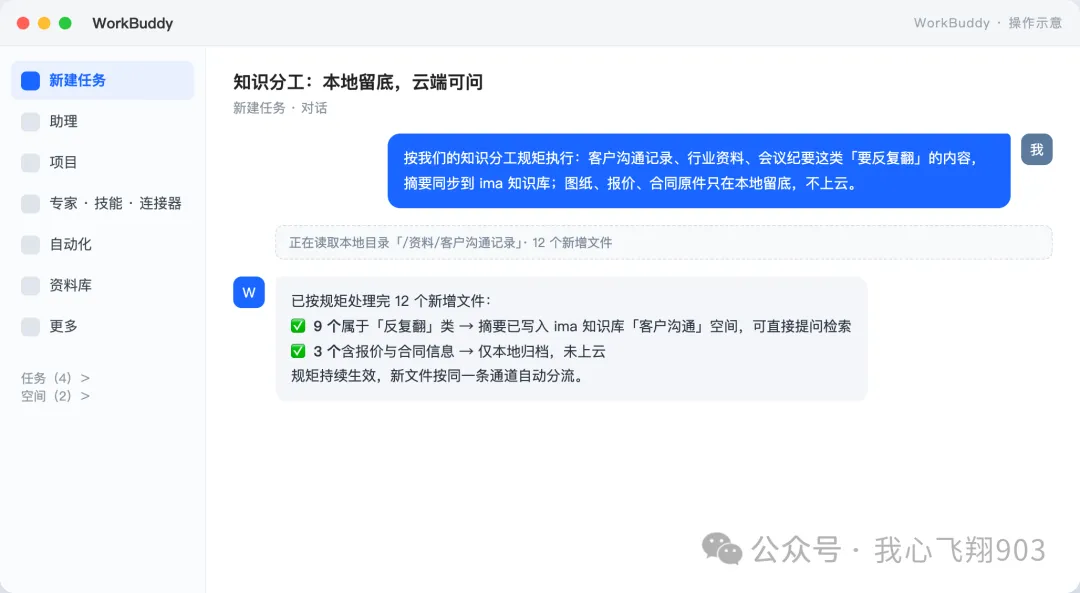
第3步:定一条通道,让两边通起来。 这一步最多人卡住——两个库怎么同步?答案是别手动搬。以 WorkBuddy 为例:它能直接读写你本地电脑上的 Markdown 文件,也能把整理好的内容写进 ima 知识库。你只需要定一条规矩:本地留底,云端可问。经验、结论、成稿这类"值得留下"的,写完顺手存一份到云端;资料、原件、原始文件,留在本地不动。
两个避坑提醒。 一是别一上来就搬家,先定规矩,新产生的内容按新规矩放,老资料用到的时候顺手归位就行。二是敏感内容别图省事往云端丢,客户名单、报价单、带公章的文件留在本地,AI 要用的时候临时喂给它。
真实案例
东莞一家做精密五金件的厂,技术部老周管着六个人的资料。以前的状态是:工艺卡拍照存在各自手机里,图纸在共享盘,客户确认记录在微信群,材质报告是邮件附件。
客户打电话来问"上个月那批不锈钢件的材质报告",老周得在工作群喊一声,三个人分头找,快则半小时,慢则一上午。
后来他们做了件很简单的事。图纸、工艺文件、报价这类"丢了要命"的,统一放本地库,用 Obsidian 管,全是电脑里的普通文件,不依赖任何厂商;客户沟通记录、行业资料、会议纪要这类"要反复翻"的,进 ima 云端库,直接问"3月给某某客户的交期承诺是什么",几秒钟出答案,还带原文出处。
现在老周找一份历史资料,从"一上午"变成"三分钟以内"。整个技术组每周省下来的找资料时间,差不多抵得上一整天。
结尾
一句话:如果你的资料散在三个以上的地方,或者你存了一堆东西、AI 却一份都用不上,这套"本地留底 + 云端可问"的分工法,值得花半小时理一次。
今天先把架子搭明白。周三我把具体的搭法写出来——怎么把 Obsidian 和 WorkBuddy 接起来、怎么让沉淀的经验自动流进云端库,跟着点就行。
(案例细节已做脱敏处理,了解更多,关注公众号)