ARTICLE · 1243924
8万 Star!GitHub 又一 AI 监控神器!
8万 Star!GitHub 又一 AI 监控神器!监控这件事,做过运维的都清楚,工具不缺,缺的是“省心”。 Zabbix功能全,但配置量大,新人接手一个现成环境都得先啃几天文档。Prometheus配Grafana是当下主流方案,灵活是灵活,代价是每接入一台机器就要写一轮exporter配置,PromQL不熟的话查个指标都得翻半天语法。 Netdata走的是另一个方向:装完,打开浏览器,机器状态已经在那儿了。GitHub目前80k+ Star。 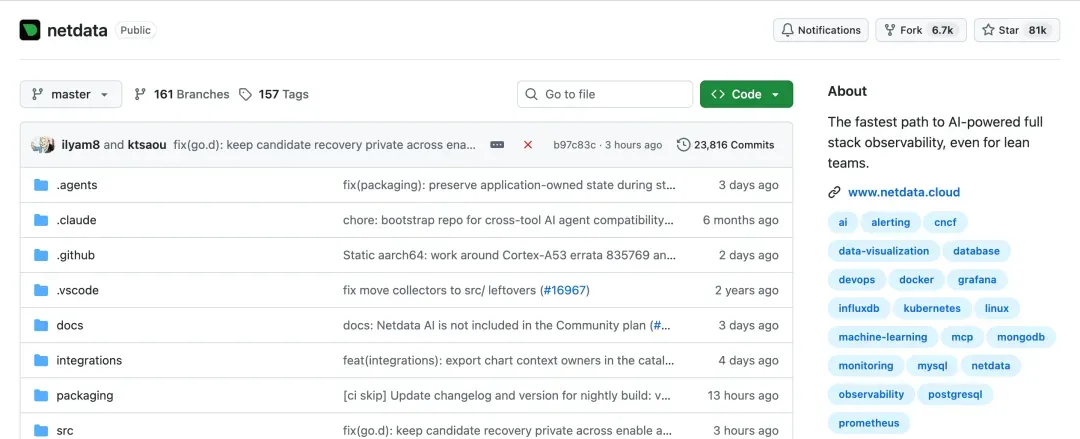

01 它到底是什么 
一个开源的实时性能监控平台。 在目标机器上装一个agent,通过19999端口访问内置仪表盘,CPU、内存、磁盘、网络、进程这些系统指标,加上MySQL、Redis等应用指标,全都直接呈现。 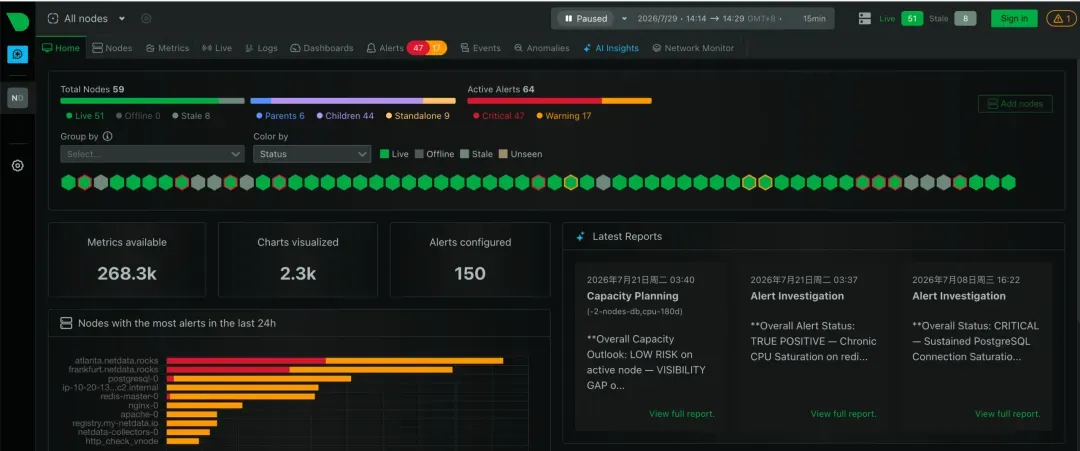
官方对它的定位是“AI加持的全栈可观测平台”,说白了就是:不只展示数据,还会主动判断哪些指标异常,排查时把可疑项排到前面。 整体分三层: 
02 核心差异:不需要你告诉它监控什么 
目前支持八百多个集成,覆盖操作系统、容器、虚拟机、硬件传感器、数据库、Web服务等。 最关键的一点:装完之后它自己扫描机器,发现什么就监控什么,仪表盘自动生成。 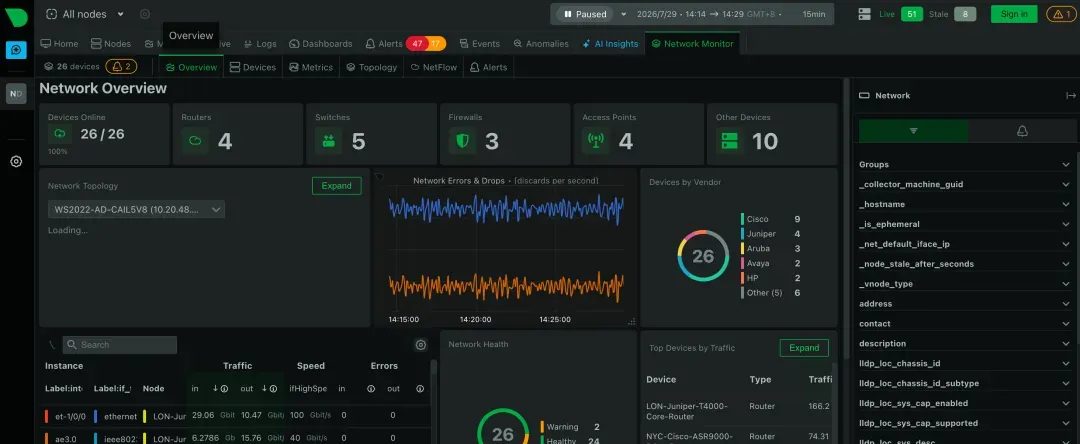
用Prometheus的话,每台机器要配exporter,每个服务要单独接入。Netdata把这一步整个砍掉了。 自动发现不代表不能手动配。想加收集器或调整采集项都可以,只是绝大多数场景用不上。 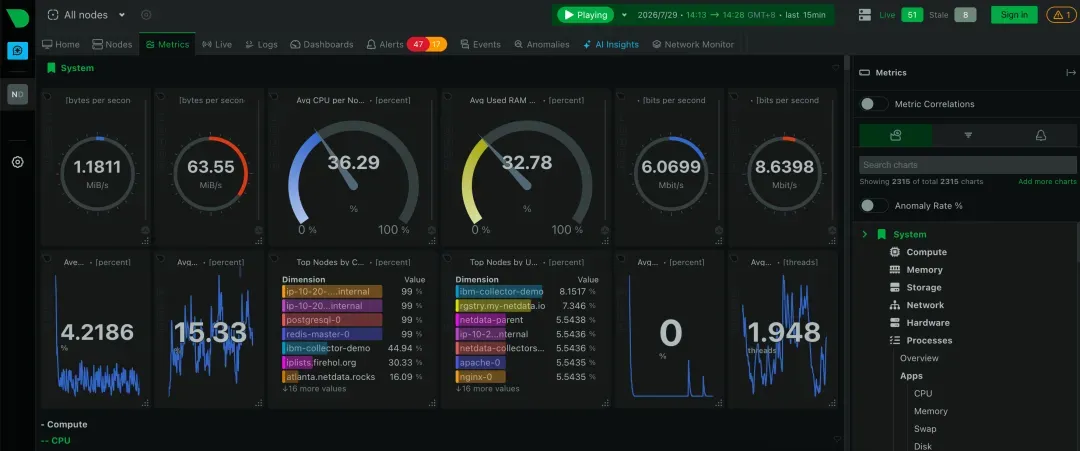
另外它也支持OpenMetrics和StatsD两种通用格式,应用自己吐的指标能直接接进来。 
03 一秒一条数据,瞬时问题跑不掉 
采集频率是每秒一次,采完立刻上图,延迟约一秒。 这一点听起来不起眼,实际差距很大。 很多监控工具30秒甚至一分钟才采一轮。那种只持续几秒的CPU飙高、网络抖动,在图上直接被平均掉,事后根本查不到。 线上最难查的故障,往往是“出了问题又自己恢复了”。一秒级的数据,就是为这类场景准备的。 
04 不用学查询语言,点鼠标就行 
Prometheus用户都懂,想看稍微复杂点的数据就得写PromQL。 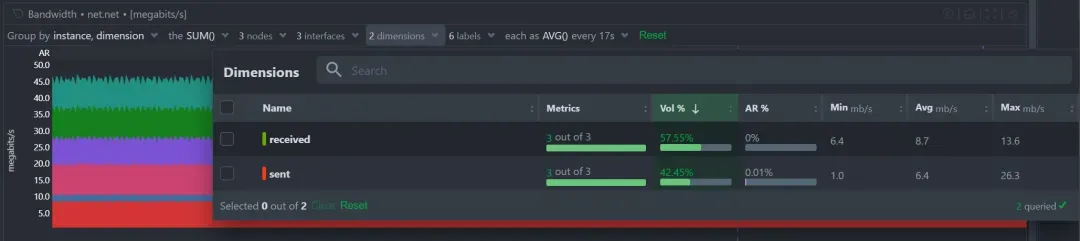
Netdata的操作方式是在图表上直接点:按机器分组、按网卡分组、按指标维度筛选,几下鼠标就能完成。 
05 18个模型投票,才判定一次异常 
异常检测用的是无监督机器学习。 每个指标训练18个模型,各自看不同时间窗口的历史数据,学习这个指标正常时的形态。判断异常时18个模型一起投票,全部认为异常才算数,误报率因此被压下来。 训练在本地机器上完成,数据不出门。 装完约15分钟出第一批结果,跑两天模型全部训练完毕,中间不需要人工干预。 出问题时有一个Anomaly Advisor,把当前最可疑的指标按顺序列出来。以前排查是对着几十张图逐个猜,现在可以先看它给的排序。 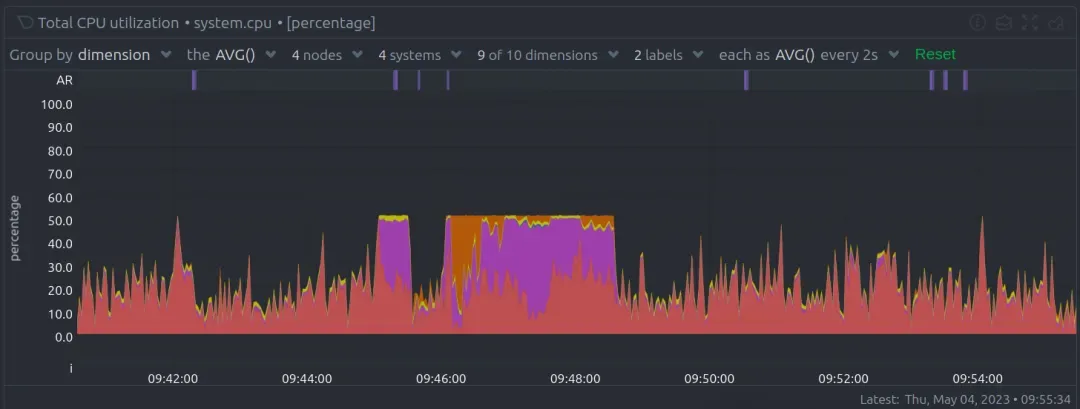

06 告警规则开箱即用 
自带几百条预置规则,磁盘将满、内存疑似泄漏、网络错误率上升这些常见场景都覆盖了。 通知渠道支持邮件、Slack、PagerDuty、Webhook。通过Webhook转发,企业微信和钉钉也能接上。邮件只要有MTA就默认可用。 如果团队在用Claude Code、Codex这类AI编程工具,可以把它们接到监控数据上,用自然语言提问,比如“昨天下午那台机器CPU为什么突然飙升”,它会自己查数据并给出分析。 
07 自身开销小,数据留在本地 
监控工具最怕自己成为负担。 官方数据:单机每秒采集5000个指标时,大约占单核CPU的5%、200MB内存。 阿姆斯特丹大学2023年的一项对比研究认为,它在CPU、内存和执行时间上都优于同类工具。 数据存储在本机,每个采样点压缩后约占0.5字节,磁盘足够的话可以存好几年。 想接入现有监控体系也没问题:除Prometheus外,还支持导出到InfluxDB、Graphite、OpenTSDB,Grafana有现成数据源插件。 它还能直接读systemd-journald和Windows事件日志,日志在本地处理完再可视化,省掉单独搭日志系统的麻烦。 此外有一个打分引擎,会跨指标找关联——比如某台机器CPU飙高,是不是因为隔壁那台出了问题。 
08 安装是它最省事的部分 
单机、容器、多机三种场景,各有一条路径,装完统一访问19999端口。 Linux一条命令: ···bash 脚本先落到/tmp再执行,装完浏览器打开http://服务器IP:19999,仪表盘已经在了,中间不需要任何配置。 macOS、FreeBSD、Windows都支持,K8s有专门部署方式。 Docker方式: ···bash -p映射19999端口,--cap-add SYS_PTRACE让容器能看见宿主机进程,-v把宿主机根目录只读挂载进去,这样它才能读到宿主机的磁盘和网络信息。 完整挂载参数更多,建议按官方文档来,上面这条是最精简的可运行版本。 多台机器: 每台各装一个agent。想要统一入口,可以注册Netdata Cloud关联多台机器,个人使用免费额度足够;不想用云的话,自己搭一个parent节点,让其他agent把数据汇总过来。 
09 适合哪些场景 

10 两点不足 
官方重心明显在Netdata Cloud上,部分AI排障能力留在云端。纯自托管能用核心监控和异常检测,但体验不是满血。 另外它强在基础设施层,如果需要完整的应用性能追踪,还得搭配其他工具。 建议:有服务器就装一个试试。一行命令,数据不出本机,就算只用来看看实时曲线也不亏。小团队从零搭监控,可以先拿它顶着。  你在看吗
上方蓝色“程序员追风”,选择“设为星标”
来源:github.com/netdata/netdata
Agent:跑在你自己机器上,负责采集、存储、推理、告警和数据导出 Cloud:多节点统一视图和集中告警配置,不存原始指标 UI:仪表盘,CDN分发
wget -O /tmp/netdata-kickstart.sh https://get.netdata.cloud/kickstart.sh && sh /tmp/netdata-kickstart.sh
docker run -d --name=netdata -p 19999:19999 --cap-add SYS_PTRACE -v /:/host/root:ro,rslave netdata/netdata
手上有几台云服务器或VPS,想随时看实时状态,装完就能用 线上问题排查,一秒级数据抓瞬时抖动比粗粒度监控强得多 跑AI训练或推理的机器,GPU功耗、温度、显存占用可以实时盯 小团队不想维护Prometheus加Grafana整套,一个工具顶好几个
开源地址:https://github.com/netdata/netdata
你在看吗