ARTICLE · 1244741
端侧AI芯片的机遇与挑战
背景
随着大模型推理成为AI算力的主要消耗,把一部分推理留在终端完成的端侧AI,被普遍视为AI周期的下一个增长点。2026年以来,这一领域的热度明显上升:资本集中涌入,9月国内近十家端侧AI芯片企业披露融资,单月合计超过30亿元,资金集中在存算一体和3D近存方向;已有出货的平台型公司业绩兑现,瑞芯微前三季度营收预增约42%,爱芯元智上半年收入增长182%;产业界对端侧大模型的预期也在抬高,高通CEO安蒙提出2028年手机可以常驻运行1000亿参数的模型。
另一方面,终端和成本端的压力在加大。端侧AI最大的载体手机正在萎缩:Counterpoint预计2026年全球智能手机出货同比下降13.9%,降至约10.8亿部,为2013年以来最低;IDC预计全球PC出货下降11.3%。手机内存LPDDR5X合约价三个季度涨到约3.8倍,内存在手机制造成本中的占比一度超过40%。与此形成鲜明对比的是数据中心:英伟达2027财年第二季度(截至2026年7月)数据中心收入890亿美元,同比增长117%,单季收入已超过全球边缘AI芯片组全年的市场规模。
但端侧AI的发展基础并不像热度显示的那样稳固。端侧AI芯片面临的核心问题是:机会究竟在哪里,与数据中心相比还面临哪些更根本的挑战,中国大陆企业又该如何应对。本文从市场机遇、终端缺位、成本约束、技术路线、车规应用、供应链与融资七个角度展开分析。
核心观点
机遇 ■ 端侧AI的需求是真实的:推理成本、时延、隐私和智能体常驻运行,都要求一部分AI留在终端。增量集中在两头:一头是Agent主机、机器人和汽车等单设备价值高的场景,另一头是AI耳机、眼镜等出货量大但单价低的可穿戴与IoT。 ■ 放量顺序依次为:Agent主机与私有化推理一体机、机器人“大脑”、车载舱驾一体与座舱大模型;可穿戴量大价低,手机端侧大模型不是近期爆点。 ■ 中国大陆在车载、AIoT、机器人和端侧大模型协处理器上具备场景和规模优势,瑞芯微、地平线、爱芯元智等已有出货的平台型公司业绩兑现。 挑战 ■ 终端缺位是最大的挑战:手机出货持续下滑,而眼镜、耳机等新终端体量不到手机的几十分之一,目前仍没有能替代手机的终端出现。端侧AI缺少一个足以拉动芯片规模的“主载体”。 ■ 与数据中心相比,端侧面临更大的不确定性:数据中心有明确的付费方(云厂商资本开支)、收敛的技术路线(GPU+HBM+CUDA)和统一的软件生态;端侧的付费方是对价格敏感的消费者,终端形态分散,技术路线和工具链高度碎片化。 ■ 存储是重要约束之一,但不是唯一约束:LPDDR5X三个季度涨到约3.8倍,AI服务器开始与手机争抢LPDDR,端侧AI的成本曲线在相当长时间里由数据中心决定。功耗散热、软件碎片化和消费者付费意愿同样制约端侧AI。 ■ 技术路线多路并行、尚未收敛:SRAM存算一体、3D近存、协处理器各有适用场景,短期收入以协处理器最大,长期价值最大的3D近存则依赖DRAM和先进封装,价值未必归属设计公司。 ■ 中国大陆面临先进制程、先进封装和存储三重供应链约束;单靠融资支撑的初创公司成功概率很低,当前融资热潮属于“结构性泡沫”,预计2027–2028年洗牌,赢家更可能来自产业链内部。 |
一、机遇:端侧AI的增量在哪里
1. 端侧AI的需求基础
把一部分AI推理留在终端,有四个现实理由:一是成本,推理已成为AI算力的主要消耗,用用户已经付费的终端算力分担推理,可以降低云端token成本;二是时延与可靠性,智驾、机器人、实时翻译对毫秒级响应有刚性要求;三是隐私与合规,相册、消息、健康数据在本地处理更易满足监管要求;四是智能体,Agent需要持续读取屏幕和上下文,常驻、低功耗的本地推理是前提。据媒体转引的IDC数据,2026年一季度中低端端侧芯片出货同比增长超过110%,增长重心正从旗舰手机转向IoT和边缘场景。
2. 市场爆点与放量顺序
判断爆点要同时看两件事:场景能否绕开终端的成本和体积约束,以及单设备的芯片价值能否支撑芯片公司的投入。按这个标准,我们认为放量顺序如图1所示。
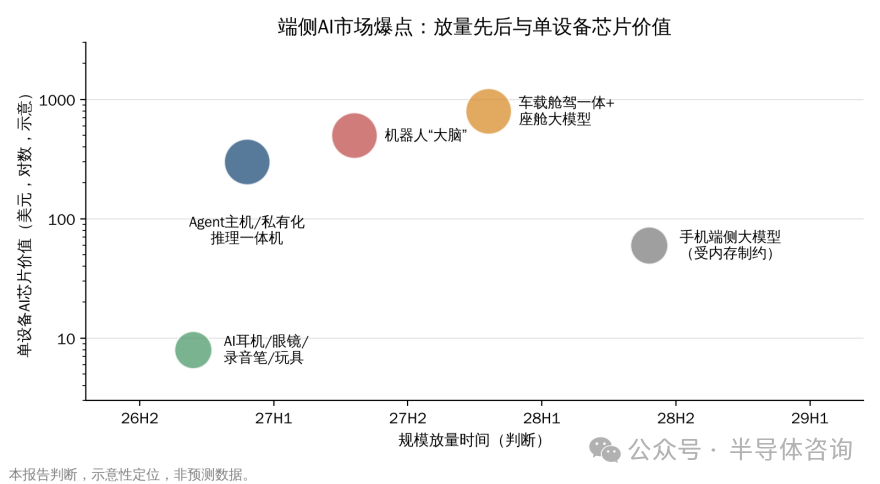
图1 端侧AI市场爆点:放量先后与单设备芯片价值(示意)
Agent主机与私有化推理一体机最先放量:这类设备不受体积和散热约束,可以配64–128GB内存,直接运行数十到上百亿参数的模型,企业和个人对数据不出本地的需求也很明确。联想P7借助后摩智能M50可在本地运行122B参数模型,爱芯元智推出AX Clawbox系列和AX8850算力卡。这一市场看重大内存、高带宽和好用的软件栈。
机器人“大脑”单设备价值最高:英伟达7月推出Jetson T3000(865 FP4 TFLOPS、32GB LPDDR5X、273GB/s带宽)和T2000(400 FP4 TFLOPS、16GB内存),把机器人计算的门槛往下拉了一档;英伟达2027财年第二季度边缘计算收入72亿美元,同比增长27%。国产方面,瑞芯微称其产品在机器人市场占有率很高,地瓜机器人9月完成4亿美元C轮融资,爱芯元智推出具身智能大脑控制器。
车载舱驾一体与座舱大模型:这是单设备芯片价值最高、验证周期也最长的市场,详见第五部分。
AI可穿戴出货量大、单价低:AI眼镜、耳机、录音笔和玩具要求毫瓦级功耗和常开感知,SRAM存算一体、集成NPU的MCU和低功耗音频SoC是主力。这类芯片单价通常只有几美元到十几美元,需要千万颗级的出货才能形成规模。
3. 中国大陆的相对优势
与数据中心AI芯片相比,端侧是中国大陆最有机会形成规模优势的领域:车载和AIoT对先进制程的依赖较低,下游整车、家电、安防、机器人和AI硬件市场全球最大,开源模型也降低了端侧部署门槛。已有出货的平台型公司业绩正在兑现:瑞芯微RK3572三季度量产、RK182X协处理器四季度放量;爱芯元智上半年智能汽车SoC出货约42万颗,边缘AI收入增长约252%。
挑战之一:终端缺位,手机下滑而替代者尚未出现
1. 手机:最大的载体正在萎缩
手机是端侧AI芯片最大、也是最成熟的载体,但它的总量在萎缩。全球智能手机出货在2019年后基本在11.7亿到13.7亿部之间徘徊,2025年为约12.6亿部;受内存涨价冲击,Counterpoint预计2026年下降13.9%至约10.8亿部,为2013年以来最低。下滑主要集中在中低端,Counterpoint预计200美元以下手机的年出货将从2026年的5.7亿部降至2030年的3.4亿部;三星、苹果相继上调售价,国内中端机普遍涨价300–1000元。PC同样承压,IDC预计2026年全球PC出货下降11.3%,Gartner把AI PC渗透率达到50%的时间推迟到2028年。
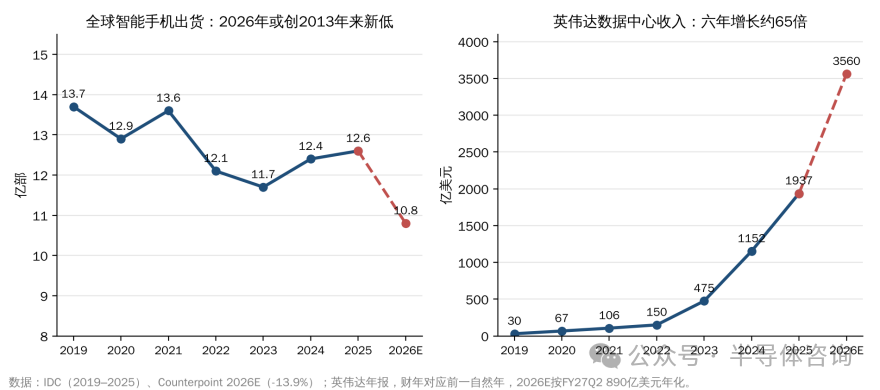
图2 全球智能手机出货与英伟达数据中心收入
这意味着端侧AI在手机和PC上的增量主要来自“量减价增”:高端SoC和内存的单价上升,而不是出货规模扩大。AI功能下沉到中低端机型的速度明显慢于此前预期,以中低端为主的芯片厂商首当其冲。
2. 新终端:尚无能替代手机的形态
过去两年,业界寄望于AI眼镜、AI耳机、AI录音设备和陪伴机器人等新终端接棒。但从体量看,它们离替代手机还很远。据媒体转引的IDC预测,2026年全球智能眼镜出货约2300万副,不到手机的2.5%;TrendForce预计AR眼镜仅约95万台;传闻中的OpenAI首款AI耳机首年预估出货4000–5000万部,即使兑现,也只有手机的约4%。更重要的是,这些设备的算力很小,多数依赖与手机或云端协同,本身并不承载大模型推理,单设备的芯片价值只有几美元到十几美元。
消费者对“AI功能”的付费意愿也不明确。多数AI手机和AI PC的卖点仍是影像、翻译和办公助手,尚未出现让用户为端侧AI专门换机的杀手级应用。我们认为,在可预见的两三年里,仍没有能替代手机的终端出现;端侧AI缺少一个足以拉动芯片规模的“主载体”,这是它与数据中心最大的不同。(判断)
3. 与数据中心相比:端侧面临更大的挑战
数据中心算力市场的增长逻辑清晰:付费方是资本开支持续扩张的云厂商和大模型公司,英伟达数据中心收入从2019年的约30亿美元增至2025年的约1937亿美元,2027财年第二季度单季就达到890亿美元;技术路线高度收敛在GPU、HBM和CUDA生态上,芯片厂商只需沿着同一条路线把性能做高。
端侧则相反。第一,付费方是对价格敏感的消费者和终端厂商,内存和芯片涨价很难顺利传导,反而会压缩出货。第二,终端形态分散,手机、PC、汽车、机器人、眼镜、IoT的功耗、成本和可靠性要求差异很大,任何一种芯片都难以通吃,单一品类的规模有限。第三,技术路线和软件生态高度碎片化,各家NPU的指令集、算子库和工具链互不兼容,开发者移植成本高。第四,端侧还要和云端竞争同一批推理需求:当云端token价格持续下降,端侧推理的成本优势会被削弱。ABI Research预测2026年全球边缘AI芯片组市场约344亿美元,规模尚不及英伟达数据中心半个季度的收入。综合来看,相对数据中心,端侧AI芯片的市场和技术路线面临更大的挑战。(判断)
挑战之二:存储等成本约束
存储是端侧AI当前最突出的成本约束,但它只是约束之一,功耗散热、先进制程成本和消费者付费意愿同样在起作用。本部分重点分析存储,因为它把技术问题直接变成了经济问题。
1. 存储涨价与AI服务器争抢LPDDR
TrendForce数据显示,LPDDR5X合约价2026年一季度环比上涨约90%,二季度再涨78%–83%,三季度涨8%–13%,三个季度累计涨到约3.8倍。更深层的变化是,LPDDR不再是手机专属:英伟达服务器CPU通过SOCAMM模组大量采用LPDDR5X,据报道英伟达明年也只能拿到所需LPDDR5X的六到七成,并已把下一代Vera CPU的SOCAMM2容量从192GB减半到96GB;AMD和英特尔明年的服务器与推理产品也将加入。存储厂产能优先保障毛利更高的服务器客户,端侧产品在供给排序中被后置,端侧AI的成本曲线在相当长时间里由数据中心决定。(判断)
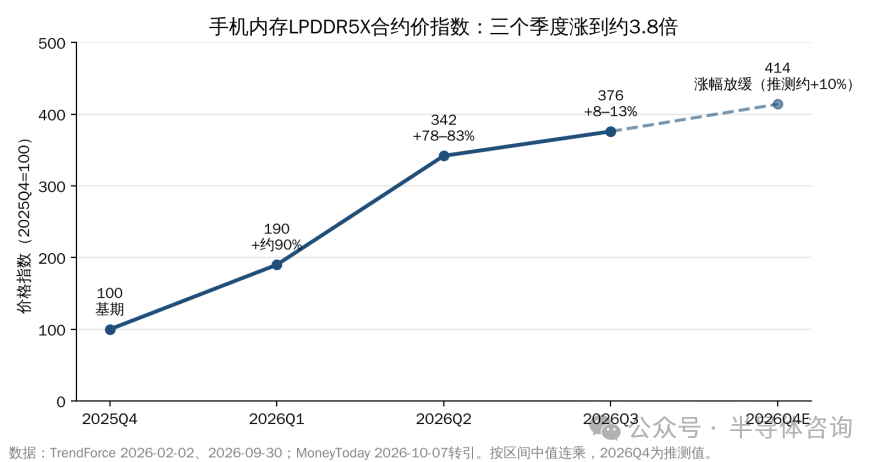
图3 手机内存LPDDR5X合约价指数(2025Q4=100)
2. 内存容量与带宽限制可运行的模型规模
大模型解码阶段每生成一个token都要把权重从内存搬到计算单元一次,生成速度由内存带宽决定,能运行多大的模型由内存容量决定。4-bit量化的100B模型仅权重就需要约50GB,2-bit也要约25GB,远超手机当前十余GB的可用内存;安蒙也承认,按目前的DRAM供给,手机内存短期很难超过16GB。现实可行的办法是更激进的量化、稀疏MoE加闪存卸载,或20–30B的蒸馏模型。我们认为,2028年前手机上的主力模型仍在10–30B量级,100B级模型会先出现在PC、Agent主机和边缘设备上。(判断)
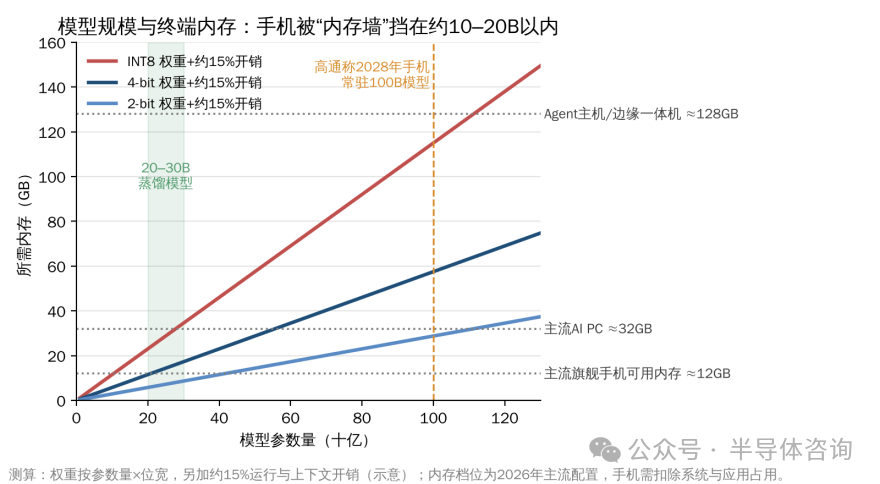
图4 不同量化精度下模型规模与终端内存档位
3. 其他约束:功耗、散热与付费意愿
手机持续推理受3–5W的热设计约束,大模型长时间运行容易触发降频;单纯堆TOPS的收益递减。芯片评价指标因此正从TOPS转向每token搬运的字节数和每瓦token数:Chips&Media推出NPU特征图无损压缩IP,ENERZAi的1.58-bit端侧语言模型获得年度奖项,BrainChip 10月14日发布面向端侧生成式AI的Sequora处理器IP。但技术上的节省,最终仍要面对终端厂商“为AI多付多少钱”的问题,在内存涨价周期中,这一意愿明显减弱,部分厂商甚至在降配。
二、技术路线:多路并行,尚未收敛
与数据中心路线高度收敛不同,端侧芯片的技术路线仍在分化。围绕“减少数据搬运”这一共同目标,存算一体、3D近存和协处理器三条路线并行发展,但解决的问题层级不同,商业成熟度差距也很大。
1. SRAM存算一体:最成熟,但装不下大模型
SRAM存算一体把乘加运算放进SRAM阵列内部完成,能效优势明显。微纳核芯称其流片实测相比传统架构可提升4–6倍算力密度和5–10倍能效比;据行业汇编,知存科技已实现千万级出货。它的硬约束是容量:片上SRAM通常只有MB级,存不下数十亿参数的权重,更适合语音唤醒、降噪、视觉检测等小模型常开场景。行业观察还指出,大厂正把存算能力直接做进自家SoC,存算一体正从独立产品变成AI芯片架构的一个组件;模拟存算的精度损失、新型存储器件的一致性和缺乏统一评价标准,也限制了它进入高可靠性场景。
2. 3D近存:解决大模型带宽的关键,但瓶颈在设计公司之外
3D近存把逻辑芯片和DRAM通过混合键合等方式垂直堆叠,带宽可以提升一个数量级。小米8月发布的玄戒O100采用6nm工艺和3D晶圆级堆叠,近存带宽达到1.22TB/s;后摩智能首款3D存算芯片A20已经投产,最多可16颗互联;据行业汇编,谦合益邦8月完成超20亿元B轮融资,并披露4层3D DRAM堆叠芯片回片点亮。这条路线的瓶颈在于定制DRAM供给、混合键合良率和散热,都不在设计公司手里。我们判断,3D近存长期价值最大,但价值主要会流向掌握DRAM和先进封装的一方,以及有能力绑定它们的终端大厂。(判断)
3. 协处理器:当前最务实的商业形态
“主控SoC加大模型协处理器”让终端厂商无需更换主控就能加上大模型能力,也降低了单颗大芯片的流片风险。后摩智能M50截至8月底获得150多个产品定点、服务100多家客户;瑞芯微RK182X多条产品线进入量产,新一代协处理器将于年内发布。协处理器在手机上是过渡形态,一旦旗舰SoC通过晶圆级封装或3D堆叠把带宽问题内部化就会被吸收;在PC、边缘盒子、机器人和汽车里,它有望长期存在。
4. 软件生态碎片化是另一道门槛
数据中心有CUDA这样的统一生态,端侧却是苹果Core ML、高通AI Hub、英伟达JetPack和众多国产NPU工具链并存。国产NPU的算子覆盖、编译器成熟度和模型适配效率普遍不足,开发者多以CUDA和高通、苹果的工具链为基准。新架构越激进,软件适配的成本越高,这也是存算一体和3D近存从样片走向规模商用的主要障碍之一。
5. 路线排序
综合来看,2026–2027年的收入规模大致是协处理器第一、SRAM存算一体第二、3D近存第三;2028年以后的长期价值排序可能倒过来。图5以时间曲线的形式汇总了近一年来的关键节点。
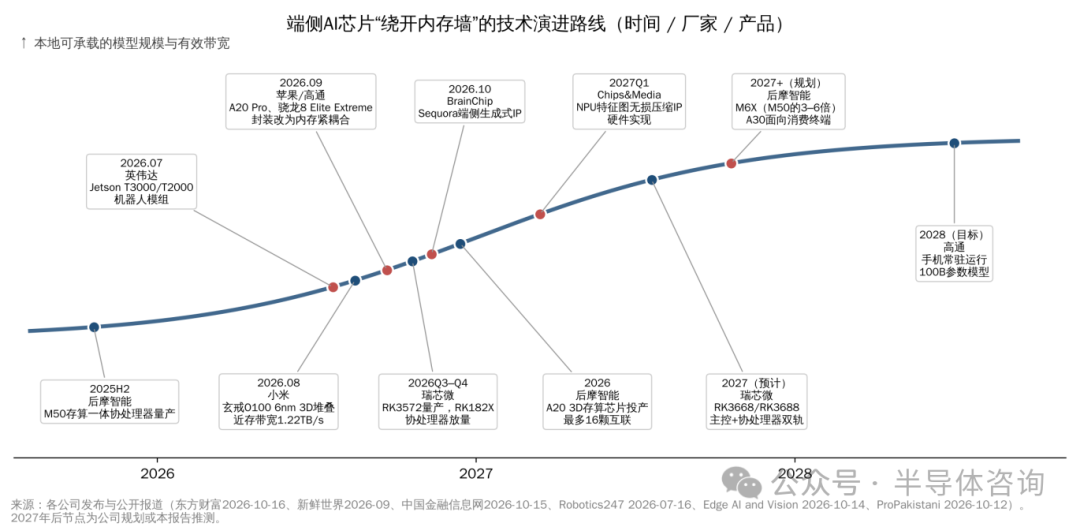
车规应用:舱驾一体是主战场
1. 舱驾一体从技术方向变成成本刚需
分离架构下,座舱和智驾两颗SoC各配一套内存,在内存涨价周期中整车BoM被放大。地平线CEO余凯表示,星空6P单芯片方案仅DDR一项就可节省2000–3000元,整车综合可省1500–4000元。行业观察还指出,舱驾一体可以把整车算力利用率从不足30%提升到70%以上;AI Agent需要跨座舱和智驾域调用数据,分离架构下跨芯片通信的延迟可达百毫秒级。
2. 竞争格局:高通领先,本土方案追赶
高通是量产落地最快的一方:骁龙8775已经量产,Ride Extreme系列全球拿到18个定点,其中10个车型已经或即将量产,座舱平台可在本地运行数百亿参数的全模态模型。地平线星空6P(5nm,650 TOPS)主打全栈交付和性价比;黑芝麻武当C1296被称为首个本土舱驾一体量产芯片,已搭载于东风奕派007;芯擎龙鹰二号计划2027年一季度启动适配。爱芯元智上半年新增24个量产车型定点,M97和M95高阶智驾芯片已回片点亮,座舱大模型算力加速芯片已经流片。车企自研方面,理想采用M100加骁龙8797的混合架构,比亚迪、小鹏、蔚来的自研芯片目前仍以智驾专用为主。
3. 新架构上车的门槛
车规对新架构格外苛刻:芯片要通过AEC-Q100可靠性认证和ISO 26262功能安全认证(高阶智驾需要ASIL-D),在零下40度到125度之间稳定工作,还要经过3–5年验证并承诺10–15年供货。模拟存算一体的精度漂移和温度敏感性,与智驾安全路径“对精度零容忍”的要求存在根本矛盾。我们判断,2029年前模拟存算一体很难进入ASIL安全关键路径;先上车的会是座舱大模型协处理器、数字近存方案,以及集成在舱驾一体SoC里的近存模块。(判断)
4. 车规存储与车市规模的风险
车规LPDDR出货量小、认证和谈判周期长,在存储厂排产中的优先级往往低于服务器和旗舰手机(判断)。座舱大模型正在把单车内存从16GB推向32GB甚至更高,一旦车规存储供应紧张,舱驾一体节省的成本可能被涨价抵消。此外,车载芯片的规模受整车销量约束,全球年销量约9000万辆,远小于手机,智驾芯片供应商过多(仅中国市场就有约14种方案)也意味着价格竞争会很激烈。
三、中国大陆:供应链约束
中国大陆端侧AI芯片在需求和场景上具备全球优势,但在供应链上存在三个硬约束,而这三处恰恰是初创公司最缺乏议价权的环节。
先进制程:IoT和可穿戴芯片用6–22nm工艺就够用,但高阶智驾芯片、旗舰手机级SoC和大模型协处理器需要4–6nm甚至更先进的工艺。大陆设计公司在台积电先进节点流片受到美国规则约束;本土先进产能有限、良率低于台积电,而且优先保障数据中心AI芯片和大客户。对初创公司来说,结果是流片排期更长、单片成本更高、工艺迭代更慢。
先进封装:3D近存依赖混合键合、晶圆级封装和硅通孔。台积电的先进封装产能优先保障苹果、英伟达等大客户;国内长电科技、通富微电、甬矽电子等积极扩产,但混合键合设备主要依赖海外厂商,存在管制风险,国产设备仍在验证阶段。产能紧张时,小批量、定制化的初创订单排序靠后。
存储:国产3D近存方案需要本土DRAM厂定制供货。长鑫存储第五代DRAM平台已经量产,全球份额进入前四,但其产能要同时支撑HBM、服务器DDR5和手机LPDDR,定制化3D堆叠DRAM在优先级上很难与大单竞争。
一颗端侧芯片从立项到规模出货通常需要18–36个月,车规需要3–5年,这期间的成本由设计公司控制不了的上游决定。瑞芯微在三季度业绩预告中提到,存储和阻容涨价、PCB短缺导致终端出货进入调整期、芯片订单延后,并预计未来几个季度上游供应会更紧张。年收入数十亿元的龙头都受到冲击,处于首代产品阶段的初创公司抗风险能力更弱。
三、融资热潮:结构性泡沫与初创公司的困境
1. 资金涌入同一方向
据21世纪经济报道,9月国内近十家端侧AI芯片企业披露融资:地瓜机器人完成4亿美元C轮,微纳核芯完成10亿元C1轮(三维存算一体),光羽芯辰半年累计融资近20亿元(3D堆叠近存),九万里未来科技累计融资超过1亿美元,淬思科技完成超亿元天使轮。据行业汇编,一年之内3D堆叠方向就涌入了思敏威、寒序科技、光本位科技、算苗科技等多家新锐。
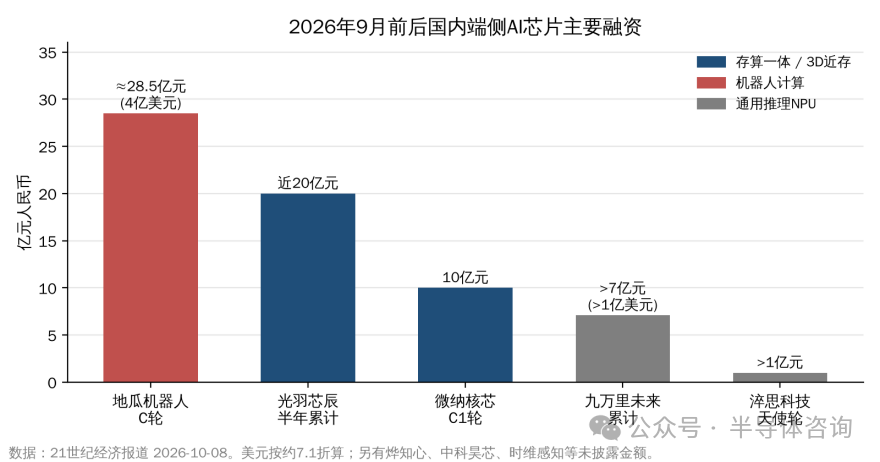
图6 2026年9月前后国内端侧AI芯片主要融资
2. 需求是真的,泡沫在结构
泡沫体现在三个方面:资金集中在同一条尚未收敛的技术路线上;大量项目仍处于流片前或首代样片阶段,没有经过量产和客户复购的检验;估值锚定的是上市公司和港股IPO窗口(2026年一季度港股IPO募资同比增长489%),而不是企业自身的收入。即使是已上市、收入高速增长的爱芯元智,券商仍预测其2026年亏损约10亿元,要到2028年才有望盈利。叠加前文所述的终端缺位,端侧芯片整体市场的扩张速度很可能慢于融资热度所隐含的预期。
3. 盈亏平衡:为什么单靠融资很难成功
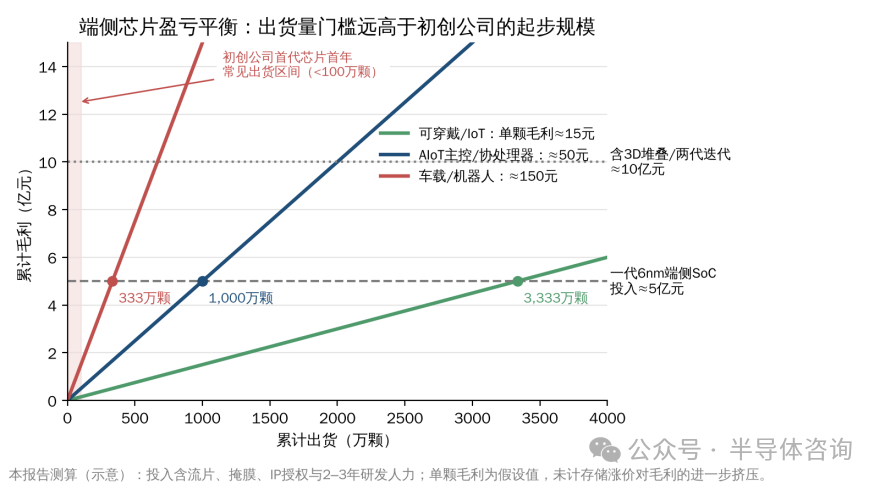
图7 端侧芯片盈亏平衡测算(示意)
以一代6nm端侧SoC总投入约5亿元(含流片、掩膜、IP授权和2–3年研发人力)测算,单颗毛利15元的可穿戴或IoT芯片需要约3300万颗出货才能回本,毛利50元的AIoT主控或协处理器需要约1000万颗,毛利150元的车载或机器人芯片也需要约330万颗;若走3D堆叠路线或需两代迭代,门槛还要翻倍。而初创公司首代芯片首年出货通常在百万颗以内(判断),存储涨价又在压缩下游客户的BoM空间和芯片毛利。融资可以支撑两到三年的研发,却很难支撑跨越数百万颗出货门槛所需的客户导入时间。零跑汽车放弃自研芯片,原因同样是规模不足。我们认为,单靠融资支撑发展的端侧芯片初创公司,成功概率非常低。
4. 洗牌的时间与触发因素
我们预计2027–2028年会出现明显的洗牌。触发因素有三:存储高价和终端下滑持续压缩需求;终端大厂和平台型SoC公司把存算、近存能力做进自家芯片;IPO窗口收窄导致后续融资中断。能够存活的公司大致具备三个特征:有量产定点和客户复购;良率、工具链和编译器经过量产检验;绑定了终端厂、DRAM厂等产业方。上市SoC平台并购初创公司会成为主要的退出路径。(判断)
四、研判
第一,端侧AI的机遇真实,但比数据中心更分散、更慢。需求来自成本、时延、隐私和智能体,增量集中在Agent主机、机器人、汽车和可穿戴;但由于缺少一个足以替代手机的主载体,端侧芯片市场难以复制数据中心那样的爆发式增长,更可能呈现多品类、分阶段的渐进式成长。
第二,相对数据中心,端侧面临的挑战更大。数据中心有明确的付费方、收敛的技术路线和统一的生态;端侧的付费方对价格敏感,终端形态分散,技术路线与工具链碎片化,还要承受数据中心对存储等上游资源的挤压。
第三,技术路线上会经历“协处理器先行、近存跟进、3D堆叠后发”的过程,2026–2027年协处理器在PC、边缘盒子和机器人中放量,3D堆叠的大规模商用取决于本土DRAM和混合键合的成熟度,预计在2028年以后。
第四,车规方面,舱驾一体将在2027–2028年进入放量期,高通仍将领先,本土方案凭成本和本地服务追赶;存算一体和3D近存进入智驾安全关键路径要到2029年以后。
第五,赢家结构由供应链和客户决定,而不是由融资规模决定。赢家更可能是自研芯片的终端大厂、向上延伸的存储与封测企业,以及已有出货和现金流的上市SoC平台;地平线能够做成,也是因为早早绑定了车企客户。融资热潮将在2027–2028年退潮,初创公司更现实的出路是成为大厂的IP或设计服务伙伴、与锚定客户共同投入,或者被并购。
五、建议
芯片设计企业:不押注单一终端,围绕Agent主机、机器人、汽车等单设备价值高的场景布局产品;把每token内存字节数和每瓦token数作为核心指标;优先在成熟工艺上通过架构、压缩和软件栈形成差异化;尽早与DRAM厂、封测厂建立联合开发和长期产能协议。
初创公司与投资方:把量产定点、客户复购和良率作为估值依据,而不是技术路线概念;在立项阶段就绑定锚定客户;对同一路线上的同质化项目保持警惕,提前规划被并购或成为IP、设计服务伙伴的退出路径。
终端厂商与车企:在内存高价周期中,用协处理器和舱驾一体方案降低整机成本;与本土芯片和存储企业建立长期合作,用真实产品负载帮助国产工具链成熟;车企应提前锁定车规存储的长期供应。
存储与封测企业:把定制DRAM和3D堆叠作为差异化业务,与设计公司共建参考设计和标准接口;在混合键合等关键设备上加快国产验证。
产业政策:减少对同一路线的重复补贴,引导资源向具备量产能力的平台集中;推动端侧NPU软件接口和存算一体评价标准的统一,降低生态碎片化;在DRAM和先进封装产能分配上为端侧和车规应用留出稳定份额。
研究跟踪:关注六个信号:全球手机与PC出货的季度变化;AI眼镜、AI耳机等新终端的实际出货;LPDDR5X合约价走势;瑞芯微RK182X和后摩M50的出货与定点;头部车企舱驾一体方案的量产节奏;端侧芯片初创公司的后续融资与并购事件。
说明:文中性能、出货与融资数据多为公司自述或媒体转引,未经独立核实;标注“(判断)”和“示意”的内容为本报告基于公开信息的推断与测算,仅供业内交流参考。