ARTICLE · 1247934
AI基础常识:为什么特征可视化有助于理解黑盒?
一张照片被神经网络认成了猫。
我们知道照片里有什么,也知道模型最后输出了「猫」,却很难回答那个真正重要的问题:它究竟看到了什么,才做出这个判断?
是尖尖的耳朵?圆圆的眼睛?毛发的纹理?身体的轮廓?还是照片背景里某种与猫经常同时出现的东西?
对人来说,「因为它有胡须、有耳朵、身上长毛,所以它像猫」似乎是很自然的解释。对神经网络来说,事情却没有这么简单。它并不是按照人类熟悉的概念,一步一步读懂一张图片。数百万个参数在不同层级上共同作用,最后给出一个结果。我们能够看到输入,也能够看到输出,却看不清中间发生了什么。
这就是所谓的「黑盒」。
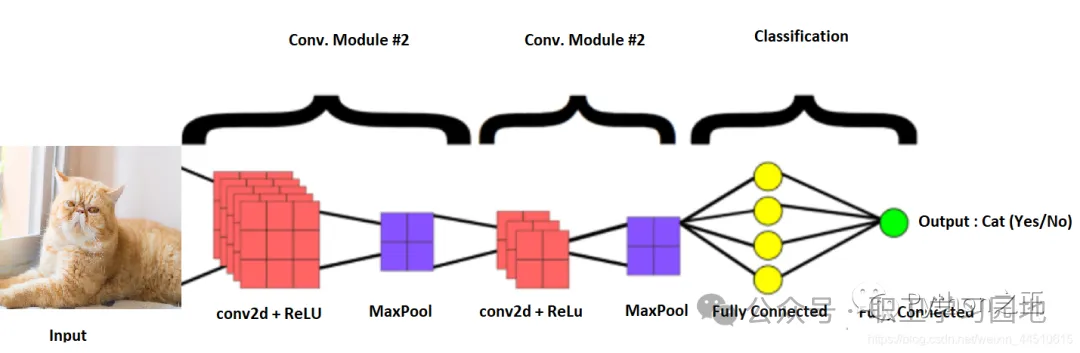
特征可视化提供了一种理解黑盒的办法。它不直接要求模型用人话解释自己,而是换了一个问题:
这个问题看似只是把图片「做出来」,实际上改变了我们研究神经网络的方式。
面对一个错误结果,人们常常会先看输入图片。
比如,一张哈士奇被模型认成了狼。研究者可能会使用热力图,观察图片中哪些区域对最终判断影响最大。结果发现,模型特别关注了狗身后的雪地。
这说明模型可能没有真正识别狗的形状,而是把「雪地」当成了「狼」的线索。
这种方法很有用,但它主要回答的是:
特征可视化关注的问题更进一步:
假设神经网络中有一个目标单元,它接收图片后会产生一个激活值。激活值越高,说明这个单元对当前输入越敏感。特征可视化所做的事情,就是不断修改输入,让这个目标单元尽可能兴奋。
用公式表示,就是寻找一个输入,使目标单元的激活达到最大:
这里,模型本身没有被修改,修改的是输入。算法从一片随机噪声,或者一张普通图片开始,根据梯度一点点调整像素,让目标单元的响应越来越强。经过多轮优化,最终得到一幅能够最大程度激活该单元的图像。
这幅图不一定是现实中存在的照片,也不一定是模型训练时见过的对象。它更像是模型内部某种功能的「极限样本」:如果把某种形状、纹理和结构推到足够明显,目标单元就会被强烈激活。
于是,一个原本只表现为「第十七层第四十二个单元、激活值为八点七三」的数字,开始具有了某种可以观察的外形。
它可能偏好一组弯曲的线条,也可能对重复纹理敏感;可能喜欢类似眼睛的圆形结构,也可能对某种物体和背景的组合产生反应。
神经网络内部的数值没有因此变成人类语言,但它获得了一个可以被比较、讨论和进一步检验的入口。
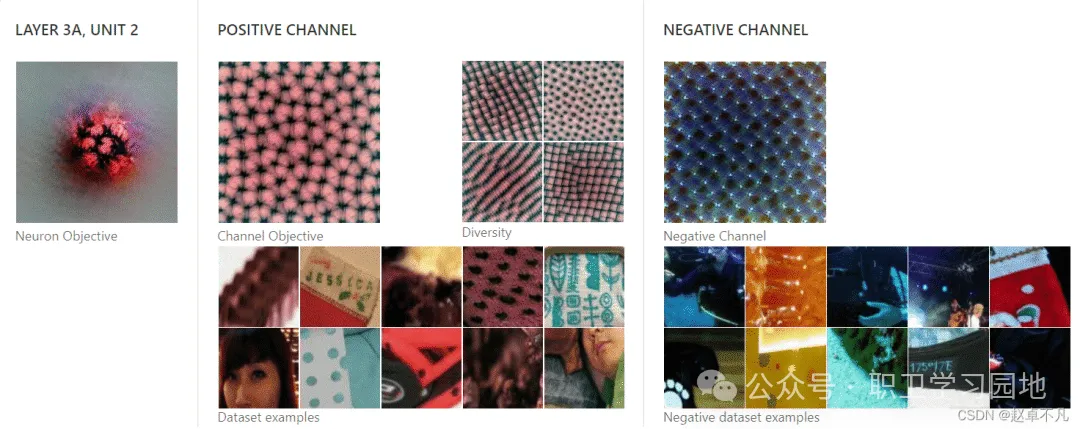
神经网络并不是一开始就理解「猫」「汽车」或「人脸」。
在视觉网络中,靠近输入的浅层通常更容易检测到简单的视觉变化,例如边缘、方向、颜色变化和局部纹理。再往深处,网络开始把这些简单结构组合起来,形成更加复杂的纹理、局部部件和物体形状。靠近输出的深层,则可能与完整物体或类别判断产生更直接的联系。
特征可视化让我们能够把不同层的结果放在一起观察。
浅层可能偏好斜向边缘;中间层可能把这些边缘组合成弧线;再往深处,弧线、颜色和纹理可能共同形成类似眼睛、车轮或动物耳朵的结构。更高层则可能把眼睛、耳朵和毛发纹理整合起来,形成对某种动物的判断。
这有点像观察一座建筑从地基到屋顶逐渐成形。最底层并不知道自己最后要建成一座房子,它只负责处理砖块、钢筋和连接方式;中间层开始构造房间与楼层;到了更高层,局部结构才共同显现出整体形状。
当然,神经网络并不一定如此整齐。它不是一条严格的流水线,许多特征会被不同模块重复使用,也可能在不同情境中承担不同作用。一个检测边缘的单元,未必只服务于一种物体;一种纹理,也可能同时参与多个类别的判断。
但可视化至少让我们有机会看到:抽象不是凭空出现的,而是由大量低层模式逐步组合出来的。
所谓「模型理解了猫」,可能并不是某个地方藏着一个完整的「猫」字样,而是许多视觉特征在不同层次上彼此连接,最终形成了一个能够支持「猫」这一判断的结构。
假设我们观察到,某个神经元在大量「狗和网球」的图片中都很活跃。
我们能不能因此说,这个神经元专门识别狗?
不能。
它可能识别的是狗,也可能识别的是网球,还可能识别的是「狗和网球一起出现」的场景。甚至,它只是在识别一种特定的颜色搭配、构图方式或背景纹理。
现实世界中的事物经常一起出现。海滩上有沙子,沙子旁边常有海;足球场上有草地,草地上常有球员。如果模型反复看到这些搭配,就可能学会利用其中一个并不可靠的线索。
这正是相关性和机制之间的差别。
特征可视化的作用,是让研究者能够主动拆分这些因素。我们可以保持物体的形状不变,只改变颜色;可以保留背景,替换主体;可以保留纹理,改变位置;也可以去掉某个局部结构,观察目标单元的激活是否下降。
如果把狗替换成猫,目标单元仍然保持高激活,那么「它识别狗」的解释就需要降低权重。如果只保留狗的轮廓,去掉雪地背景之后,激活依然很高,我们才有更多理由认为,轮廓可能是这个单元真正关注的因素。
于是,研究过程不再只是观察模型「碰巧」对什么有反应,而是可以有意识地改变输入,再观察内部活动如何变化:
这里最关键的不是得到一张「看起来像某种东西」的图,而是把图像变成一个可以继续验证的猜想。
特征可视化不是在告诉我们:「这个神经元就是猫。」
它更像是在说:
人很容易把神经网络中的单个神经元,想象成大脑里的一个「概念按钮」。
看到一个神经元的可视化结果很像眼睛,我们就想说:「这是眼睛神经元。」看到另一个结果很像车轮,我们就想说:「这是车轮神经元。」
这种理解有时过于简单。
神经网络中的一个单元,可能同时对眼睛、车轮、圆形纹理以及某种特定角度的边缘产生响应。它未必只承担一种功能,也未必能够被一个自然语言词语完整概括。
这种现象通常被称为多义性:一个单元在不同上下文中表现出多种含义。更进一步,当模型需要在有限的神经元空间中表示大量特征时,不同特征还可能被压缩到相同的方向或相近的活动模式中,这类现象常被称为超位或特征叠加。
因此,一张最大激活图不能被直接当作最终答案。
如果一幅图同时出现了眼睛、车轮和旋涡状纹理,我们不能立刻断言:「这个神经元识别车轮。」更谨慎的说法是:
研究者需要从一次可视化转向一组可重复的实验。从不同随机起点开始优化,结果是否相似?只在局部区域中优化,目标模式还会出现吗?去掉某个局部结构后,激活是否显著下降?把颜色、位置或背景换掉之后,目标单元是否依然响应?
当可视化结果、真实样本和干预实验彼此支持时,我们才更接近一个可靠的解释。
特征可视化最初的问题是:这个神经元看起来像什么?
但更重要的问题是:这个特征在模型中究竟发挥了什么作用?
一个单元可能确实对车轮纹理敏感,但这不代表模型依赖它来判断「汽车」。它可能只是被多个类别共同使用的一种视觉信号,也可能只是模型内部的一条旁路。
理解一个特征,至少要经过三个层次。
例如,研究者发现某个通道对眼睛状结构有高激活。进一步观察发现,它在猫和狗的图片中都会被激活。再往后追踪,这个通道的输出会被下一层用于判断动物面部区域。当研究者抑制它时,模型对动物类别的识别明显下降,但对背景类别几乎没有影响。
这时,把它简单称作「眼睛检测器」仍然不够准确。更严谨的描述可能是:
后一个说法没有前一个说法简洁,却更接近神经网络真实的工作方式。
因为模型中的功能通常不是由某一个神经元单独完成的,而是由一组特征、连接和中间步骤共同完成的。研究者因此开始从单个神经元转向更大的「特征电路」,试图理解某种能力是如何沿着多个层级传递和组合起来的。
从这个角度看:
「黑盒」这个词很容易让人误以为,神经网络内部完全没有结构。
更准确的说法是:神经网络内部存在大量结构,但这些结构过于复杂,无法直接用人类熟悉的规则表达。
特征可视化并没有把黑盒变成透明玻璃。它做的事情更像是在黑盒上开出了一些观察孔,让我们能够提出更具体的问题。
原本我们只能看到:
有了特征可视化之后,我们可以开始追踪:
这条路径仍然不完整,却比直接面对一大片参数矩阵更接近可以检验的解释。
研究者可以进一步追问:某个特征是否只在特定位置出现?它能否被另一个特征替代?移除它之后,模型会失去什么能力?它识别的是目标本身,还是目标与背景之间的偶然联系?
这些问题都不一定能够通过一张图片解决,但一张图片可能让问题第一次变得清晰。
这就是特征可视化最重要的贡献:它把「模型似乎这样做」推进为「我们可以设计实验,检验模型是否确实这样做」。
特征可视化也有自己的陷阱。
为了让目标单元的激活最大,优化算法可能生成一些人眼难以识别的纹理。研究者通常会加入平滑、去噪或自然图像先验,使结果更容易阅读。但这些处理也可能把研究者预先设定的偏好带入图像之中。
如果完全不加约束,结果可能充满噪声;如果加入太强的约束,结果虽然更加漂亮,却未必更加忠实于模型。
因此,特征可视化呈现的并不是「模型脑中原封不动的一张图片」,而是三种因素共同作用的结果:
看到一幅像眼睛的图,只能说明这类结构能够激活目标单元,不能直接推出该单元拥有类似人类的「眼睛概念」。
更可靠的解释需要逐步增加证据强度。
首先,我们可以说某种图案在多次优化中反复出现。接着,可以观察它是否与真实样本中的激活相关。再进一步,改变或遮挡这个图案,看目标单元是否稳定变化。最后,还要确认这种变化是否会沿着网络传递,并影响模型的最终判断。
也就是说,可视化通常提供的是研究的入口,而不是研究的终点。
一个模型在某类图片中反复激活某个特征,并不意味着这个特征就是它做出判断的真正原因。
它可能只是一个伴随信号。模型的最终决策,可能由其他特征完成;也可能只有在特定背景、特定位置和特定类别竞争关系下,这个特征才发挥作用。
因此,研究特征时,不能只问:
还要问:
这也是为什么机制可解释性不能停留在「给神经元命名」。命名能够帮助人交流,却不能替代因果检验。
一个可靠的解释,应当能够说明:某种特征如何被提取,如何与其他特征组合,如何影响后续模块,以及这条路径为什么会使模型产生最终输出。
当我们真正开始干预模型,而不只是观看模型时,黑盒研究才从图像描述进入机制分析。
特征可视化之所以有助于理解黑盒,并不是因为它能把神经网络变成人类可以直接阅读的说明书。
它的价值在于,把原本不可见的内部活动,转换成了可以观察、比较和干预的对象。
我们因此有机会看到,网络不同层级可能处理什么样的模式;一个判断可能由哪些中间特征逐步组成;模型是否真正识别了目标,还是利用了背景和偶然线索;一个神经元为什么不能简单等同于一个概念;复杂能力为什么更可能存在于特征之间的组合和电路之中。
但真正可靠的解释,不能停留在「这张图看起来像什么」。
它还必须继续追问:
所以,特征可视化更准确的定位,不是「黑盒解释器」,而是黑盒研究的实验起点。
它并没有让神经网络立刻变得透明,却让我们能够从一团难以阅读的参数中,逐步找出特征、关系和机制。
而理解黑盒,往往正是从这样一个看似朴素的问题开始的: