ARTICLE · 1258476
2030年有望破百万台!人形机器人AI加速器迎来高速增长周期
人形机器人算力迎来爆发式增长周期
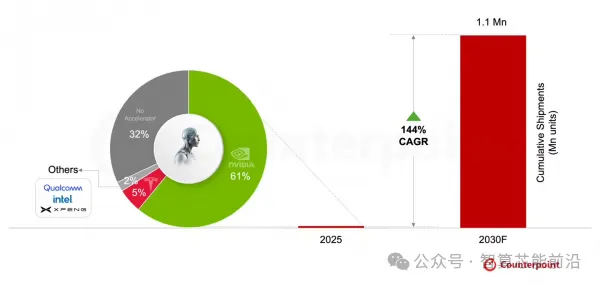
随着具身智能技术持续落地,人形机器人的硬件竞争重心,正逐步落到AI加速器这一核心计算单元上。市场研究机构Counterpoint Research最新发布的全球人形机器人追踪报告,给出了行业未来几年的增长预期。报告测算,到2030年,全球人形机器人AI加速器累计出货量将突破100万台,2026至2030年复合年增长率CAGR达到144%。这样的增长幅度,也直观反映出整个产业正从原型研发,向着规模化落地快速推进。
两大计算架构并行发展
从底层计算架构来看,视觉‑语言‑行动VLA模型和世界模型不断融合迭代,GPU依旧是现阶段人形机器人算力的主流选择。对于复杂的具身大模型部署,GPU能够提供充足的通用计算能力,适配各类模型迭代调试需求。
与此同时AI ASIC专用集成电路正在快速成长。不少具备整车自研能力的企业,开始把汽车行业沉淀下来的芯片研发经验迁移到人形机器人项目。这类垂直整合模式,希望借助已有的软硬件积累,打造适配机器人场景的专用算力硬件,和通用GPU形成差异化竞争。未来行业不会出现单一技术一统天下的局面,多种计算架构共存将成为长期趋势。
海外芯片厂商的市场布局
英伟达依靠算力芯片、AI模型、仿真工具搭建起完整全栈体系,牢牢占据人形机器人GPU市场的主要份额。目前这家企业已经和全球多家头部人形机器人本体企业建立深度合作,合作名单涵盖智元机器人、宇树科技、优必选、Figure AI等海内外多家企业,为各类机器人开发项目提供算力底座支持。
高通选择以异构计算方案切入赛道,产品侧重点放在运行能效以及物料成本BoM控制层面,希望以更低功耗适配机器人端侧的严苛硬件条件。高通已经和多家机器人企业完成设计层面合作,但从出货规模来看,和英伟达之间还存在不小差距。
Counterpoint首席分析师Soumen Mandal分析,机器人AI模型从VLA向着世界行动模型WAM不断演进,机器人机身内部空间有限,散热条件受到约束,专用芯片在低功耗、高能效层面的优势,价值会进一步凸显出来。
该机构副总监Ethan Qi也提到,现阶段想要运行高性能的具身模型,GPU依旧是端侧部署的优选方案。而特斯拉这类拥有整车研发背景的企业,会成为AI ASIC架构重要的推动力量。预计到2027年之后,一批面向AGI负载的新一代AI加速器实现量产,整个市场的竞争激烈程度还会进一步升级。
车企入局重塑算力竞争格局
特斯拉与小鹏汽车代表的车企阵营,正在走出一条垂直整合路线。汽车制造工艺积累、自研芯片技术、专属AI模型,加上软硬件一体化开发能力,构成他们参与人形机器人算力竞争的核心底牌。车企过往在自动驾驶领域打磨的感知、控制技术,能够直接复用在机器人身上,这也让他们有机会改写AI加速器市场的竞争版图。
国内算力生态持续完善
国内赛道同样有新力量崛起,从地平线拆分出来的D‑Robotics地瓜机器人,已经和乐聚机器人、LIMX Dynamics等本土机器人厂商达成合作。其推出RDK S100算控一体化开发套件,采用CPU+BPU+MCU组合架构,搭载基于Nash架构、算力80TOPS的BPU神经网络处理单元。这套方案意在补齐本土机器人算控环节,持续强化国内人形机器人算力生态自主化建设,为本土机器人开发者提供可用的硬件开发底座。
整体来看,人形机器人算力市场还处在发展早期。通用GPU保障前期研发迭代,自研ASIC追求端侧落地的功耗成本优势,海外芯片大厂、车企、本土算力企业多方同台,接下来几年,算力硬件的迭代速度,也会直接影响人形机器人商业化落地的实际进程。
(智算芯能前沿网综合)