ARTICLE · 1258594
OpenClaw 私有化部署:让 AI 助手真正住进你的内网
OpenClaw 私有化部署:让 AI 助手真正住进你的内网
有个问题,我这两年听到的次数多到已经不用猜了。
一个二十来人的技术团队,想把 AI 助手用起来。试了几个月,最后卡在同一个地方:数据不能出内网。
不是不想用,是过不了自己那关。你把客户名单、故障工单、内部架构图发给公网的模型,问一句「帮我总结下」,那一刻其实已经把公司最不该外流的东西送出去了。就算服务商承诺不用你的数据训练,这条链路本身仍然存在——数据出过域,就是出过域。
于是很多人做了折中:敏感的不问,能问的不敏感。结果助手变成了一个只能聊天气和写周报的玩具。
今天这篇讲一个不同的解法:把整套东西搬到你自己机房里。
——◆——
一、先说什么叫「私有化」
这个词被用滥了。有人管「买了 SaaS 的独享实例」叫私有化,有人管「数据存在国内节点」叫私有化。
我这里说的私有化,定义很窄:
所有组件运行在客户自己的服务器上,对话内容、记忆数据、模型调用全部不出内网。
不是独享实例,不是国内节点,不是「承诺不用于训练」。是物理上不出你的网络边界。
这套东西叫 OpenClaw,是一个本地优先的智能体平台。它现在已经在一套真实环境里跑着,不是 PPT 上的架构。下面这张图是实测出来的部署拓扑:
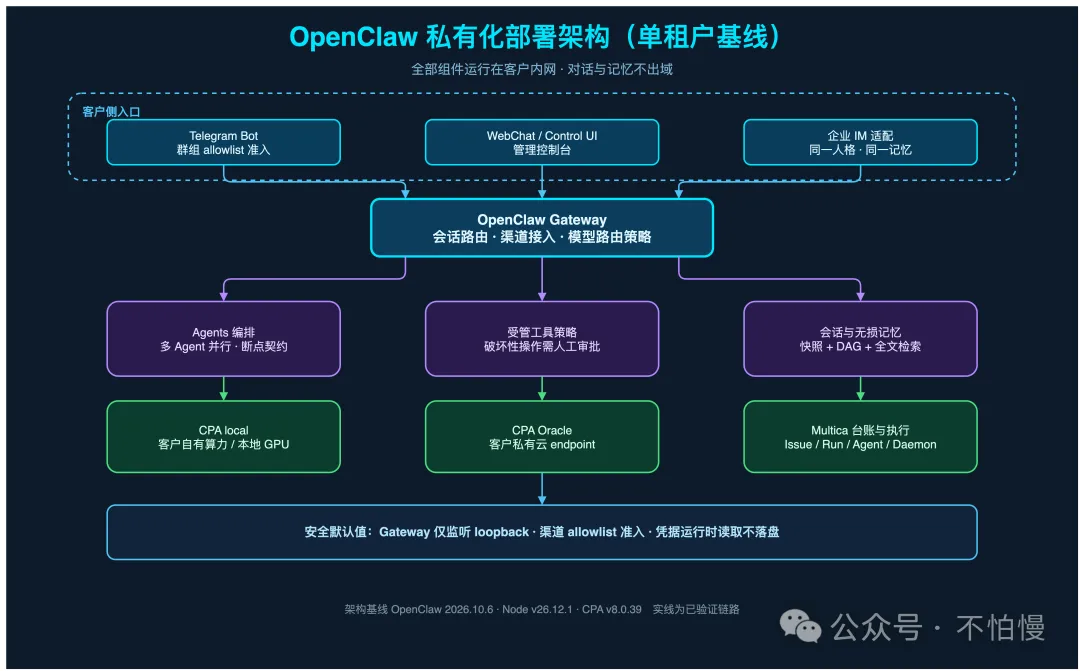
OpenClaw 私有化部署架构
从上往下看,链路是这样的:
• 客户侧入口是各种消息渠道——Telegram、WebChat 控制台、企业 IM 适配。不同渠道进来,但你面对的是同一个助手、同一份记忆;
• 中间是 Gateway,负责会话路由、渠道接入、模型路由策略。它默认只监听 127.0.0.1,也就是说公网根本连不上它;
• 往下一层是能力层:Agent 编排、受管工具策略、会话与无损记忆;
• 最底是算力层:CPA local 接你自己的本地 GPU,CPA Oracle 接你自己的私有云 endpoint,外加 Multica 做任务台账。
整条链路里,没有任何一个组件需要向外发起请求。
——◆——
二、这套东西到底解决什么问题
我不喜欢讲功能列表,讲四个真实会痛的地方。
2.1 数据不出域,而且不是靠承诺
很多产品的私有化是「给你单独开一个实例」,数据仍然在厂商机房。这个不是。
Gateway 的监听地址是 loopback,意味着它压根没打算对外服务。远程访问走的是受控通道(比如 Tailscale Serve),不是把端口暴露到公网。渠道准入默认是白名单——DM 只允许 owner,群组只允许登记过的群组,陌生人发消息进来不会触发回复。
凭据的处理方式也值得说一句:运行时读取,不落盘。配置文件里是脱敏模板,真实密钥单独密封交接,不进任何文档。
这条对做安全评审的人很重要。你去过等保或者内部安全评审就知道,「密钥写在配置文件里」是一个必然会被挑出来的问题。
2.2 自有算力,不再按 token 计费
这一点是很多团队最在意的。
如果你已经有本地 GPU,或者有私有云额度,OpenClaw 可以直接把它们接成模型 provider。调用发生在你自己的机器上,按 token 计费这件事就不存在了。
那为什么还要留一个「私有云 endpoint」的选项?因为现实里算力往往不够。本地 GPU 跑得动小模型,但复杂推理吃力。所以架构上做了两档:简单任务走本地,复杂任务走你私有云上的更强模型。两档都在你的资源边界内,只是成本结构不同。
这里必须加一句诚实的提醒:本地小模型的能力是有上限的。长上下文推理、复杂代码生成这类任务,本地模型的输出质量不如顶级云端模型,这是事实。所以架构上保留了升级开关,而不是假装本地算力能解决一切。
2.3 记忆不丢,而且能回溯到原文
这是我认为最被低估的一块。
大部分 AI 助手的长对话是这么处理的:聊到一定长度,把前面的内容压缩成一段摘要,继续往下聊。问题在于——压缩是不可逆的。摘要里没写进去的细节,永久消失了。你上周跟它确认过的那个接口字段名,这周问它,它编一个给你。
OpenClaw 的做法不一样:快照 + DAG + 全文检索。记忆被分层保存,需要细节时可以沿着引用链展开回原文。
差别在哪?前者是「我记得你说过大概是这样」,后者是「你说过这句,原话在这里」。
对做技术支持、做运维、做客户对接的人来说,这个差别是决定性的。
2.4 破坏性操作要人点头
这条是我个人最看重的。
一个能读文件、能执行命令、能改配置的助手,本质上是一个有权限的进程。你跟它说「清理一下日志」,它理解成 rm -rf 某个目录,这个风险是真实存在的。
所以 OpenClaw 里有一条硬约束:纯读操作放行,外部写和破坏性操作需要审批。审批不是弹个窗点一下完事,是有调用审计日志的——谁在什么时间让助手做了什么,有记录。
这条设计背后的判断是:AI 助手的价值在于效率,但效率不能以「不可控」为代价。宁可慢一步,也不要出一个无法追溯的事故。
——◆——
三、私有化交付到底交付什么
这是客户问得最多的问题,也是最容易含糊的地方。
我把它拆成四个阶段,每个阶段有明确的产出物:
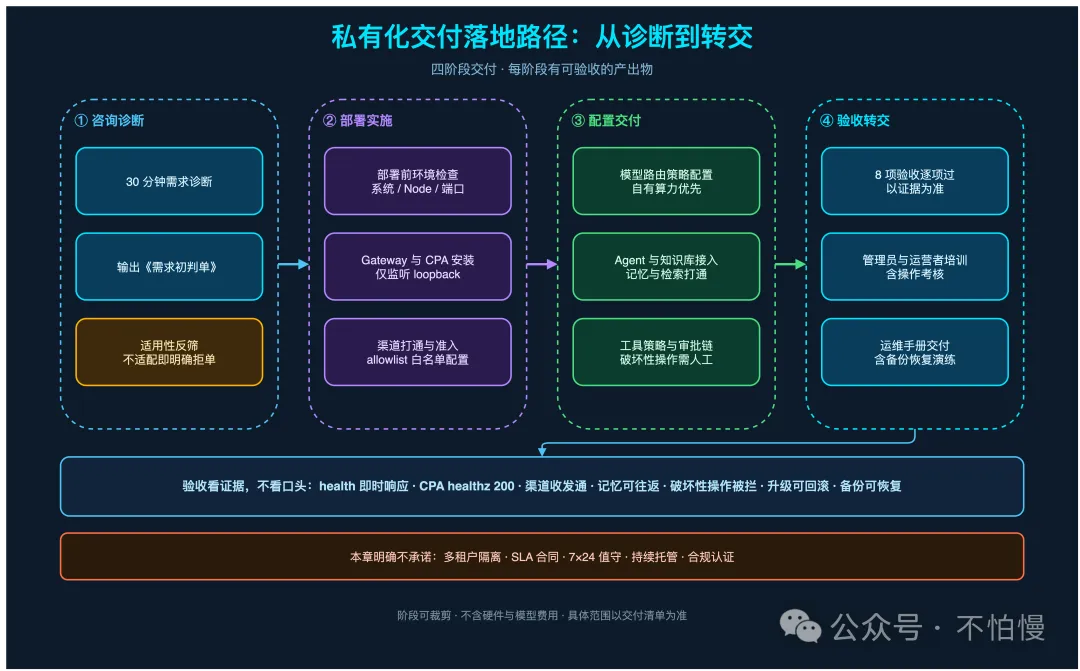
私有化交付落地路径
阶段一:咨询诊断
先聊 30 分钟,不是销售话术,是搞清楚三件事:
1. 你的数据敏感到什么程度?(决定部署形态)
2. 你手上有什么算力?(决定模型路由方案)
3. 你有几个人能维护它?(决定交付深度)
聊完输出一份《需求初判单》。这个阶段有个不太讨喜的环节:适用性反筛。
如果你的需求是「多租户隔离、按租户计费」,那是 SaaS 平台该干的事,这套方案不做。 如果你要「SLA 合同 + 7×24 人工值守」,当前没有这个资源,也做不了。 如果你必须过 SOC2、GDPR、HIPAA 这类认证,现在没有,别浪费彼此时间。
明确拒单比含糊接单负责任。 一个装完发现不合适再回滚的项目,对双方都是损失。
阶段二:部署实施
环境检查 → 安装 Gateway 与 CPA → 打通渠道与准入配置。
环境检查这一步别跳过。Node 版本、端口占用、系统依赖,任何一项不对,后面全是连环坑。我们踩过的坑包括:端口被旧进程占着、系统时区导致的定时任务错乱、磁盘空间不够导致记忆库写入失败。这些在检查清单里都有。
阶段三:配置交付
模型路由策略、Agent 与知识库接入、工具策略与审批链。
这一步工作量最大,也最依赖客户的具体场景。同样一套 OpenClaw,配成一个客服助手和配成一个运维助手,配置差异很大——知识库结构不同、工具权限不同、审批策略不同。
阶段四:验收转交
验收按 8 项逐条过,看证据,不看口头:
然后是培训和文档:管理员培训、运营者培训(含操作考核)、运维手册交付,以及一次备份恢复演练。
演练这件事我要强调一下。 很多交付到「配置了备份」就结束了,但备份能不能恢复是两码事。没演练过的备份,不叫备份,叫心理安慰。
——◆——
四、技术底座长什么样
给关心实现的人一段。不关心可以跳过。
加上渠道层、受管工具策略、审计日志,构成完整闭环。
一个细节:这套架构在真实生产环境里跑着 45 个 Agent,不是实验室环境。事件循环延迟、内存占用、进程泄漏这些指标都有实测基线。私有化交付的稳定性判断基于这套运行数据,不是理论推演。
——◆——
五、什么样的团队适合
说适合之前,先说不适合。这一节比前面所有内容都重要。
明确不适合的六种情况
① 需要一个多租户 SaaS 平台 当前是单租户基线,没有租户隔离、没有计费引擎。你要做的是对外卖账号的生意,这套方案帮不上。
② 要求 SLA 合同和 7×24 人工值守 没有这个资源,也不打算承诺做不到的事。如果停机一小时对你是重大事故,需要的是有运维团队托底的服务商。
③ 必须通过强合规认证 SOC2、GDPR、HIPAA、等保、密评——这些认证目前都没有。受监管行业(金融、医疗)请先确认合规路径,不要指望技术方案绕过去。
④ 没有任何运维资源 「装完就再也不用管」是做不到的。Gateway 需要健康巡检,CPA 需要探活,升级需要有人跟。至少要有一个能看懂日志的人。
⑤ 只是想免费尝鲜 社区版是开源免费的,自己部署就行,不用走私有化流程。
⑥ 期望模型效果对标顶级云端模型 本地算力的模型能力有客观上限。如果你的场景对输出质量要求极高,用本地小模型会失望。
真正适合的三种团队
A. 数据主权敏感的中小科技企业(20–100 人,有自有算力) 内部研发资料、客户数据、架构文档不能出内网,但团队确实需要 AI 提效。
B. 多渠道运营的小团队(5–30 人) Telegram、企业 IM、网页客服各挂一个 bot,每个都记不住上下文。需要统一人格、统一记忆。
C. 有专职运维的政企内网部门 必须内网部署、模型不出域,且有 1–2 人能承担日常巡检。
——◆——
六、如果你正在评估,建议这么走
不要一上来就问「多少钱」。先回答三个问题:
1. 数据敏感级别是什么?决定能不能用云、要不要全内网。
2. 算力现状是什么?有没有本地 GPU,有多少显存,跑什么模型。
3. 谁来维护?有没有人能看懂 Gateway 日志和 health 输出。
这三个问题答清楚,方案形态基本就定了。
然后走一遍诊断。30 分钟,输出《需求初判单》,包含:适配判断、建议套餐形态、交付周期预估、需要你方准备的前置条件。
诊断是免费的,拒单也是明确的。 如果聊完发现不合适,我会直接说,不绕弯子。
——◆——
写在最后
私有化这件事,本质上是把「信任」从承诺变成结构。
云服务的信任基础是合同和品牌——我承诺不用你的数据训练。私有化的信任基础是网络边界——数据物理上没出去过。
两者没有绝对的高下,取决于你在什么行业、面对什么数据、承担什么责任。但对相当一部分团队来说,后者才是能过评审的那一个。
如果你正卡在「想用 AI 但数据不能出内网」这个点上,欢迎聊聊。哪怕最后不合适,把边界聊清楚也是有价值的。
——◆——
📋 不适用客户自检清单
在联系我们之前,请先自查。命中任意一条,建议直接跳过私有化方案:
• [ ] 需要多租户隔离、按租户计费
• [ ] 要求 SLA 合同、7×24 人工值守
• [ ] 必须通过 SOC2 / GDPR / HIPAA / 等保 / 密评
• [ ] 团队里没有任何人能承担运维巡检
• [ ] 期望「装完即用、永久免维护」
• [ ] 要求本地模型效果对标顶级云端模型
• [ ] 只是想免费试用(请直接用开源社区版)
全部未命中,且属于下列之一,欢迎进一步沟通:
• [ ] 数据/记忆不能出内网,有自有算力
• [ ] 多渠道需要统一人格与统一记忆
• [ ] 有 1–2 人可承担日常巡检
——◆——
延伸阅读:
• OpenClaw 私有化产品手册(能力边界、三档交付包、验收口径)
• OpenClaw 私有化架构设计(部署拓扑、数据流、安全边界、故障恢复)
• OpenClaw 私有化运维手册(部署前检查、健康巡检、备份恢复、密钥轮换)
——◆——
你所在的公司,现在是怎么处理「想用 AI 但数据不能出内网」这个矛盾的?留言说说你们的实际做法,或者卡在哪一步,一起交流 👇
——◆——
🤔 互动话题
关于OpenClaw 私有化部署,你有什么踩坑经历或心得?评论区聊聊~
📖 阅读原文 👈 底部查看
👍 点赞 + 在看 + 转发 是对我最大的支持!
本文首发于「不怕慢」