ARTICLE · 1266140
那些「不值得开发」的工厂需求,正在被 AI 激活
我们在工厂跑了 3 个月,发现一个很反常识的事:
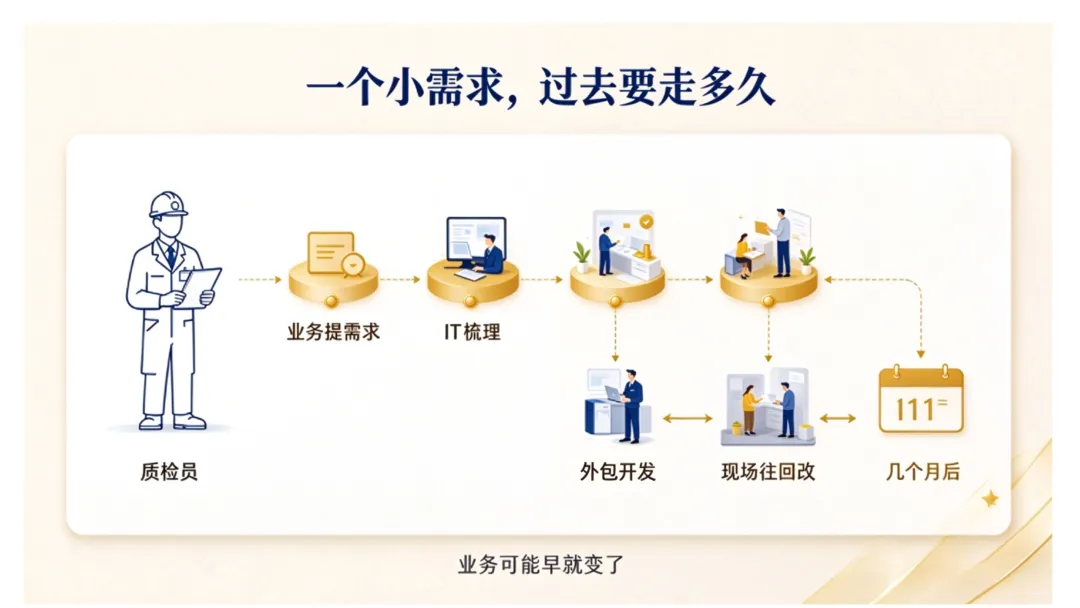
工厂里一个质检员想加一张自定义报表,要走多长的路?
业务部门提需求、IT 部门梳理、外部团队开发、现场来回改 ——几个月后系统上线,业务早就变了。
至于那些更小、更碎的需求:设备的一个临时提醒、某道工序的一次工艺分析、一条产线的质量追溯 —— 它们甚至走不上流程,因为「单独做个系统,不划算」。
AI 正在改变这件事。当需求文档可以直接驱动原型生成,当开发周期从「月」压缩到「天」,那些长期被搁置的长尾需求,第一次具备了落地的条件。
但真正决定成败的,不是 AI 写代码有多快,而是它能不能「懂这个厂」。
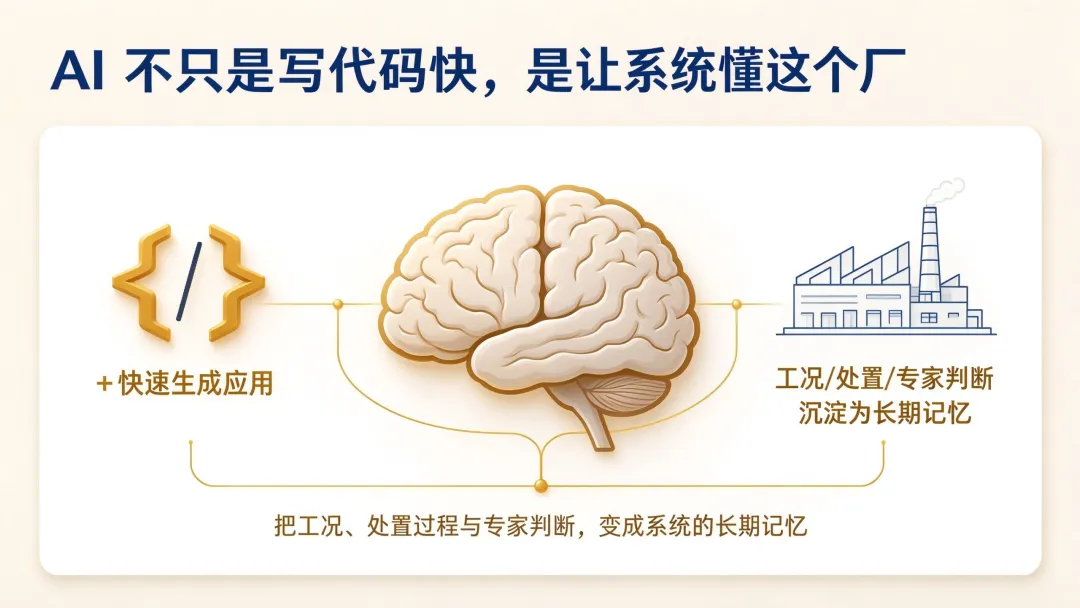
核心观点 工业 AI 的长期价值,不只在于更快生成应用,而在于把工况、处置过程与专家判断沉淀为长期记忆,让系统真正「懂这个厂」。
01|不是没需求,是过去不划算
小白解读
什么是「长尾需求」?就像电商平台,卖得最好的是少数爆款(头部),但海量小众商品加起来销量同样惊人(长尾)。
工厂里的数字化需求也一样:MES、ERP 是「爆款」,值得花几百万定制;而「给这台设备加个异常提醒」这类小需求,就是长尾——单个不大,加起来满地都是。
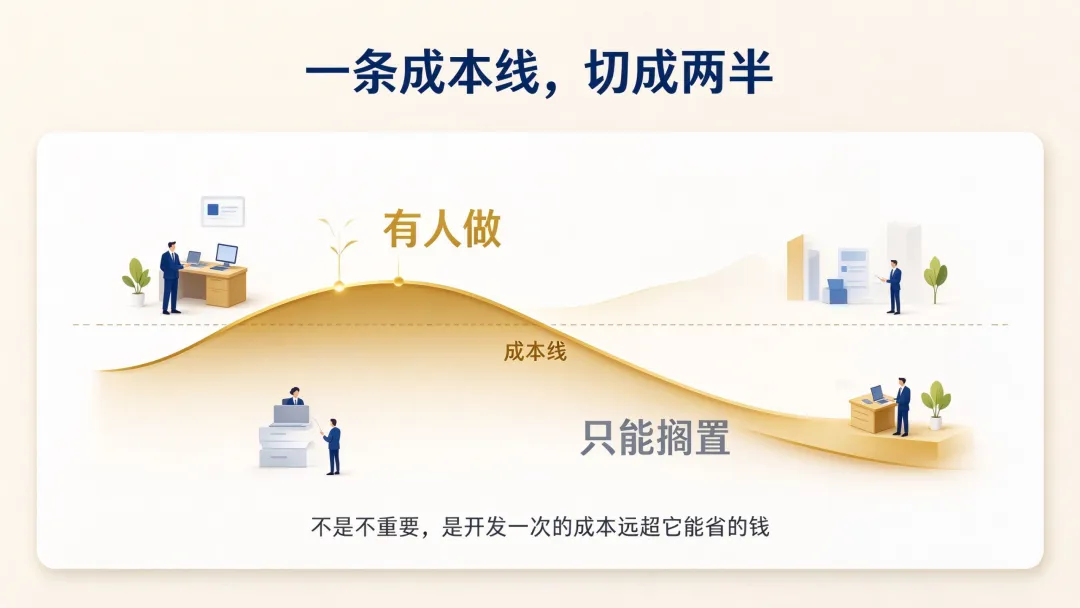
工业数字化的需求分布,是一条典型的长尾曲线:头部是大系统,价值密度高,值得重金投入;往后走,是海量的小场景——碎、杂、变化快,单拎出来每一个都不大,加起来却是工厂日常运转的真实痛点。
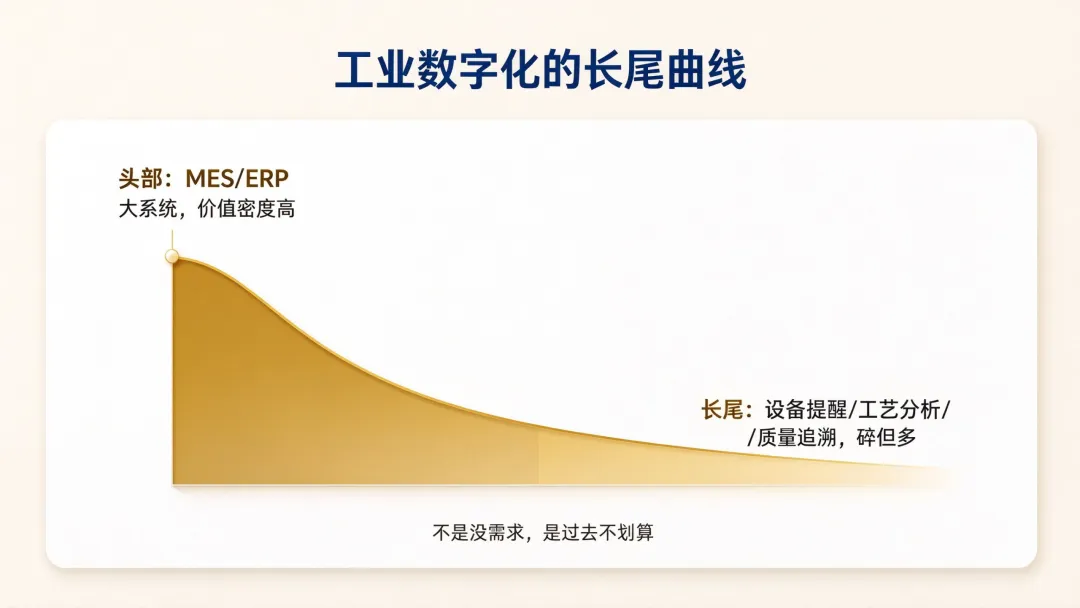
过去,这条曲线被一条「成本线」切成两半:线以上的需求有人做,线以下的只能搁置——不是不重要,是开发一次的成本远超它能省的钱。
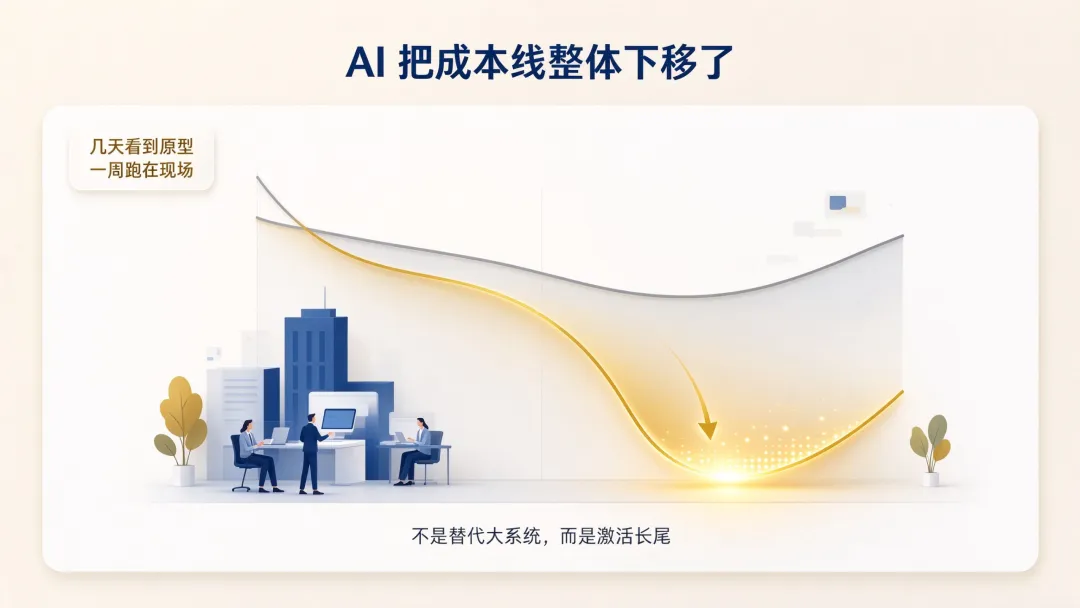
AI 把成本线整体下移了。一份清晰的需求描述,几十分钟就能看到可操作的系统原型,一周左右就能跑在现场。
当「试试看」的成本足够低,质量追溯、设备监控、工艺小分析这些碎片化需求,从「不值得做」变成了「顺手就做」。这才是 AI 对工业软件最实在的冲击——不是替代大系统,而是激活长尾。
02|真正的门槛不在代码,在「懂这个厂」
代码变得便宜之后,一个更深的问题浮出水面:AI 可以很快写出一个应用,但它懂这家工厂吗?
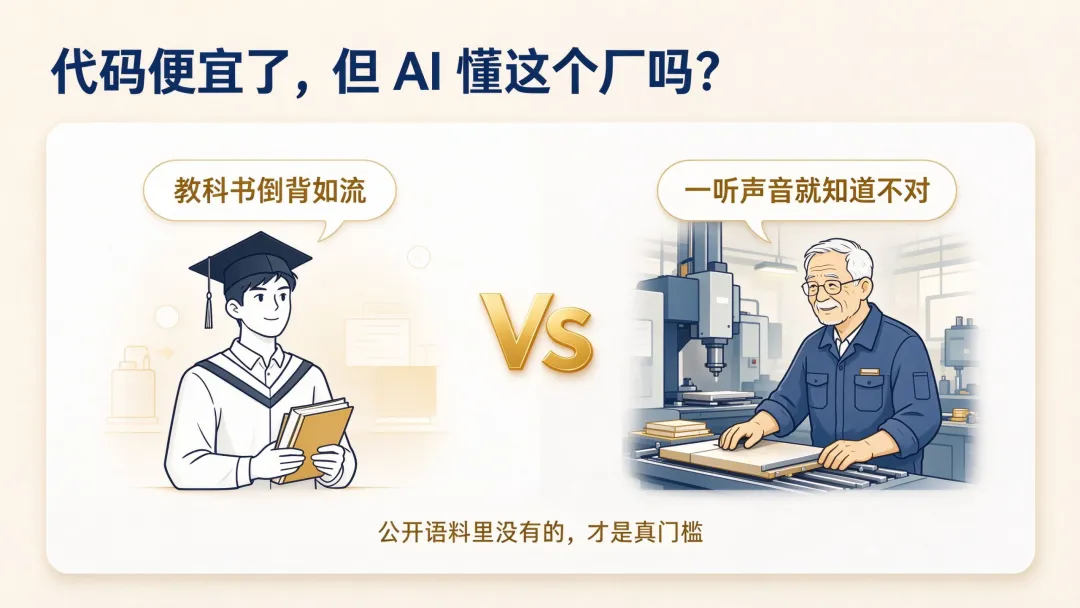
打个比方:今天的大模型像一个名校刚毕业的高材生——教科书倒背如流,行业标准张口就来。但一进车间就露怯:这台设备特有的诊断流程、写在作业指导书里的工艺路线、老师傅一听就知道「声音不对劲」的经验——这些它一概不知,因为公开语料里根本没有。
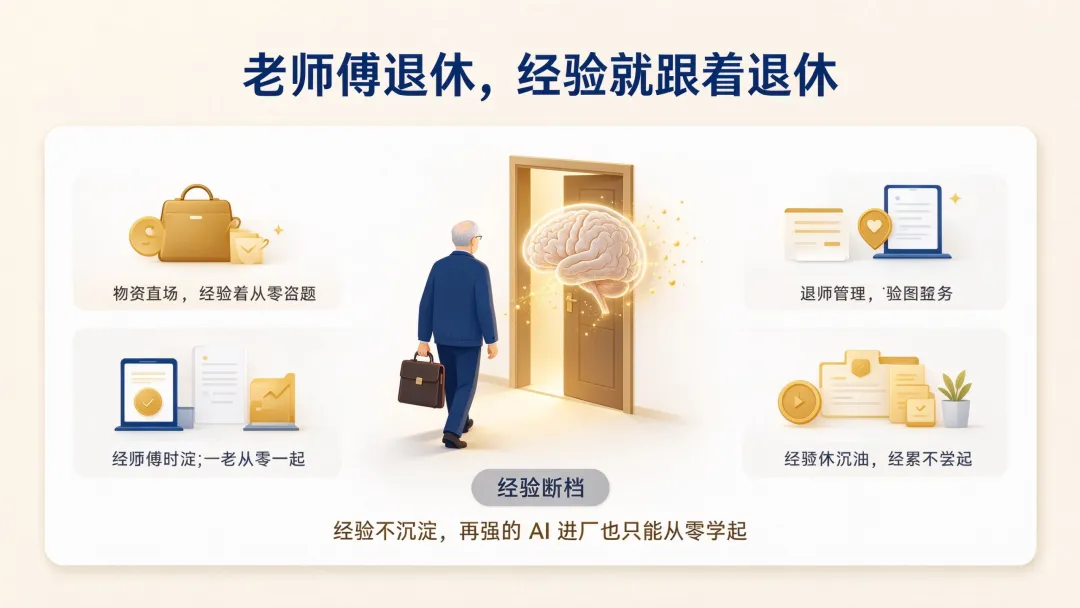
更棘手的是,这些经验大多还在人脑里。老师傅退休,经验就跟着退休;专家换岗,判断依据就断了档。
经验不沉淀,再强的 AI 进厂也只能从零学起。
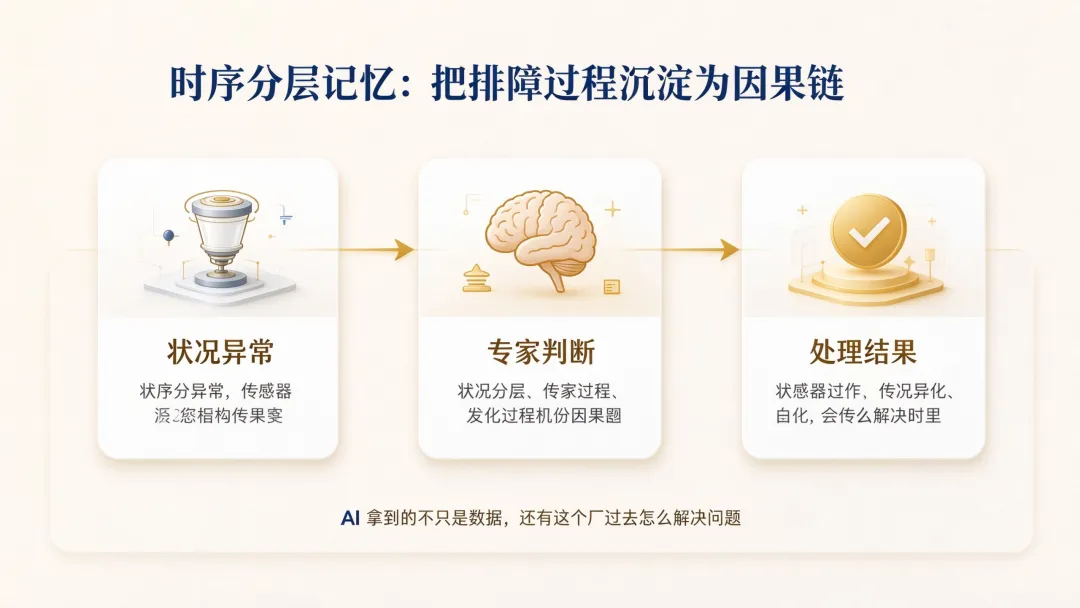
这正是我们把「记忆」放在工业智能体核心的原因。太忆 TiMEM 的时序分层记忆机制,把每一次排障的过程、每一次调参的结果,沿时间线沉淀成可追溯的因果链:当时什么工况、做了什么判断、结果如何。
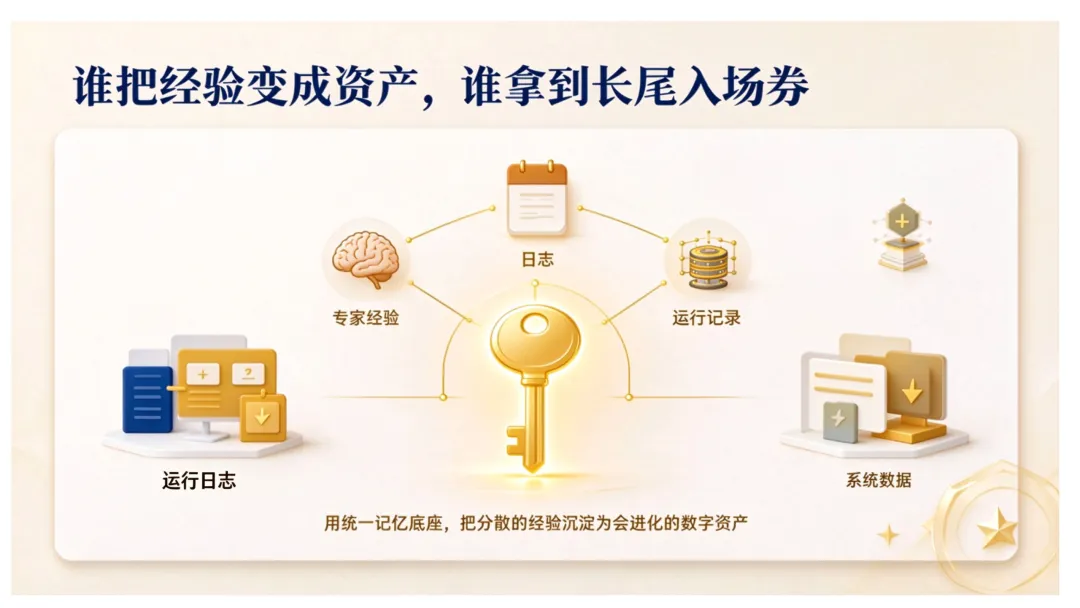
经验从人脑里的孤岛,变成企业可复用、可检索、可传承的数字资产——AI 拿到的就不只是数据,还有这个厂「过去是怎么解决问题的」。
03|交付即定型?不,系统应该越用越准
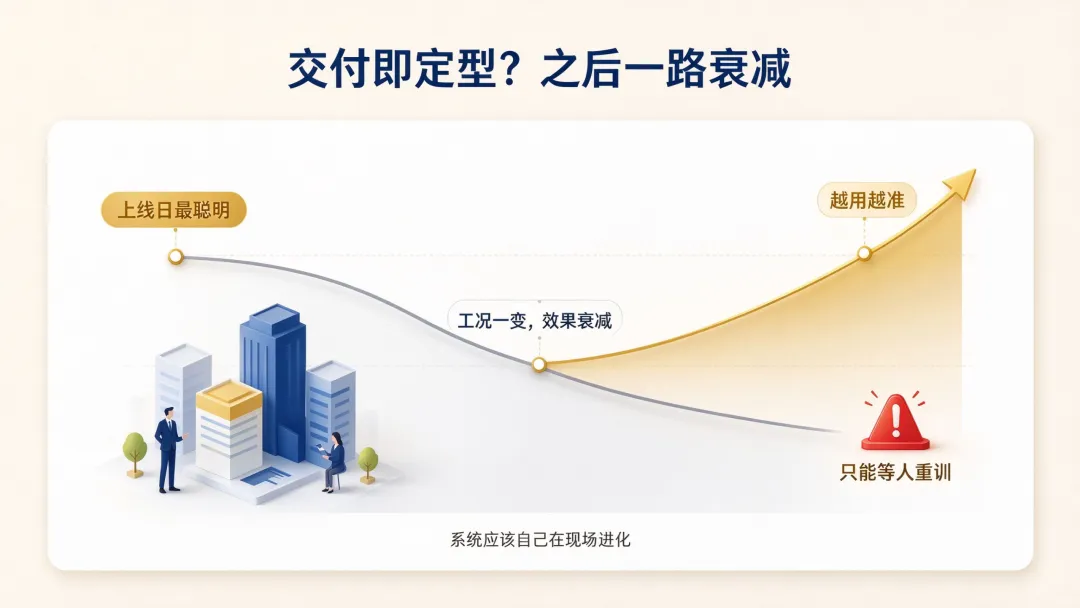
传统工业 AI 产品有个老毛病:交付即定型。模型上线那天是它最聪明的一天,之后工况一变,预测效果一路衰减,只能等人来重新训练。
而长尾场景恰恰变化最快——需求天天在变,系统却不能天天等厂商来改。
小白解读 什么是「自进化」?想象一个特别上进的新员工:每天下班后写复盘——今天哪里判断对了、哪里错了、下次怎么改,第二天带着复盘继续干活。
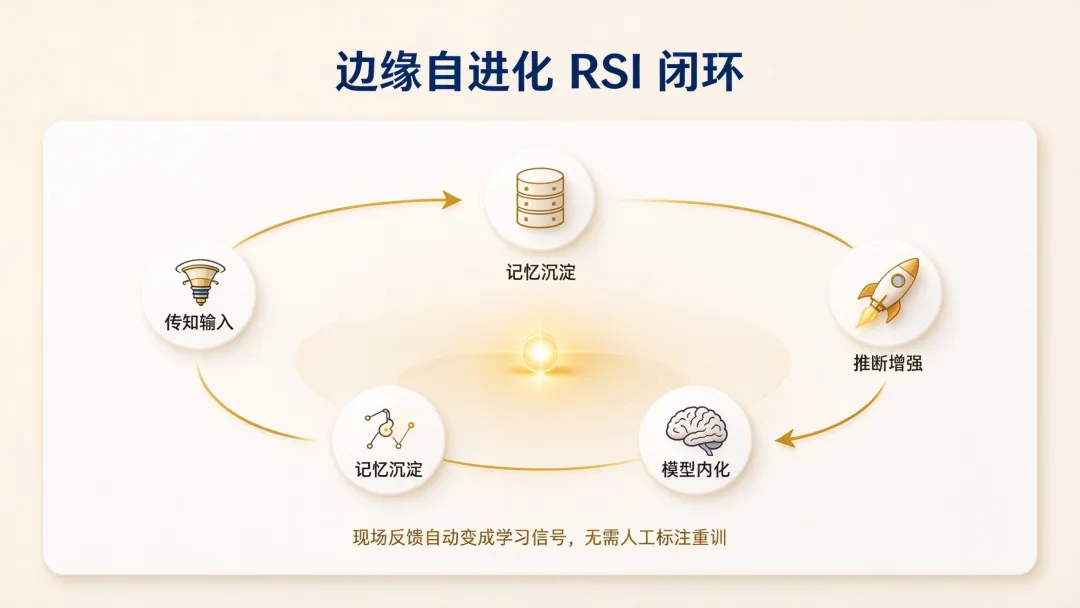
太忆的边缘自进化(RSI,Rapid Self-Improvement,快速自迭代)就是让 AI 系统做同样的事:现场的真实反馈自动变成「复盘素材」,系统自己订正、自己变强,不用等工程师回来重训。
太忆的答案是让系统自己在现场进化。边缘自进化(RSI)闭环在内网完成「感知输入 → 记忆沉淀 → 模型内化 → 推理增强」的循环:
现场的真实反馈自动变成学习信号,配合规则合成数据与自我反思订正,系统无需人工标注重训,用得越久,识别和预判越准。
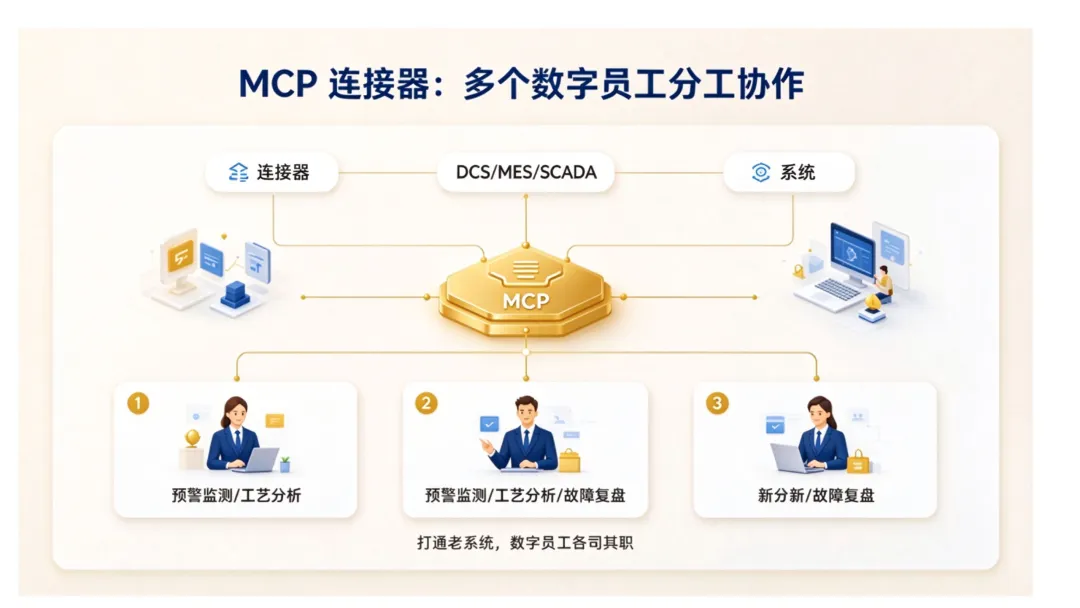
架构上,通过 MCP 连接器打通 DCS、MES、SCADA 等既有系统(可以简单理解为工厂里管设备、管生产、管监控的几套老系统),多个「数字员工」分工协作——一个盯预警监测,一个做工艺分析,一个管故障复盘;
整套系统基于国产 NPU 私有化部署,数据全程不出厂,权限隔离、审计日志、安全沙箱一应俱全,满足国央企的信创与安全要求。
04|人的角色变了:会提问题的人最值钱
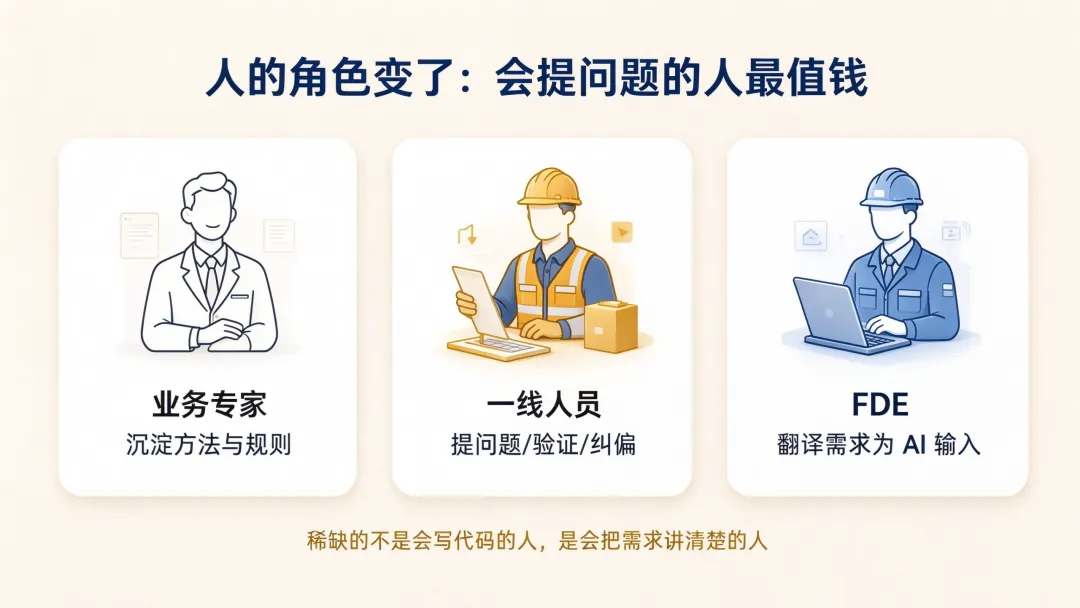
当 AI 接管了编码,一个有趣的变化发生了:稀缺的不是会写代码的人,而是会把需求讲清楚的人。需求描述越清晰,AI 交付得越准确——复杂系统依然需要一个结构化、可确认的需求基线,不能让 AI 靠着只言片语去猜整套系统。
业务专家负责把「这件事该怎么做」的方法沉淀下来,变成可复用的技能与规则;
一线人员不需要懂算法,提出问题、验证结果、纠正偏差,就能让系统持续贴合现场;
交付人员(FDE,现场交付工程师)的工作也变了:不再负责把需求翻译成代码,而是把客户需求翻译成 AI 能理解的输入,把重复出现的工程问题沉淀回平台。这正是最近大热的「前线部署工程师」(Forward Deployed Engineer)。
技能一旦沉淀,就是平台的核心资产。同一个行业的相似场景,不必每次从头再来——这也是太忆支持软硬一体机点位交付、FDE 驻场实施、软件授权订阅多种模式的原因:让不同数字化基础的工厂,都能找到自己的上车方式。
05|一个属于专业玩家的窗口期
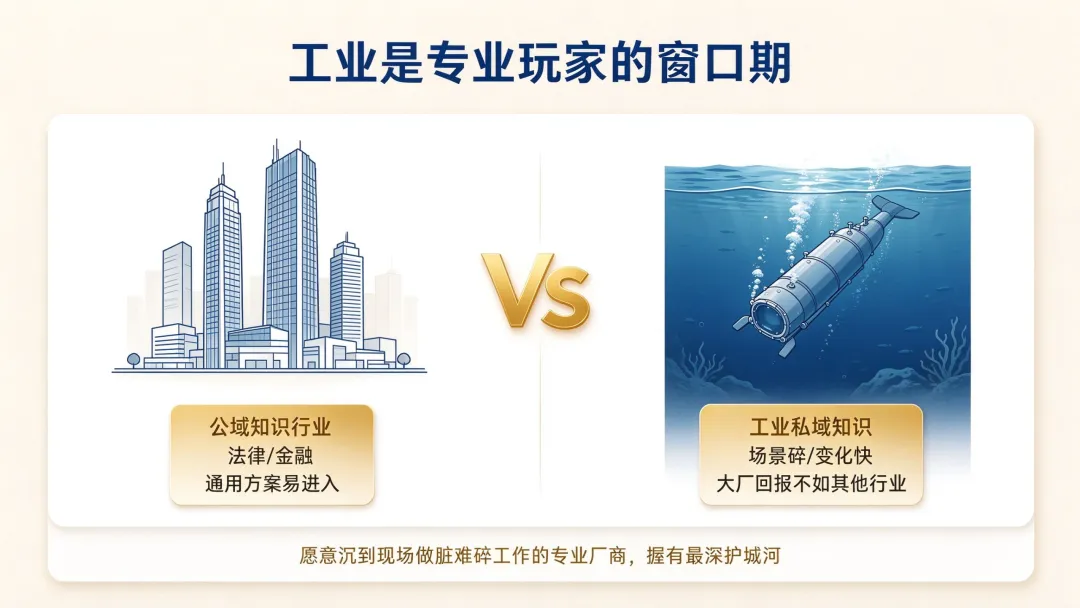
有人会问:大厂也在组建交付团队,通用模型越来越强,专业厂商还有没有机会?我们的判断是:有,而且窗口不小。法律、金融这类公域知识占比较高的行业,通用方案容易进入;但工业恰恰相反——私域知识占主导,场景高度碎片化,同样投一个人,大厂在别的行业回报更高。愿意沉到现场做「脏、难、碎」工作的专业厂商,反而握有最深的护城河。
谁能把经验变成资产,谁就拿到了长尾时代的入场券。太忆正在做的,就是这件事:用统一的记忆底座,把工厂里分散在人脑、日志和系统里的经验,沉淀成会进化的数字资产。如果你的工厂也有那些被搁置已久的「小需求」,欢迎聊聊——长尾时代的入口,可能就藏在其中某一个里。
关于我们
TiMEM 太忆——
为 Agent 构建统一的认知记忆引擎。通过持续观察交互轨迹、持续反思反馈信号、持续回溯调用记忆,让智能体真正拥有跨 Agent 的长期记忆与自主进化能力。每一次对话,都在累积经验;每一次思考,都在迭代认知。
在智能体从“对话者”进化为“执行者”的时代,TiMEM 重新定义 AI 的记忆方式——让经验可迁移、可共享、可迭代,让 Agent 在持续观察与反思中,成为与你并肩进化的智能伙伴。
相关链接🔗跳转
太忆空间:https://space.timem.cloud
太忆云-记忆开放平台:https://console.timem.cloud
体验中心:https://playground.timem.cloud
太忆品牌官网:https://timem.cloud/
文档中心:https://docs.timem.cloud
论文(arXiv):https://arxiv.org/abs/2601.02845
WorkBuddy 用户:在技能商店搜索「太忆」,安装技能,让你的 AI 共用一个大脑。
点击「阅读原文」,立即跨 Agent 记忆管理