ARTICLE · 1271105
你的 AI 代理不是变笨了,是被自己的工具输出撑爆了
Claude Code 干到一半开始忘事,跟模型换没换代没关系。
真正的原因是它的上下文窗口,被 MCP 工具吐出来的原始数据吃掉了。
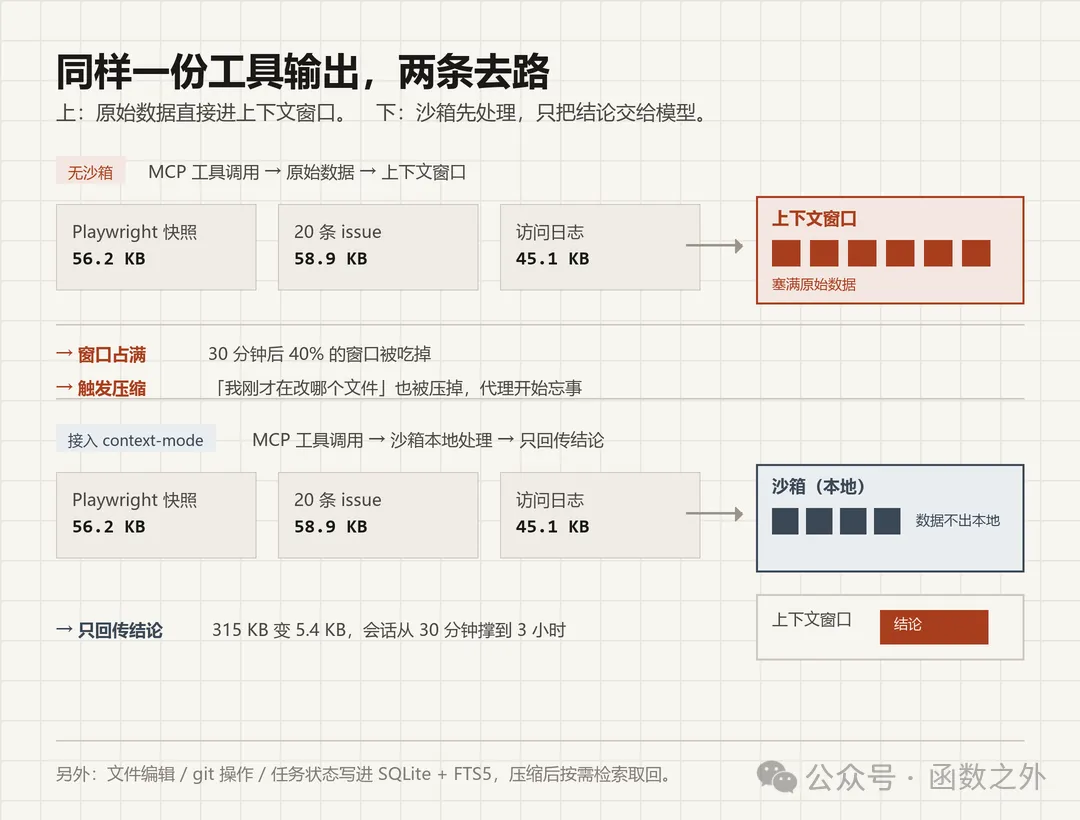
一次 Playwright 快照 56 KB,二十条 GitHub issue 59 KB,一份访问日志 45 KB。这些都不是你写的代码,是工具调用带回来的东西。它们一个字节不落地进了上下文窗口。
三十分钟下来,40% 的窗口没了。
「原始数据」这四个字是问题所在
代理要的是一个结论——哪个文件有多少行、哪个 issue 还没解决。但 MCP 给它的是整个页面的 HTML、整份日志的每一行。
"Every MCP tool call dumps raw data into your context window. A Playwright snapshot costs 56 KB. Twenty GitHub issues cost 59 KB. One access log — 45 KB. After 30 minutes, 40% of your context is gone."
窗口满了,触发压缩。
压缩会把什么一起压掉?「我刚才在改 src/parser.ts」这件事也在里面。
所以代理不是变笨了,是它忘了自己正在干什么。
有个 3 万星的仓库在解这个问题
mksglu/context-mode,32,651 star,本月涨了 8,586,是 GitHub 月度 Trending 榜上跟编程代理最相关的一个。2026 年 10 月 28 日当天它还在提交代码。
它的做法是把工具输出关进沙箱。
"Context Saving — Sandbox tools keep raw data out of the context window. 315 KB becomes 5.4 KB. 98% reduction."
沙箱在本地跑,模型只收到结果。315 KB 的原始输出,进到模型眼前的是 5.4 KB。
README 里给了一张实测表,八个场景:
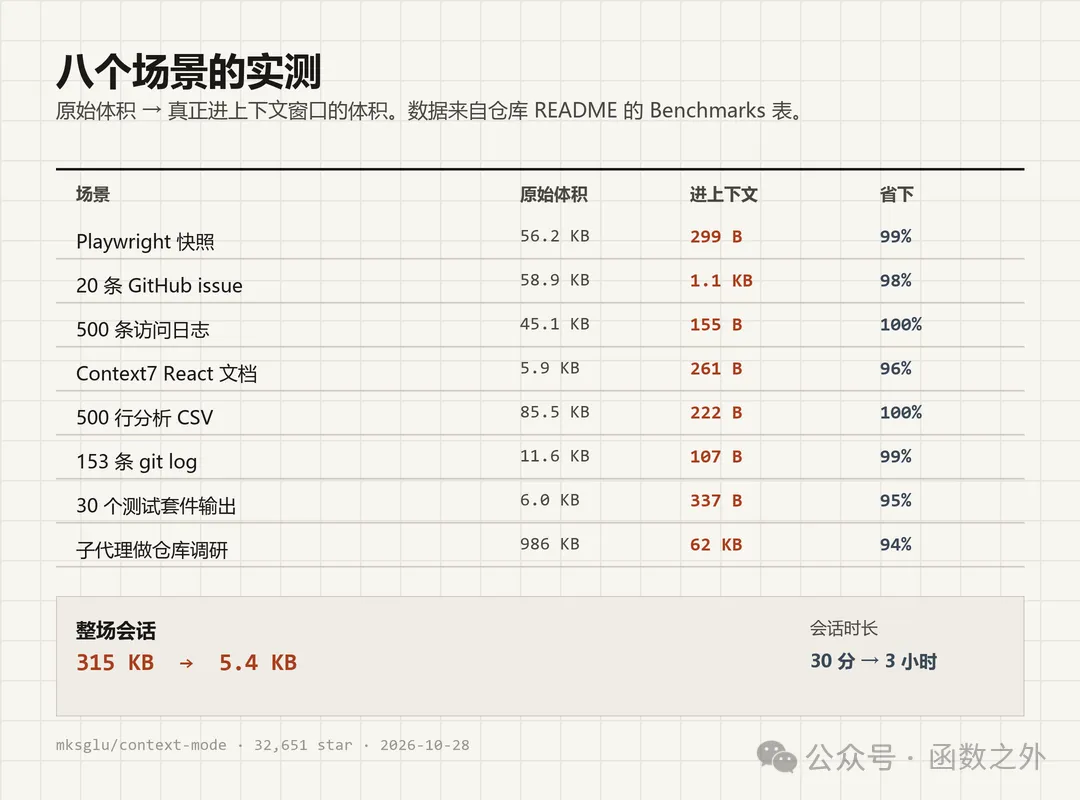
最扎眼的是最后一行。子代理做一次仓库调研,原始数据 986 KB,压到 62 KB,还是省了 94%。
整场会话算下来:
"Over a full session: 315 KB of raw output becomes 5.4 KB. Session time extends from ~30 minutes to ~3 hours."
同一场会话,从 30 分钟撑到 3 小时。
省空间是第一步,记住事是第二步
每次文件编辑、git 操作、任务状态、报错、你做过的决定——全部写进 SQLite。
会话被压缩的时候,它不把这些数据倒回上下文(那样窗口又满了),而是索引进 FTS5,用 BM25 检索,只捞回当前相关的部分。
FTS5 是 SQLite 的全文检索虚拟表。仓库里用到了几个实用特性:porter 词干还原让 "caching" 能匹配 "cached",trigram 分词让 "useEff" 能找到 "useEffect"。排序用 BM25,再叠一层 Reciprocal Rank Fusion 和 proximity 重排。
比省 token 更值得说的,是它的第三个动作:
"Think in Code — The LLM should program the analysis, not compute it. Instead of reading 50 files into context to count functions, the agent writes a script that does the counting and
console.log()s only the result. One script replaces ten tool calls and saves 100x context."
让模型写脚本去算,而不是读 50 个文件进上下文数函数。README 里的对比是 47 次 Read() 吃 700 KB,换成 1 次 ctx_execute() 只剩 3.6 KB。
这个思路的价值不止于省 token——它把代理从「数据搬运工」变成了「写代码的人」。
有一件事它明确不管:输出的啰嗦程度。
"Aggressive brevity prompts have been shown to degrade coding/reasoning benchmarks"
作者还专门引了 Moonshot AI 的 kimi-k2.5 基准说这事。上下文管理归上下文管理,输出风格归输出风格,不搅在一起。
装起来其实就三行
Claude Code 走插件市场,装完自动生效:
# 1. 加插件市场 /plugin marketplace add mksglu/context-mode # 2. 装插件 /plugin install context-mode@context-mode # 3. 重启 Claude Code,或执行 /reload-plugins 前置条件是 Claude Code v1.0.33 以上。如果 /plugin 这个命令不认,先升级(brew upgrade claude-code 或 npm update -g @anthropic-ai/claude-code)。
装完先跑一次体检:
/context-mode:ctx-doctor 所有检查项都该显示 [x]。它会校验 runtime、hooks、FTS5 和插件注册。
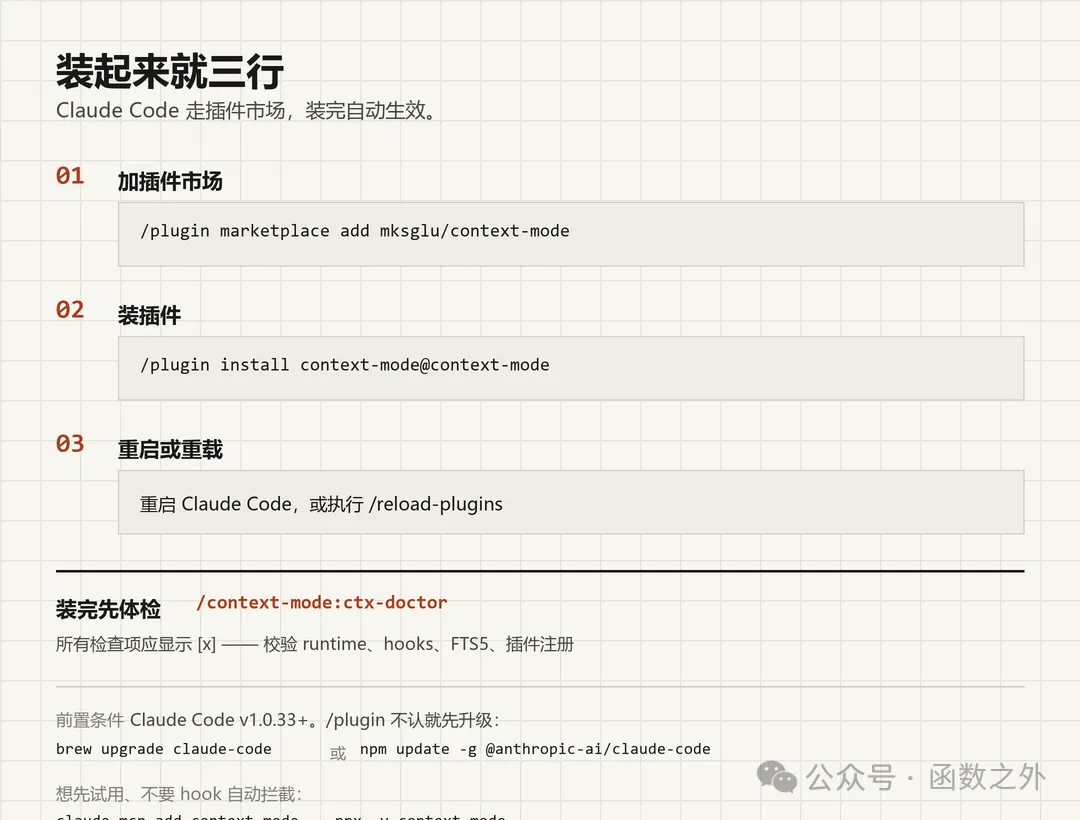
想先试试水、不想要 hook 自动拦截,可以只装 MCP 部分:
claude mcp add context-mode -- npx -y context-mode 这样 11 个 MCP 工具都在,但模型不会被主动引导去用它们。它想直接调 Bash,那就直接调 Bash。
支持哪些平台,效果差多少
仓库自己写的是 17 个平台(README 兼容表列了 18 列,Antigravity 和 Antigravity CLI 分开算)。效果分两档,差别来自 hook 能力:
AGENTS.md / GEMINI.md |
Antigravity 和 Zed 不支持 hook,这是平台限制,仓库解决不了:
"Antigravity and Zed do not support hooks. They rely solely on manually-copied routing instruction files (
AGENTS.md/GEMINI.md) for enforcement (~60% compliance)."
差了三成多。不在这两个平台上的话,装 Claude Code、Cursor、Codex CLI、Copilot CLI 里的任意一个,效果都是完整的。
两个必须说清的坑
第一,license 不明。 GitHub API 返回的 SPDX 标识是 NOASSERTION,仓库 README 上的徽章写的是 Elastic License 2.0。商用之前,自己去确认一下 LICENSE 文件原文。
第二,还在预发布。 最新版本号是 v2.0.0-next.8,2026 年 10 月 28 日发布。next 阶段的东西,接口可能变。
另外这个项目还在高频迭代:光是 10 月 27 日一天就发了 next.5、next.6、next.7 三个版本,第二天又发了 next.8。追新版本别追太紧。
适合谁
适合:每天用 Claude Code 或 Cursor 干活、会遇到「它开始忘事」的;已经在用 MCP、装了一堆 server 的;做长任务(比如一次改十几个文件)的。
不太适合:只是偶尔问几句的小任务——装完的收益抵不上配置成本;或者你压根不用 MCP 工具。
仓库还带一个 /context-mode:ctx-insight,会打开一个托管的 dashboard 看团队级的 token 节省统计。有团队的话值得看一眼。
最后
上下文窗口的容量这几年一直在涨,但代理消耗它的速度涨得更快。
结果就是你越来越频繁地遇到同一件事:写到一半,它开始忘。
context-mode 的答案是把「读数据」这件事挪出模型的视野,让模型只看见结论。上下文不是靠塞得更满来管的,是靠不往里塞来管的。
你现在的代理,有没有出现过「干到一半忘事」?评论区说说,你是怎么处理的。