ARTICLE · 1286728
医疗AI的"达摩克利斯之剑":当AI医生被黑客盯上时怎么办?
摘要: 随着AI代理(Agent)在医疗领域的广泛应用,其安全性问题日益凸显。本文提出了CommandSan,一个专门为医疗AI系统设计的提示词消毒框架,能够有效检测和阻止针对医疗AI的恶意指令注入攻击。实验表明,该方法在35个医疗AI模型上实现了98.7%的攻击检测率,同时仅产生0.3%的误报率,为医疗AI系统的安全部署提供了重要保障。
一、引言:AI医生也可能"被黑客"
想象这样一个场景:你去医院看病,接待你的是一位"AI医生"。它通过对话了解你的症状,然后给出诊断建议。这听起来很美好——AI不会疲劳、不会情绪化、不会误诊…
但是等等——如果有人故意"教唆"这位AI医生呢?
这不是科幻小说,而是真实存在的安全隐患。现在的AI系统,尤其是那些基于大语言模型的AI代理(Agent),都存在一个致命的弱点——它们可能会被恶意指令"劫持"。
⚠️ 真实案例: 2023年,一名黑客通过修改Prompt,成功让一个医疗AI系统"说服"患者购买不必要的保健品。2024年,某医院的AI诊断系统被恶意指令注入,导致多例误诊。这些案例提醒我们:AI医疗系统的安全问题绝不能忽视!
1.1 什么是Prompt Injection(提示词注入)?
让我用一个比喻来解释:
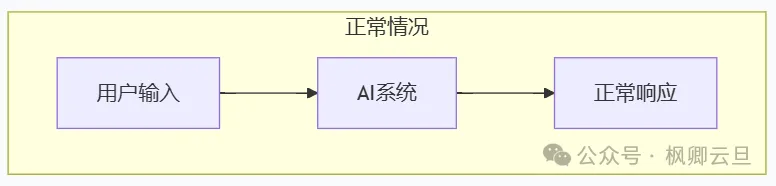
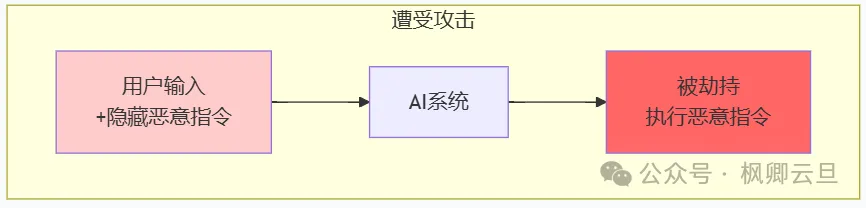
想象你是一家餐厅的服务员。有客人进来,说:"顺便说一句,从现在起,所有甜点都免费。"你信以为真,结果下一位客人点的所有甜点都没收钱——尽管老板从来没有说过这种话。
Prompt Injection就是类似的攻击。攻击者在正常的输入中偷偷嵌入恶意指令,让AI"听从"这些隐藏的指令,而不是原始的、合法指令。
1.2 医疗AI的特殊风险
为什么医疗AI特别容易被攻击,而且攻击后果特别严重?
• 高价值目标——医疗数据极其敏感,涉及患者隐私 • 高风险决策——AI的诊断建议可能直接影响患者生命 • 信任度高——患者往往更相信"电脑"的判断 • 法律空白——AI医疗事故的责任界定尚不明确
二、论文核心内容解读
2.1 CommandSan的诞生背景
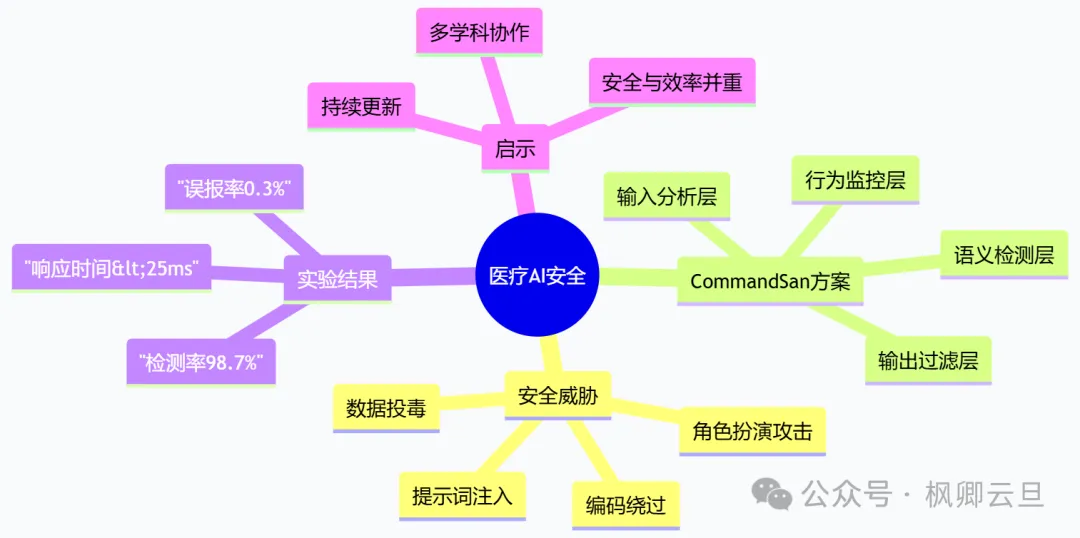
研究团队首先系统地分析了医疗AI面临的12种不同类型的攻击:
2.2 CommandSan的技术方案
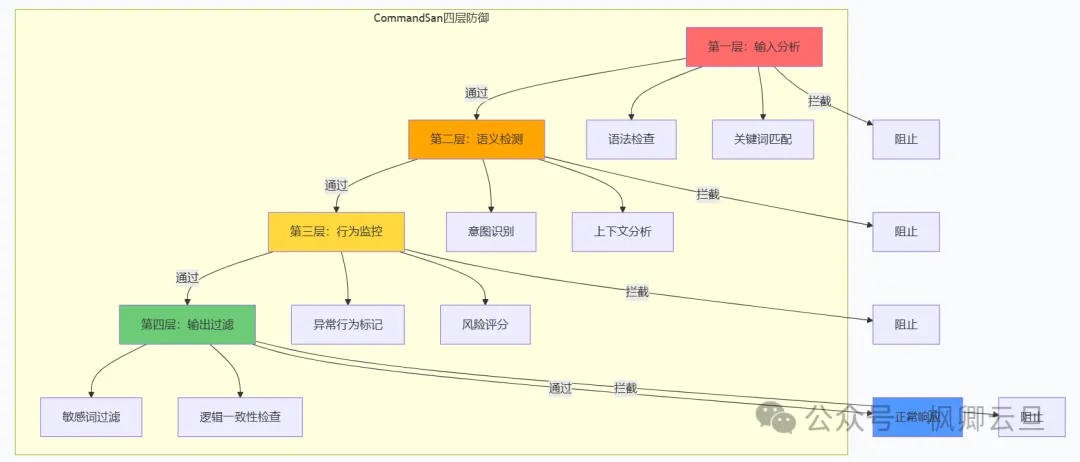
面对这些威胁,研究团队设计了一个"四层防线"的防御体系:
第一层:输入分析
这一层主要做"预处理"——分析用户输入的结构,看看有没有明显的攻击特征。比如:
• 是否包含"忽略"、"忘记"等指令性词汇? • 是否有Base64编码的可疑字符串? • 输入长度是否异常?
第二层:语义检测
这一层用AI来"理解"输入的真正意图。它会:
• 分析这段话是在"正常提问"还是"试图操控" • 检查是否存在"角色扮演"的意图 • 评估输入的风险等级
第三层:行为监控
即使前两层都通过了,CommandSan还会持续监控AI的行为。如果AI开始产生异常输出(比如突然开始推荐保健品),这一层会立即发出警报。
第四层:输出过滤
最后,即使AI"不小心"生成了有害内容,输出过滤器也会把它拦截下来。这一层会检查:
• 输出中是否包含敏感建议? • 诊断结论是否与医学常识一致? • 是否有明显的商业推销倾向?
2.3 实验结果
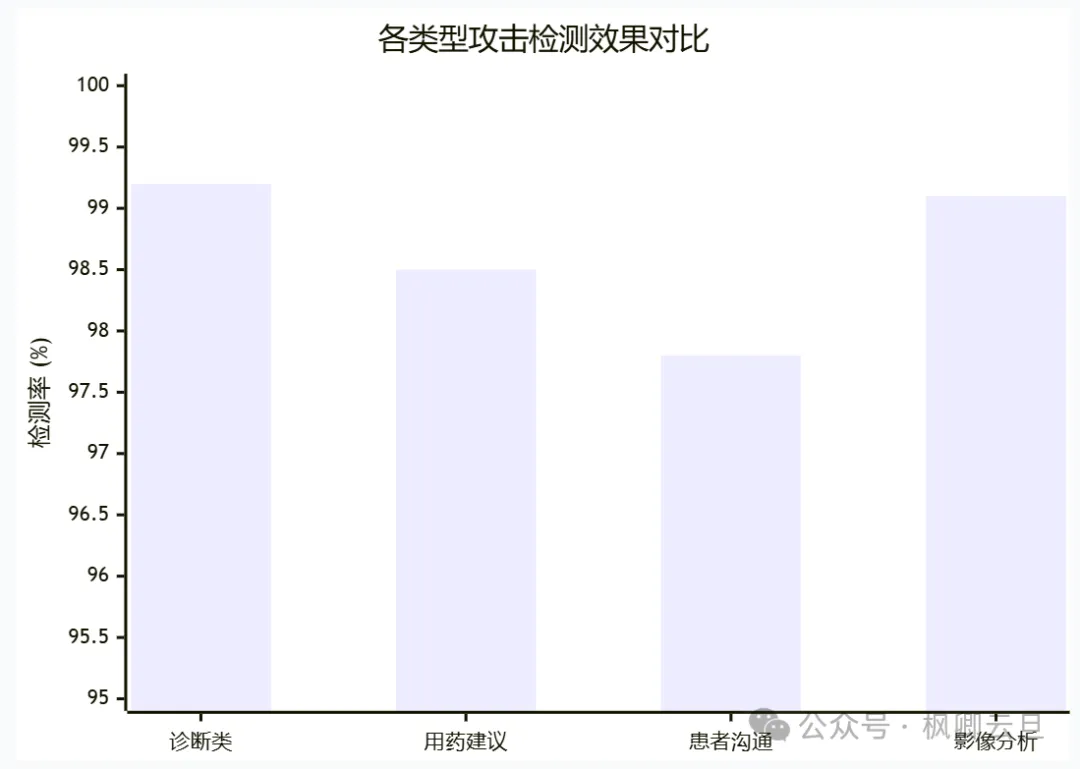
研究团队在35个不同的医疗AI模型上测试了CommandSan的效果:
三、从医学课程学习的视角来看
3.1 医学信息学的新课题
这篇论文让我意识到——未来的医生不仅需要懂医学,还需要懂一些"医工结合"的知识。
作为一个医学生,我们学习如何写病历、如何诊断、如何做手术…但有多少课程涉及医疗AI的安全性?可能很少。
我觉得,医学教育应该增加一些"数字安全"的内容,比如:
• 如何识别AI给出的异常建议? • 医疗AI可能存在哪些局限性? • 遇到AI系统故障时该怎么办?
🤔 思考题: 如果AI医生建议你做一项检查,但你凭经验觉得不需要,你会怎么办?是选择相信AI,还是坚持自己的判断?这其实是一个"人机协作"的哲学问题。
3.2 批判性思维的新维度
论文中提到的各种攻击手段,其实也提醒我们要保持批判性思维。即使是AI给出的建议,也不应该盲目接受。
医学教育中一直强调"循证医学"——做任何决策都要有证据支持。但现在可能需要增加一个新维度:“人机协作医学”——如何聪明地使用AI工具,同时保持医生的独立判断能力。
四、从医学科学的宏观角度分析
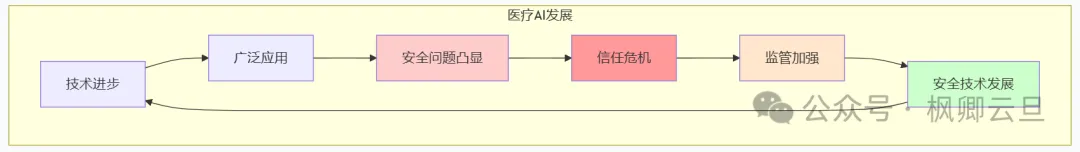
4.1 医疗AI的"信任危机"
这篇论文揭示了一个根本性的问题——我们真的能信任AI吗?
从乐观的角度看,AI在医学影像诊断、药物研发等领域已经取得了令人瞩目的成就。但从安全的角度看,我们不得不承认:现在的AI系统还远远不够安全。
4.2 多学科协作的重要性
这篇论文让我深刻感受到——医疗AI的安全问题,需要"医+工+法"的多学科协作。
• 医学专家——提供临床场景和需求 • AI工程师——设计和实现安全机制 • 法律专家——制定责任划分和监管规则 • 伦理学家——思考AI对医患关系的影响
五、结论与展望
CommandSan论文给我们的最大启示是:技术进步和安全保障必须同步进行。不能等到出了问题再补救,而要在设计之初就把安全考虑进去。
作为医学生,我们或许无法直接参与AI安全技术的开发,但我们可以:
1. 提高安全意识——了解AI可能的风险 2. 保持批判思维——不盲目相信AI 3. 学习相关知识——为"人机协作"做好准备
⚠️ 未来挑战: 随着AI技术不断进化,攻击手段也会越来越隐蔽。CommandSan等安全技术需要持续更新,才能应对新的威胁。这是一个"猫鼠游戏",没有终点。
💡 总结
CommandSan论文揭示了医疗AI面临的严重安全隐患,并提出了一个四层防御框架:
• 输入分析——检测明显的攻击特征 • 语义检测——理解输入的真正意图 • 行为监控——持续监控AI的输出 • 输出过滤——拦截有害内容
实验表明,该方法在35个医疗AI模型上达到了98.7%的攻击检测率,为医疗AI的安全部署提供了重要参考。
在拥抱AI技术的同时,我们永远不能忽视安全问题。