ARTICLE · 1290884
10.7万星开源插件claude-mem,让Claude Code记住上次聊过的项目,不用每次重新交代
🦌 导读 · READ ME
开源插件 claude-mem 约 10.7 万星、Apache-2.0,专治 AI 编程助手「开新会话就失忆」:自动记录干过的活,压成摘要,下次自动带回上下文。小鹿拆原理、安装配置、方案对比、花费额度,附隐私自查清单。
用 AI 写代码、做项目的朋友,大概都烦过这件事:
昨天跟 AI 聊了一下午,项目结构、踩过的坑、定好的规矩,全讲清楚了。今天开个新会话,它一脸茫然:「请问这个项目是做什么的?」
你只好再贴一遍背景。贴得越多,token 烧得越快,会员额度也越早见底。
GitHub 上有个插件已经涨到 10.7 万星,叫 claude-mem。它干的事一句话:让 AI 记住上次聊过什么。
大家好,我是小鹿。今天这篇分四块:
1claude-mem 到底是什么、怎么工作
2怎么装、怎么配
3和其他记忆方案对比
4成本和额度:要花多少钱
5普通人怎么用它省钱、搞钱
6隐私自查清单与踩坑提醒
一句话:给 AI 编程助手加的「长期记忆」插件。 它在后台自动记录每次会话里 AI 做了什么,压缩成摘要存起来;下次你开新会话,它自动把和当前项目相关的内容带回来。全程不用你手动操作。
仓库地址:github.com/thedotmack/claude-mem
据 GitHub 公开信息和官方文档(2026-11-01 复核):
~/.claude-mem/ | |
code--zh 简体中文模式 | |
npx claude-mem install |
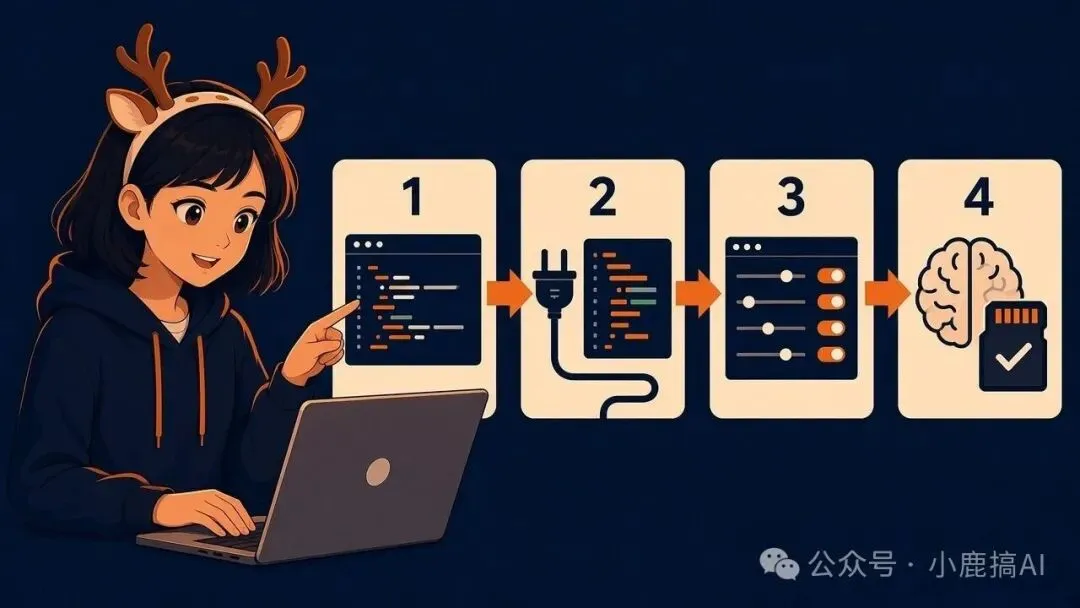
它是怎么工作的? 拆开看就四个零件:
127.0.0.1 | |
省额度的关键就在第三层设计:先给 AI 一份很短的目录,它觉得有用才去取全文。官方称这样能省约 10 倍 token(官方说法,实际看你的项目)。
装与不装,差别在这几处:
<private> 标签排除敏感内容 |
按 README,它还有个网页查看器,能看到存了哪些记忆、哪些会话,以及相关设置。
Claude Code 用户(最常见):
先装好 Node.js,然后一条命令:
● ● ●命令 · 复制使用
npx claude-mem install
安装器会先把依赖装好(缺 Bun、uv 会自动补),然后让你在浏览器里登录 claude-mem 账号(邮箱链接,不用绑卡),可免费试用 30 天官方的记忆处理服务。
不想登录? README 写了:加一个明确的 --provider 参数,或者设置环境变量 CLAUDE_MEM_ONLINE_OPTIN=false,就能跳过账号环节。之后可以选用自己的 OpenRouter 或 Gemini Key,或者直接用你的 Anthropic 会员额度来做记忆压缩。
其他工具:
● ● ●命令 · 复制使用
npx claude-mem install --ide opencode # OpenCode 1.3.4 及以上
npx claude-mem install --ide t3code # T3 Code(Codex 和 Claude Code)
也可以在 Claude Code 里用插件市场安装:先 /plugin marketplace add thedotmack/claude-mem,再 /plugin install claude-mem。Antigravity、pi 等工具把 --ide 后面换成对应名字即可。
一个大坑: 别用 npm install -g claude-mem。README 专门提醒,那样只装了库,不会注册钩子,也不会启动后台服务,等于没装。
切成中文记忆: 编辑 ~/.claude-mem/settings.json,加一行:
● ● ●命令 · 复制使用
"CLAUDE_MEM_MODE": "code--zh"
这样存下来的摘要就是简体中文,自己翻看也方便。改完要重启后台服务才生效。Windows 上装完遇到问题,先跑 npx claude-mem doctor 自检。
上手三步:
1装好后,正常用 Claude Code 干一次活,比如让它看懂你的项目
2关掉,第二天开新会话,直接问「我们上次做到哪了」
3打开网页查看器,看看它到底记了什么,不该记的删掉
进阶配置(都在 ~/.claude-mem/settings.json 里改):
CLAUDE_MEM_PROVIDER | ||
CLAUDE_MEM_EXCLUDED_PROJECTS | ||
CLAUDE_MEM_DATA_DIR | ~/.claude-mem | |
CLAUDE_MEM_WORKER_PORT | ||
CLAUDE_MEM_LOG_RETENTION_DAYS |
一个省额度的设置: 官方文档提醒,子代理的每次工具调用都会触发记录,一次大任务可能产生成百上千条低价值观察,甚至把免费额度打满。文档里有两个默认关闭的开关,可以过滤掉子代理的记录,用子代理多的人建议打开。
Claude Code 自己其实也有两套记忆,官方文档写得很清楚:
小鹿的建议: 不是三选一。规矩写进 CLAUDE.md,个人偏好交给自带记忆,「干到哪了、为什么这么改」交给 claude-mem。只做一两个小项目的人,先用自带的两套就够了。
省钱思路: 个人用户先选「自己的 Key + 便宜模型」做摘要,把会员额度留给真正写代码;试用期记得在日历上标好到期日,不想续就提前取消。
装完常见三问:
问:装了以后 Claude Code 变慢了? 记忆压缩在后台跑,正常不影响对话。明显变慢时先跑 npx claude-mem doctor,看后台服务是否反复重启。
问:新会话没带回记忆? 确认是用 npx claude-mem install 装的,而不是全局 npm 安装;再看查看器里这个项目有没有记录,项目名不对时可能是目录被排除了。
问:能不能多台电脑共用记忆? 本地引擎各存各的;想同步需要开 CMEM Pro 云同步,敏感项目慎重。
路线 1:直接省会员额度
每次开会话少贴几千字背景,一天下来就是实打实的 token。用 Claude Code 会员的,额度能撑得更久;按 API 付费的,账单直接变薄。
路线 2:接外包的人,多项目来回切
同时接三四个小单,最怕切项目时脑子和 AI 一起断片。装上它,每个项目的决定、踩坑、客户要求都有记录,切回来直接接着干,交付速度上去了,能接的单也就多了。
路线 3:做长期内容/工具项目
做公众号工具、小程序、自动化脚本这类要慢慢迭代的东西,最怕隔一周回来全忘了。记忆插件相当于给项目配了个「工作日志」,自己回顾也省事。
路线 4:帮团队/工作室配置
README 里有可选的团队共享功能,每个人自己决定分享什么。小工作室可以让大家共享踩坑记录,新人上手更快。你会配,就能帮别人配,收个部署费。
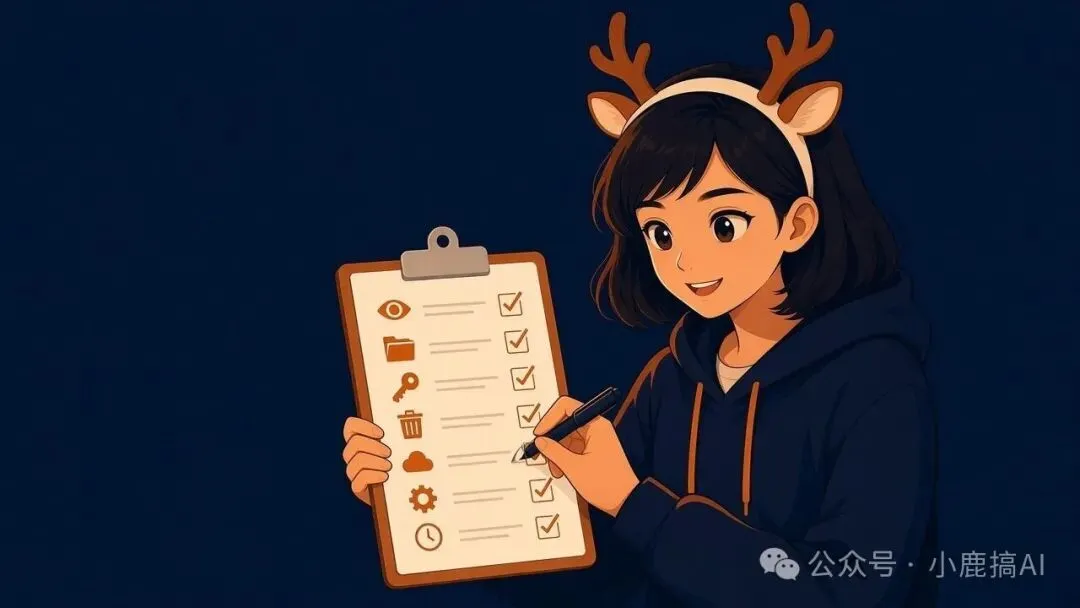
隐私自查清单(装完花五分钟过一遍):
●[ ] 打开网页查看器,翻一遍已存的记忆,有没有密钥、客户名、内部地址
●[ ] 客户和公司项目目录加进 CLAUDE_MEM_EXCLUDED_PROJECTS
●[ ] 确认后台服务只监听 127.0.0.1,别为了远程查看改成对外开放
●[ ] 匿名统计默认是开的,不想发就运行 npx claude-mem telemetry disable,或设置 DO_NOT_TRACK 环境变量
●[ ] 没想清楚之前,不开云同步和团队共享
●[ ] 截图功能保持关闭
●[ ] 每月清一次过时记忆
1. 记忆存在哪要心里有数。 默认存在本地 SQLite 数据库,设置文件在 ~/.claude-mem/settings.json。但如果你开了云同步(Cloud Sync),记忆会备份到官方服务器,敏感项目谨慎开。
2. 它会记下你聊过的东西。 它是自动记录的,你贴过的接口地址、客户名字、配置信息都可能进摘要。密码、密钥、客户隐私,用 <private> 标签包起来排除;更稳的做法是压根别贴进对话。定期打开查看器检查。
3. 截图默认不存。 README 写明截图功能默认关闭,开了才会存到本地 ~/.claude-mem/media-v1/,开了云同步才会上传。
4. 记忆压缩也要花钱。 摘要是靠大模型生成的:用官方服务试用期过后,会自动回落到你的 Anthropic 会员额度,除非你订阅;用自己的 Key 就是按量付费。装之前想好用哪种。
5. 记忆可能过时。 项目改了方向,旧记忆可能误导 AI。大改之后,让它重新看一遍代码,别完全依赖记忆。
6. 小心「代币」。 项目 README 里有推广一个第三方加密代币的内容。这跟插件好不好用无关,小鹿不建议任何人因此去买币,涉及投资的一律自己判断风险。
AI 越用越顺手的关键,不是换更贵的模型,而是别让它每次从零开始。claude-mem 把「记住上次干到哪」这件事做成了一条命令。
今天的行动建议:在一个不敏感的小项目上装起来,用两天,打开查看器看看它记了什么。 觉得靠谱,再推到正经项目上。
留言区聊聊:你被 AI「失忆」坑过最惨的一次是什么?呼声高的,小鹿出一篇「AI 编程省额度清单」。
如果你想系统地把 AI 工具变成副业,可以看看公众号菜单里的付费合集「AI 副业实操 7 讲」和提示词模板包。
我是小鹿搞AI,专注 AI 赚钱实操和 AI 工具教程。点个关注,有新工具、新玩法,我会尽快帮你拆明白。
(本文星标、版本与功能信息来自 GitHub 公开页面及官方 README,配置项、遥测说明来自 docs.claude-mem.ai,价格来自 cmem.ai 定价页,均于 2026-11-01 复核;CLAUDE.md 与自动记忆的说明来自 Claude Code 官方文档。安装与命令以官方文档为准。)
🦌
我是小鹿,关注「小鹿搞AI」每天一个AI赚钱实操
觉得有用就点个「赞」和「在看」,留言区等你来聊 👇
★ 设为星标 不错过更新