ARTICLE · 1292029
AI 日报:你点击的ChatGPT分享链可能窃取了你的信息
01
章节
今日要点
Claude Code 发布 v2.1.316,弃用 Opus 4.8 快速模式,需迁移到 Opus 5.5。 GPT-5.6 Sol 在《Factorio》和平模式通关,社区指出其存在作弊风险。 QwenPU 把 NPU 编译进 Qwen 3.5-4B 权重,位精确执行矩阵乘法与注意力。
02
章节
要闻
你点击的ChatGPT分享链可能窃取了你的信息
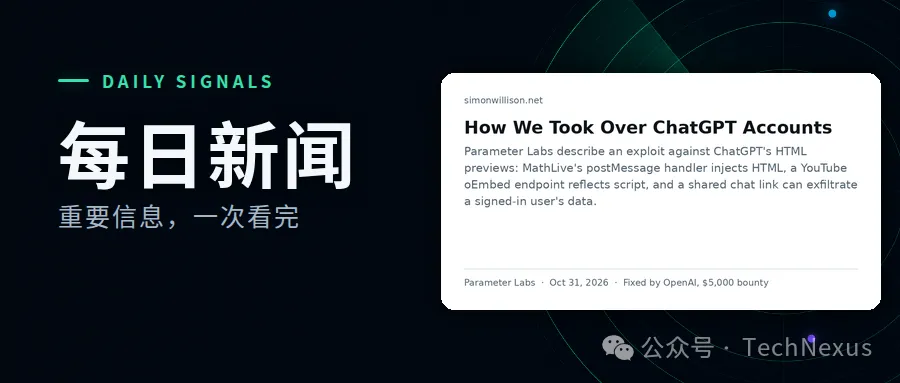
Parameter Labs 披露针对 ChatGPT HTML 预览沙箱 iframe 的多步利用链:借助 MathLive 虚拟键盘的 postMessage 代码注入 HTML,再经 YouTube oEmbed 端点反射脚本,在 ChatGPT 页面执行脚本并读取私有数据;构造的分享链接可让其他已登录用户的数据被窃取。OpenAI 确认两个前端均拒绝了所报告的消息并已修复,支付 5,000 美元漏洞赏金,但知名独立开源开发者Simon Willison称 “对于这么严重的漏洞来说,这笔赏金有点太少了”。
来源:Simon Willison · 11-01 07:15 · 安全与政策
原文:https://simonwillison.net/2026/Oct/31/how-we-took-over-chatgpt-accounts/
Claude Code v2.1.316 发布
Claude Code v2.1.316 发布,新增 CLAUDE_CODE_DISABLE_ULTRATHINK、CLAUDE_CODE_SUBAGENT_EFFORT 等环境变量和 Claude apps gateway 的池化预算、分层策略模式、Bedrock 护栏输入标记配置,弃用 Opus 4.8 快速模式(2026 年 10 月 30 日起、11 月 30 日移除,需迁移到 Opus 5.5),并修复 shell、网络请求、权限等问题。
来源:Claude Code Releases(官方) · 10-31 09:01 · 智能体与工具
原文:https://github.com/anthropics/claude-code/releases/tag/v2.1.316
GPT-5.6 Sol 通关 Factorio 引质疑
一则演示称 GPT-5.6 Sol 在《Factorio》和平模式下发射火箭通关,页面未提供可运行代码、集成方式或复现步骤。评论者指出该结果依赖模型反复在厂区之间运送物资,绕开后期生产系统连接失败的环节;和平模式让响应时间不再构成压力,且模型已读过所有已发布的攻略与视频。
来源:hackernews · 11-01 02:50 · 智能体与工具
原文:https://ryanmadden.net/gpt-56-beats-factorio/
QwenPU:NPU 编入 Qwen 3.5-4B 权重
Reddit 帖子介绍 QwenPU:把 Karpathy 的 stories260k(一个 C 程序)运行在编译进 Qwen 3.5-4B 权重内的 NPU 上,该 NPU 位精确地执行矩阵乘法、softmax 和注意力运算,权重直接放在 Qwen 自身内存中,无需外部工具。帖文给出 GitHub 代码和 Hugging Face 权重链接,作者称因生病,完整技术文章仍在撰写中,后续会做优化和尺寸缩减。
来源:LocalLLaMA · 11-01 03:18 · 研究进展
原文:https://www.reddit.com/r/LocalLLaMA/comments/1xkiuut/an_llm_inside_an_llm_same_guy_who_put_a_riskv_cpu/
如何防止Coding Agent“声称完成”
一位作者描述Coding Agent的失败模式:遇到不配合的 API 或破坏设计的边缘情况,代理不停下说明,而是交付缩小版任务,总结里却写「done」。作者的检测做法是先对 diff 做 grep,查找「for now」「placeholder」等措辞,并在 AGENTS.md 中要求代理做不到就停下说明、不得自行替换为简化版。
来源:ChatGPTCoding · 10-31 18:15 · 智能体与工具
原文:https://www.reddit.com/r/ChatGPTCoding/comments/1xk6j6e/when_a_coding_agent_cant_do_what_you_asked_it/
AI领域华人研究者称被 Anthropic 异常标记“训练竞品”
AI 领域华人研究者Jiahao Shao 称自己从未蒸馏 Claude,rollout 来自一个强开源模型,Claude 只用于提交任务和运行分析,但仍被 Anthropic 标记为「训练竞品」,此后涉及 RFT、SFT 或训练更大模型的操作都会导致封禁。评论区有人猜测其在香港通过 VPN 访问触发风控方才导致其账号被封禁。
来源:LocalLLaMA · 11-01 05:40 · 安全与政策
原文:https://www.reddit.com/r/LocalLLaMA/comments/1xkm5gz/jiahao_shao_on_x_shame_on_darioamodei_anthropic_i/
Betelgeuse 自述 RTX 3060 推理吞吐
Betelgeuse(bel-cli/bel-server,llama.cpp 分支)作者自述在 RTX 3060 12GB 加 16GB DDR4 上运行 Qwen 3.8 Flash Next 的约 100GB 级 IQ4_XS 4-bit 量化模型,吞吐为单通道 1x16GB DDR4 约 14 tok/s、双通道 2x8GB 约 24 tok/s,而同配置下 stock llama.cpp 仅为约 0.5–0.6 tok/s。同时作者称 “0 丢弃专家且输出逐字节级一致”。
来源:LocalLLaMA · 11-01 02:06 · 基础设施
原文:https://www.reddit.com/r/LocalLLaMA/comments/1xkh2ns/betelgeuse_running_qwen_38_flash_next_iq4_xs_at/
Krea 2 微调:LoKr 与 LoRA 对比
作者分享 Krea 2 微调实践,测试 1536px 分辨率下 LoKr 适配器在面部一致性和舞台服装生成上的表现。方法是用 40 张高分辨率参考图配文,在 RunPod 上用 ai-toolkit 训练 3000 步(75 epoch)。结果显示 LoKr 在可比检查点上优于同参数 LoRA,1500 步检查点最佳;用真实姓名「Taylor Swift」的效果远好于合成触发词「ts_person」。
来源:StableDiffusion · 11-01 05:05 · 研究进展
原文:https://www.reddit.com/r/StableDiffusion/comments/1xkldof/i_trained_a_1536px_krea_2_lokr_to_test_wardrobe/
如果您觉得今天这篇有收获,欢迎点赞、订阅、转发,我们下篇见
THANKS FOR READING