ARTICLE · 1293020
让AI看视频就能做游戏?这个开源项目做到了
我最近翻到一个 GitHub 仓库,名字很直白,Video to Game,从视频到游戏。
它做的事一句话能说完。给编程 agent 看一段十几秒的游戏视频,它把这段视频逆向成一个真的能在浏览器里玩的游戏。
仓库里放了 31 个成品。云端的飞鲸、水墨的山、深海的幽灵鲸、纸灯笼搭的楼梯。每一个都能点开就玩,键盘就能操作。
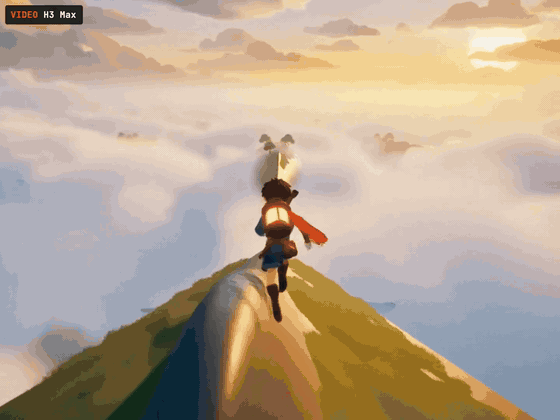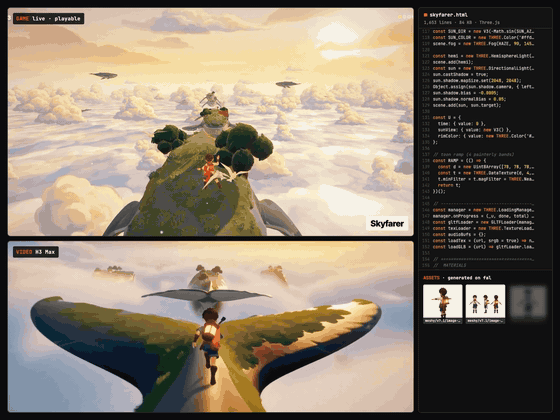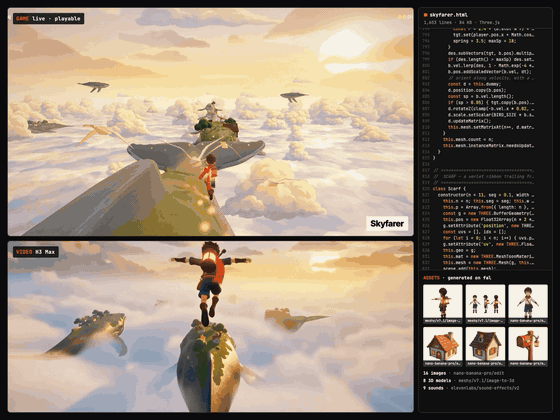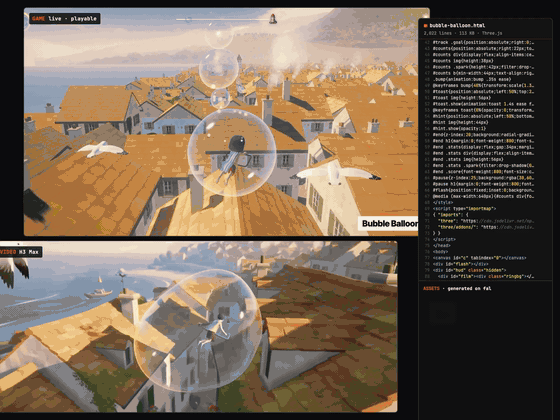
左边上下两张,分别是生成的视频和照着它做出来的游戏,右侧是代码与资产清单。图源 lovisdotio/video-to-game
我把那几段动图来回看了几遍。下面那张不是过场动画,是实时渲染,是玩家拿方向键在跑。
更反常的是它的体积。这 31 个游戏,每一个都是一个单独的 index.html,里面只有 Three.js。没有 Unity,没有虚幻,没有模板,没有第二个库。
有意思的地方其实不是「AI 能生成游戏」。这种小玩具现在太多了。有意思的是它选的顺序。
1
让 agent 做游戏,它给你一个灰盒子
你直接让一个 coding agent 做「一个男孩在飞鲸之间滑翔」的游戏,它会给你什么,用过的人都懂。
几个灰色立方体。一个默认的天蓝色天空。一个转起来跟玩家较劲的摄像机。逻辑跑得通,交互也跑得通,但你一眼都不想多看。
这不是模型笨。一个游戏长什么样、镜头放在哪、光从哪来、颜色怎么统一,本来就不是文字能传过去的东西。你把「梦幻的云海」写十遍,它给你的还是那几个灰盒子。
agent 缺的不是代码能力,
是审美。
作者的解法很直接。视频模型恰好只会干这件事,那就让它先干。
先让视频把游戏的外观、镜头、还有那一个让人记得住的机制拍出来,再让 agent 照着复刻。
这段视频不是素材,不是灵感板,是设计文档。
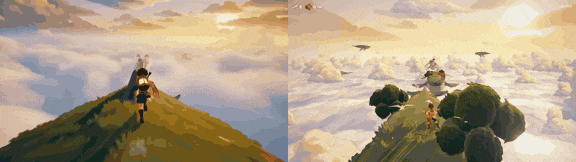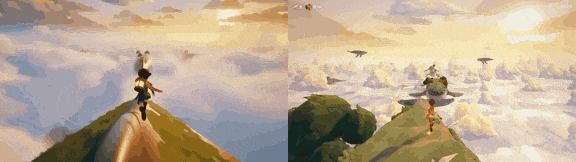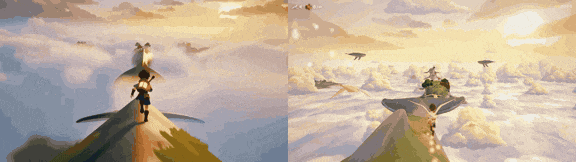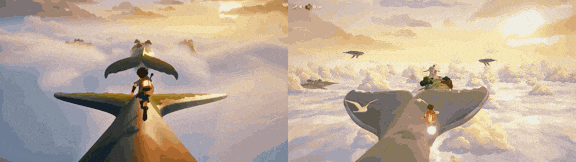
Skyfarer,邮差男孩在飞鲸背上起跳、滑翔。左边视频,右边游戏
2
先把视频读成一份规格书
第一步是 study_video.py。它把片子拆开,每 0.25 秒存一帧,拼一张总览图,顺手把整段视频的色板和镜头切点算出来。
然后 agent 打开这些帧,写一份 spec。
机位离主角多远、多高、什么焦段。主角是谁。核心机制是哪一个。世界怎么摆。色板、光、材质、情绪。还有视频最想让你记住的那一秒。
spec 写完,才开始写代码。
这里有一条很硬的规矩。视频里的机制,就是游戏的机制。
视频里要是一个女孩在把整个世界翻过来,游戏就得是「把世界翻过来」。不能做成一个通用跑酷,套上她的模型交差。
「看起来对了」,没有并排图就不算检查。
所以每改一次,脚本都会在视频和游戏的同样三个时间点截一张并排图。同样的三个位置,每次都是这三个。
这条规矩听着像强迫症。它其实做了一件很实的事,把「好看」从一个形容词,变成了可以验收的东西。
3
每一张图、每一个模型、每一段声音,都从那几帧里长出来
资产这块是我看得最久的地方。
31 个游戏一共 1013 次生成调用,产出 594 张图、194 个 3D 模型、290 段音效和音乐。
规矩是不许手画,不许从别处下载。所有东西都拿视频自己的帧当参考,一次生成一个,看完再要下一个。
角色是这么来的。挑出主角最清楚的几帧,让 Nano Banana Pro 画一张全身设定图,要求 A-pose,不是 T-pose。因为 A-pose 绑骨骼更顺,袖子和披风不会被糊成一片。
然后去背景,图生 3D,绑骨骼,出跑、跳、滑翔几段动作。都装进一个 GLB,游戏里用动画混合器过渡,跑着跑着起跳,不会硬切。
环境走另一条线。远山、云层、城市轮廓,一个深度画一张宽图,抠干净,放到不同距离的平面上做视差。
草地、石头、瓦片、沙地,都要求无缝平铺、顶光、平光、无阴影、无透视,用之前先拼成 3×3 看接缝。
声音一个动作一条。起跳、落地、滑翔的风、收集、核心机制、环境底噪。音乐强制纯器乐,响度还要压下去,让音效压得住。
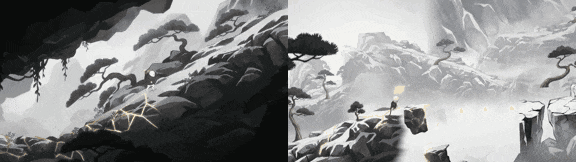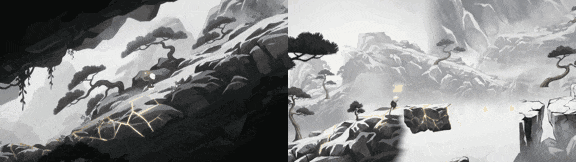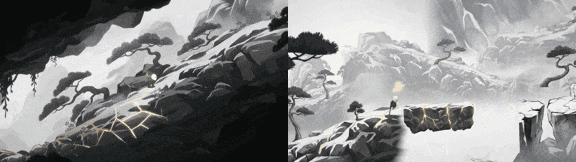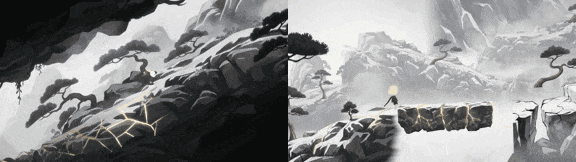
Kintsugi Mountain,黑白水墨的山,每一步踩下去开出一片金箔
4
屏幕上不放字
这 31 个游戏还有一个共同的克制。除了标题和一行操作说明,屏幕上没有字。没有血条,没有任务提示,没有「按空格跳」。
作者的说法是世界自己会解释。玩家看见前面那道断崖,就知道要跳。
配色也一样。一个世界里只有一个和谐的色板,东西可以密,但要归组。主角和所有能交互的东西,必须在一个安静的背景上跳出来。
这几条不是后期打磨,是 spec 的一部分,第一天就写进去。色调映射、一个调色、雾、泛光、暗角、颗粒,全都跟着视频走。
这也解释了为什么这些画面看起来「像有美术」。不是因为细节多,是因为没有一处乱。
5
最后一个环节,AI 玩自己的游戏
这是我最喜欢的一段,也是最容易被跳过的一段。
项目里有个模板叫 play.mjs。一个只用键盘的试玩场景。它靠读 window.__game 里的状态当眼睛,一边操作,一边判断自己现在在哪、还剩多少空间、下一跳够不够得着。
录制的脚本用 Playwright 按真实帧率把这段过程拍下来。另一个脚本再从录像里找出最热闹的那十秒。
然后 agent 去看这十秒。哪里掉下去了,哪里卡墙了,哪里空转三秒没人动,都在别人看见之前,先被自己修掉。
出厂标准一条条写死。完整试玩一遍,控制台零报错,不掉坑,没有空转的秒,视频里最关键的那一下要真的出现在画面里。
它先当了自己的第一个玩家。
在这条上我停了一下。我们平时讲 AI 写代码,默认验收是「人来看」。这里反过来了。写的人同时是验收的人,材料是录像和并排图,不是「我觉得差不多了」。
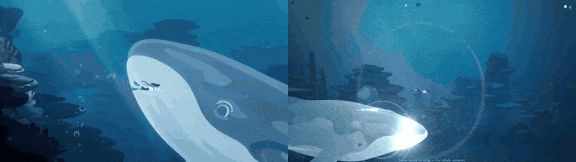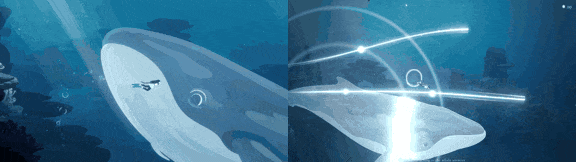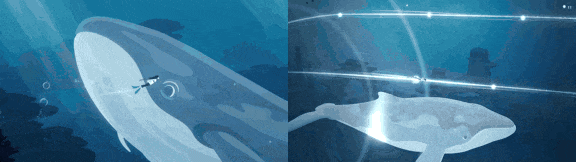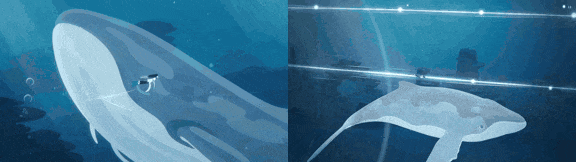
Whale Song,深蓝的海里,一个戴红围巾的潜水员和一头半透明的幽灵鲸
6
真正变了的,不是游戏
说回开头那个顺序。
以前做游戏,美术决定了想象力的上限。你想得出云海上的鲸,做不出来,就只能白想。
现在这个顺序是,先想出来,拍出来,再照着拍出来的东西做出来。中间那一步,把「想象」变成了「规格」。
我自己的判断是,这里最值钱的不是视频生成,也不是图生 3D,是那份从帧里读出来的 spec。
没有它,agent 拿到 594 张图也拼不出一个世界。有了它,图、模型、声音、雾、调色、泛光,全都有地方落脚。
顺带说清楚,这 31 个游戏都不大。屏幕上不放字,没有关卡菜单,没有存档,就是十几秒视频能承载的体量,一个机制,一个瞬间。拿它跟 3A 比没有意义。
但它证明了一件更小也更硬的事。一个说得清的美术方向,现在可以被完整地执行出来。
以前我们说,想法不值钱,执行值钱。
这一次,执行被压到了一段提示词的距离。
贵的东西,重新回到了那个还没被写下来的想象。
— 附 —
想自己玩,或者自己装
31 个游戏在 fal-video-to-game.vercel.app,点开就能玩,单机、双人、四人合作的都有。
Claude Code 用 claude plugin marketplace add lovisdotio/video-to-game 安装,Codex、Cursor 这类 agent 用 npx skills add lovisdotio/video-to-game。
要跑起来还得备好 Python 3.9+、ffmpeg、Node 18+ 和 playwright-core,再装 fal-client 并配好 FAL_KEY,资产都靠 fal 上的模型实时生成。
手上没有视频也不影响,仓库里的 prompts 目录放着 31 条能直接用的提示词。
仓库地址 github.com/lovisdotio/video-to-game。视频由 MiniMax H3 Max 和 Seedance 2.5 生成,代码、资产管线和试玩由 Claude Opus 5.5 完成,作者 Lovis Odin,MIT 协议开源。