ARTICLE · 1297687
AI的发展史
AI HISTORY · 1956—2026
AI 的七十年
一台机器,怎么学会看、听、说,最后学会自己做事
从麦卡洛克的一张电路草图,到今天会自己订机票的 Agent。中间隔了七十年,也隔了三次寒冬。
全文约 8000 字 · 慢慢看,大概二十分钟 · 27 张图,12 份原始资料
2022 年 11 月 30 日之后的那个星期,很多人的朋友圈被同一个截图占满:一个白色对话框,和一句「帮我写个……」。
大多数人当时的判断是,OpenAI 赢在产品——界面够干净,谁都会用。
这个判断只对了一半。对话框背后其实躺着七十九年的东西:1943 年有人在纸上画出了人工神经元的数学模型,1956 年一群人在达特茅斯的夏天给这门学问起了名字,1986 年有人终于想明白多层网络该怎么调参数,2017 年几个谷歌研究员把「排队读」换成了「同时看」。
这四件事,单拎哪一件都不像产品。攒到一起,才有了那个框。
本文分七段
一、机器想「想」这件事,卡在哪儿
二、一条拉直了的时间轴
三、九个阶段,九次换挡
四、六次能力跃迁
五、为什么偏偏是最近几年爆发
六、十二份值得自己翻一遍的原始资料
七、如果现在开始学,按什么顺序
一、机器想「想」这件事,卡在哪儿
人身上有些本事,机器看着都眼馋。
眼睛能看,耳朵能听,摔一跤就记住教训,听一句话能听出弦外之音,还能凭空琢磨出个原本不存在的东西。
把这几样翻译成研究课题,就成了六件事:怎么算、怎么推理、怎么从经验里学、怎么理解眼前的世界、怎么造出新的内容、怎么自己把活干完。
七十年的 AI 史,基本就围着这六件事打转。每一代人都只能啃下一小块,然后发现下一块更硬。
有个容易被忽略的地方:这六件事并不是排队解决的。视觉和语言几乎同时在推进,推理和生成长期各走各路。教科书为了好看,把它们排成一条线;真实的实验室里,是一堆互不通气的房间。
二、一条拉直了的时间轴
先把全景铺开。下面每一条后面都会展开,现在只需要有个方位感。
1943—1950 有人开始认真问:大脑能不能用电路画出来。
1956—1970 一群人在夏天开了个会,给这门学问起了名字。他们以为一个夏天就能推进一大步。
1970—1980 承诺兑现不了。钱停了,人散了,这行冷了十年。
1980—1990 通用智能太远,那就先把一个领域做窄、做深。
1990—2000 别写规则了,让机器自己从数据里找规律。
2000—2010 互联网、GPU、海量文本,三样东西慢慢凑齐。
2012—2016 图像识别的错误率从 26% 直接压到 15%,第二名还站在原地。
2017—2021 换掉循环结构,语言模型开始出现「越大越强」的势头。
2022—2023 交互门槛塌了。普通人第一次真的用上。
2024—2026 从「回答问题」走向「把事办完」,也第一次开始谈权限和可靠性。
这个分段是我为了讲清楚自己划的,不是学术界的标准分期。真正的技术史没有这么整齐——符号系统和神经网络争了三十年,视觉和语言各走各的路。别把它当成唯一答案。
三、九个阶段,九次换挡
第一阶段 · 1943—1950
理论萌芽
一个问题:大脑能不能用电路画出来?
计算机刚问世那几年,人们很快就撞上一个别扭的边界。
它算得极快。你让它算 1+1,它给你 2,零延迟。可你要是把一张照片推过去,问「这是不是只猫」,它就没反应了——不是算得慢,是根本无从下手。认出一只猫,得从一堆明暗不一的像素里揪出耳朵、胡须、脸型这些特征,再判断它们凑在一起意味着什么。这活儿以前只有脑子能干。
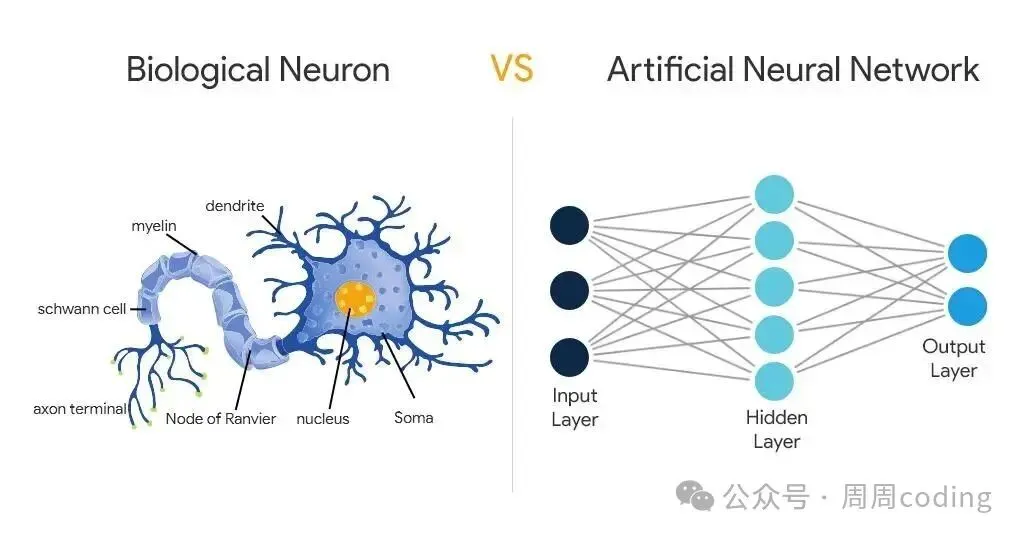
1943 年,麦卡洛克和皮茨发了篇论文,标题长得不像话:《神经活动中内在观念的逻辑演算》。名字吓人,想法其实很朴素:把神经元当成一个开关,若干路信号进来,各自带一个权重,加起来超过某个阈值就「通电」,否则不通。写成公式,只有几行。
来源:medium.com
来源:robotsauthority.com
这几行公式,是今天所有神经网络的祖先。当然,1943 年没人管它叫「人工智能」——这个词还得再等十三年。
不过这套模型有个前提:神经元之间得靠信号传递,权重得有人来定。谁来定?当时没人答得上来。
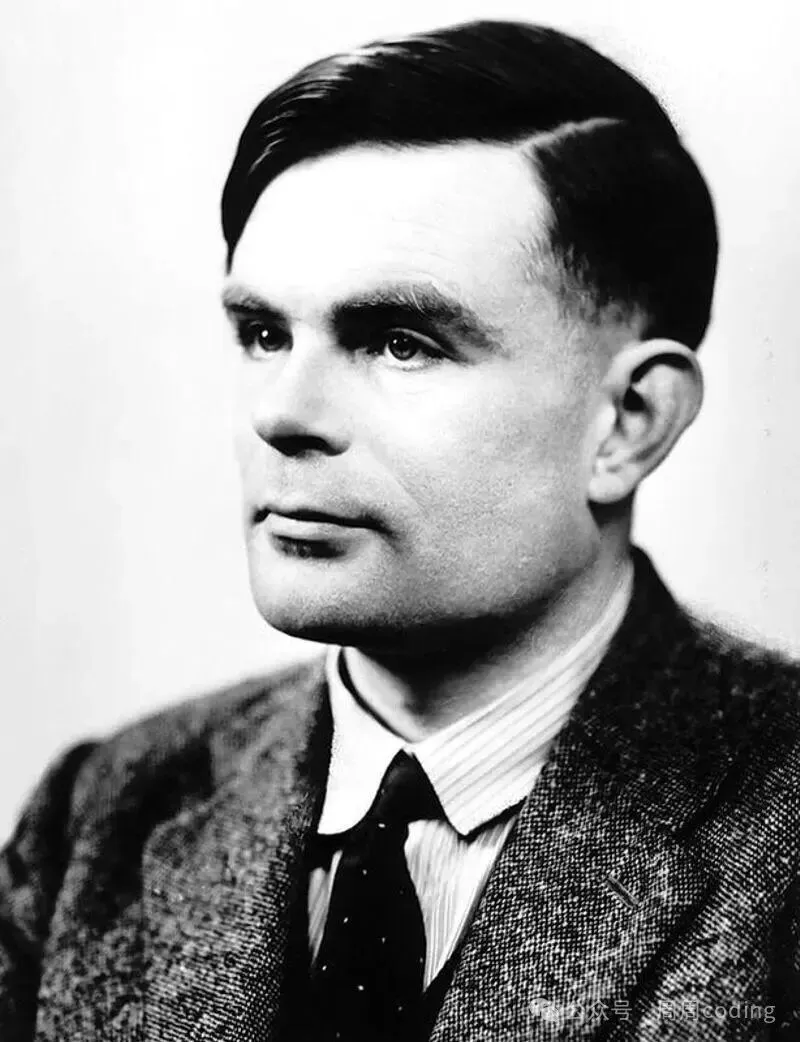
七年之后,图灵在《Mind》上发了一篇文章,标题本身就是个设问:《计算机器与智能》。
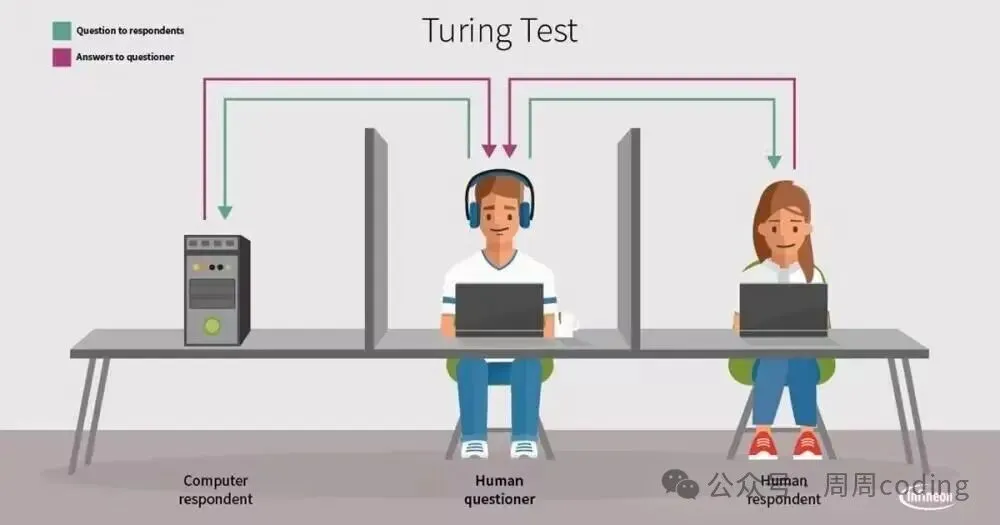
有意思的是他绕开了定义。「机器能不能思考」——什么叫思考?他不回答。他换了个问法:假如你隔着一堵墙,只能靠打字跟两个对象聊天,一个是人,一个不是。聊完你分不出来谁是谁,那这台机器算不算「会想」?
来源:Computer History Museum
Alan Turing,艾伦·图灵,英国数学家。这篇文章最有价值的地方,不是它给了答案,而是它把「机器能不能想」这个哲学问题,改造成了一个可以设计实验、可以争论、可以判对错的问题。
他在文末顺手给了个估计:大概到 2000 年,机器就能骗过三成的裁判。这个数字后来被引用过无数遍,也被证伪过无数遍——真到 2000 年,聊天机器人还在靠模板拼句子。
话说回来,二十三年后 ChatGPT 上线,玩的正是这套玩法。图灵猜错了时间,但没猜错方向。
来源:lopegonzalez.es
原文在这儿
· 图灵 1950,《Computing Machinery and Intelligence》
· 图灵数字档案(手稿和通信都在里面)
· 斯坦福 AI100 的历史附录
第二阶段 · 1956—1970
正式诞生,也正式夸大
他们以为一个夏天就够了
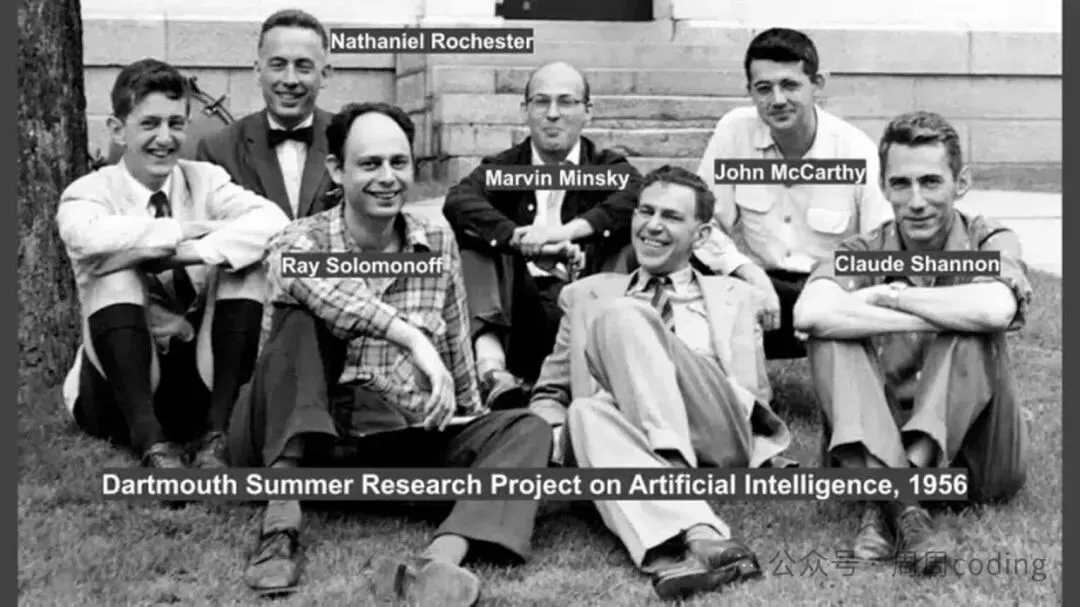
1956 年夏天,新罕布什尔州的达特茅斯学院来了一小群人。
他们打算用两个月、十来个人的时间,把「让机器模拟智能」这件事推进一大步。听起来像玩笑,可提案里写得一本正经:学习的每个方面,或者智能的任何其他特征,原则上都能被精确描述,以至于可以造一台机器来模拟它。
给这个项目起名的是麦卡锡,那年他二十九岁。他用了一个此前没人用过的词:Artificial Intelligence。
来源:infobae.com
后来大家把这场聚会当成 AI 的生日。严格说,它更像一次立项——会开得零零散散,不少人只来了几天就走了,最后也没留下什么统一结论。但名字留下了,人也认识了,这门学问从此有了一个可以拿去申请经费的名目。
那一代人的工具箱里基本只有一样东西:逻辑。
拿「判断一个人是不是成年人」举例。你给它写一条规则:年龄大于等于十八,输出「成年人」,否则「未成年人」。它答得又快又准。纽厄尔和西蒙那几年写出 Logic Theorist,能把《数学原理》里的定理一条条证出来。
这就是符号主义。人类把知识和判断写成条款,机器照着条款往下推。它确实解决了一类问题——过去被认为非得靠人脑才能干的活,机器第一次干成了。
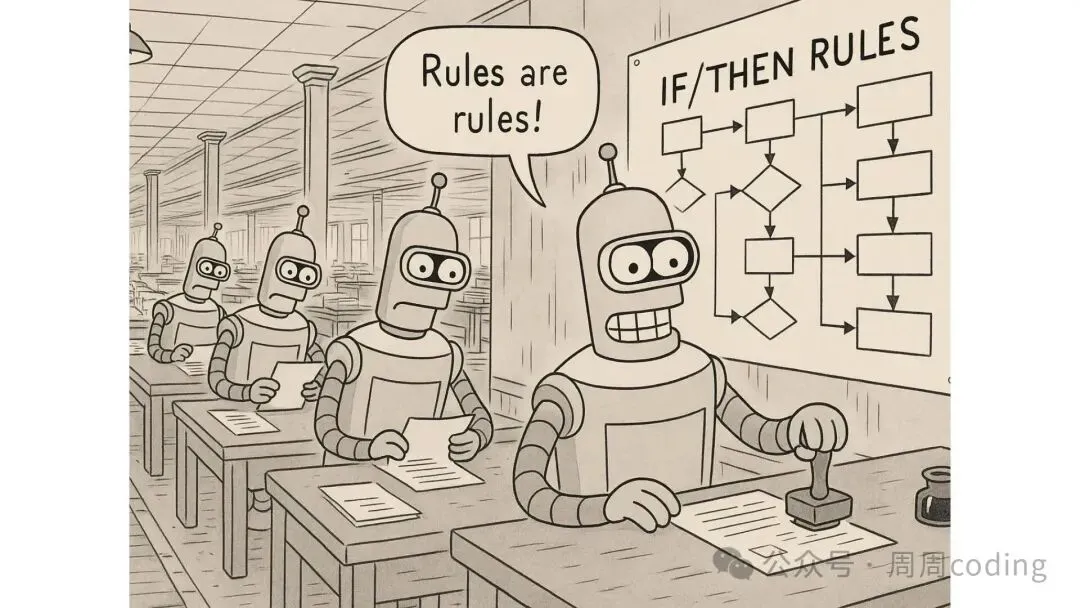
来源:medium.com
但现实里的问题,有几条能写成这么干净的规则?
「这个人是不是生病了」「这句话是不是在讽刺我」「这张图好不好看」——你试着写写看。写到第三条就会发现,条件之间开始互相打架,例外比规则还多。人类专家自己也说不清他的判断依据,他只是「一看就知道」。
这个坑,埋了十几年才炸。
原文在这儿
达特茅斯学院:The Founding and Future of AI · AI100 简史
第三阶段 · 1970—1980
第一次寒冬
钱停了
1973 年,英国政府请数学家 James Lighthill 来评估这件事。报告出来的措辞不太客气:这个领域的研究,没达到它自己承诺过的水平。
钱就停了。
来源:alicebot.org
严格说,那几年不是「没有进展」,是「进展和承诺之间的落差太大」。前面那批人许下的东西太满,公众记住了承诺,忘了技术限制。
拆开看,卡住的地方有三个。
算力不够。那时候一台机器的主存以 KB 计,跑今天任何一个玩具模型都撑不住。
数据不够。互联网还要等二十年,人类大部分文字还躺在纸上、胶片上、人的脑子里。
方法也不对。符号系统处理「如果 A 那么 B」很拿手,处理「这张脸看着有点像他」就彻底没辙。前者是逻辑,后者是感觉——而七十年代没有描述「感觉」的语言。
这件事后来被反复证明:一个技术方向能不能成,从来不只取决于想法好不好。数据和算力不到位,再漂亮的构想也只能停在论文里。
原文在这儿
Stanford AI100:AI Winter 一节
第四阶段 · 1980—1990
专家系统:把范围收窄
既然通用做不了,那就先做一个专科
寒冬之后,学界换了个思路:既然造不出通才,那就先培养一个专科医生。
专家系统是这么干活的:找一位在这个领域真的懂行的人,把他的判断一条条问出来,整理成规则库,机器再拿着规则去套。听上去笨,但在狭窄领域里出奇地好用。
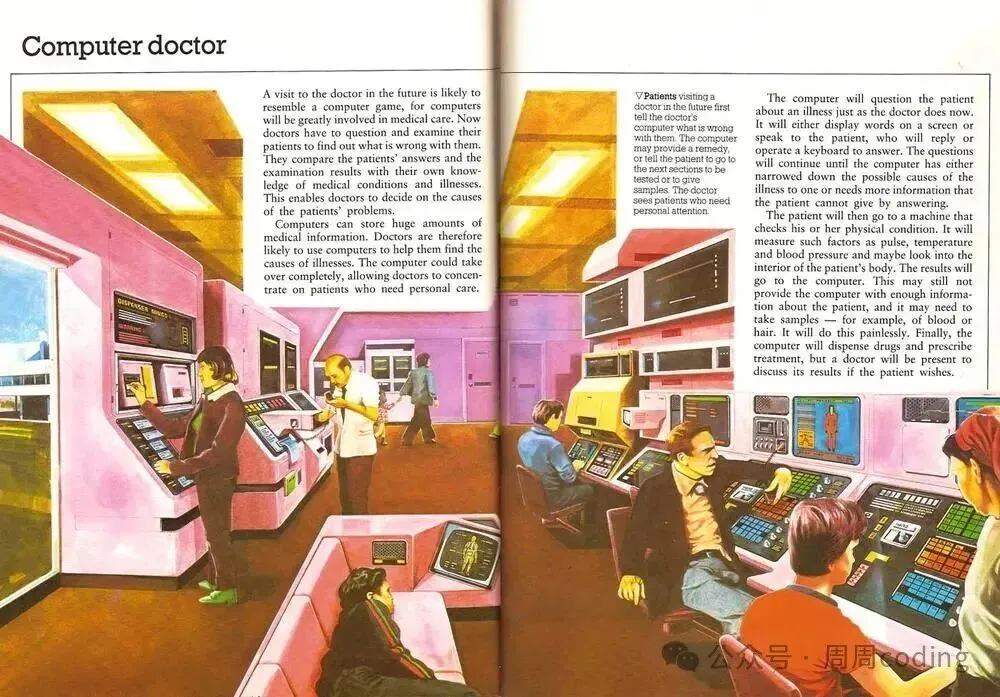
来源:paleofuture.com
最有名的案例叫 MYCIN,斯坦福在七十年代做的,专门看血液感染。它攒了几百条规则,输入症状和化验结果,输出可能的病菌和用药建议。
有意思的是,后来有评估发现,它在血液感染上的判断质量不输给当时的专科医生。可它几乎没进过真正的病房。
来源:alicebot.org
为什么?因为规则得有人一直养着。医生发现一条新情况,你就要回去改规则库;改到第五百条,第十条和第四百八十条开始互相矛盾,没人敢动。更要命的是新病菌、新药、新的检测手段一出现,整套规则立刻过期——它不会自己学。
于是有人提了个反过来的问题:能不能别教它所有规则,让它自己看数据?
顺带说一句,这套东西的血脉今天还活着。不少企业的客服机器人、风控规则引擎,骨架还是「知识库 + 一堆 if-else」,只是外面套了层对话界面。
原文在这儿
Stanford AI100:Expert Systems 与第二次寒冬
第五阶段 · 1980—2000
机器学习:别写规则了,调参数
问题从「怎么写」变成了「怎么调」
思路一转,问题的形状就变了。原来问「规则该怎么写」,现在问「参数该怎么调」。
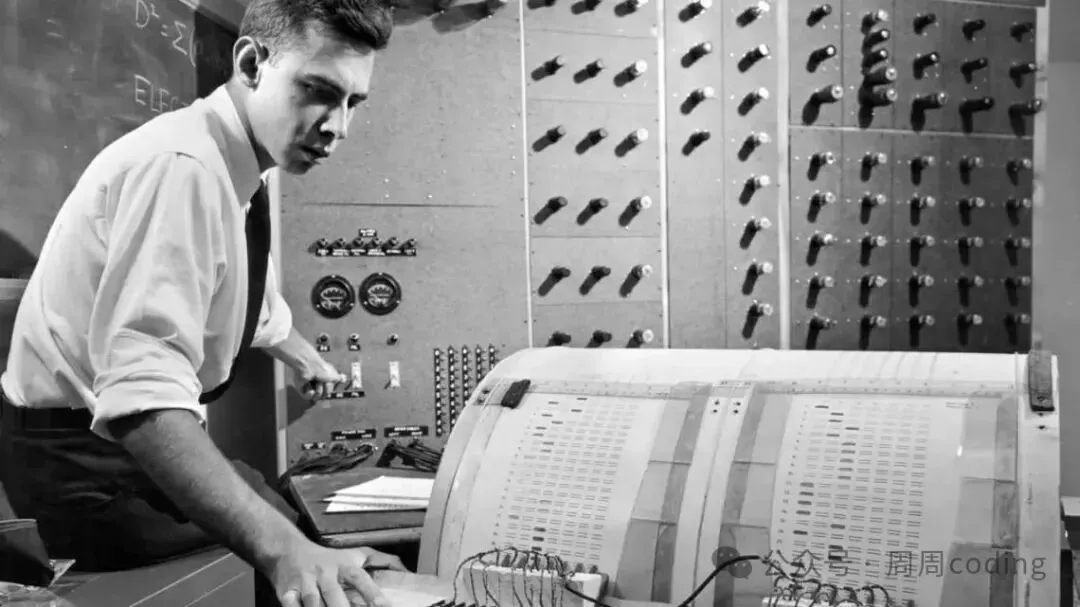
这事其实早有伏笔。1958 年,康奈尔的心理学家罗森布拉特做了台机器,叫 Mark I Perceptron,主体是四百个光电管拼成的一片「视网膜」,后面接一层可调权重的电路。他把权重做成旋钮,拧错了就重拧——机器在错误里自己找方向。
当时媒体很兴奋,报道说这东西将来能走路、说话、看东西。
来源:omnisearch.ai
兴奋没持续多久。1969 年,明斯基和佩珀特出了本书,就叫《Perceptrons》,里面证明了一件让人泄气的事:单层感知机连「异或」都算不了。异或是什么?「两个条件里恰好有一个成立」——就这么简单的一件事,一层网络做不出来。
这本书的杀伤力被后来的评论者认为夸大了,但它确实成了压垮神经网络的最后一根稻草之一。神经网络这条线,冷到了八十年代中期。
转机来自一个很笨的问题:既然一层不够,那就叠几层。可叠了层,怎么知道该调哪个参数?
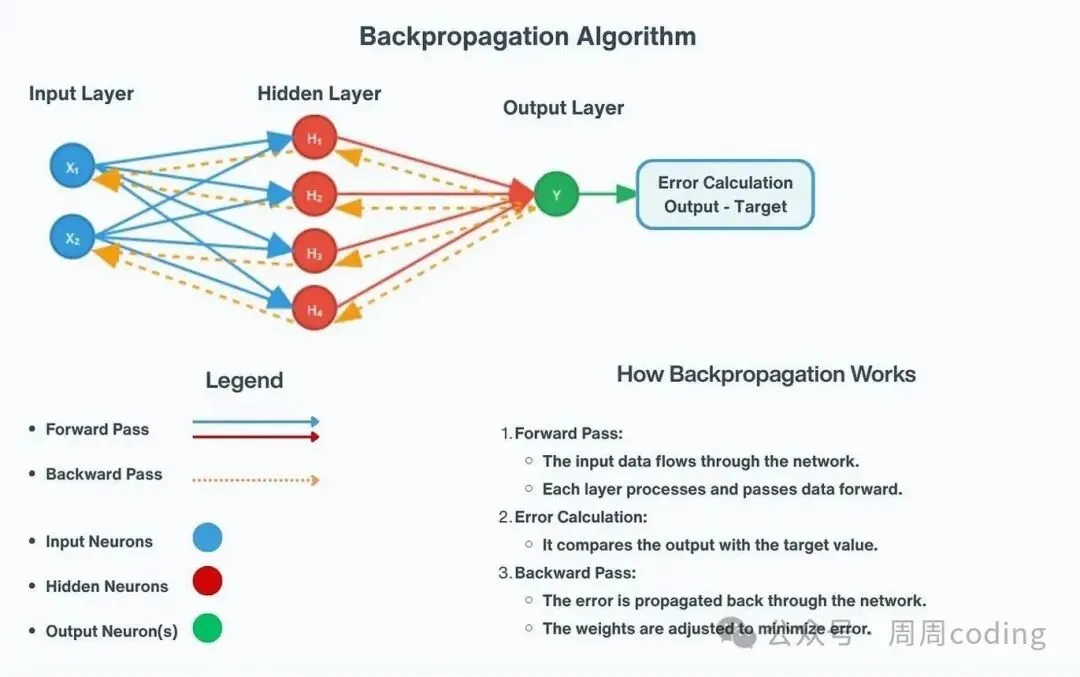
1986 年,鲁梅尔哈特、辛顿和威廉姆斯在《Nature》上给了答案:反向传播。
来源:medium.com
它的逻辑跟学生改错题一模一样。考了六十分,知道正确答案是一百分,差在哪、差多少,从最后一层往前一层层算回去,每层领一份责任,各自微调一点点。下一次再考,误差小一点。重复几万次。
说起来这套思路并非 1986 年首创,更早有人提过。但那篇论文把它讲清楚了、跑通了、让整个领域相信它可以规模化。有时候一个方法能不能活下来,取决于有没有人把它讲到别人愿意用。
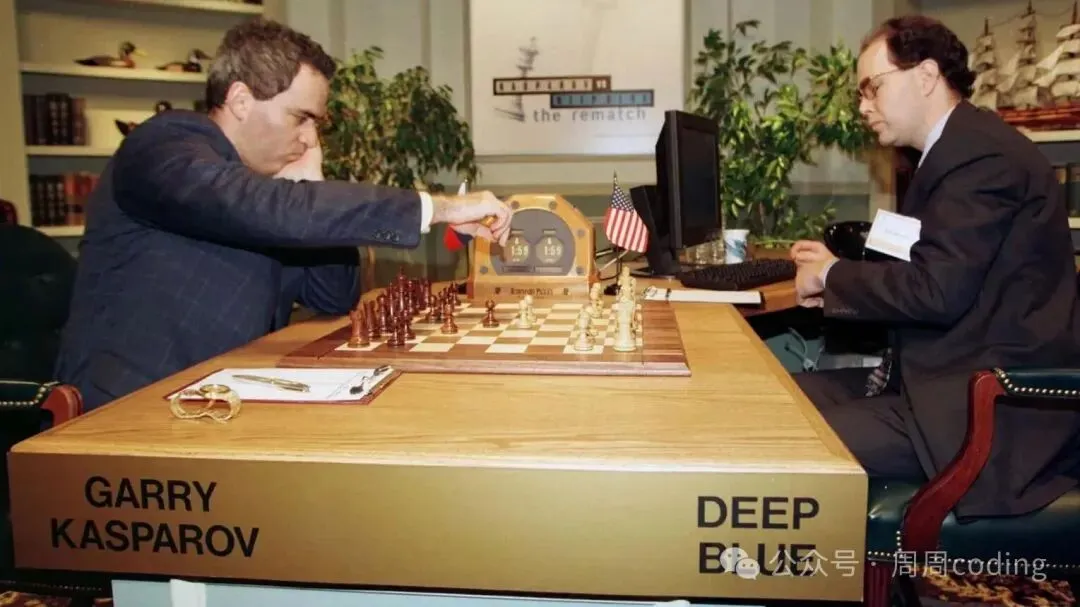
再往后是 1997 年 5 月,纽约。IBM 的深蓝跟卡斯帕罗夫下了六盘,三胜一负二和。
来源:theworld.org
那场比赛的意义,不完全在棋上。它第一次给了「机器能不能比人强」一个具体的、可以被指认的对象——不是设想,是一台摆在纽约的机柜。
但这里有个特别容易搞混的地方:深蓝不会下棋。
它没看过一盘棋谱去「学」,它的做法是每秒算两亿个局面,配上一个人手写的评估函数。赢棋靠的是搜索深度和算力,跟今天那种靠数据喂出来的模型,是完全两条路。
这一点值得记牢:AI 不等于机器学习。同一种「智能表现」,背后可以是暴力搜索,也可以是统计学习。分不清这两者,后面很多新闻都会看歪。
这一阶段的转向,说到底是把主语换了。以前是「人告诉机器怎么办」,现在是「机器自己从例子里琢磨怎么办」。人从出题人,变成了提供题库的人。
原文在这儿
· Rumelhart, Hinton & Williams, 1986(Nature)
· IBM 的深蓝档案
· AI100 简史
第六阶段 · 2000—2012
三样东西,同时到位
深度学习不再是空谈
AI 在 21 世纪翻身,靠的不是某一篇论文。是三个东西同时到位。
数据。互联网把人干过的事全记下来了:照片、帖子、点击、订单、导航轨迹。以前训练一个模型要找实验室借数据集,现在数据是自己涌过来的。
算力。GPU 本来是为打游戏做的,结果发现它擅长的矩阵乘法,正好是神经网络最吃力的部分。这是个很典型的意外——为另一件事造的锤子,敲开了这扇门。
方法。网络结构、初始化、正则化,这些琐碎的工程细节一点点被磨出来。单个看都不像突破,攒起来才让「深」这件事真的能训。
来源:ainvest.com
2012 年秋天的 ImageNet 竞赛,是这三样东西第一次同时显形。
三个年轻人——克里热夫斯基、苏茨克维、辛顿——交了一个叫 AlexNet 的模型。成绩出来,Top-5 错误率 15.3%。第二名 26.2%。
这个差距在竞赛史上是反常的。往年的进步以零点几个百分点计,评委们习惯了慢慢挪。这一次直接跳了一档。
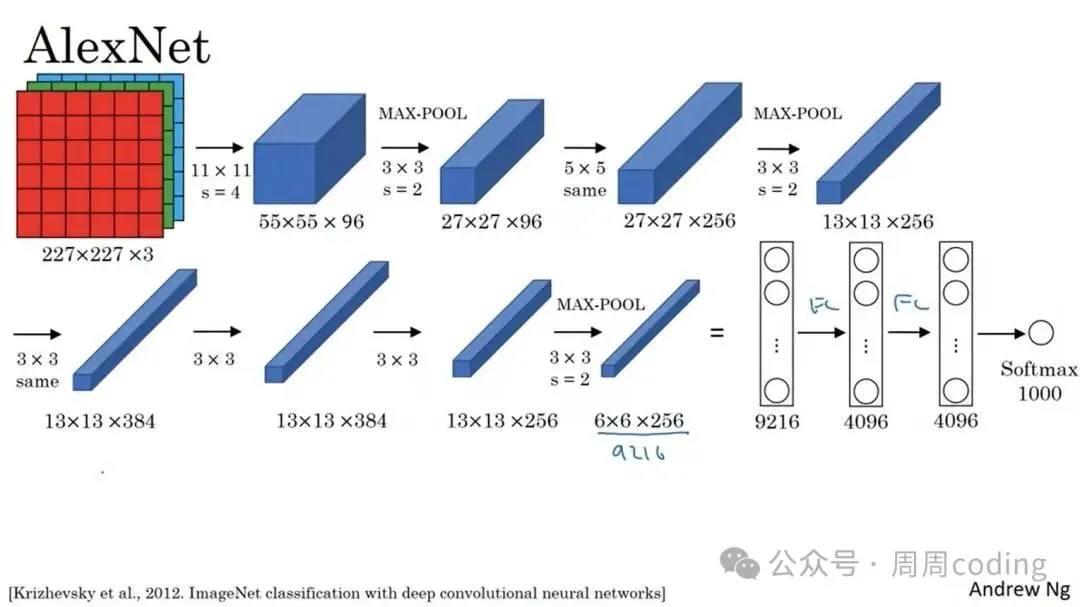
来源:medium.com
更有意思的是它的硬件:两张 GTX 580 显卡,加起来 6GB 显存。今天你手里任何一台游戏本,算力都比它高出十几倍。所以 AlexNet 真正的贡献不是「算得多」,而是证明了「这么算,值得」。
学界的反应很快。此前深度学习在顶会里属于偏门,第二年就变成了主流。一个数字改了整个领域的品味。
四年后,AlphaGo 把战场搬到了围棋。
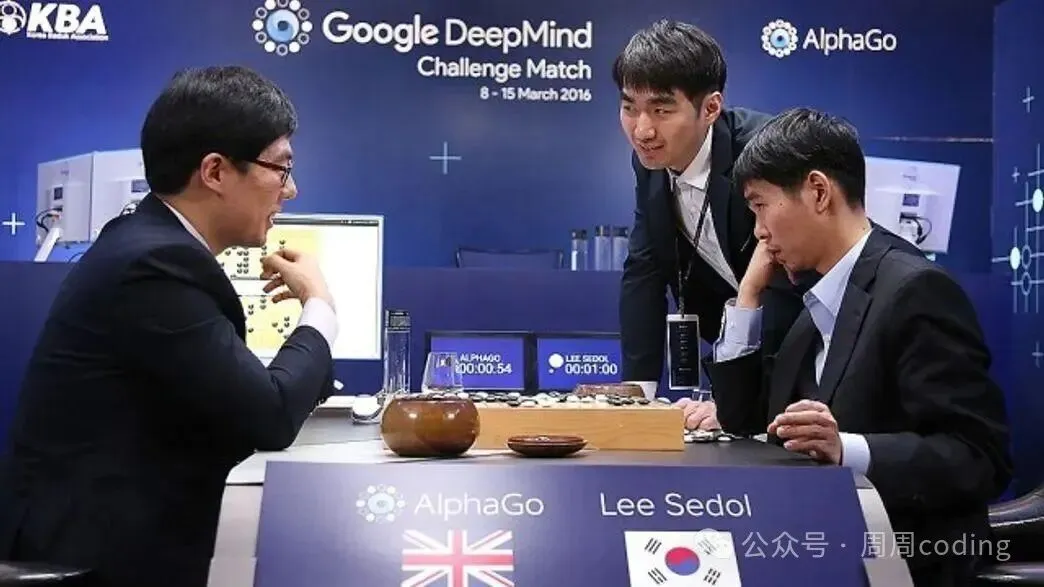
来源:iflscience.com
围棋难在哪儿?国际象棋的分支还能靠算力硬扛,围棋一盘棋的可能局面数比宇宙里的原子还多,蛮力搜索走不通。
AlphaGo 的办法是「感觉 + 算」:策略网络负责猜「人大概会往这儿下」,价值网络负责估「现在这盘我赢面几分」,两个网络都靠自我对弈喂出来——自己跟自己下几千万盘,从输赢里学。
第二局第 37 手,它下了一步五路肩冲。这步棋不在人类棋谱里,解说员一度以为程序出错了。后来复盘才发现,那是一步好棋——只是好得不像人。
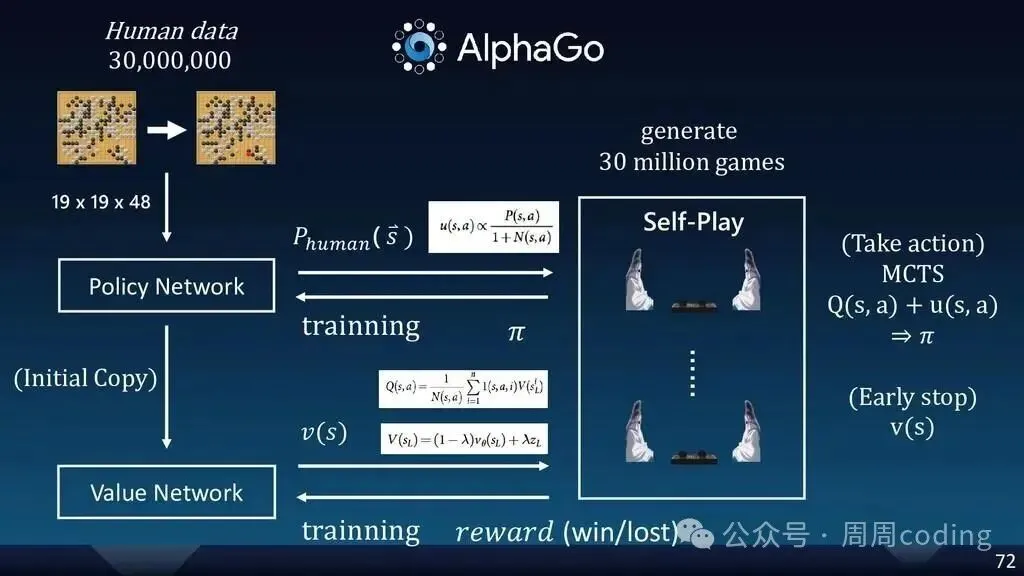
来源:speakerdeck.com
这一阶段真正变化的东西,比「机器更准了」要深一点:它开始能在没有标准答案的地方做选择。看图和下棋是两回事,后者需要判断、取舍、承担后果。
原文在这儿
AlexNet 论文 · DeepMind 的 AlphaGo 技术页
第七阶段 · 2017—2021
Transformer:把排队改成开会
一个指代问题,逼出了一种新结构
先做个小测试。
读这句话:「小明把苹果放在桌上,因为它很滑。」这个「它」指什么?
多数人会先说桌子,然后顿一下,改成苹果——苹果才可能滑,桌子一般不滑。这个「顿一下」的过程,就是语言理解。你调用了常识,也调用了上下文。
机器以前做不好这件事,因为它一个词一个词往后读,读到「它」的时候,前面那些词的印象已经淡了。
2017 年,谷歌的八个研究员交了篇论文,标题起得很硬气:《Attention Is All You Need》。
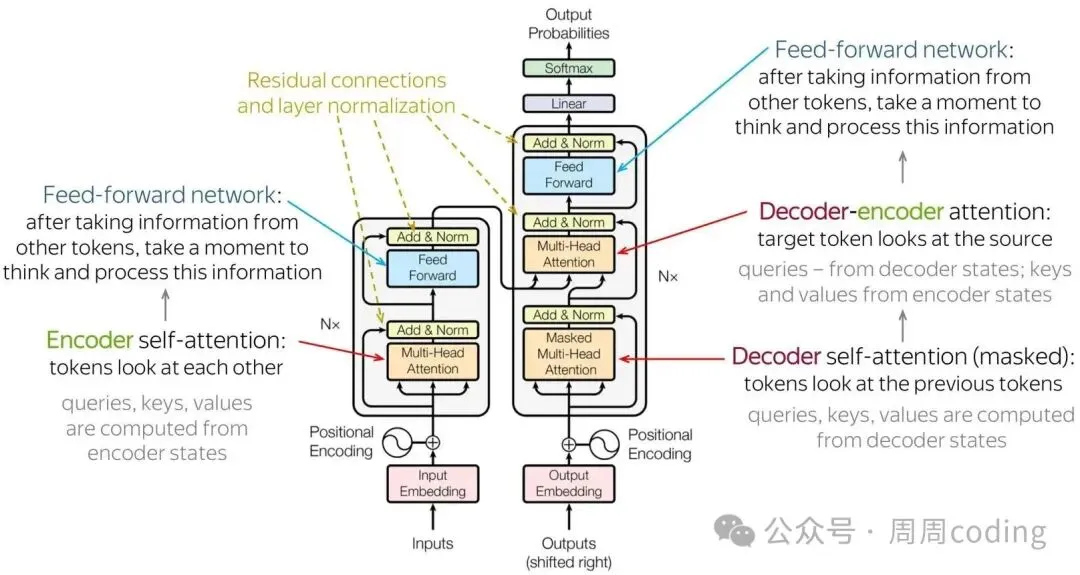
来源:toloka.ai
注意力机制干的事,说得直白点:让每个词自己去问其他词一句「咱俩有多熟」,然后把答案按亲疏加权汇总。
更关键的是它顺手解决了效率问题。原来的循环网络必须排队,一个词算完才算下一个;Transformer 让所有词同时进场,像开会而不是像传话。这一改,训练规模才可能往上堆。
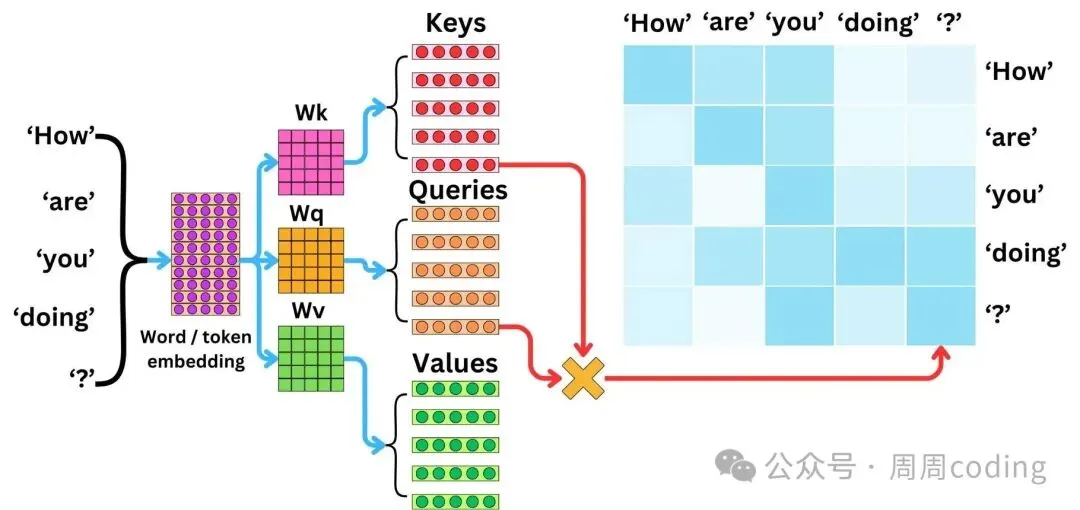
来源:newsletter.theaiedge.io
2018 年谷歌又放出 BERT。它跟 Transformer 的关系像同一套骨架的两种练法:BERT 让每个词同时看左右两边,适合理解;后来 GPT 那条线只看左边,适合往下续写。
2020 年,GPT-3 出来了。1750 亿参数。
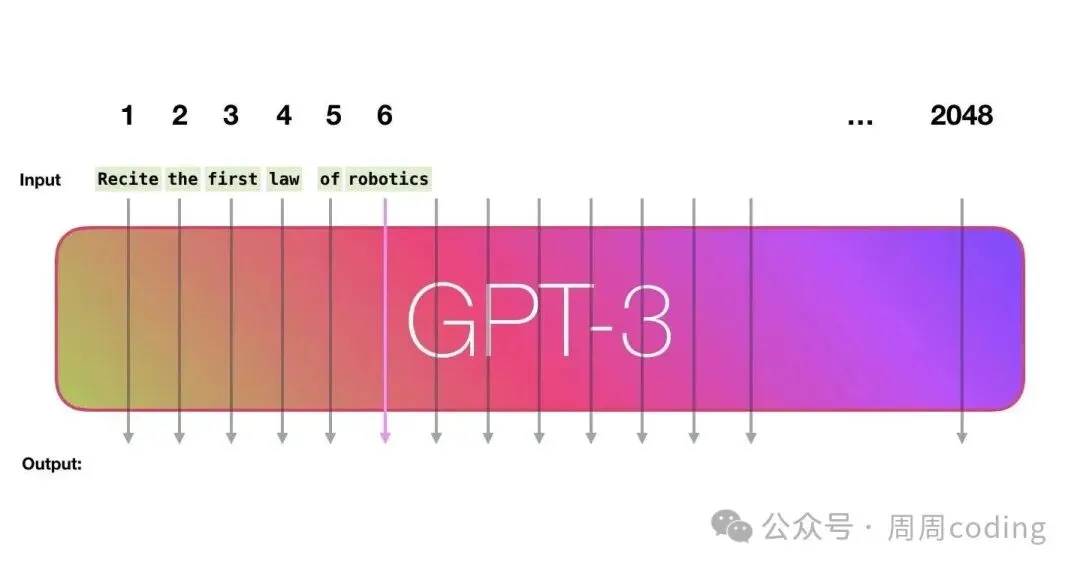
来源:jalammar.github.io
1750 亿是个什么概念?每个参数按一字节粗算,光把模型装进内存就得 175GB。当年训练它的账单,按公开估算在千万美元量级。
论文里真正让人坐不住的不是参数量,是一种叫「少样本学习」的现象:你给它两三个例子,甚至只给一句指令,它就能把新任务做得像样。它没为这个任务专门训练过。
这里得泼一盆冷水。
GPT 并没有「学会」人类的知识。它学的是词与词之间的统计关系。你把海量文本喂给它,它记住的是「在这个语境下,下一个词大概率是什么」,而不是「这件事在物理世界里是怎么回事」。
打个不太严谨的比方:它像一个把整座图书馆读完、但从没做过一次实验的人。谈什么都头头是道,真让他上手修个水管,就未必。
原文在这儿
Transformer 原文(arXiv) · Google Research 条目 · GPT-3 论文
第八阶段 · 2022—2023
门槛塌了
五天,一百万人
2022 年 11 月 30 日,OpenAI 挂出一个「研究预览」版本,名字叫 ChatGPT。
五天,一百万注册用户。这个速度在当时是没见过的。
来源:kommo.com
它做对的那件事,技术上讲并不新鲜。底层模型 GPT-3.5 已经存在好几个月,能调用它的 API 也早就在。变的是壳:一个空白的输入框,没有参数,没有提示词模板,没有「请先阅读文档」。
以前用 AI,门槛在编程和术语。现在门槛只剩「你会不会打字」。
另一件事常被忽略:RLHF。简单说,就是找一批人给模型的回答打分排序,模型朝着「人更喜欢的那一档」去调。这套办法不提模型的水平,但很会改它的语气——从「我猜可能是」变成「你可以这样试试」。
很多人第一次觉得「它好像懂我」,其实是被这一点打动的。
来源:tn.com.ar
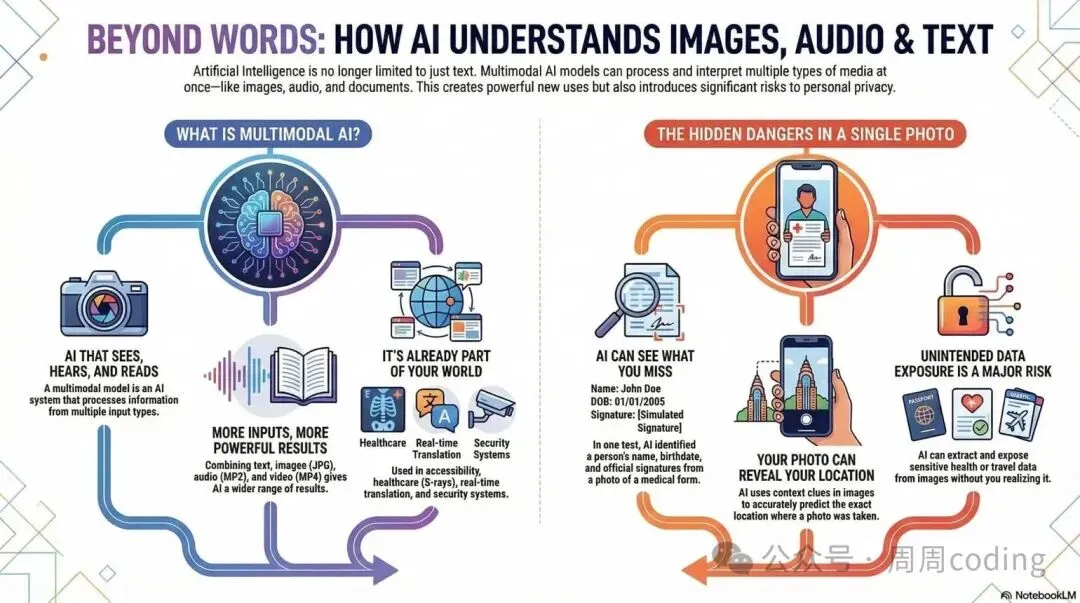
2023 年 3 月,GPT-4 来了。跟只会读文字的版本比,它能看图了:你把一堆数据图表截图丢过去,问「这组数据说明什么」,它能讲出个大概。
同年 12 月,谷歌发布 Gemini,宣传口径是「从第一天就按多模态设计」。是不是真从第一天就长这样,外界无从验证;但方向很清楚——文字不再是唯一的入口。
来源:forum.code.org
原文在这儿
OpenAI:Introducing ChatGPT · GPT-4 · Gemini
第九阶段 · 2024—2026
从答题到办事
它开始自己动手了
2024 年 2 月,OpenAI 放出了 Sora 的演示片段。输入一句话,出来的是一段可以慢慢看的动态画面。当时圈内讨论最多的不是画面质量,是那几段视频里「东西会不会突然消失又出现」——因为物理规律守不守得住,才是这类模型真假的试金石。
来源:ai-trends.blog
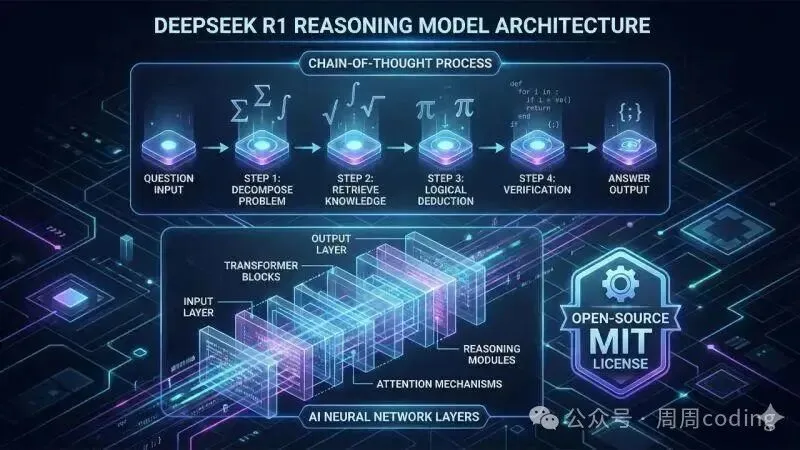
三个月后是 GPT-4o,重点在「实时」:说话不用等它转成文字,语气、停顿、被打断,都处理得下来。九月,o1 出来了,换了个训练思路——不急着给答案,先在内部多想几步。
这个思路的公开解读里,「思维链」和强化学习被提得最多。说得糙一点:以前训练它「答得快」,现在训练它「答之前先想想」。人类做题本来就这么干,机器绕了一大圈才回来。
2025 年 1 月 20 日,DeepSeek 发布 R1,把这条路线的权重公开了。这件事的影响有两层:一层是技术上的,证明用强化学习做推理不必非得关起门来搞;另一层是心理上的,很多人第一次意识到,前沿模型的名单不再是固定的那两三家。
来源:linkedin.com
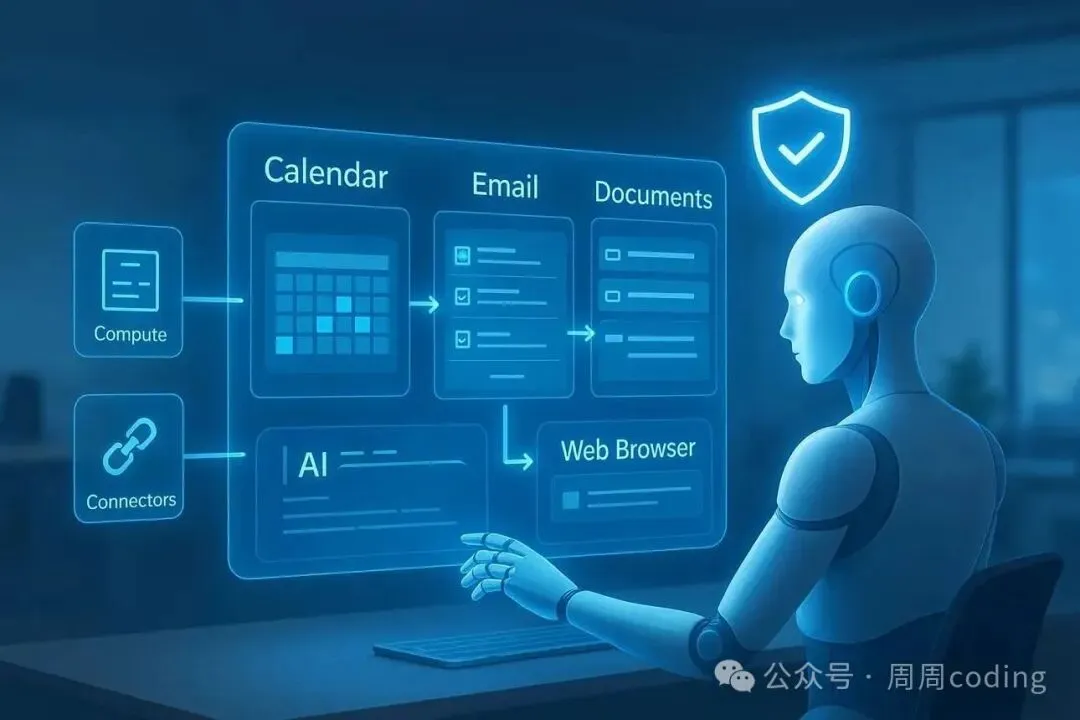
然后是 Agent。这一年多,几乎每家都在讲这个词。
它想解决的问题很具体。你让 ChatGPT「安排一趟去大阪的三天行程,预算八千」,它给你一份漂亮的路书。然后呢?机票你自己搜,酒店你自己比,行程你自己往日历里敲。它出主意,你干活。
Agent 想做的是把后半段接过去:拆任务、开浏览器、比价、填表,走到付款页停住,回头问你一句「用哪张卡」。
「回头问一句」这个动作,恰好划出了今天的能力边界。它不是不能自己付,是不敢。权限、责任、可撤销性,这些问题一个都还没解决。
来源:windowsforum.com
Agent 不是某天突然发明的新算法。它是规划、工具调用、长上下文、多轮纠错这些能力的拼装体。拼装体的问题是:任何一环不稳,整体就不可靠——这也是为什么演示视频永远比实际体验好看。
原文在这儿
Sora 技术说明 · o1 的推理路线 · DeepSeek-R1 论文
四、六次能力跃迁
把这七十年拉直了看,能看到六次换挡。每一次都不是「变强了一点」,而是「能干的事换了一类」。
从算数到推理。早期机器只会加减乘除,人得把问题翻译成算式。符号主义那批人想让它自己往下推,于是有了定理证明程序。这一步的野心不小:不只是算得快,而是「知道自己在算什么」。
从写规则到看数据。规则写不完,这是七十年代最痛的一课。转向机器学习之后,人的角色从「定规则」变成「给例子」。这个转变听着技术,实际上是权力转移——决定机器行为的,从工程师变成了数据。
从浅层到深层。一层网络只能画直线,多层才能画曲线。这句话听起来简单,中间隔了将近二十年——因为层一多,参数就没法调了。反向传播补上了这块,深度学习才真正成立。
从识别到生成。识别是「这属于哪一类」,生成是「造一个出来」。前者有标准答案,后者没有。机器开始做没有标准答案的事,评判标准也就从「对不对」变成了「好不好」——这个变化带来的麻烦,比技术进步本身更多。
从单模态到多模态。文字、图像、声音、视频原本是四个独立赛道,各有各的模型。把它们放进同一个表征空间,等于让机器第一次有可能理解「这张图配这句话是什么意思」。
从回答到办事。前五次跃迁都在改善「输出的质量」,这一次改的是「输出的终点」。它不再交给你一段文字,而是交给你一个已完成的动作。风险也在这里——文字错了可以删掉重来,事情做错了,得去收拾。
请在微信客户端打开
五、为什么偏偏是最近几年爆发
这个问题被问过很多次,标准答案是「算力、数据、算法」。答案没错,但太干净了,解释不了为什么是 2022 而不是 2015。
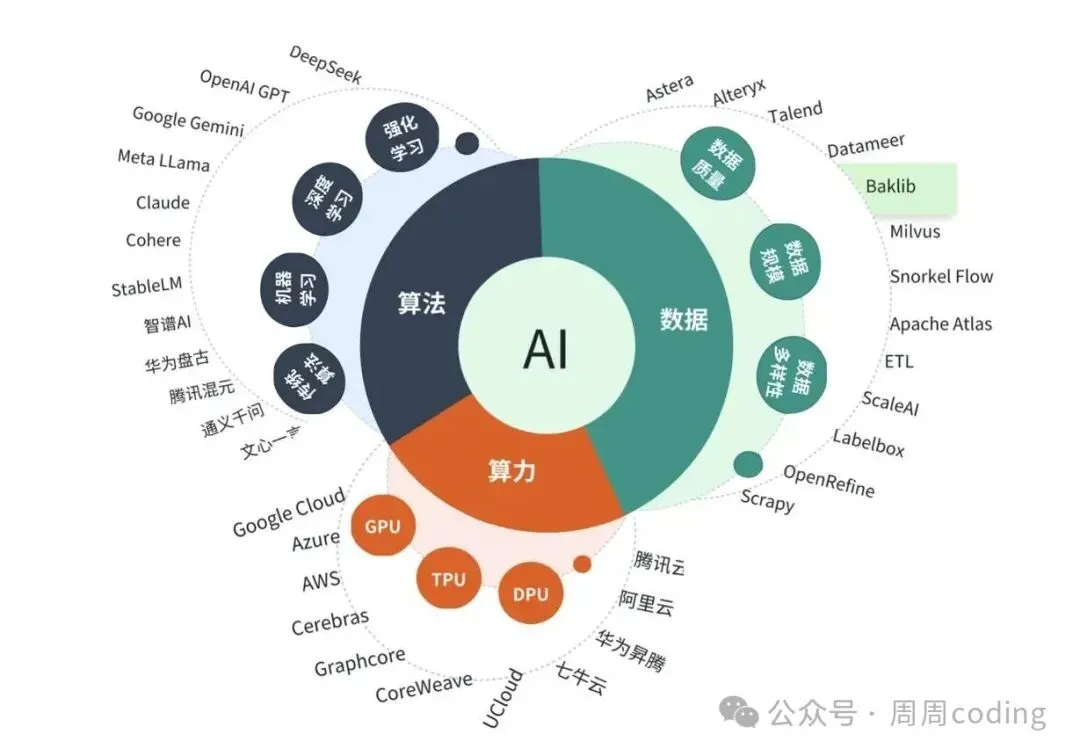
我的看法是,这五样东西凑到了一起,而且它们会互相喂养。
来源:woshipm.com
这五项不是并列关系,是滚雪球。算力上去,模型变大,能力变强,用户变多,收入变多,才敢继续买卡。反过来任何一环断了,雪球就停在原地——七十年代和九十年代,都是这么停的。
所以我倾向于认为,AI 这波不是某个人天才的结果,也不是单点突破。它更像一堆零件终于凑齐,然后有人把它们拧在了一起。
六、十二份值得自己翻一遍的原始资料
二手解读看多了容易失真,原话还是得自己读几页。下面这份清单我隔一阵会翻一遍,每次注意到的点都不太一样。
如果只挑三份
我选 1950、1986、2017。第一份告诉你问题是怎么被提问的,第二份告诉你学习是怎么发生的,第三份告诉你今天这一切为什么能规模化。剩下九份是血肉,这三份是骨头。
还想再往里走一层,可以看斯坦福的 AI100 百年研究计划的附录。它把技术脉络和社会影响放在一起讲,相对来说不那么技术宅。
请在微信客户端打开
七、如果现在开始学,按什么顺序
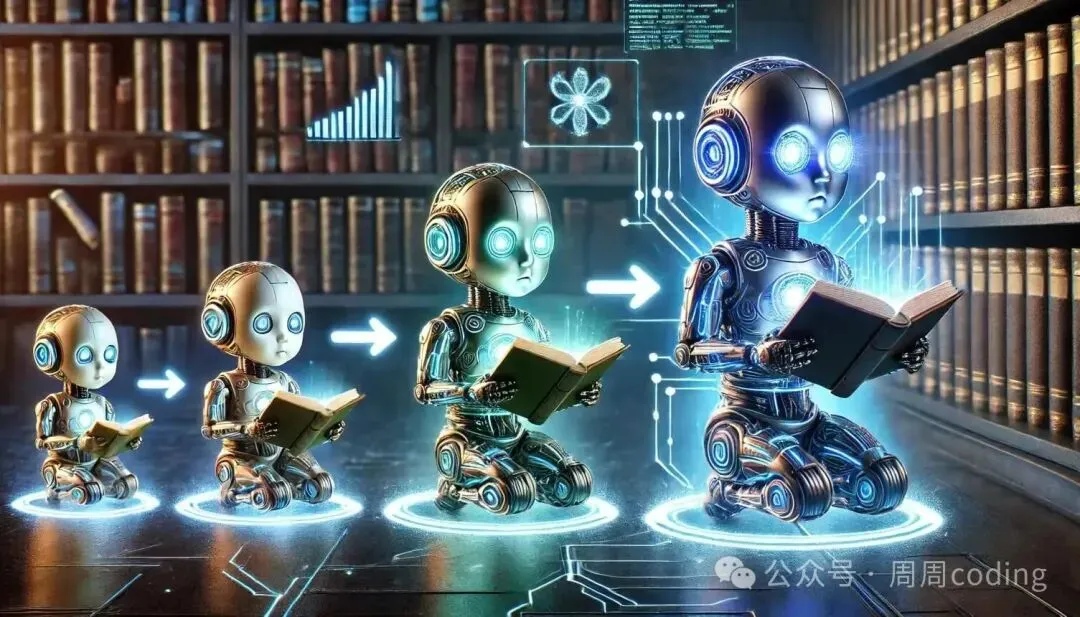
这七十年,与其说是在造机器,不如说是在带一个徒弟。
头二十年,师傅把规矩一条条写给他看。后来发现规矩永远写不完,改成扔一堆案例,让他自己总结。再后来,给他看图纸、看录像、看整个行业的档案。现在,敢让他自己出门办事了——只是还得有人在旁边盯着,尤其是付钱那一步。
来源:medium.com
不过有一点得说清楚:这个徒弟越能干,越不代表他懂了。他答对一道题,可能只是见过太多相似的题。这是统计学习的天花板,也是它最容易被误解的地方。
所以真正该问的,不是「它有多强」,而是:它能解决什么、凭什么解决、在哪儿会翻车、翻车了怎么办。
请在微信客户端打开
如果你从零开始,我建议按这个顺序走,不要跳。
机器学习 先弄明白「从数据里找规律」这句话落到地上是什么样。梯度、损失、过拟合,这三个词绕不过去。
神经网络 一层层叠起来的东西,内部到底长什么样。重点不是公式,是「为什么叠起来就能表达更复杂的东西」。
深度学习 训练为什么难,为什么深了反而更好。到这儿你会第一次碰到「调参像玄学」的挫败感。
Transformer 注意力到底在算什么。这一块卡住的人最多,值得多花两周。
大语言模型 预训练、微调、对齐,三个阶段各自解决什么问题。对齐那一环最容易被跳过,但它解释了模型为什么「看起来有礼貌」。
Agent 规划、工具、记忆、纠错,四件事怎么拼。到了这里你会发现,难的不在模型,在工程。
每学一个概念,别急着往下翻。先问自己三句话:它解决了前面哪个卡点?靠什么办法解决的?这个办法在什么情况下会失效?
第三问最有用。前面两个问题任何一本教材都会告诉你答案,第三个问题往往得自己撞一次墙才明白。
最后说一句我自己的看法
这七十年最值得学的地方,不是那些成功的方法,是那些失败的分岔。符号主义、专家系统、单层感知机,它们当年都被寄予厚望,最后都没走通。可正是这些走不通的路,逼出了后面的答案。
看 AI 的新闻也是一样。一个模型今天刷屏,三个月后可能就没人提了。真正沉淀下来的,往往是那几个不起眼的改动——比如把排队改成开会。
请在微信客户端打开