ARTICLE · 1299644
咨询|AI 用得差,别急着怪模型
STATE OF AI 2026 精读 · 第①篇
AI 用得差,别急着怪模型
每个咨询人、法律人都该补的一课:Harness
你大概率经历过这样的时刻:
同一个 AI 模型,上周帮你把行业分析写得像模像样,这周连一份会议纪要都整理得丢三落四。你的第一反应是什么?换模型。上最新的、最强的、最贵的那一个。
结果往往令人失望:钱花了,输出并没有质的变化。
先别急着下"AI 不行"的结论。2026 年 10 月发布的《State of AI Report》用一整条研究线索告诉我们:你的 AI 表现不稳定,问题可能不在"脑",而在"壳"。
这个"壳",就是今年报告里最值得每个知识工作者理解的概念——Harness(模型外壳)。
先用报告的原始定义:
"A harness is the software around a model, like Claude Code or Codex CLI, that runs its commands and stores its memory and skills."
翻译成非技术语言:模型是大脑,Harness 是这个大脑所在的整体工作环境——它能看到什么文件、能用什么工具、带着什么记忆、按什么流程干活。
打个比方:同一位主厨,食材一样、手艺一样,但你把他从路边大排档换进一套米其林后厨——刀、灶台、备菜流程、出品标准全变了,端出来的菜就是不一样。
你其实每天都在体验这个差别:同一个模型,在网页版聊天框里,和接入了你的文件、模板、工具的那个版本里,表现判若两模。差别不是玄学,也不是运气——是"壳"的差别。
今年报告里关于 Harness 的证据,密集得罕见。挑三组最硬的:
第一组:7.8 倍。一组受控实验把 3 个模型分别装进 3 种外壳,跑同样的 100 道任务。结果发现:外壳不同造成的成绩波动,是模型本身差异的 7.8 倍。换句话说,你以为你在比较模型,其实大部分时候你在比较外壳。
第二组:弱模型反超强模型。同一个模型 Haiku 4.5,在 Claude Code 这个外壳里得分 27.5%,换进一个叫 Meta-Harness 的外壳,直接干到 37.6%——模型没换、任务没换,只换了壳。更夸张的是 WeaveBench 上的结果:Qwen 3.7-Plus 这个相对较弱的模型,换上长程任务外壳后,成绩反超了更强模型 Opus 4.7 的基线。
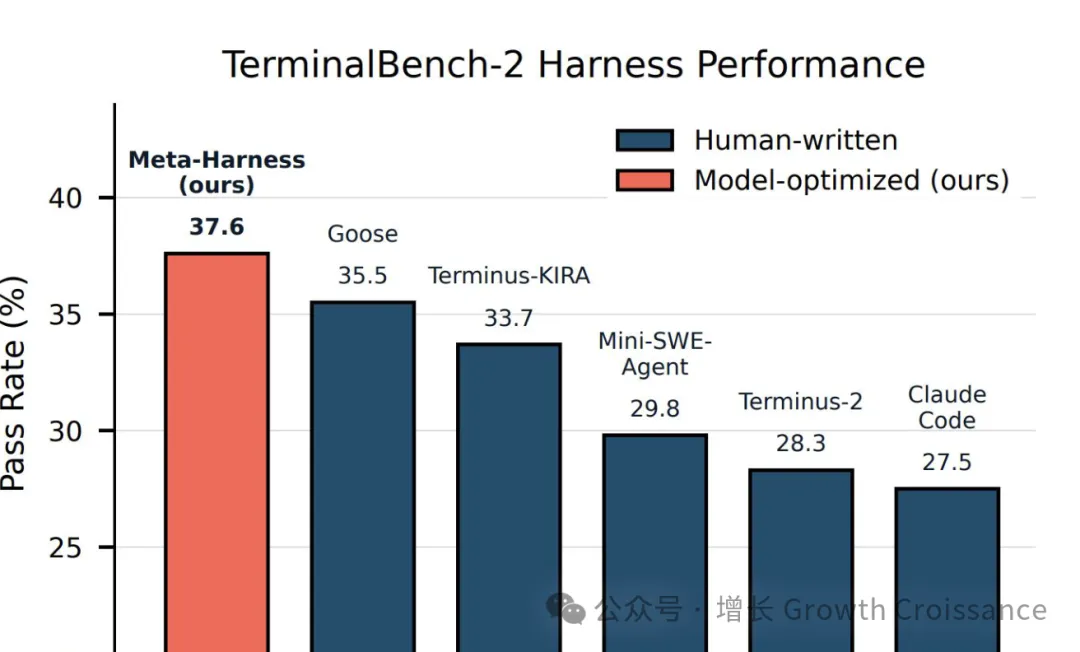
▲ 同一模型在不同外壳下的 TerminalBench-2 成绩,截自《State of AI Report 2026》
第三组:62.3 vs 39.4。安全评测 HarnessSafe 给同一个模型 GPT-5.6 Sol 在不同外壳里打分:在 Codex CLI 里 62.3 分,换到 Claude Code 里只剩 39.4 分,相差 23 分。而整个榜单上,换壳造成的影响(23 分)与换模型造成的影响(36 分)几乎在同一量级。
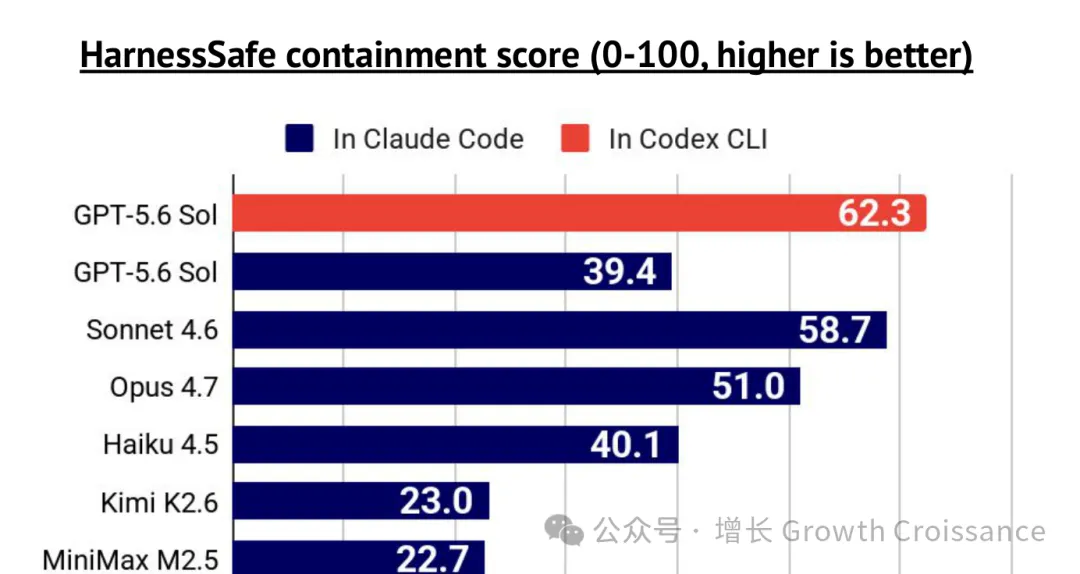
▲ 同一模型在不同外壳中的 HarnessSafe 分数,截自《State of AI Report 2026》
还有一张更直观的图:在最难的 ARC-AGI-3 交互推理榜上,同一个 Astra 模型,用标准外壳得 62.7%,换上"状态持久"外壳后得分99.9%——几乎追平人类的 100%。
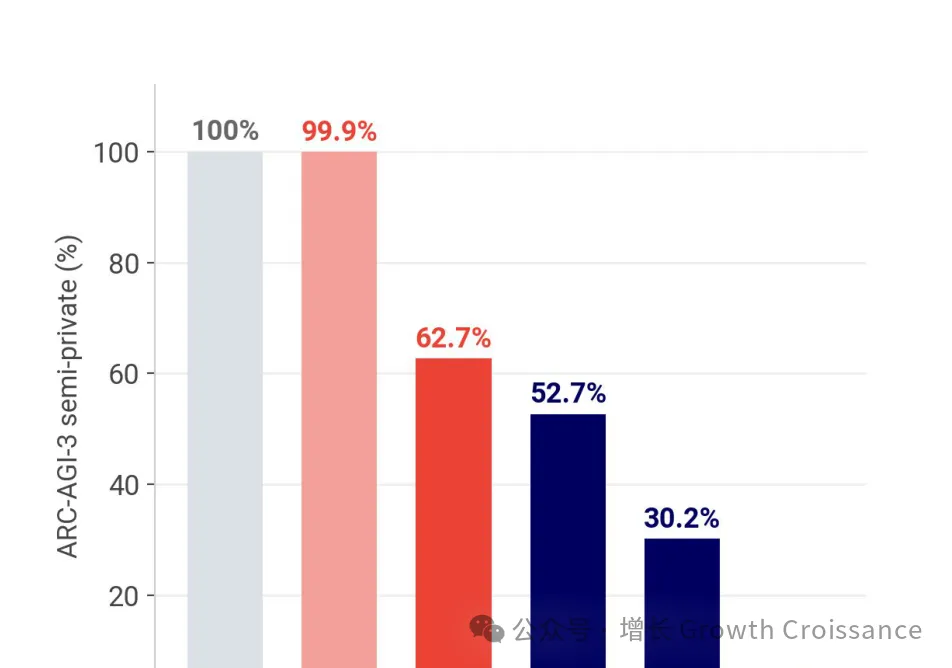
▲ ARC-AGI-3:同一模型换外壳前后的成绩,截自《State of AI Report 2026》
报告作者的结论值得原样记下:"有意义的模型对比,必须披露外壳,并把外壳固定住。"反过来说,任何不告诉你测试外壳的模型跑分,参考价值都要打折扣。
读到这里你可能会想:这是给开发者看的东西,和我有什么关系?
关系恰恰最大。因为给 AI 搭外壳这件事,你早就在做了——只是你用的不是代码,而是你的职业本能。
想一想你带项目时搭的那套东西:项目资料室、模板库、先例库、QC 检查清单、审校流程。现在把 AI 放进来——
▪你喂给它的文件和上下文,就是它的"环境接口":只看得到一段聊天描述的律师 AI,和读完了全部尽调材料、历史合同模板的律师 AI,是两个物种;
▪你沉淀的方法论模板,就是它的"技能包":你的尽调清单、财务分析框架、法律意见书骨架,装进去一次,每次都生效;
▪你设计的审校流程,就是它的"质量护栏":先让 AI 出草稿、你按清单核验,和让它一口气直接出终稿,出错率天差地别。
模型能力每三个月上一个台阶,但"如何为专业工作搭建环境"这件事,模型不会替你做。这正是专业人士的旧技能(搭资料室、定模板、管流程)在新语境下的复利。
不过,这条线索有一个关键的转折,很多人会栽在这里。
报告里这一节的标题是:"更强的模型,会长过自己的外壳"(Stronger models can outgrow their harnesses)。
过去几年,因为模型不够聪明,大家的外壳里堆积了大量精巧的补丁:冗长的系统提示词、反复的提醒、手把手的工作流程。这些补丁在当年确实有用。但报告给出了一组耐人寻味的数据:
Claude Code 为最新的高级模型删掉了 80% 的系统提示词——编码成绩没有任何可测量的损失。甚至,提示词里的 few-shot 工具使用示例反而会抑制模型的探索。
也就是说:为旧模型打的拐杖,会变成新模型的镣铐。
这里还有一层更深的含义:报告观察到,外壳正在变成模型的"课程"——最新的 GPT 模型就是用 Codex 外壳里产生的轨迹来训练的。这意味着你今天在什么环境里、以什么方式使用 AI,会在未来反过来塑造模型本身。
对专业人士的启示非常具体:
1.提示词需要定期"大扫除"。那段写于两年前、每次都要粘贴的长提示词,现在可能在拖累新模型。试试把你的提示词砍掉一半,看输出是变好还是变差——大概率是变好。
2.投资接口,而不是投资说教。报告给"值得长期投资的外壳要素"列了一张清单:环境接口(工具、MCP 服务器)、记忆与状态管理、可观测性、沙箱基础设施。翻译一下:给 AI 接上你的文件和工具,好过在提示词里苦口婆心。
把 Harness 思维落到咨询和法律的日常,我整理成六条:
1换环境测试法。重要任务别只出一版:换个工具、或开一个干净的新会话再跑一次。两版对比的方差,会告诉你任务对「壳」有多敏感。
2搭项目工作台。接手新任务的第一步不是提问,是喂料:把相关文件、既往模板、关键先例放进项目空间,让模型带着上下文工作。这一点上,各家 AI 的「项目/工作区」功能就是给你的壳。
3下结论前固定变量。觉得「模型变笨了」,先检查壳:会话是不是太长、上下文是不是已经互相污染、任务是不是超出了这个壳的设计场景。报告里的数据说明,壳的问题的表现形式,恰恰最像「模型不行」。
4把方法论沉淀成模板和技能。而不是每次重打长提示词。你的尽调清单、分析框架、文书骨架,做成可复用的模板放进壳里,一次搭建、长期生效。这是把个人经验资产化的过程。
5提示词做减法。按第四节的逻辑,定期审视你那些最长的提示词:哪些是补丁,哪些是接口?补丁该删就删。
6记录失败案例。报告总结了头部应用公司的共同打法:把 AI 每次交付失败的案例变成可回放的测试,持续改进外壳。你不需要那么技术化,但至少可以建一个「AI 翻车记录」,翻车三次的地方,就是你壳的薄弱环节。
《State of AI 2026》的这条研究线索,说白了就一句话:
模型行业把"聪明"做成了三个月一次的公共品,所有人都能租到;而你能不能用好它,取决于你为它搭建的环境。
对咨询人、法律人来说,这个判断还有一层职业含义:当模型能力趋同、人人都能租到最强大脑时,真正拉开差距的,是谁把行业知识、方法论和质量标准装进了自己的工作环境。
模型是租来的,三个月换一代;你搭的环境,才是复利资产。
下一次,当你的 AI 表现失常,先别急着换模型。
换壳试试。
数据来源:Air Street Capital, State of AI Report 2026(2026-10-08,Nathan Benaich)。文中数字对应页码:换壳实验与 7.8 倍(p.7)、外壳耐久投资与 80% 系统提示词(p.14)、ARC-AGI-3 外壳差异(p.39)、Harness 定义与 HarnessSafe 分数(p.202)。本文图表截取自报告原页。