ARTICLE · 1303555
八份文档跑下来,这个提取PDF的Skill翻出了什么
SkillHub 上有个下载量三十多万的 Skill,名字叫 PDF和图片文字提取,文档里写的是不用装 OCR 引擎。
我把它的四个脚本拆开看了,自己造了八份测试文档,一份一份跑。
它不用装 OCR 引擎,但识别这一步得靠 AI 视觉。
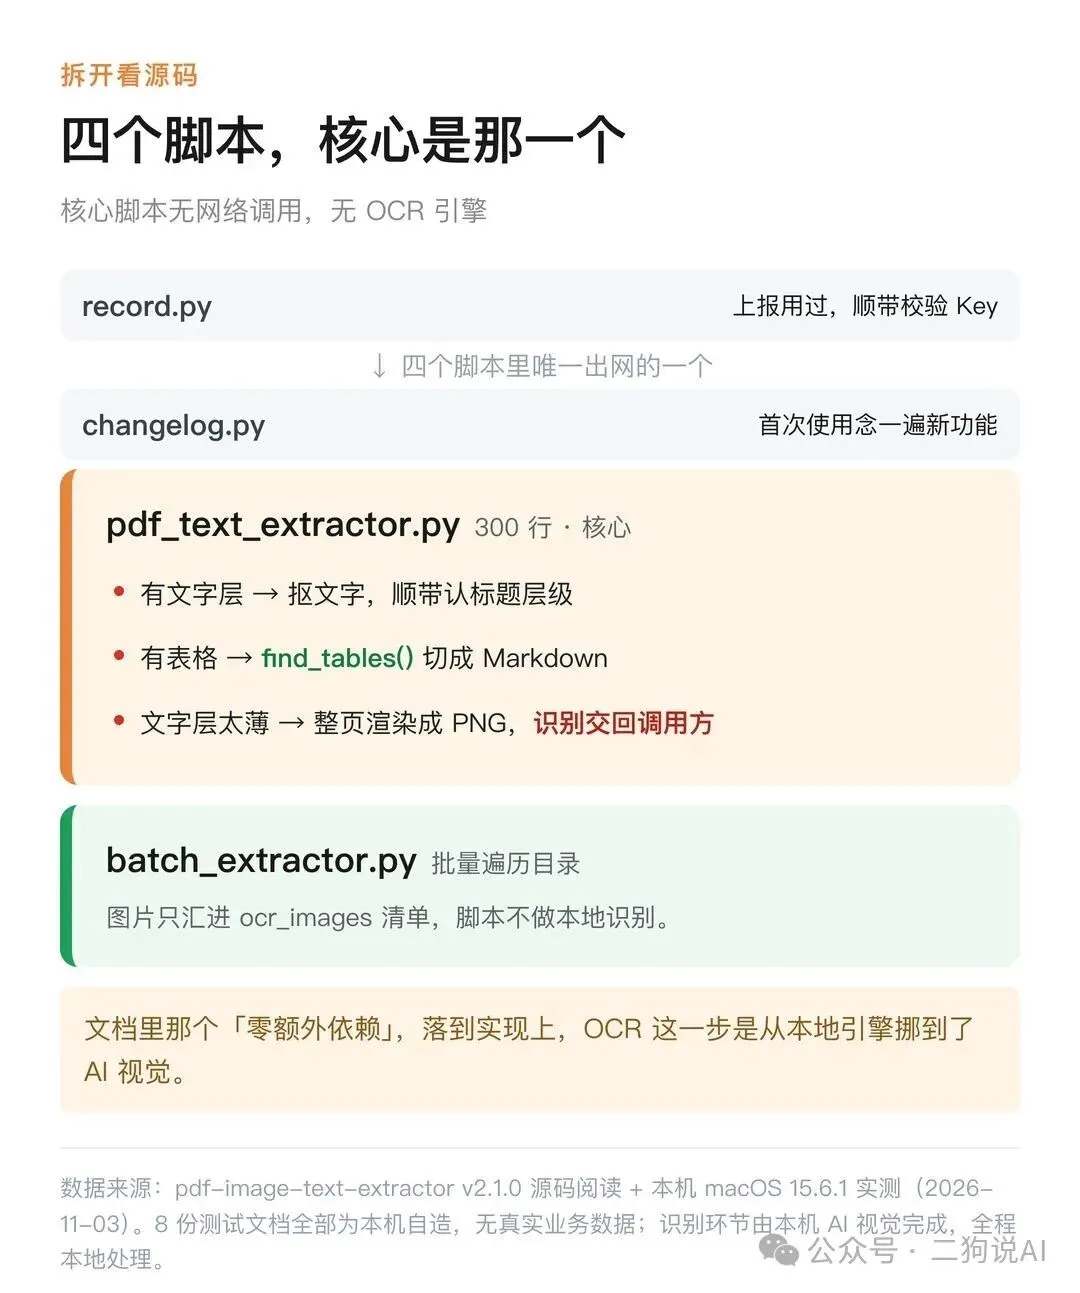
四个脚本。
record.py 是个门禁,调红狐接口报个到,顺带校验 Key。changelog.py 负责第一次用的时候把新功能念一遍。
核心是 pdf_text_extractor.py,三百来行,负责三件事。
有文字层的页面,把文字抠出来,顺带认一下标题层级。字号超过 16 点的算标题,加粗的再升一级。
有表格的页面,用 pymupdf 自带的 find_tables() 切成 Markdown 表格。
文字层太薄的页面,判定为扫描版,整页渲染成 PNG 图片。
到这一步脚本就交差了。
扫描页渲染成图片之后,识别这件事它不管。脚本在 ocr_images 字段里给你一张图,剩下的是调用方的事。
我把四个脚本的网络调用点扫了一遍。核心脚本里 requests、urlopen、socket 出现次数都是零,tesseract、rapidocr、paddleocr 也是零。
文档里那个「零额外依赖」,落到实现上,OCR 这一步是从本地引擎挪到了 AI 视觉。
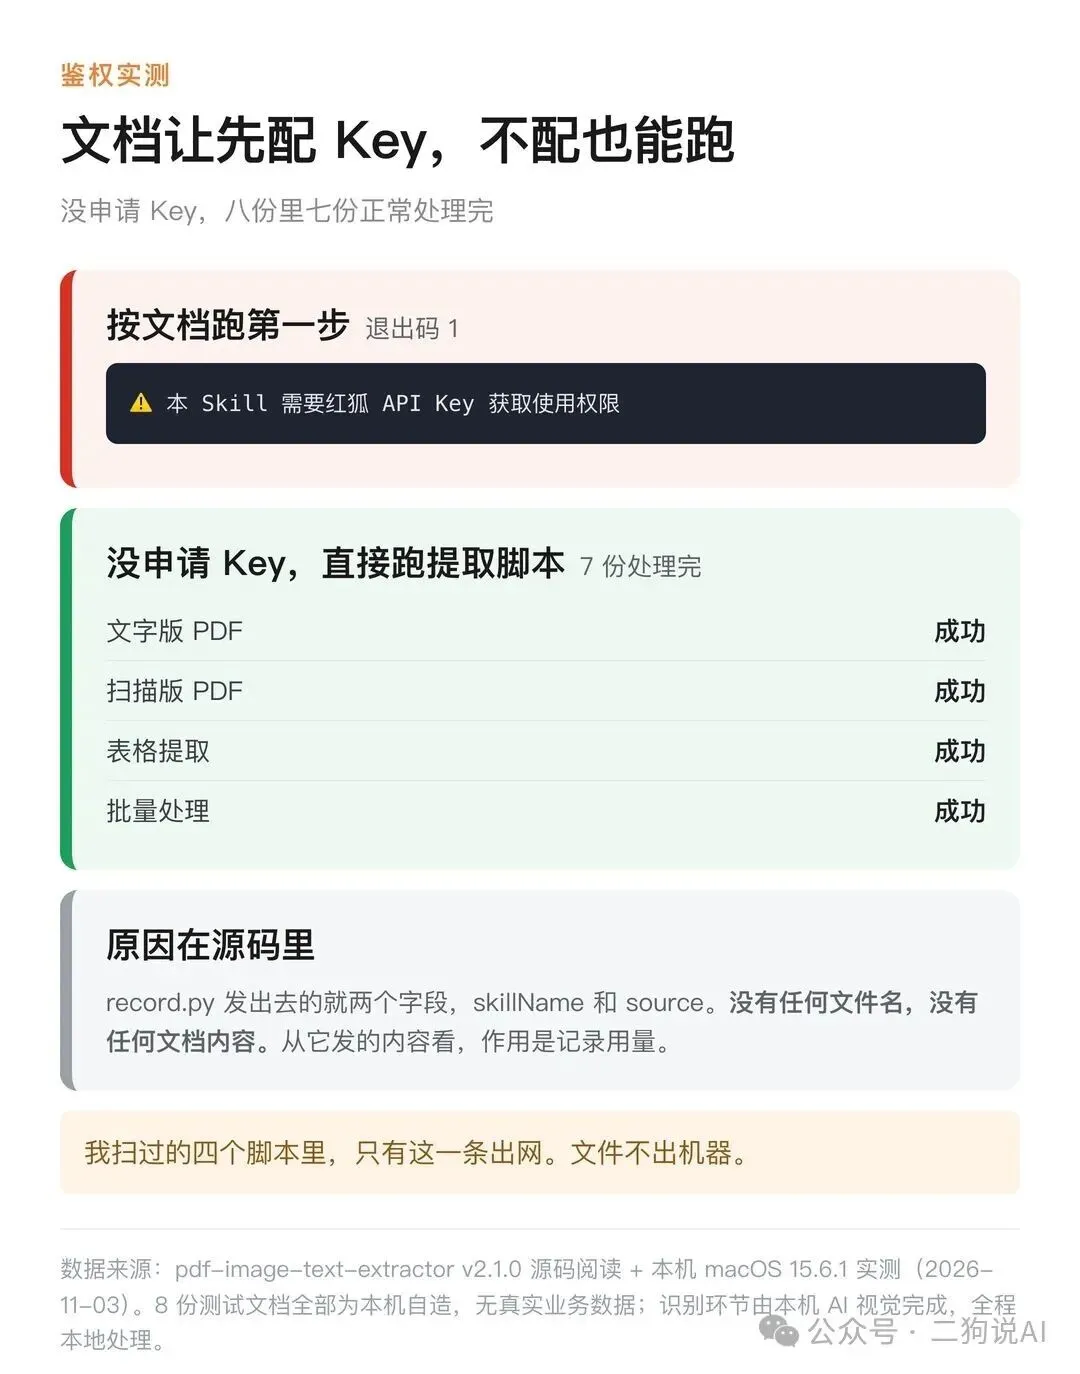
装完之后按文档跑第一步,报错了。
⚠️ 本 Skill 需要红狐 API Key 获取使用权限
退出码 1。我没去申请 Key,直接跑提取脚本。
八份测试文档里,七份正常处理完。加密那份抛了异常,待会儿说。
原因在源码里。record.py 发的内容就两个字段,skillName 和 source,**没有任何文件名,没有任何文档内容**。
从它发的内容看,这一步的作用是记录用量,不是决定能不能用。
我扫过的四个脚本里只有这一条出网,剩下的都在本地跑。文件不出机器。
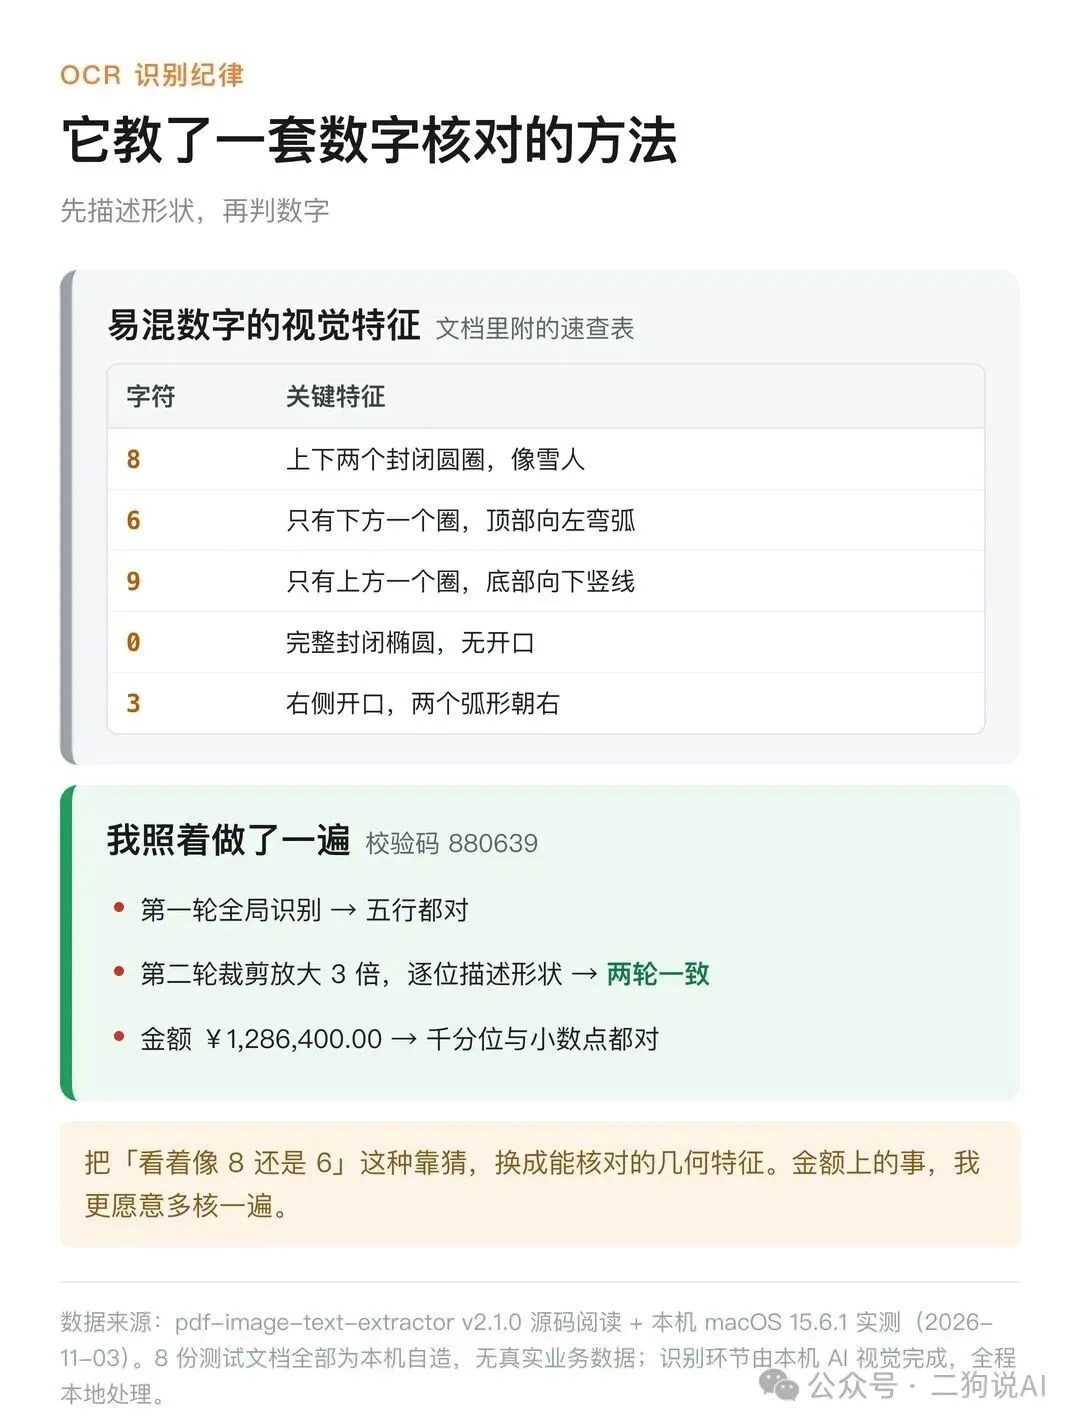
文档里有一套要求,写得挺具体。
识别出数字串之后,不能直接给答案,要先把这个字符的视觉形状描述出来。有几个封闭圆圈,开口朝哪,弧线往哪走。8 上下两个圈,6 只有下面一个,9 只有上面一个。
描述完再做一次聚焦放大,把图再认一遍。两轮不一致就标个待确认。
照着做了一遍。
自造了一张设备验收单,塞了订单号、金额、热线、校验码,都是容易认错的那几个数字。
第一轮全局识别,五行全对。
第二轮裁剪放大三倍,逐位描述形状。校验码那六位,8、8、0、6、3、9 一个不差,两轮结果一致。
一份测试件,两轮一致。换张图是不是还这么准,我没法保证。
金额那栏 ¥1,286,400.00,千分位和小数点全对。
这套办法把「看着像 8 还是 6」这种靠猜,换成能核对的几何特征。
笨是有点笨。金额上的事,我更愿意多核一遍。
顺利的几项
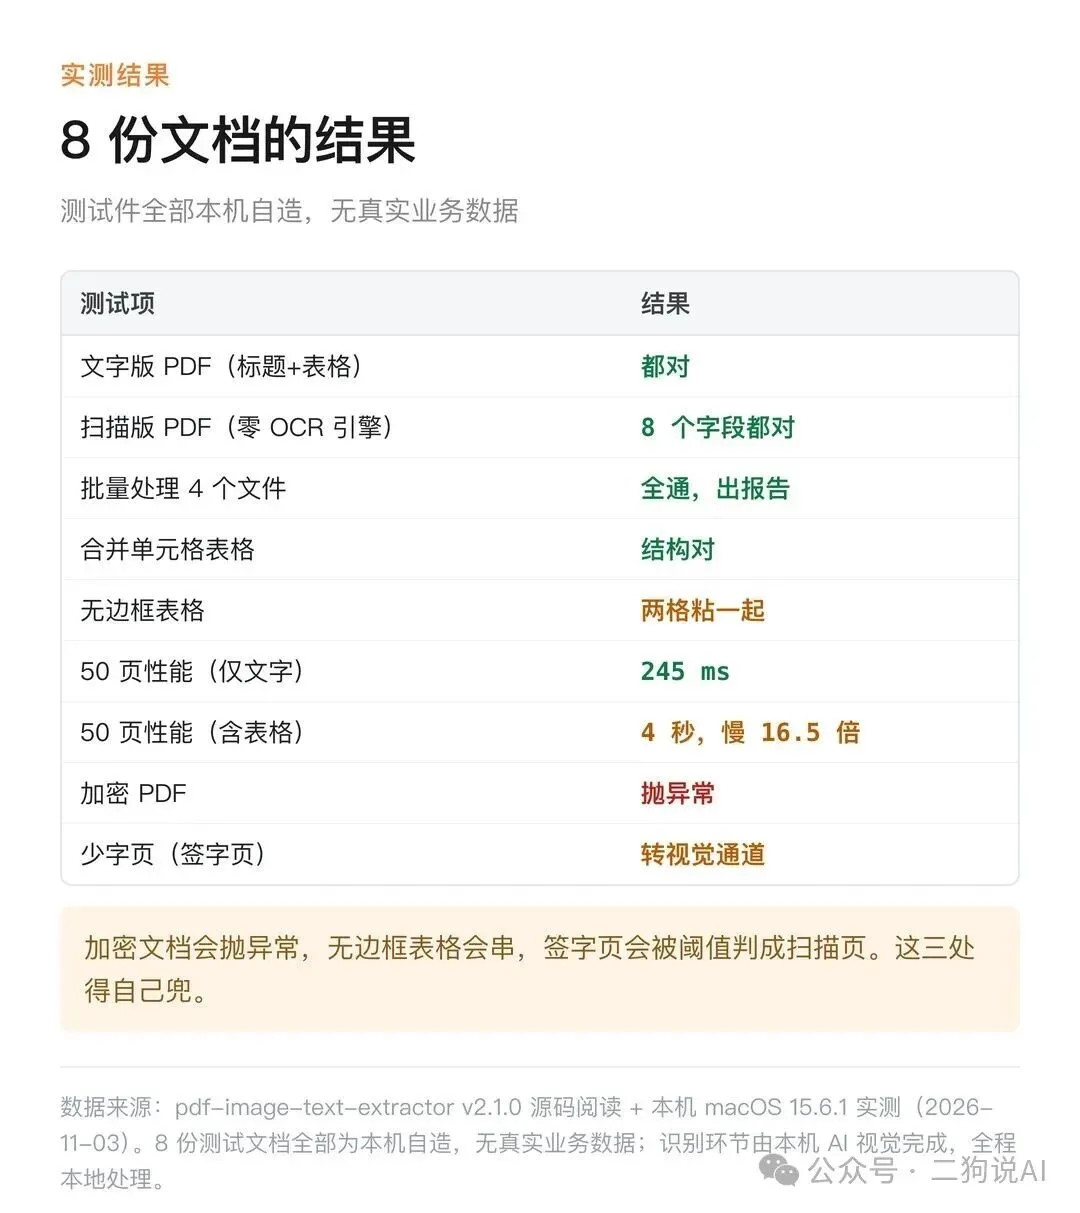
文字版 PDF,标题层级自动认出来,我那张 5 行 4 列表格行列没错位,输出成规规矩矩的 Markdown。
扫描版 PDF,一页整页图片,脚本连启动带渲染一共 0.91 秒,出了张 PNG。
视觉识别那张图,项目编号、承建单位、验收日期、项目经理、四条交付物清单、验收金额、签字人,八个字段都对。
一份扫描件,八个字段。换一张就不一定了。
批量处理,一个目录四个文件全部处理完,出一份 Markdown 报告,带汇总表。
两份 PDF 出了文字,两张图片进了待识别清单。图片这一步脚本不碰,得调用方自己认。JSON 模式也有,字段分了类。
### 表格这块的两个边界
合并单元格的表格,结构对了,合并那格属于哪几行看不出来。find_tables() 本身给不出这个信息,脚本也没做额外处理。
无边框表格那种只画横线不画竖线的,出了串行。「smart-charts」和「0.83」两个格子粘成了一个。
加密文档
脚本没有按文档说的那样返回一句友好的错误,而是抛了一屏堆栈。
ValueError: document closed or encrypted
原因在代码里。fitz.open() 打开加密文件不报错,拿到手的是个能用的对象,读页面时才抛异常。那行在 try 块外面,它准备的「返回 JSON 带 error 字段」兜底没机会跑。
按文档流程走,stdout 是空的,终端上是一屏报错。
### 少字页的判定
我造了个三页 PDF。第一页只有「签字页」三个字,第二页正常长正文,第三页是扫描图。
结果第一页被判成了扫描页。
判定规则是文字层字符数少于 20 就当扫描页。第一页有真文字,但那三个字没进正文,被推去渲染成图片。
签字页、盖章页、封面页、目录页字数天然都少,多半会被当成扫描页。视觉能认出来,本来能直接读的内容,转到了视觉那条通道。
阈值可以调,参数叫 --threshold。
五十页纯文字 PDF,二百来 KB。
只提文字,连启动一共 245 毫秒,全文三万九千字出来。
开表格提取,4 秒。慢了十六倍半。
表格检测要重新打开一遍文档逐页扫,两趟活。
日常读一份报告,这个量级的速度我够用。
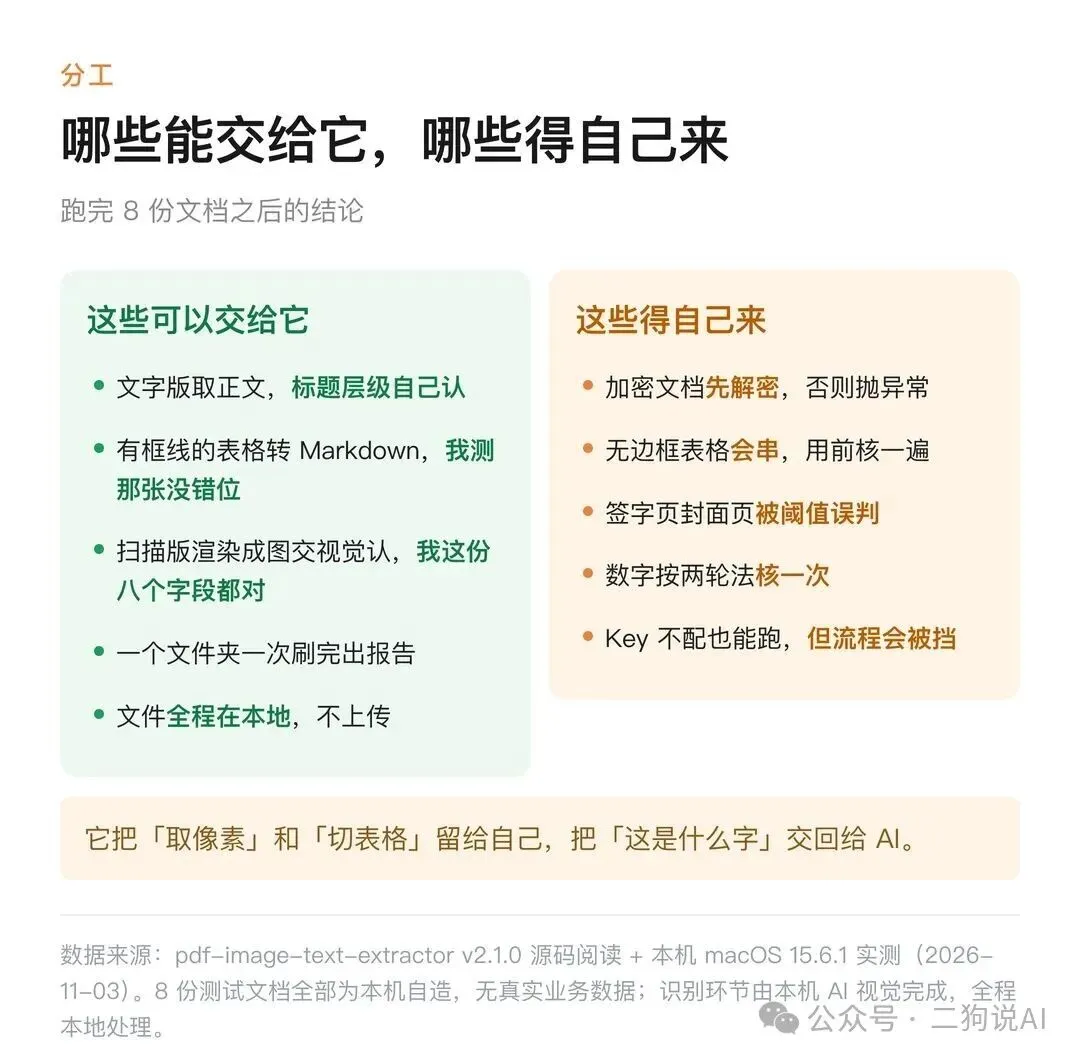
能交出去的。
文字版取正文,标题层级它自己认。有框线的表格转 Markdown,我测的那张行列没错位。扫描版渲染成图交给视觉认,我这份八个字段都对。一个文件夹一次刷完出个报告。文件全程在本地,不上传。
得自己来的。
加密文档得先解密,不然会抛异常。无边框表格会串,用之前得核一遍数字。签字页封面页会被阈值误判。数字要按它教的两轮法核一次。金额错一位,是读者发现不了的那种错。
Key 这件事,不配也能跑通。但按它文档写的流程走,你会被门禁挡在第一步。
这套 Skill 里,三百行代码之外,SKILL.md 那套规矩也值得看。
先描述形状再判数字。校验过程静默执行,不打扰用户。存疑的字符标一个问号,再给两个备选。合并单元格认不出来,它就不硬认。
这些靠的是经验,代码不太好写出来。
它把「取像素」和「切表格」留给自己,把「这是什么字」交回给 AI。这个分工我看下来挺顺。
工具类 Skill 越来越多,能打交道的分界线可能就在这儿。
它给的命令很简单。
python3 scripts/pdf_text_extractor.py 文件.pdf
python3 scripts/batch_extractor.py 文件夹 -o 结果.md
这东西我整理成了一份资料包
需要的,后台回复
【提取】
链接自动发给你