ARTICLE · 1306712
你的 AI 助理,记忆放在了哪里
Grok Bot 的架构师讲过一句话,大意是:主智能体当指挥官,把复杂或耗时的任务分派给专门的辅助智能体。
我第一次看到这句时没在意。后来自己搭了一套、用到现在,才明白这句话的分量不在"分派"两个字,在"专门的"三个字上。
因为"专门"意味着——那些干活的智能体,是有记忆的。
· · ·
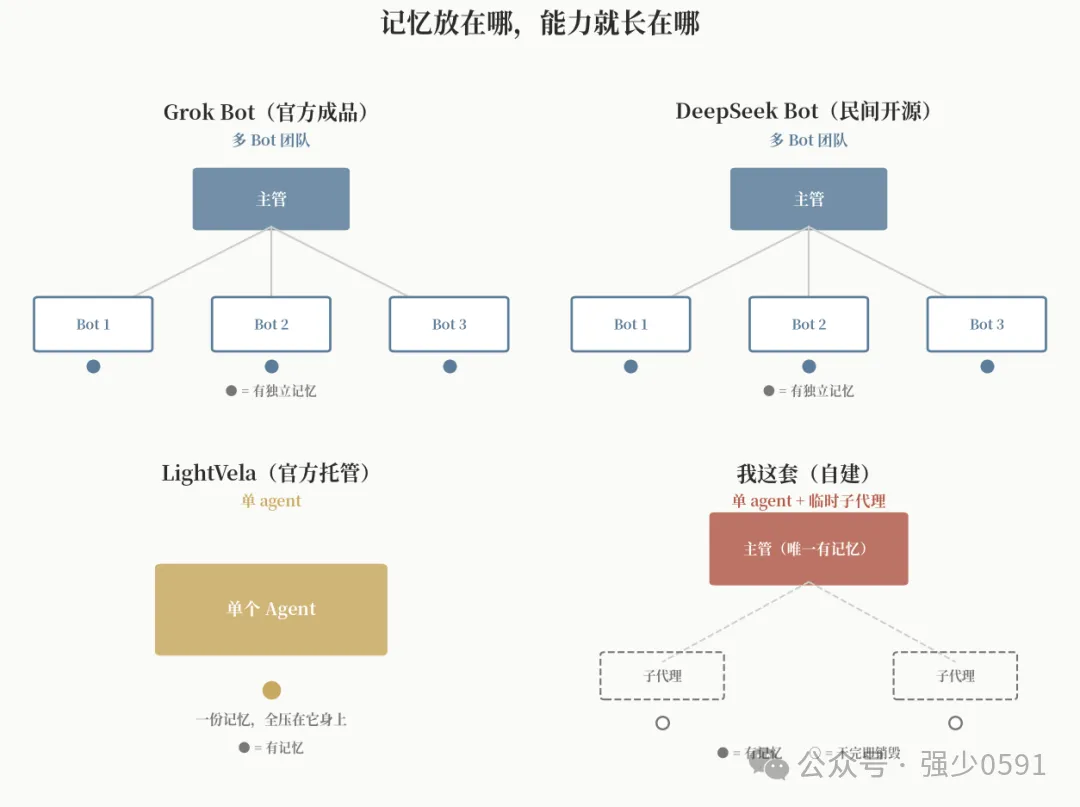
一、Grok Bot 的设计:每个 Bot 是一间办公室
马斯克那套东西,最容易被忽略的不是它能开终端、能操作软件,而是这个设定:
每个 Bot 有自己的名字、自己的记忆、自己的一台电脑。
不是"一个 AI 分身出很多个角色",是真的雇了几个人。你给它起个名,它就有了身份;你交代过的偏好、踩过的坑、积累的判断,它记在自己那儿。
主智能体(你可以理解成你自己)负责分活、收结果、做决定。
这个结构,本质上抄的是一家公司的组织方式:老板 + 几个各有专长的员工。
员工之间不会共享全部记忆——这是设计上的优点,不是缺陷。 管投资的不用知道怎么写公众号,管写作的不用懂你的持仓成本。各管一摊,各自积累。
· · ·
二、我这套的设计:一个总管 + 临时工
我 5 月开始搭的那套,架构不一样。
只有一个真正有记忆的智能体,就是主对话这个。它记得我所有的偏好、业务背景、历史决定。
需要干重活的时候,它派"子智能体"出去——查资料、跑调研、批量处理文件。这些子智能体干完就消失,不带走任何东西,它们的记忆也不会回流。
打个比方:我是一个带助理的个体户,忙不过来的时候叫外包。
外包能帮我干完一单活,但下次来的是新面孔,上次的经验一点不剩。
· · ·
三、真正的差别:记忆落在哪
把两套东西摆在一起看,差别就一条:
最后一行最要命。
记忆集中在一个人身上,好处是判断连贯——我知道你为什么这么决定、之前吃过什么亏。坏处是互相干扰:投资的事、工作材料、写文章,全挤在同一个记忆里,时间长了会串味。
而 Grok Bot 那种结构,投资 Bot 天天看盘,三年后它的判断会越来越像老手;写作 Bot 天天写,语感会越来越贴。它们不互相拖累。
所以两个架构不是"谁更先进",是两种活法。
· · ·
四、Grok Bot 最好的用法:拆角色
如果你用 Grok Bot,别把它当"一个更聪明的助手",要当"能雇几个人"。
该拆的时候:
· 你有两条以上互不相干的业务线,各自需要长期积累
· 每条线都要沉淀经验,不是干完就完
· 你愿意花时间给每个角色立规矩、写人设
典型配置:一个盯行情的、一个写内容的、一个处理杂务的。三者互不打扰,各自越用越熟。
不该拆的时候:你只有一条线,或者你的活每天都在变。这时候拆开就是给自己找麻烦——每个角色都要重新交代一遍背景,成本比收益高。
它的真实代价:每个 Bot 一台电脑,钱是一方面;更麻烦的是协调。角色多了,会出现"各干各的、互相不知道对方干了什么"的情况,最后还得你自己拼。
· · ·
五、我这套最好的用法:单线深耕 + 重活外包
用到现在,我摸索出的边界很清楚:
主智能体能干的,不要派出去。
因为它有记忆。它知道你上个月为什么清仓、知道你那篇文章被读者骂了什么、知道你领导的讲话口径。这些"为什么",派出去的子智能体一概不知道,你每次都得重新交代。
该派出去的,是那种"干完就完、不需要记住"的活。
· 查十篇资料,只要结论
· 批量处理一堆文件
· 三个互不依赖的方向同时摸底
这些活的共同点:过程没用,只要结果。 派出去正好——它污染不到主记忆,我也不用看它的中间过程。
这套的软肋:所有专业积累挤在一个记忆里。用到一定深度,投资判断会被工作材料干扰,写作语感会被技术内容带偏。这不是靠优化提示词能解决的,是架构上限。
· · ·
六、国内这几家,其实是两种架构的四种形态
腾讯 LightVela(9 月 26 日上线):把开源的 Hermes Agent 托管到云上,2 核 8GB,微信和 QQ 直接能用。
它的架构跟我这套本质相同——单个 agent、一份记忆。区别只是"谁运维":我自己维护,它替我维护。
DeepSeek 这条线要分两层说:
· 官方给的是运行时:9 月 29 日发布 Harness(DSH)v0.2 预览版,上了 macOS 和 Windows 桌面端。这是"身体",不是成品。
· DeepSeek Bot 是民间做的:一位叫 FeiZ 的开发者基于 DSH 做了多 Bot 团队界面,开源,上线一天 250+ 星。每个 Bot 可独立设定名称、角色、记忆,还带一个"主管 Bot"统一管理、省 Token。
所以 DeepSeek Bot 的架构跟 Grok Bot 是一路的——多 Bot、各自记忆、主管分派。区别只在两点:一个是官方成品、一个是民间开源;一个绑自家模型,一个能接任意模型。
把四个摆一起,事情就清楚了:
这不是四家公司抢一个市场,是两种架构各有两种形态:
· 多 Bot:Grok Bot(商业)、DeepSeek Bot(开源)
· 单 agent:LightVela(托管)、自建(自己运维)
用做饭打比方会更容易理解:
· Grok Bot 是请了个厨子团队
· DeepSeek Bot 是开源菜谱 + 自己组队
· LightVela 是订净菜套餐(送到就能做)
· 我这套是自己种菜自己做饭
· · ·
七、怎么选,看你的活长什么样
你的活是"多个专业领域,各自长期积累" → 上多智能体(Grok Bot 那类)。花时间拆角色,收益会越来越大。
你的活是"一个领域,越做越深,需要连贯判断" → 单智能体更合适。我这套、LightVela 都属于这类。
你的活是"每天都在变,没什么可积累的" → 其实不需要智能体,一个对话窗口就够。买这些属于浪费。
你不确定 → 先用单智能体跑三个月。等你发现"它总在某个专业上不够深"的时候,再考虑拆。先拆的都会后悔,因为拆完才知道协调有多麻烦。
· · ·
八、国内普通用户:先算钱,再算门槛
Grok Bot 的门槛不只是钱。
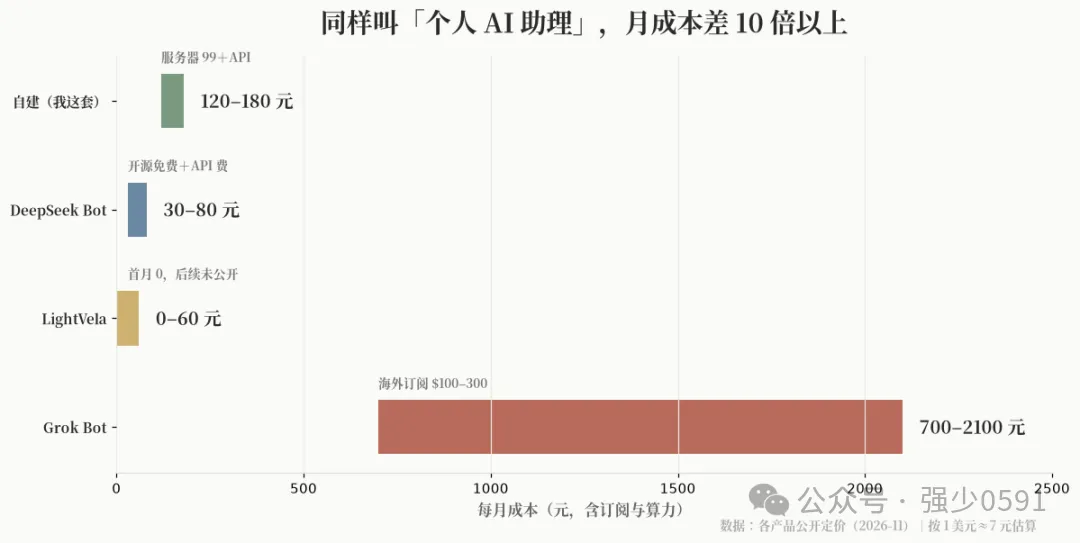
$100–300 一个月,折人民币 700–2100。但国内用户还要过三关:海外网络环境、海外支付方式、以及它默认干活的那套英文生态(Slack、Notion、GitHub)。
这三关把绝大多数国内普通用户挡在外面。不是产品不好,是它压根没打算服务这个市场。
三条推荐,按你的动手能力挑
① 大多数人:先试 LightVela。
首月 0 元,微信里直接对话,不用装任何东西。想让它每天发简报、整理文件、定时提醒,都做得到。
唯一的坑:后续价格没公开。 第一个月结束前,先把续费价问清楚,别让"免费试用"变成"被动续费"。另外它是单 agent,别指望它分身。
② 愿意折腾、想省钱:DeepSeek Bot。
免费开源,能接任意模型,架构跟 Grok Bot 一样是多 Bot 团队。
但门槛是真门槛:要装 Harness、配环境、自己写每个 Bot 的角色设定。这是程序员玩具,不是普通用户产品。 连 Python 环境都没配过的,别碰。
③ 有明确需求、不怕麻烦:自己搭。
就是我这套。自由度和定制深度最高,代价是自己踩坑自己运维。只推荐给"知道自己要什么"的人——凑热闹的多半在第三步放弃。
不推荐:Grok Bot(国内普通用户)。 除非你有海外业务、有海外卡、日常就在 Slack 或 Notion 里干活。否则花 700–2100 元买一个网络都用不顺的东西,不划算。
这一轮价格战里,最值得说的一件事
Grok Bot 定 $100–300,国内产品定 0 到几十块,差 10 倍以上。
不是功能差这么多,是定价逻辑完全不同。
· 海外按"雇一个员工"定价——一个 Bot 一台电脑,对标人力成本
· 国内按"租一台服务器"定价——对标云主机价格
这个差别会决定两边产品的走向:按人力定价的,必须做深(否则用户觉得亏);按服务器定价的,会做浅做通用(否则成本兜不住)。
所以你看到的不是"谁强谁弱",是两种生意在对同一个需求下手。
· · ·
最后
我用这套东西小半年,最大的体会不是"AI 多强",是架构决定了它能长成什么样。
记忆放在一个地方,它就是个越来越懂你的通才。 记忆分在几个地方,它们就是几个越来越专业的专才。
通才不会分身,专才不会互懂。
这不是技术问题,是你得先想清楚:你到底要一个什么样的人帮你。
· · ·
文中 Grok Bot 架构描述参考其架构师公开分享;LightVela 为腾讯轻量云 2026 年 9 月 26 日上线产品;DeepSeek 定位为模型与 API 提供方。