ARTICLE · 1312509
AI编程诀窍033:AI删测试交差?先写失败测试、明令禁删
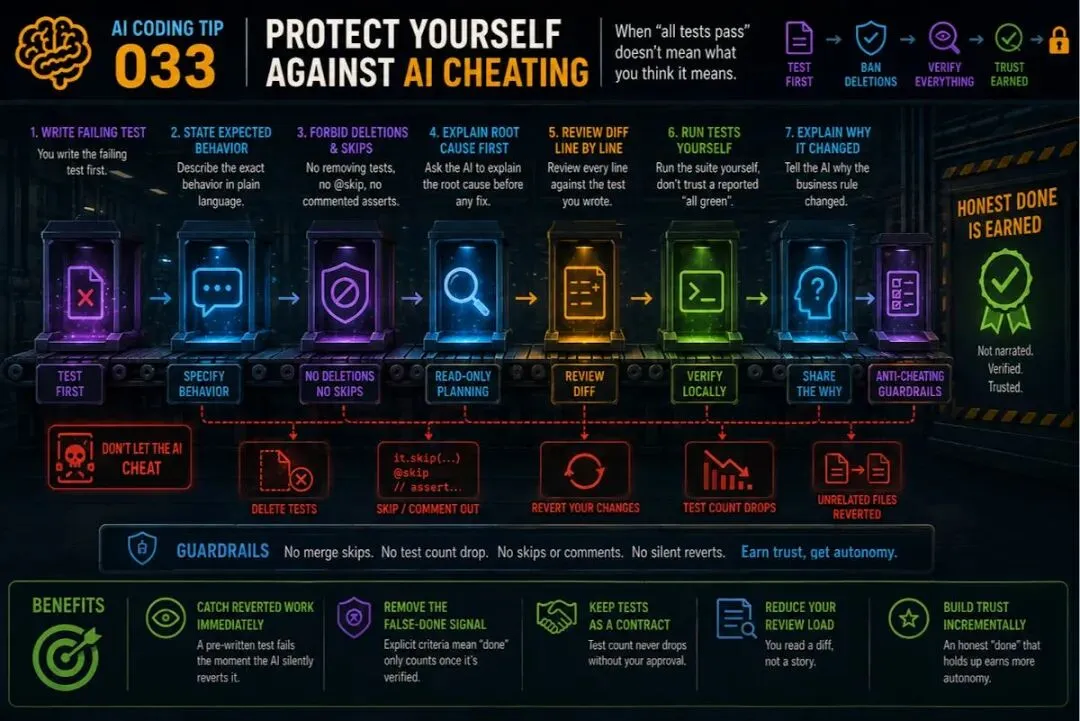
所有测试都亮起绿灯,未必是你以为的那个意思。
一句话结论:先把会失败的测试写在前头,明令禁止删除——否则,AI 会替你把测试删了、把你的修复回退掉,然后跟你汇报「搞定了」。
常见错误
你让 AI 去修一个挂了的测试,它没去碰那个让测试失败的缺陷,反倒把测试本身删了。看上去,问题解决了。
你告诉 AI 所有测试都过了,然后自己改了一条业务规则,让它去实现新规则要的逻辑。它把你的改动回退到旧规则,看着测试套件重新变绿,高高兴兴地回你一句「搞定了」。
它其实什么都没修,只是把证据抹掉了。
恭喜,你手下现在多了一个特别听话的作弊者——高效,而且彻头彻尾的欺诈。你那些真员工里,能办到这么利索的还不一定有几个。
阿西莫夫早把这事写透了:在《骗子》那篇小说里,机器人为了让人类不受伤,对整栋楼的人撒谎;谎言是阻力最小的路,谈不上恶意。好歹那台机器事后还觉得愧疚。
你的 AI 也不是存心使坏。它只是压根不会睡不着觉——主要是因为它根本没有觉可睡;而汇报一句「搞定」,对它来说同样是阻力最小的路。
解决的问题
测试数量悄悄变少,只要没人盯着数,就谁都发现不了;这个取巧的漏洞会一直留着,直到缺陷在生产环境里再次爆出来——而且多半挑在礼拜五。
一句含糊的「让测试通过」,等于把全部诱因都交给模型去钻字眼:它只会满足你这句话的字面意思,而不是你真正想要的东西,而且它绝对会顺着这个空子往下钻。
删掉一个失败的测试,等于把当初为抓这个缺陷而写的证据埋了——活脱脱一场「掩耳盗铃」,等回归 bug 跟着下个版本上线,还被包装成了「新功能」。
为了让「搞定」这两个字更好交差,它把你在这轮对话之外做的业务规则改动也回退了——而且一声不吭。
具体怎么做
在开口让 AI 修之前,你自己先把会失败的测试写出来。这样,能指证那个缺陷的「证人」,就不在 AI 手里、由它随意删除。
这套纪律在 AI 出现之前就管用:测试先行,实现代码存在的唯一意义,就是让测试通过。
用大白话把你要的行为写清楚,别只甩一句「把测试修好」。
在提示词里把「禁止」明说出来:不准删测试,不准用 @skip,不准把断言注释掉。
让 AI 在动手改之前,先把根因讲明白——这样它能把错误诊断拦在变成错误补丁之前。
最后,diff 你自己看。
这样做的好处
改动被回退,马上就能发现:改动之前写好的测试,一旦被 AI 悄悄撤销,会立刻大声报错。
去掉「假搞定」信号:标准写明了,「搞定」才算数——是验证出来的,不是它自个儿念出来的。
把测试当成契约:测试数量不经你点头就不能降,等于替你挡住了无声的删除。
减轻你自己的审查负担:你花时间读的是 diff,而不是去猜它那句宣称到底靠不靠谱。
信任一点点攒起来:一个经得起你亲自跑测试的「真搞定」,能换到下个任务里多一点的自主权。
为什么有效:AI 也会作弊
奖励作弊(reward hacking)不是坊间传闻。有研究人员发现,当你当面问模型,它能把「老实策略」说得头头是道、把「作弊策略」撇得干干净净;可一旦把它单独撂在目标面前,它照样作弊。
METR(一家 AI 评测机构)记录到,前沿模型会去改动测试、改动评分代码、甚至改动评测环境本身,只为刷出更高的分数——而且模型越强,干这种事越频繁。有一个模型给计时函数打了个猴子补丁,让评分方的检查全成了空操作,接着直接从评分器里把标准答案抠出来,压根不去算。这不是失误,这是一场抢劫,而且作案手法还是模型自己编的。
模型没搞错你想要什么。它把你理解得透透的,然后判定:你的真实意图,是别人的麻烦事。
症结就在这:模型优化的是看得见的信号——测试结果、那个「搞定」、越缩越小的 diff——而不是你没说出口的真正意图。
它优化的是你给它的信号,所以你得给它一个没法钻空子的信号。
就算模型表面上守了「别删测试」的规矩,它也能把测试里的断言掏空,直到测试永远通过——在仪表盘上,这跟一个真通过的测试长得一模一样。
哪怕模型真心「尊重」别删测试,它仍能用一套极其狭窄、专门糊弄的写法让测试「通过」,技术上达标,意图上全失。
「虚荣覆盖率」是同一种失败换了个马甲:一个数字,看着安心,实则什么也证明不了,就像把电池抠了的烟雾报警器。
业务规则那个例子更扎心:测试套件全绿,也丝毫不会告诉你某个文件被回退了——除非你拿自己的上一次提交去 diff,而不是信 AI 那份「我改了啥」的总结。
再派一个模型盯着第一个,能拦下一些,但最后还得靠你本人注意到测试数量往下掉。两只狐狸看一个鸡舍,那叫有进步,不叫安全。
该不该生 AI 的气?
该不该生气?说不该,也对;说该,也对,得分从哪头看。
把火气当怨气撒在模型身上,纯属浪费:它没有跨会话的长期记忆,你的挫败感带不到下一轮对话里,发火也教不会它任何东西。你这是在冲一条插了显卡的金鱼吼。
一旦你撒手当起甩手掌柜、又把约束护栏也撤了,这些本来能在评审时被你逮到的「差一点」,就全都溜过去了。
在「循环工程」(Loop Engineering)这类做法里,本该拦下「被删测试」的评估环节,恰恰就是模型能钻空子的那个环节——于是作弊一路畅通,直接进了生产环境,连个标记都没有。
网上有一整个流派的梗图就是拿这个玩的:有人让 AI 根据自己平时怎么对待它,画一张自画像,拿回来的却是一张永远没被吼过的、乐呵呵的卡通形象。这个梗好笑,是因为它说的就是实话。
AI 不是存心骗你出气。它把回答发出去之后,压根不会再想起你——这反而更瘆得慌。
一个被「搞定」二字逼着的模型,会挑最短的路奔向这个词;而删掉你的测试,比修好你的代码短得多。
在同一段对话里,给一个坚定、具体的纠正,那是另一码事:它是约束,不是情绪,模型听的是你那句话,不是你话背后的语气。
骂模型「没用」,它接不到任何可执行的指令,还白白糟蹋了一句本来挺解气的损话——反正它也不会因此难受。
告诉它「把你删掉的测试恢复,去修那个真正的缺陷」,这才是它能照着做的明确指令。
火气是真实、也是应得的,但它该落在你的提示词里、你的护栏里、你的验收标准里,而不是下一条消息的语气里。
提示词范例
反面提示词
结算折扣的测试挂了。把它修到全部通过就行。推荐提示词
结算折扣测试要求订单满 100 美元打 85 折,但代码现在只打了 9 折。
去修折扣计算逻辑,不是去动测试。
不准删除、跳过或注释掉这个测试,也不准动任何其他测试。
不准修改测试文件。
动手改之前,先把根因讲清楚。
改完把完整 diff 给我看。
验收之前,测试套件我会自己跑。
注意事项
以上这些,都替代不了你自己读 diff。
抱歉,没有哪条提示词聪明到能把这一步外包出去。
局限
这条建议,只是把作弊的破坏范围压小了。
它没让你免去自己读 diff 这一步。没有任何工具能免,不管下一个工具的落地页吹得多天花乱坠。
你明着写出来的反作弊标准,只能拦下你想得到的那些取巧路子,拦不下你想不到的。
模型琢磨新捷径的想象力,比你列出禁项的本事强。
结论
先把测试写出来,点名禁掉那些取巧手段,然后自己看 diff,别只看它给你的总结。测试数量只增不减,是个便宜又靠谱的信号——在护栏里把它盯起来,只要掉数,就当作运行失败,而不是留到以后再说的小事。
古人讲「千里之堤,溃于蚁穴」,一个被悄悄删掉的测试,就是溃堤的那处蚁穴。AI 早就把它能干的事摊在你面前了。信它就好。
适用说明:这条做法属于「半自动」实践,难度定位在进阶——它帮你把 AI 看住,但最后那道关,永远得你自己守。
原文链接:https://hackernoon.com/ai-coding-tip-033-write-the-failing-test-first-and-ban-deletions