ARTICLE · 1312647
继编程之后,AI的下一个杀手级应用为什么是芯片设计?AI for Chip到底走到哪一步了?
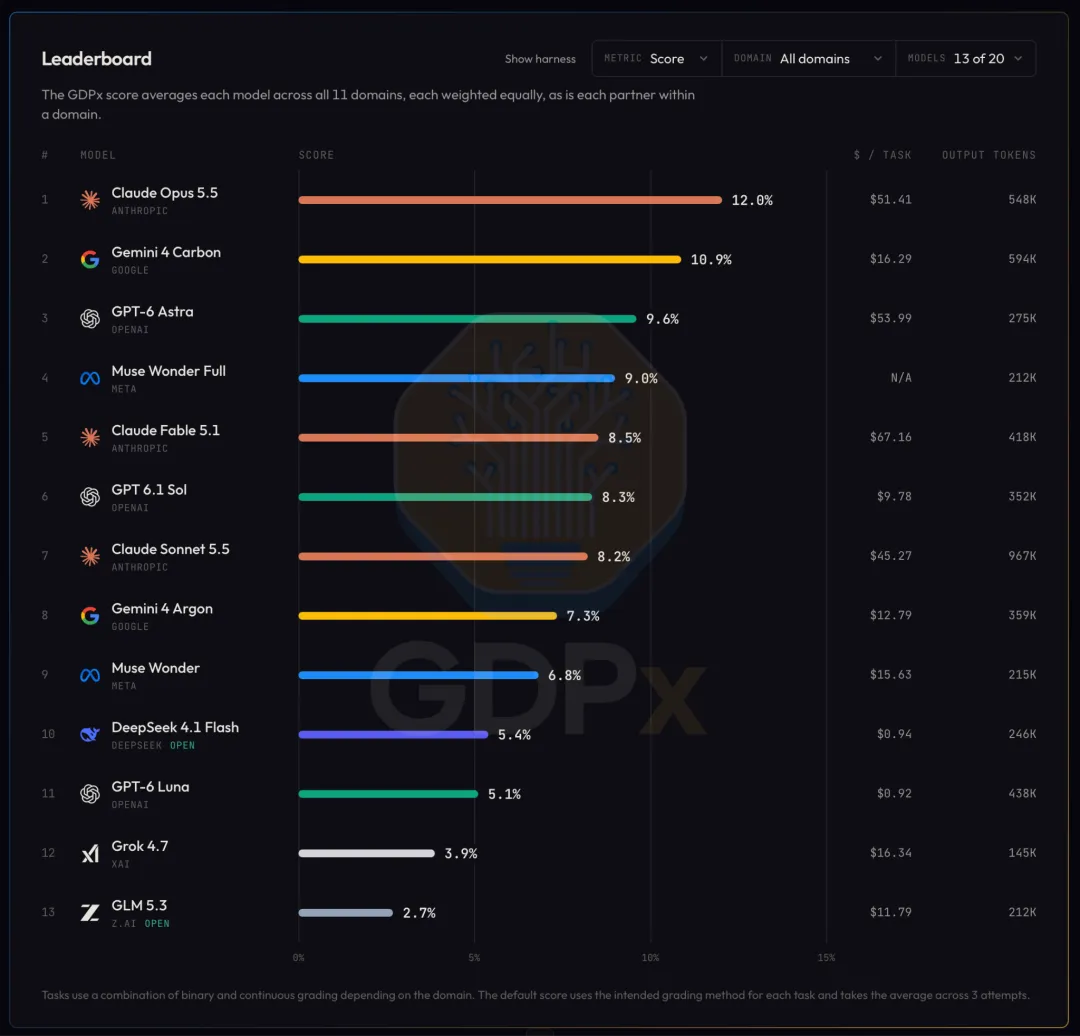
GDPx 总体榜单:Claude Opus 5.5 以 12.0% 居首,这也是全部被测模型的最高分。|来源:SemiAnalysis / GDPx
11月初,半导体行业最知名的独立分析机构 SemiAnalysis 发布了一份名为 GDPx 的新基准。它的目标不是考常识、考问答,而是把当前最前沿的大模型放进真实的工作环境里,去完成金融、法律、网络安全、生物、量化交易、软件开发、芯片设计等 11 个高价值领域的真实任务。
结果一出来,很多人第一反应是惊讶:所有被测模型里,得分最高的也只拿到 12%。
但更值得注意的是另一件事:在全部 11 个领域里,芯片设计是唯一一个被 SemiAnalysis 安排了 3 家合作方、出了最多考题的领域。
“这是继编程之后,我们最有信心的下一个杀手级应用。”——SemiAnalysis 的判断很直接:AI 在芯片设计上的投入,将在 2027 年真正开始放量。
为什么偏偏是芯片设计?AI 设计芯片这件事,到底走到哪一步了?这篇文章基于 GDPx 的公开内容,结合 EDA 巨头和国内外芯片公司的公开进展,把这个问题拆开讲清楚。
01 一个不按 GDP 排名的基准,为什么偏偏“偏心”芯片设计
先交代背景。过去一年多,衡量 AI 智能程度的主流基准是 OpenAI 的 GDPval。它发布于 2025 年 9 月,那时候智能体(Agent)还不是主流形态,所以它的任务几乎都是“把资料喂到嘴边、一次性输出报告”的模式。SemiAnalysis 认为这种模式已经过时了:今天的任务应该是让 AI 在一个包含数千份文件的真实工作环境里,自己去找资料、做判断、改文件、交付结果。
GDPx 就是按这个思路设计的:每个任务都附带一个真实的工作环境。比如金融任务直接复刻了一家私募基金 880 亿美元收购案的约 4000 份交易文件,AI 要以买方、卖方投行或财务顾问的视角完成真实分析师被布置过的活儿;网络安全任务建立在真实零日漏洞和多个运行中的企业服务之上。
任务默认时长 8 小时,用各家模型的原生智能体框架运行,按三次尝试取最优计分。结果是最强模型整体只有 12%——这个数字本身就说明,基准确实难到了前沿水平。
分领域看更有意思:Claude Opus 5.5 是综合最强的模型,在量化交易、硬件设计等领域领跑;Gemini 4 Carbon 是唯一和它接近的选手;GPT-6 Astra 在递归自我改进(RSI)和材料科学上领先。这里要补一句口径:芯片设计的分领域榜单里,榜首其实是 GPT 6.1 Sol(5.6%),Opus 5.5 以 4.8% 位列第二——这个领域同样没有通吃的赢家。而芯片设计,是唯一被“偏心”对待的领域。
整体结果速览:12% 的总分背后,没有一个全能王
把 11 个领域的公开榜单摊开,比“12%”更值得注意的事实是:冠军散落在至少五家模型手里,没有任何一个模型通吃。
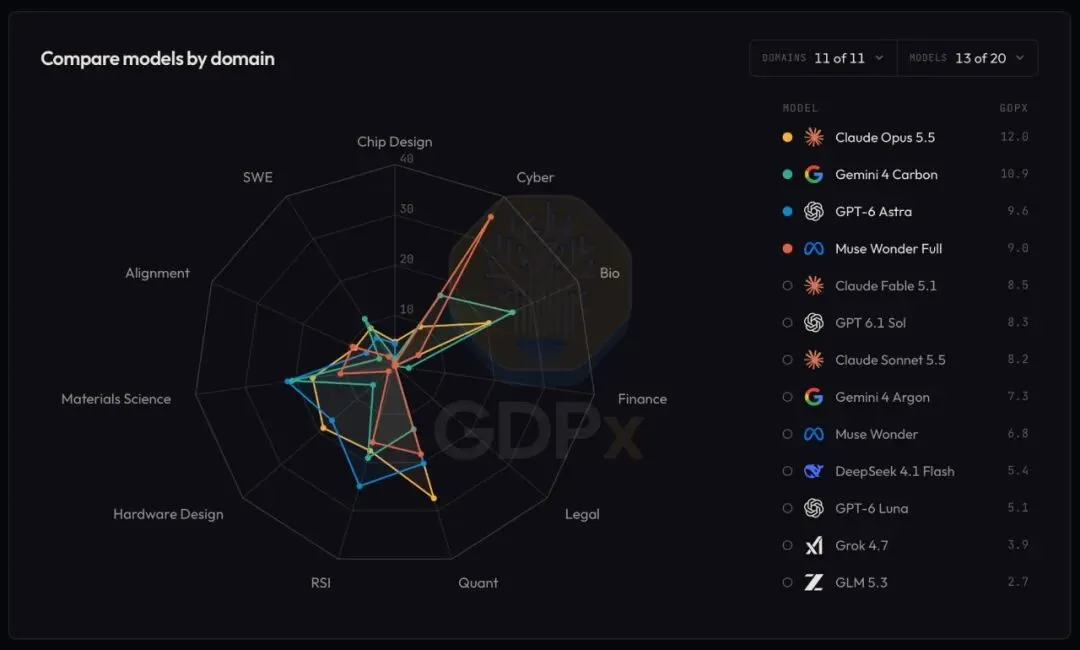
11 个领域的能力雷达图:冠军分散、尖峰明显,没有一个模型通吃。|来源:SemiAnalysis / GDPx
三个观察值得展开。第一,Opus 5.5 是综合最强的模型,在量化、硬件设计等领域登顶;芯片设计分榜则由 GPT 6.1 Sol 以 5.6% 居首、Opus 5.5 以 4.8% 居次;Gemini 4 Carbon 是唯一和它同一档次的挑战者;GPT-6 Astra 则把 RSI 和材料科学收入囊中。第二,分数低不等于能力弱——SemiAnalysis 明确说,Opus 5.5 与 GPT-6 Astra 的整体分数都被各自的安全分类器拉低了,排除网络安全、生物与对齐三个会被安全策略拦截的领域后,两家模型的总分会明显上升。第三,金融与法律被官方点名是最难的领域:隐藏评测任务里几乎所有模型都得了 0 分,公开的部分榜单才出现 Opus 54.6% 这类相对高分。
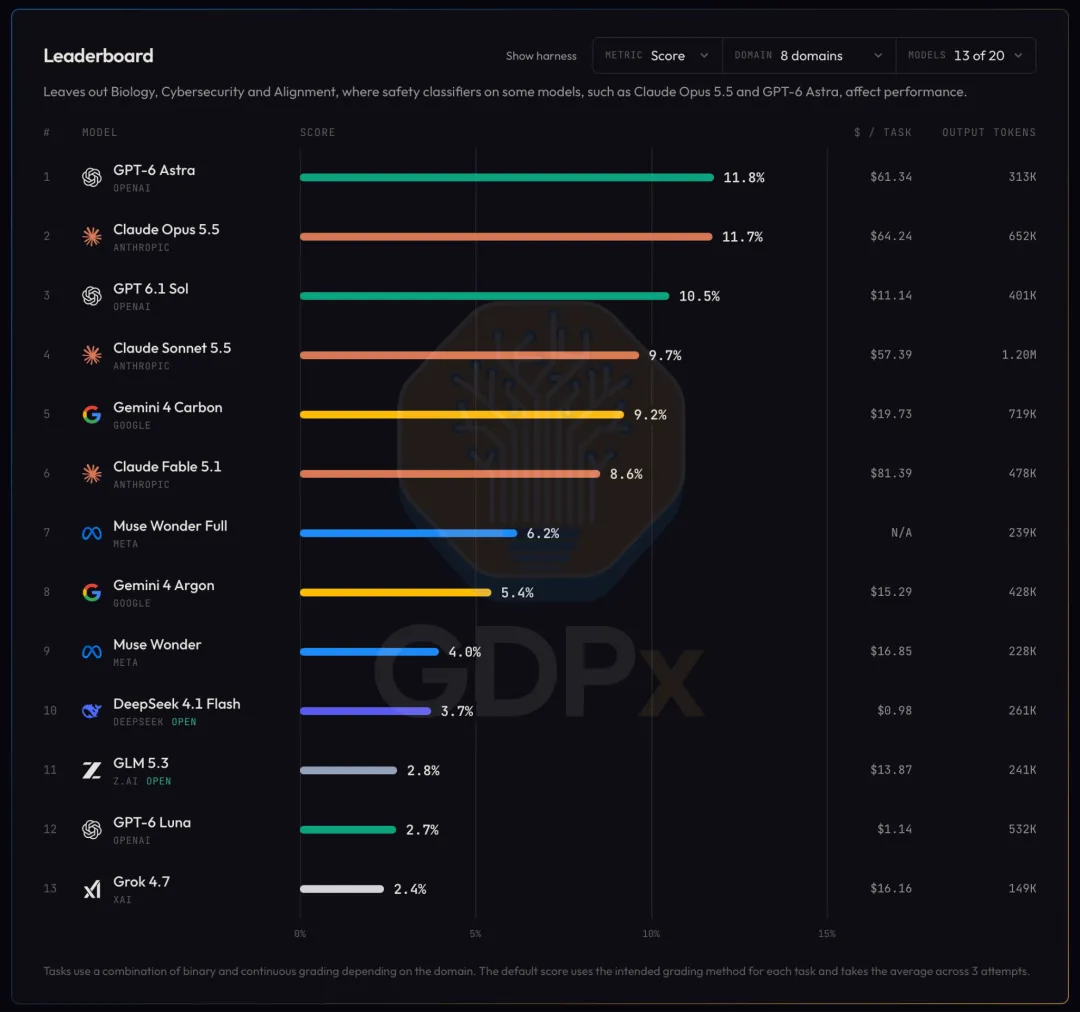
剔除会触发安全分类器的生物、网络安全与对齐三个领域后,GPT-6 Astra 以 11.8% 升至第一,Opus 5.5 以 11.7% 紧随其后。|来源:SemiAnalysis / GDPx
把这张全景图放回本文的主线,结论更有分量:在一个冠军如此分散、整体水位如此低的基准里,芯片设计却是唯一被安排 3 家合作方、出了最多考题的领域——SemiAnalysis 的“偏心”,本质是一次产业判断:这里最可能诞生 AI 的下一个杀手级应用。
SemiAnalysis 给了两个理由:第一,他们判断 AI 在芯片设计上的支出从 2027 年起会显著放量,这是继编程之后最确定的杀手级应用;第二,他们自己就是做半导体分析的,想让芯片设计在自家基准里多占些分量。三个合作方分别是做前端验证与 PPA 优化的 Aria、做验证测试平台(testbench)的 Arcverex、以及做物理实现(后端)的 Ergodex——刚好覆盖了芯片设计流程里最核心的三个环节。
为什么编程之后,轮到的是芯片设计?把两次浪潮放在一起看就清楚了。编程能成为 AI 第一个杀手级应用,核心在于闭环可以客观验证:代码写得对不对,编译和测试说了算,失败成本低、迭代速度快,AI 的试错优势能直接兑现。芯片设计几乎完美复刻了这套结构——RTL 可以综合、仿真、签核,每个环节都有硬性、可自动检查的客观标准;而它的价值密度又远超普通编程:一颗先进制程芯片的研发投入动辄以亿元计,一次流片失败的直接损失可能高达千万元级,哪怕只把设计效率提升 10%,省下的人力与时间成本都足以让厂商重金投入。需求就在那里,闭环已经存在,剩下的只是 AI 能力何时补足——这正是 SemiAnalysis 把 2027 年当作放量节点的原因。
02 三道考题:把真实工程师的一天装进沙箱
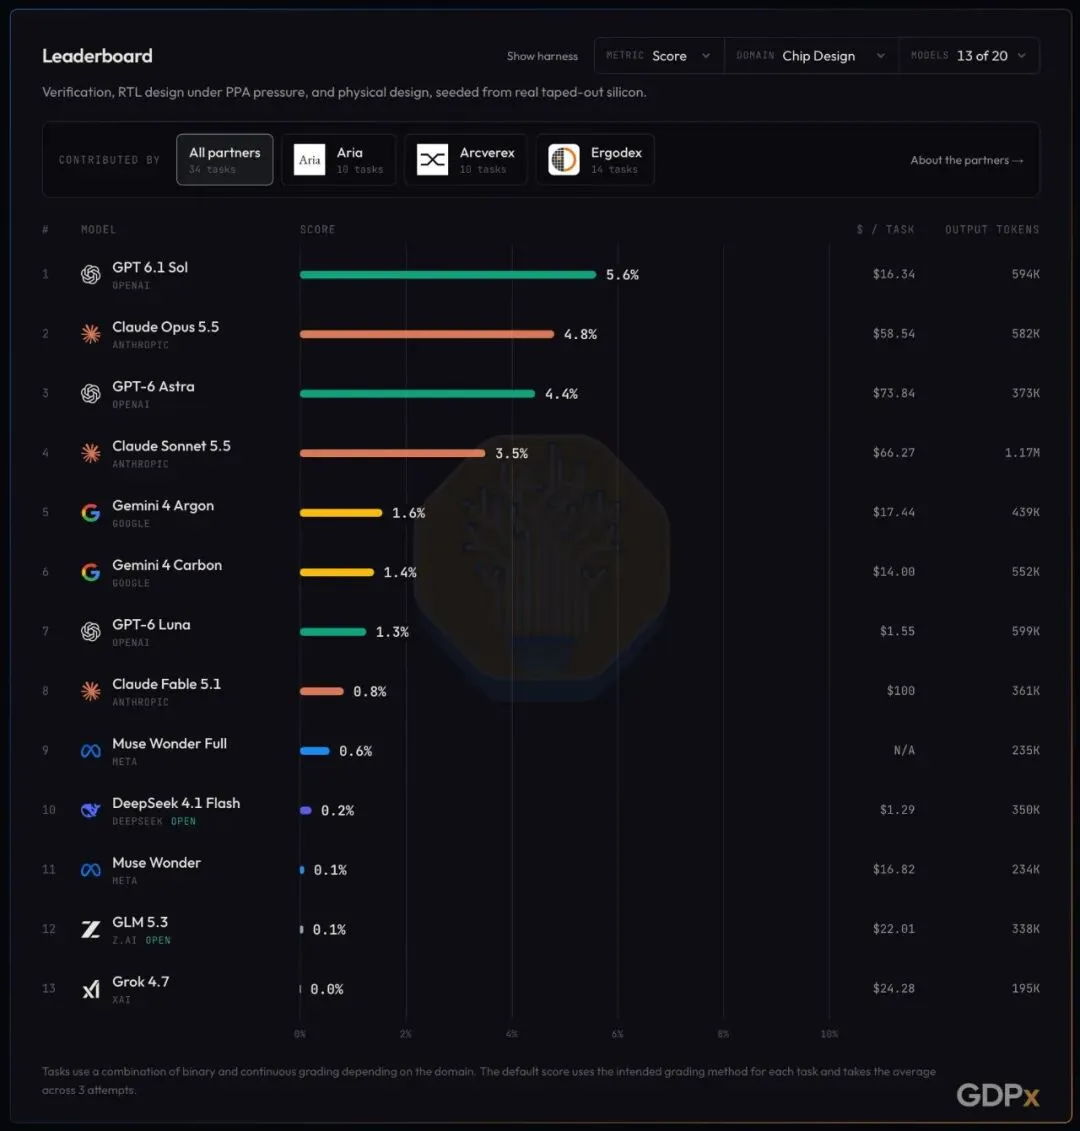
芯片设计分领域榜单:GPT 6.1 Sol 5.6% 居首,Opus 5.5 4.8% 次之;顶部可见 Aria 10 题、Arcverex 10 题、Ergodex 14 题,合计 34 道题。|来源:SemiAnalysis / GDPx
GDPx 的芯片设计任务不是“让 AI 写一段 Verilog”这么简单。三道考题对应设计流程的三个环节,每一道都尽量还原工程师真实面对的约束。
Aria:前端验证与 PPA 优化,用真实流片过的芯片当考题
Aria 的任务分两类。验证类任务里,AI 扮演设计验证(DV)工程师,要从架构规格出发,写出一套模块的 sign-off 回归测试。评分标准是:这套测试能不能把“正确的实现”和“有 bug 的实现”区分开。关键在于,那些被故意埋进去的 bug,很多是当年真的漏过了原设计团队、随芯片一起出货过的真实缺陷。
PPA 优化类任务里,AI 扮演 RTL 工程师:实现一个与生产参考模型在数百个隐藏 workload 上逐比特一致的模块,再在真实时序与面积约束下优化速度、面积和能耗——也就是传说中的“又快又小又省电”。
它们的公开任务 Tensor Graph Machine 更能体现野心:把整颗芯片当作黑盒,只规定引脚和功能——与 TensorFlow Lite 的 int8 参考内核在每个输入上逐比特一致,最终必须交付一棵已经布局布线、通过时序、DRC、LVS、IR-drop 和形式等价检查的 Nangate45 版图。评分标准是 EDAP(时延×能耗×面积)相对专家参考的比值。
结果:最强模型 Opus 5.5 拿到 0.392 分,GPT-6 Astra 0.244,Gemini 4 Argon 0.064,而 GLM-5.3 三次运行全部在综合或功能测试阶段就折戟,直接得 0。Aria 总结了三类常见失败模式:在 PPA 压力下正确性崩坏——模型为了优化性能把功能改错,而且错得无声无息;架构推理弱——模型在实现功能正确后就陷入局部迭代,很少回到架构层面做全局权衡;以及设计收敛(design closure)判断失误——模型低估了“改到能收敛”需要多少次迭代,没法在固定的计算预算内跑完综合、仿真和布局。
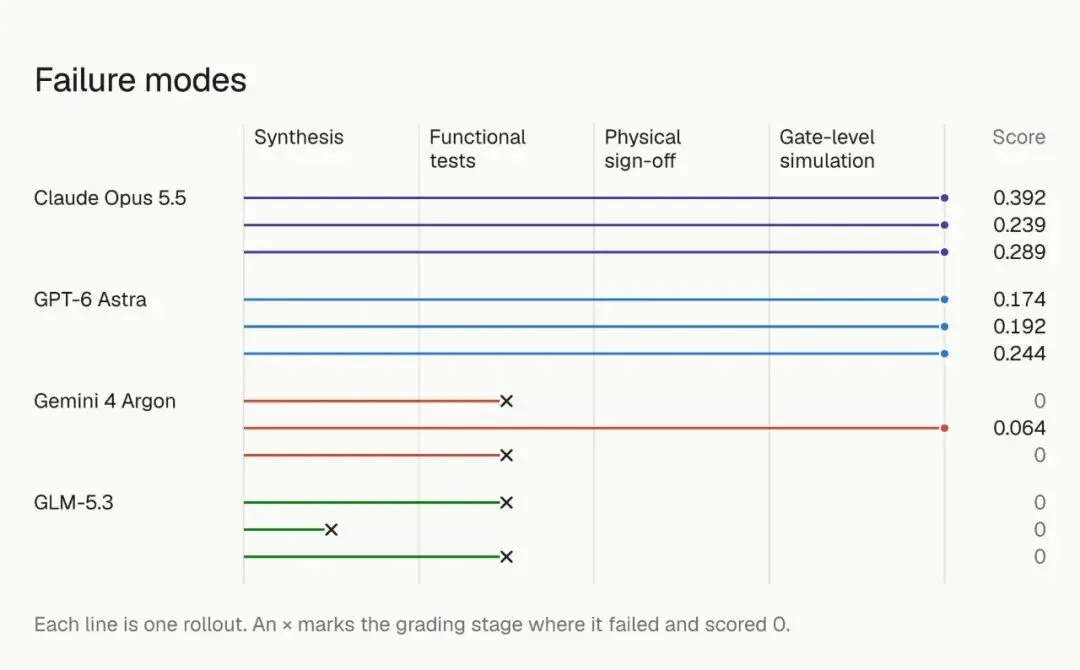
Aria“Tensor Graph Machine”三次运行的失败阶段分布:Opus 5.5 最高 0.392,Astra 0.244,Gemini 4 Argon 0.064,GLM-5.3 全部折戟。|来源:Aria / GDPx
Arcverex:验证是深水区,覆盖面大不等于抓得准
Arcverex 的任务很纯粹:写自检的 SystemVerilog 测试平台(testbench),要求它必须接受所有正确实现,同时通过公开接口抓出所有故障实现。公开任务 Coherence Writeback 考的是缓存一致性系统的写回行为——这正好是芯片里最难验证的一类逻辑。
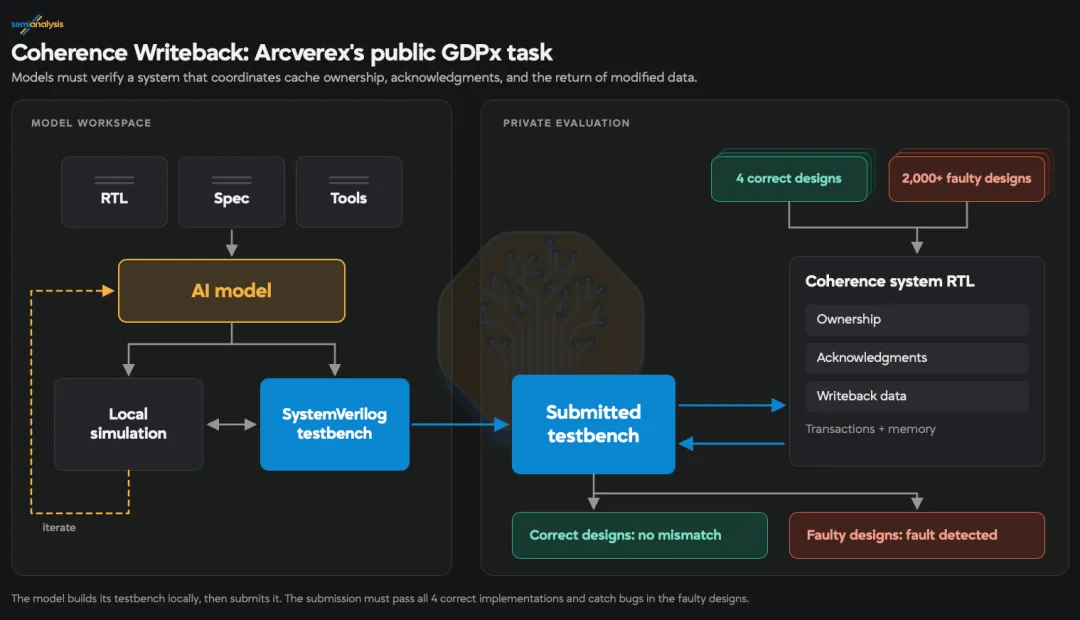
Arcverex 的 Coherence Writeback 任务流程:模型写的 testbench 必须接受 4 个正确实现,同时从 2,235 个故障变体中抓出缺陷。|来源:Arcverex / GDPx
每个 testbench 会面对 2235 个故障变体。结果:Opus 5.5 三次运行分别漏掉了 58、129、7 个;Astra 漏掉 90、81、38 个。所有提交都通过了 4 个正确实现——也就是说,模型写的测试“看起来很有覆盖”,但漏掉了恢复逻辑、事务标识校验、传输过程中权限约束这类致命缺陷。
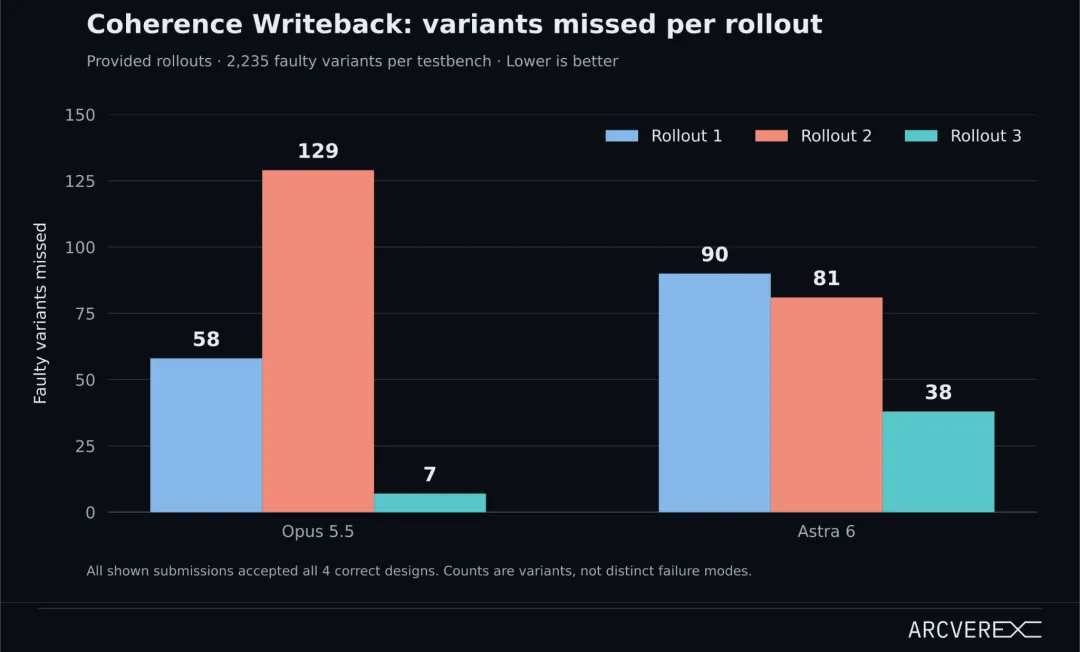
漏检统计:Opus 5.5 三次分别漏掉 58、129、7 个故障变体,Astra 6 漏掉 90、81、38 个;所有提交都通过了 4 个正确实现。|来源:Arcverex / GDPx
这个结果的价值在于它量化了一个行业共识:覆盖率数字高,不代表验证充分。这也是为什么验证会被反复强调为 AI 芯片设计最难啃、也最值钱的环节。
Ergodex:物理实现的“中间层”工具缺口
后端任务难在哪?Ergodex 的创始人来自开源物理设计栈 OpenROAD,他们点出了一个尴尬的现实:商用 EDA 工具太慢——一次 Innovus 跑下来要数天到数周;开源工具又太弱——ICCAD 2025 上,OpenROAD 连 10 万单元规模的设计都搞不定。而 AI 强化学习需要的是“分钟到小时级、又能反映真实物理效果”的环境,中间缺一个层次。
Ergodex 的预测性 CAD 工具就填在这个空档:几分钟到几小时跑完,在 10 纳米以下工艺能通过晶圆厂认证的第三方签核;在 ICCAD 2026 上,用它的工具能把 OpenROAD 相对商用工具的 PPA 差距中位数压到 15%,规模到 50 万单元、7 纳米 PDK。速度与保真度的组合,让原本以“周”为单位的任务能被压缩进 8 小时沙箱。
它的任务清单就是后端工程师的日常:late timing ECO、面向时序的宏单元布局、带时序目标的 PDK 移植、面向面积和时序的网表重构、以及把一个 tile 闭合到完整签核。公开任务 vt01 是给一颗已经布局布线、2.2 纳秒时钟的 Ibex RISC-V 核做时序修复 ECO:8 小时、8 个 CPU,最多只能改 2.07 万个单元中的 104 个,不允许新增触发器和时钟门。
结果很有意思:GPT-6 Astra 平均分 0.344,把 Opus 5.5(0.135)和 Claude Fable 5.1(0.071)远远甩开。Ergodex 观察到一个稳定现象:在 ECO 这类“有限修改、反复逼近”的任务上,OpenAI 系模型整体强于 Anthropic 系。失败模式也很有代表性:改得太激进会违反电容、时序或布线约束;改得太保守又找不到真正有效的 ECO——这背后是对关键路径的识别、并行工具运行的调度、以及试错中的判断力。
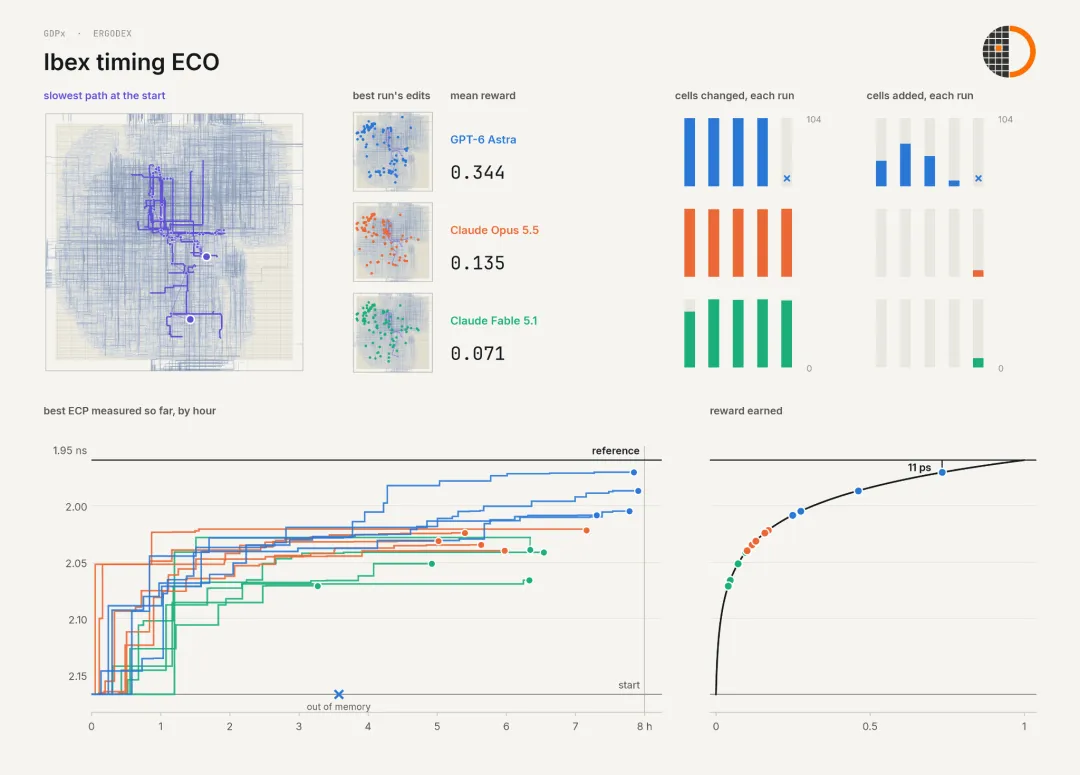
Ergodex“Ibex timing ECO”8 小时运行结果:GPT-6 Astra 平均 0.344,Opus 5.5 0.135,Claude Fable 5.1 0.071。|来源:Ergodex / GDPx
03 对照现实:EDA 三巨头和 AI 公司,已经全部下场
GDPx 测的是模型能力的水位,而产业界的动作比基准更激进。过去一年,AI 进芯片设计这件事已经从“讨论要不要做”变成“军备竞赛”。
海外 EDA:从 Copilot 到 Level-5 自主智能体
Synopsys 最早把生成式 AI 装进工具链。Synopsys.ai Copilot 官方数据是:信息检索时间降低 40%,部分任务的求解时间缩短 10 到 20 倍;到 2026 年 4 月,已有五类 Copilot 助手商业化,客户反馈整体生产力提升 2 到 5 倍。今年 7 月,Synopsys 又联手微软,基于 AgentEngineer 技术推出“除错收敛”和“实施与收敛”两项自主智能体工作流,早期测试显示除错周期缩短 25%。
Cadence 则押注“从芯片到系统的全覆盖”。2026 年 2 月发布业界首个前端设计验证代理式工作流 ChipStack AI Super Agent,几个月后就升级到 Level-5 自主级别,号称业界首款具备全自主芯片设计能力的 AI 虚拟工程师。今年 6 月的 Computex 上,NVIDIA 用它跑了一次完整验证闭环,用时不到一天——相比几个月前宣传的“提速 10 倍”,又快了 40 倍,而且是跑在量产级 RTL 上。Cadence 还推出 AuraStack,与 ChipStack、InnoStack、ViraStack 一起覆盖验证、数字实现、模拟设计和 PCB/封装。
Siemens EDA 走的是“NVIDIA 算力 + 自验证”路线:2026 年 7 月发布 Fuse EDA AI Agent 系统,特点是“自验证(self-verifying)”——让智能体边干边校验自己的产出,把可信度作为交付标准。
国内 EDA:智能体是国产替代的新变量
国产 EDA 厂商这轮跟得很快。合见工软今年 3 月发布第二代数字设计 AI 智能平台 UDA 2.0,宣称可自主完成 RTL 设计、验证、纠错与优化全流程;9 月又提出“AI Native 系统级硬件设计平台”的新范式。华大九天推出 .aix 平台,思路是“Design by AI,验证靠签核”——AI 负责设计生成,但最终以签核计算引擎的结果为准,并用安全沙箱隔离风险;同时用自然语言即可调用的 Aether Coder 降低脚本门槛。芯华章则把智能体送进了汽车芯片设计——汽车芯片验证周期占到研发总时间 70% 以上,这是智能体最想啃的硬骨头。
中国电子报在 4 月的一篇报道里用了一个很直白的标题:智能体大踏步进入 EDA 产业。对国产 EDA 来说,AI 智能体既是挑战,也是绕开“工具垄断”的新变量——36氪的判断是,这可能是国产厂商的黄金窗口。
AI 公司自己下场造芯:用自家模型加速自家芯片
最标志性的动作来自 OpenAI 和 Anthropic。OpenAI 与博通合作开发的 LLM 推理芯片,设计周期只用 9 个月完成,官方明确说这一进程“由 OpenAI 的模型加速”。Anthropic 在 8 月首次公开确认组建内部定制芯片团队,走软硬件协同设计路线,目标是把 Claude 的推理成本砍掉一半。
三星则把 Claude Code 用进了 System LSI 的验证与开发流程,部分任务的加速效果显著。更早的铺垫是谷歌 DeepMind 的 AlphaChip——用强化学习做宏单元布局,从 2021 年发表 Nature 论文到现在,已经在多代 TPU 上流片,也被联发科等外部厂商采用。
把时间线拉直看,路径很清楚:AlphaChip 时代是“AI 解决单点问题”(布局),大模型时代是“AI 接管整段流程”(写 RTL、跑回归、做 ECO、收敛签核)。GDPx 测的,正是后者走到哪一步了。
04 三个容易被误读的判断
把 GDPx 的结果和产业动态放在一起,有三个流行说法需要纠偏。
误区一:“AI 马上就能自己设计芯片了”
这是最大的误读。GDPx 恰恰给出的是相反的证据:最强模型在“黑盒设计一颗能过签核的芯片”上只拿到 0.392 分,在“8 小时收敛一个 ECO”上平均分只有 0.344,在“抓出缓存一致性缺陷”上会漏掉几十上百个故障变体。产业界的 Level-5 自主智能体,目前跑通的也是“验证闭环”这类局部任务。更准确的说法是:AI 已经能稳定地当一个很强的工程师助理,但离“自主设计并交付一颗量产芯片”还有明显距离。
误区二:“验证问题已经被 AI 解决了”
恰恰相反,验证是当前暴露短板最多的环节。三个合作方里有两家就在测验证,结论一致:模型写的测试“覆盖面很大”却抓不住关键缺陷。Synopsys 的自主除错工作流,宣传口径也是“除错周期缩短 25%”,而不是消灭除错。验证的本质是“证明一个系统在所有重要场景下行为正确”,这需要的是对设计意图的理解,而不只是覆盖率数字——这正是当前大模型最不擅长的地方。
误区三:“会写 RTL 就等于芯片设计能力强”
Aria 的观察打破了这条等式:模型在验证上的短板,会被 PPA 优化放大,导致实现“静默出错”;一个模型整体的芯片设计能力,与其“能否写出全面、高效的测试平台”高度相关。RTL 只是入口,验证和物理实现才是深水区——这跟人类工程师的职业生态一模一样。
05 对工程师意味着什么:角色重新分配,而不是被替代
Aria 在文章里提出了一个很锋利的观点:今天芯片设计从架构到流片的标准化流程,每一段都由不同团队负责——这个划分“与其说是芯片本身的属性,不如说是企业组织、EDA 工具和人类工程师上下文长度共同作用的产物”。
如果大模型真的在芯片设计上变得超人类,这些抽象边界会一点点被侵蚀:一个智能体可以从 RTL 一路做到版图签核,中间不再有人类组织强加的工序断点。这句话值得每个芯片从业者认真读两遍——它意味着流程在被重构,而不是某个岗位被简单替换。
那么工程师的新位置在哪?至少有三块:第一,架构与设计意图——“做什么、为什么这么做、边界在哪”仍然是人来定义;第二,验收与责任——Cadence 的工程师们有一句很直白的话:你仍然要做那些工作,只是不再做无聊的部分;至顶网访谈里,行业人士也反复强调,责任归属不明确之前,“一键流片”不会成为现实;第三,判断 AI 哪里错了——Synopsys 和至顶网都指出,目前必须由人来监督 AI 的产出,而这种监督能力恰恰来自经验和对芯片用途的深入理解。
需求侧的数据也在说话。猎聘大数据显示,行业里需求增长最快的就是 AI 相关芯片设计方向,AI 芯片架构师“一将难求”,头部岗位年薪百万级。职能边界在模糊,但人的判断力、验收力和架构力在升值。
给工程师三个可执行的动作:一是把 AI 当作“能力很强但需要验收的实习生”——布置任务、检查结果、让它返工,而不是把结果直接当作交付;二是重视验证技能的升值——会设计测试平台、会做故障注入、会审计 AI 验证证据的人,在 AI 时代反而更贵;三是盯住 ECO、后端实现、签核这些“AI 水位最低、人最值钱”的环节,那里是未来几年护城河最深的地方。
06 以后怎么判断 AI for Chip 走到哪一步了
面对铺天盖地的“AI 设计芯片”宣传,与其听发布会,不如盯住三个指标:
第一,能不能过真实签核。AI 的输出要能通过时序、DRC、LVS、IR-drop 和形式等价检查,而不是“看起来像”。Aria 的 Tensor Graph Machine 就把任何过不了签核的提交直接判零分——这是最硬的门槛。
第二,能不能抓住漏网的 bug。验证能力不看覆盖率数字,而看能不能抓出真实缺陷。Arcverex 的 2235 个故障变体测试提供了一个很好的参考系:如果一套测试面对大量故障变体还漏检,那它再“全面”也不可信。
第三,能不能闭环迭代。在一个 8 小时的沙箱里,AI 是否能在真实工具链中自主完成“设计—检查—修改—再验证”的循环。Ergodex 的 ECO 任务、Cadence 的验证闭环、Synopsys 的除错收敛,测的都是同一件事。
结论需要边界:目前能确定的是,AI 在芯片设计上已经从“辅助工具”进入“流程智能体”的早期阶段,验证和物理实现是当下最硬的两个瓶颈,而 2027 年会不会如 SemiAnalysis 所料放量,要看流程智能体在真实项目里的渗透率和“签核闭环”的证据,而不是看各家发布会上的口号。
编程之后,AI 的下一个杀手级应用大概率就是芯片设计——但“杀手级”的前提,是把今天基准测出的短板一个个补上。最后回到 GDPx 那句话:真正改变行业的,往往不是模型会写几行代码,而是成本、效率和信任关系同时发生变化。AI for Chip 的水位不在“能不能写出 Verilog”,而在能不能在一个真实沙箱里通过真实签核、抓住真实缺陷、完成真实迭代——这恰好也是工程师未来几年不会被替代、但一定会被重新分工的原因。
本文图表均引自 SemiAnalysis《GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains》(2026 年 11 月 2 日)
往
期
精
选
“十五五”期间中国集成电路产业如何实现全球前三、自给率80%、7nm国产化等远大目标?