ARTICLE · 1313005
5万下载暴跌84%,谷歌AI视觉工具遇冷
5万下载,10月环比暴跌84%。谷歌把Dreambeans推到印度,试图用个人数据生成视觉故事,但市场反应极其冷淡。
先说结论:
- 谷歌Dreambeans美国下载量仅5.5万,10月暴跌84%,C端个人故事需求是伪命题。
- 竞品Muse首月740万下载,通用AI工具依然碾压垂直场景。
- 工具新增Veo视频模型动画功能,接单设计师可关注其底层能力而非C端产品。
C端不买账,个人数据故事是个伪需求?
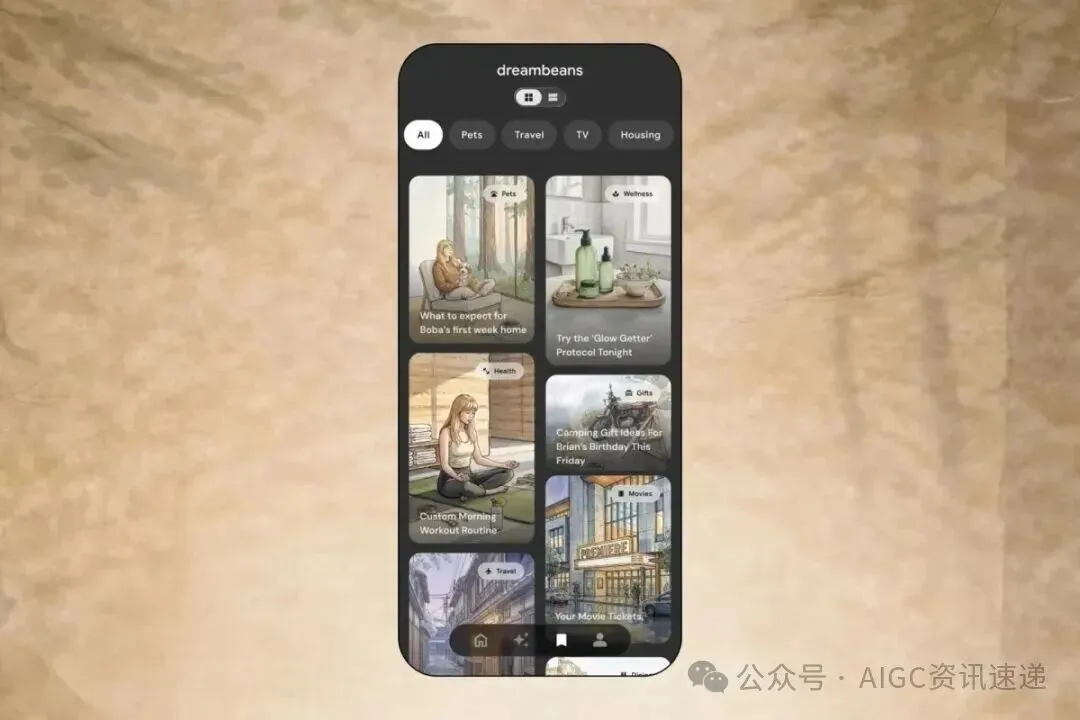
Dreambeans的核心卖点是读取你的Calendar、Gmail、Photos和YouTube数据,不用写提示词就能自动生成带插图的视觉故事。听起来很美好,但 Sensor Tower 的数据显示,这款应用在美国开放下载后的前30天只拿到了2.9万次下载。到了10月,下载量直接暴跌84%至5500次。用户用脚投票证明了,大家并不需要一个AI来自动翻旧账。对于靠视觉吃饭的设计师来说,这直接戳破了一个幻觉:客户根本不需要“全自动生成的个人回忆”,他们需要的是能直接商用的视觉资产。这种缺乏控制力的C端玩具,完全无法转化为B端生产力。
更致命的是隐私和控制力问题。这款应用依赖用户的Google账户数据,产品经理 Gozde Oznur 承认,它甚至可能生成涉及死者的故事,让用户感到不适。在印度市场,它还不支持混合语言(比如Hinglish),只能单选一种语言。这意味着它的底层语义理解非常死板。你接活的时候,客户让你改个细节,你得能精准控制。而Dreambeans这种“黑盒式”的自动生成,连语言混合都搞不定,更别提满足商业级项目的修改需求了。靠这种工具接单,只会让你在无尽的返工中崩溃。
下载量对比背后的真实工作流需求
我们来看看 Sensor Tower 给出的首月30天下载量对比数据:Dreambeans 2.9万,Meta的Muse高达740万,ChatGPT 280万,Grok Bot 36.2万,Claude 15.5万。差距是数量级的。通用大模型之所以能碾压垂直场景,是因为它们提供了极高的自由度和工作流兼容性。设计师和自媒体人需要的是能融入现有生产线的工具,而不是一个只能看不能改的“故事会”。Dreambeans的惨淡数据说明,试图用单一垂直场景去框住用户的AI产品,在当前的创作生态里根本行不通。
这给接活的设计师提了个醒:评估一个AI工具能不能帮你赚钱,别看它概念多炫,要看它能不能无缝接入你的工作流。Muse能拿740万下载,是因为它能处理各种宽泛的查询和生成任务。而Dreambeans只能被动地给你喂故事。在实际接单中,你需要的是能精确控制镜头、光影、人物一致性的工具。如果一个工具连用户想混用两种语言都满足不了,它就不可能满足甲方“把Logo放进视频里还要保持动态模糊”这种离谱但真实的需求。
Veo模型才是接单设计师该盯的肥肉
虽然Dreambeans这个产品拉胯,但原文提到一个关键细节:谷歌最近给它加了Veo视频生成模型,用来把静态插图动画化。这才是视觉工作者该盯的重点。Veo模型如果能被拆解或者集成到本地工作流里,用来做动态分镜、产品展示动画,那是实打实的接活利器。你可以用它来快速生成客户提案里的动态效果,大幅缩短前期沟通成本。别去管Dreambeans这个C端壳子,去研究Veo模型本身的参数和生成逻辑。以下是原文提供的相关链接,建议收藏查阅底层技术动态:
Dreambeans的翻车证明,完全依赖用户隐私数据且缺乏控制力的AI产品走不远。作为独立设计师,我们要警惕这种“全自动无脑生成”的产品思路。接活时,客户需要的是精准控制,而不是AI给你瞎编一个故事。把精力放在研究Veo这种底层视频模型的提示词和节点控制上,才是保住饭碗的关键。想靠一个连语言混合都不支持的自动生成器去糊弄甲方,最后只会砸了自己的招牌。
评论区唠唠
你现在主力跑什么视频模型?显存多少?出片速度多少?
往期推荐
- ·Grok Bot额度从50%跳到100%,马斯克承认成本兜不住
- ·网页抓取数据微调翻车,模型竟吐出半渲染HTML
- ·准确率从 50% 到 90%,ElevenLabs 语音微调太狠
点击公众号头像 → 历史消息,可翻阅以上文章