ARTICLE · 1317695
AI与学术研究:这个330星的开源项目能自动修好LaTeX报错却不能替你核一条引文
全文约 4441 字 · 阅读约 11 分钟
项目信号:★330 stars、35 forks、3 人 watch、8 个未解决 issue,主要语言 TypeScript,创建于 2026-02-04,最近一次推送 2026-05-12。半年时间三百多星,属于小而具体的项目,距上次推送已过去将近三个月,README 里被标为 beta 的功能还没等到下一轮修复。协议要看两处,README 徽章与文末都写 MIT License,GitHub 元数据那一栏是空的,说明抓取方没读到许可文件,以 README 的声明为准,落地前自己去仓库确认一遍 LICENSE 文件是否真的在。
关键词及解析:
- LaTeX
:学术界通用的排版语言,论文写成纯文本源码再编译成 PDF,公式、参考文献和会议模板都靠它,编译报错是它最折磨人的一环。 - Agent 模式
:AI 不直接改文件,先生成一份改动对照(diff)给你确认,你点了才落盘。 - Template Transfer
:把一篇已经写好的稿子迁到另一个会议的模板里,README 提供 LaTeX 到 LaTeX 与 PDF 到 Markdown 到 LaTeX 两条路径,目前标注为测试中。 - 本地优先
:项目文件和数据默认存在你自己机器的 `data/` 目录,模型接口指向哪里由你在配置里决定。
这个项目自动化的核心环节是 LaTeX 从源码到能看的 PDF 之间那段反复试错,AI 被挂在编辑器旁边当助手,起草论文这件事仍在你手上。
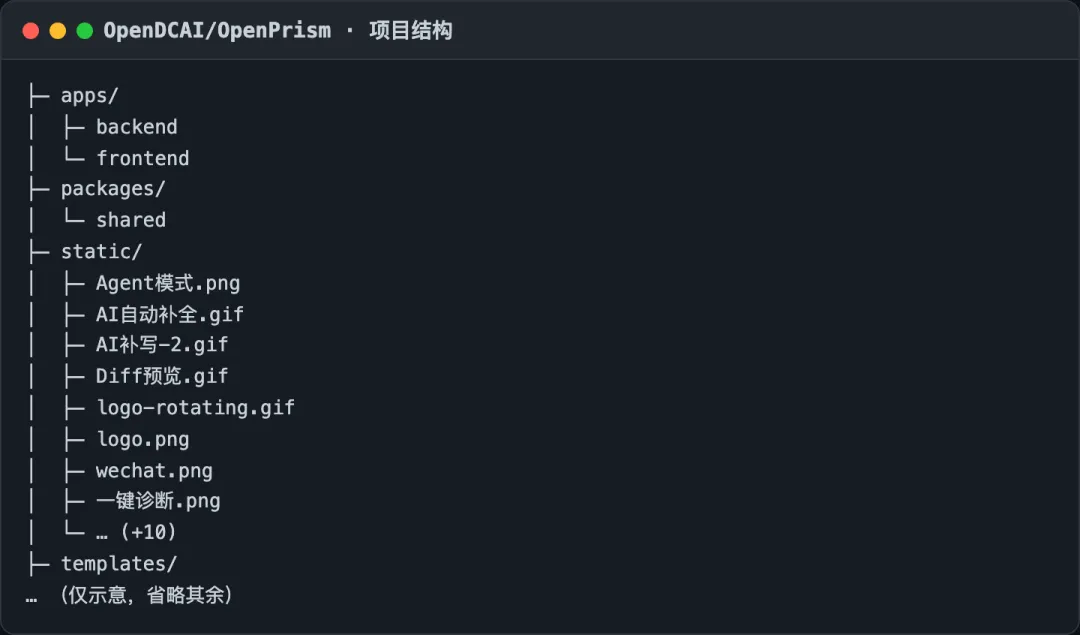
项目结构
对着结构图看,它是一个前后端分离的两块结构。`apps/frontend` 是 React 加 Vite 的界面层,里面 `app/App.tsx` 管主逻辑,`latex/` 目录接 TexLive,`api/client.ts` 负责跟后端说话。`apps/backend` 是 Fastify 服务,`index.js` 同时承担三件事,对外的 API、真正调编译器出 PDF、以及把你的请求转发给大模型。旁边 `templates/` 放 ACL、CVPR、NeurIPS、ICML 四套会议模板,`data/` 是默认的项目存储目录。
这个结构里最值得看的是 backend 下面那棵 `transferAgent/` 子树。 它有 `graph.js` 和 `graphMineru.js` 两张图、一个 `state.js` 状态定义和一个 `nodes/` 目录,用的是 LangGraph 这种把多步流程写成节点图的编排方式。README 说明这条流程做四件事,先让模型分析原模板与目标模板的结构差异并给出迁移方案,再做内容映射,然后自动检测并修复编译报错、带重试,最后可选调一个视觉模型检查排版有没有溢出、重叠和间距问题。
数据流因此有两条。日常写作那条是你在编辑器里改、点编译、右边出 PDF,报错时编译日志被解析成可点击的位置,一键诊断把错误交给模型解释。换模板那条是把整份稿子丢进上面那张图,MinerU 模式还会先把 PDF 解析成 Markdown 再往目标模板里填。
把编译报错的排查交给模型,是整个项目里价值最扎实的一处。 LaTeX 报错信息常常和真正的病因隔着好几层,一个没闭合的括号能报到几十行之外,这类查错对人是纯消耗,对模型恰好是它擅长的模式匹配。
另外三块能力挂在同一个界面上。检索有 WebSearch 和 PaperSearch 两项,后者带引文信息。表格能一步转成图表,公式和图表能被识别成可编辑的结构。协作那块用 CRDT 加 WebSocket 做多人同时编辑,光标实时同步,但 README 写明当前版本需要一台有公网 IP 的服务器,本地跑的人用不上。
评中,卡人的地方在 LaTeX 环境而不在这个项目本身。
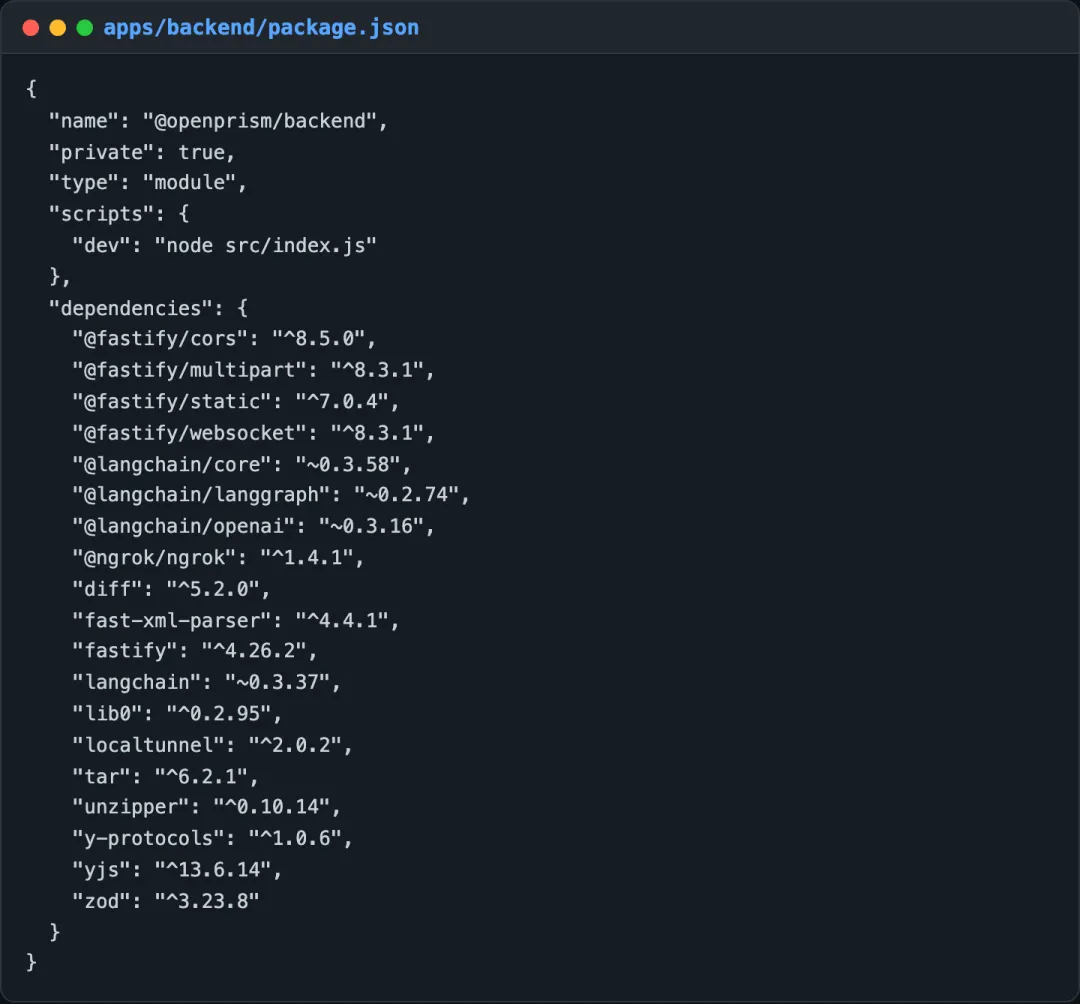
关键配置:apps/backend/package.json
后端的依赖清单说明了它为什么必须先有别的东西才跑得起来。它自己只是一个 Fastify 服务加编排逻辑,真正生成 PDF 的编译器不在 npm 包里,得你先装。README 给了两个选项,TexLive 完整版功能全但要占 5 到 7 GB,Tectonic 轻但功能少,配置里还能选 pdflatex、xelatex、lualatex、latexmk、tectonic 具体哪个引擎,写中文的人要走 xelatex 这一路。
装完之后项目本身只有三步,clone、`npm install`、`npm run dev`,前端起在 5173,后端起在 8787。要求 Node.js 18 以上、npm 9 以上,三个操作系统都支持。
配置分两种填法。写 `.env` 文件的话,`OPENPRISM_LLM_ENDPOINT`、`OPENPRISM_LLM_API_KEY`、`OPENPRISM_LLM_MODEL` 三项指定模型,`OPENPRISM_DATA_DIR` 指定数据目录,用 MinerU 那条迁移路径还要额外填 `OPENPRISM_MINERU_TOKEN`。不想碰命令行的话,界面里有设置面板,填完自动存进浏览器的 localStorage。它接受任何 OpenAI 兼容的接口,README 举例包括 OpenAI、Azure OpenAI 和第三方中转服务,示例模型写的是 gpt-4o-mini。
坑有三处。第一处是 TexLive 那 5 到 7 GB 的下载,网络不好的时候这一步比全部代码加起来更花时间。第二处是 Template Transfer 被 README 用醒目警告标为测试中、可能有已知与未知的 bug,赶投稿截止时间的时候不要指望它。第三处是协作功能的公网 IP 要求,README 给了 ngrok 隧道作为替代方案。
代码本身开源免费,模型接口费自付。 接本地模型或校内自建服务可以做到零接口费,用 MinerU 解析 PDF 那条路径需要另外申请它的 token。
它帮到的是写作和投稿的最后一段,文献这一环它基本没接上。
三处增益是实的。
第一处是编译与排版。一键诊断加自动修错这条链,省掉的是对着编译日志逐行猜的时间。据我们估算,一篇正常长度的会议论文在成稿阶段花在编译报错、图表位置、模板格式上的时间大致在两到五小时之间,这条链能吃掉其中一部分,具体多少取决于报错是常见类型还是模板本身的怪毛病,README 没有给出耗时数据。
第二处是换模板。一稿投多个会议是这个圈子的常态,从 NeurIPS 格式改成 ACL 格式手工做要重排作者块、字号、参考文献样式和图表环境,纯机械劳动。它把这件事做成一条带自动修错和排版检查的流程,即便还在测试中,做完手工复核也比从头重排快。
第三处是投稿前的自查。Peer Review 模块里有四项,AI 质量检查、完整的审稿意见报告、术语与符号一致性检查、以及找出哪些陈述需要补引用。一致性检查这一项对长稿特别有用,同一个概念前后用了两个词、同一个符号换了字体,这类错误人自己读十遍也容易漏,机器扫一遍就出来。找出需要补引用的句子也有价值,它指出的是位置。
不能可靠交给它的有三件。
第一件是引文本身。它有 PaperSearch 能查论文并给引文信息,但 Roadmap 里「自动检索相关论文并生成 BibTeX」这一项明确还是 Planned,也就是说这条链现在没有闭合。Peer Review 能告诉你这句话缺引用,填进去的那条引文仍要你自己到数据库里核对。 模型顺着上下文生成的参考文献看着格式完整、作者与期刊都像真的,一条查不到的引文足以让整篇稿子失去可信度,这一步没有任何省时间的余地。
第二件是审稿意见的分量。它生成的是审稿人风格的评论,读起来像意见,但它没读过你这个领域的争论现场,也不知道哪个批评在你的评审那里真的致命。当查漏工具用可以,当质量判断用会误导。
第三件是 Agent 改过的内容。Agent 模式生成 diff 让你确认这个设计是对的,前提是你真的逐条看。改动一多、diff 一长,人就开始整段接受,论证被悄悄改弱这种事在这个环节最容易发生。Diff 确认这道门只在你真的读它的时候才是一道门。
文件在本地,内容去哪由你填的那个接口地址决定,这两件事要分开看。
本地这一头是清楚的。项目文件存在 `data/projects/` 下面,默认就是你自己的磁盘,改 `OPENPRISM_DATA_DIR` 能换位置,没有强制的账号体系和云端同步。
出网这一头分三档。指向 OpenAI 或任何第三方中转服务,你的稿件片段就发给了那家公司,第三方中转这一档还多一层不确定,请求要经过一个你不了解其日志策略的中间方。指向学校自建或本地模型服务,整条链可以不出网,未发表的数据、访谈记录、受试者信息只在这一档下才谈得上安全。用 MinerU 模式做模板迁移是第三档,那是把整份 PDF 上传到它的云端 API 解析,处理带身份信息的材料时这一条要直接排除。
API key 存在浏览器 localStorage 里,共用的机器、别人也能登录的浏览器配置文件、装了来路不明扩展的浏览器,这三种情况下这把钥匙都不算安全。 命令行填 `.env` 的方式更可控。
协作那一块有两处需要动手。`OPENPRISM_COLLAB_TOKEN_SECRET` 这个签名密钥 README 明确写了生产环境必须改掉,默认值等于没有锁。另一处是 README 里那句提示,本机访问默认绕过 token 验证,方便本地开发,一旦你按它的隧道方案把服务暴露到公网,就要确认 `OPENPRISM_COLLAB_REQUIRE_TOKEN` 是开着的,否则拿到链接的人可以直接进你的编辑器。伦理审批限定了用途的材料、合作方给的未公开数据,在开着隧道的状态下不要放进这个工作区。
它适合已经在写 LaTeX、又愿意自己装环境和管模型接口的研究者,尤其适合一稿多投、经常被模板和编译折磨的人。习惯了 Word 的人用不上,指望它管文献库和引文的人会落空。把正在赶的稿子整个搬进去之前,先留好原来的工程目录和一条随时退回的路。
来源:OpenPrism,OpenDCAI/OpenPrism,https://github.com/OpenDCAI/OpenPrism,330 stars,README 声明 MIT License(GitHub 元数据未识别到许可文件)。