ARTICLE · 1323191
AI编程助手换个会话就失忆?我给它装了个海马体:claude-mem本地实测!
即使大模型支持1m的上下文,对于每一次会话上下文的延续也是很重要的,不可能每次都要重复把之前的沟通进程都忘掉!
比如:上周改一个重试逻辑,在会话里跟模型解释了三遍:为什么要从固定延迟换成指数退避,上限为什么是30秒,改完的文件在哪?
第二天我新开了一个会话,它又问我“你想改哪个文件”。
虽然目前基本所有的AI利器都是能把上一次会话接回来的,如:
OpenCode支持--continueClaude Code有--resume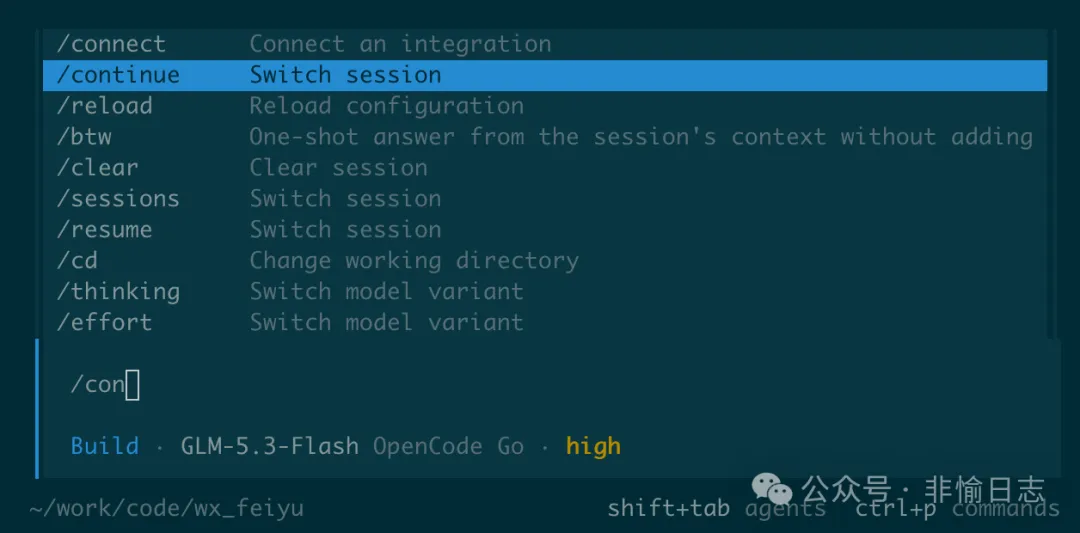
但想把整段对话重新加载,或者换个会话、换个工具、再隔几天回来,它还是不知道你上次为什么这么改呢?
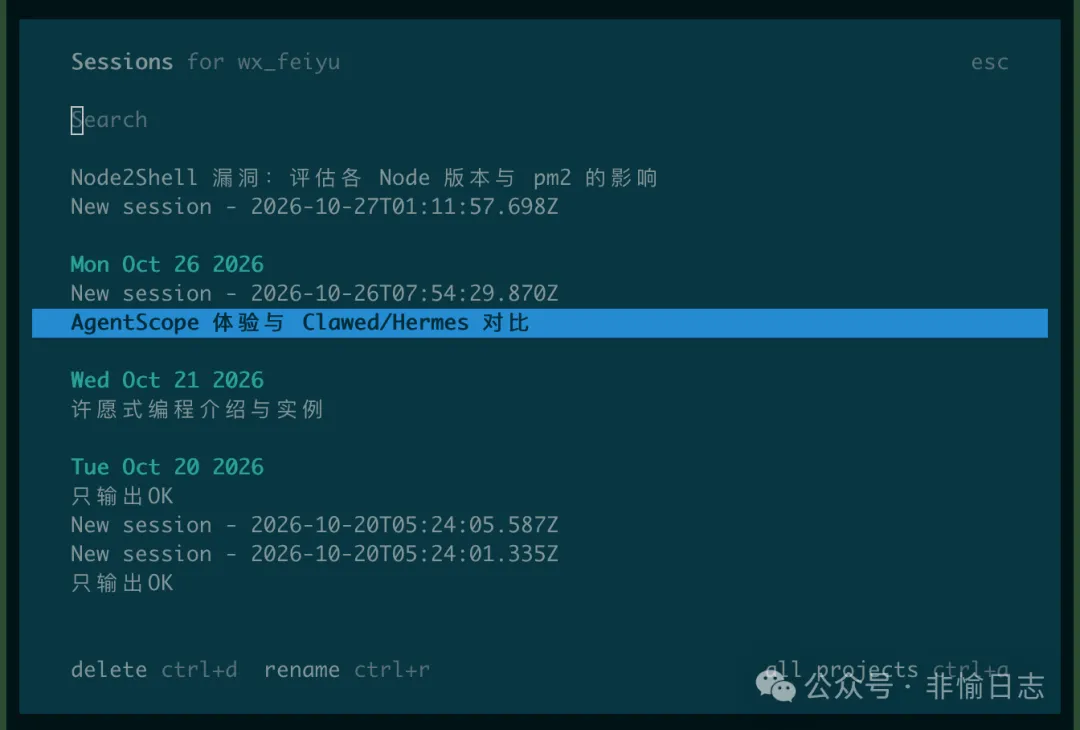
恰好,claude-mem项目就是弥补这块空白的!不重放整段对话,只把“做过什么、为什么”压成记忆,下次启动时带回来。
接下来是我在本机安装,使用claude-mem的记录,大家可以一块看看。
一、记的不是聊天记录
claude-mem挂在Agent的生命周期上,一共六个钩子:会话开始、用户提问、工具调用前、工具调用后、回合结束、会话结束!
工具调用发生后,它把这次操作交给一个观察模型,压成一条结构化记录,包含类型、标题、叙述、事实和涉及的文件;会话结束时再生成一份摘要,写清这次查了什么、学到什么、做完什么、下一步是什么...然后再下次会话启动时,它把最近的项目记忆拼成一段上下文,注入到系统提示里。
这里的存储分两层,一层是SQLite,一层是Chroma:
~/.claude-mem/claude-mem.db | ||
~/.claude-mem/chroma/ |
检索步骤:先search拿索引,再timeline看上下文,最后get_observations取详情。
它和--continue也不是一回事:--continue把上一次的完整对话接回来,claude-mem是把多次会话压成项目记忆,跨会话、跨工具都能用。
二、安装
安装命令很短:
npx claude-mem install--ide opencode支持OpenCode 1.3.4以上,包括OpenCode 2。
我这边是v2.2.5,符合要求!真正浪费时间的是安装过程中遇到的环境问题:
安装器要先装Bun,默认从GitHub拉二进制,下载完bun-darwin-aarch64.zip,解压到~/.bun/bin,把PATH补上。接着是provider:安装器默认引导登录cmem.ai,领30天试用,我不想把记忆交给第三方,就试了--provider host。它要求本机37777或37778已经有一个OpenAI兼容的observer,而它自己不启动。于是我改用--provider openrouter,把base URL、key和模型写进~/.claude-mem/settings.json,指向我自己的deepseek-v4-flash端点,观察生成正常。
最后是Chroma,worker起来后健康检查是ok,但Chroma一直unhealthy,日志里是chroma-mcp prewarm timed out after 120000ms——uvx要从PyPI拉chromadb和onnxruntime,首次下载超过120秒。使用清华镜像,又把uvx依赖预热了一遍,启动时间从几分钟降到2秒。
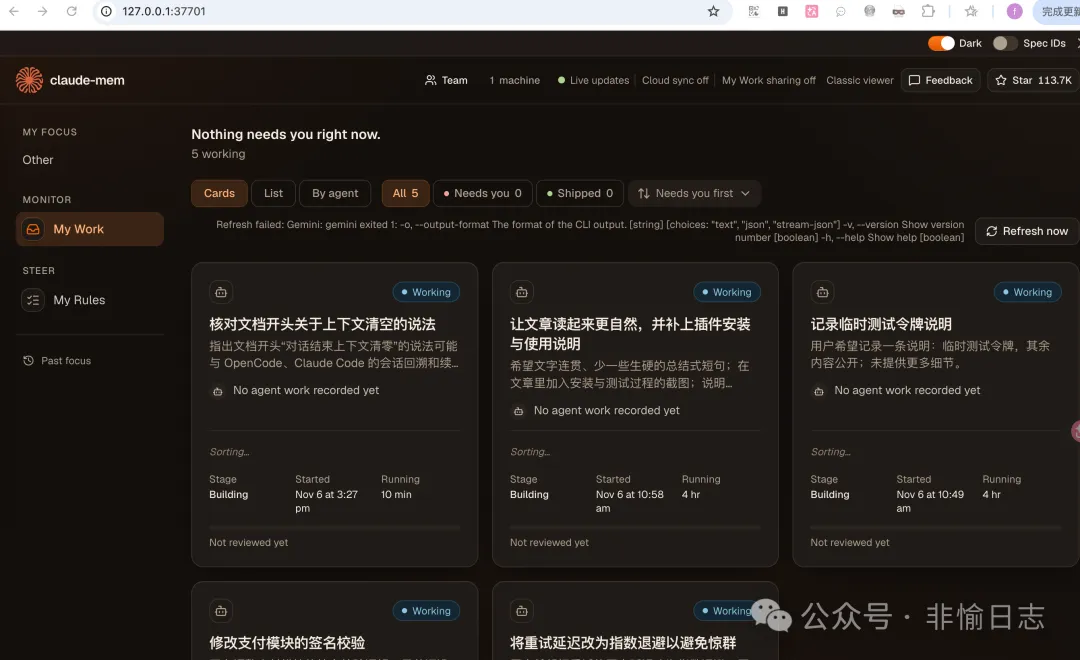
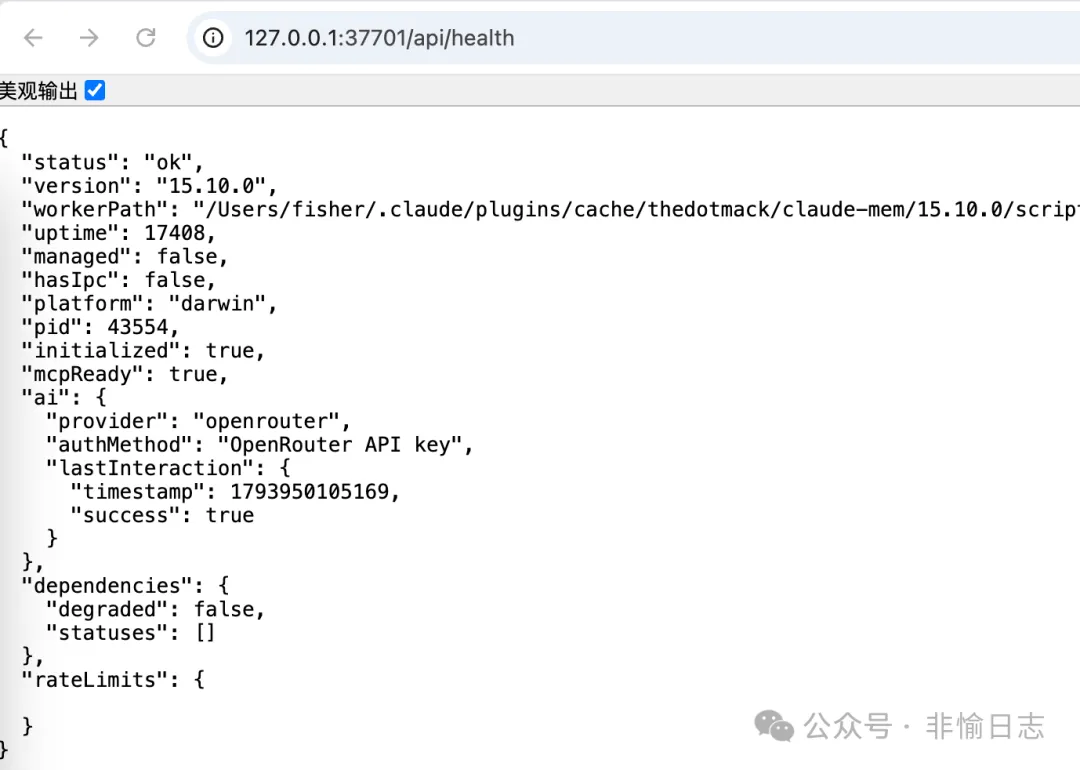
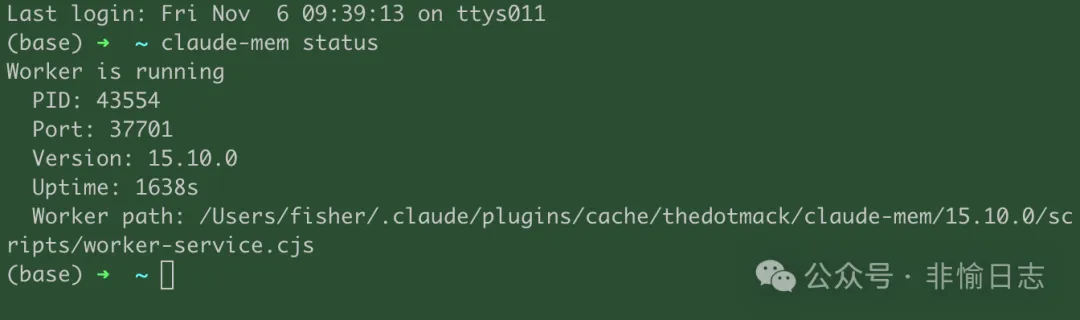
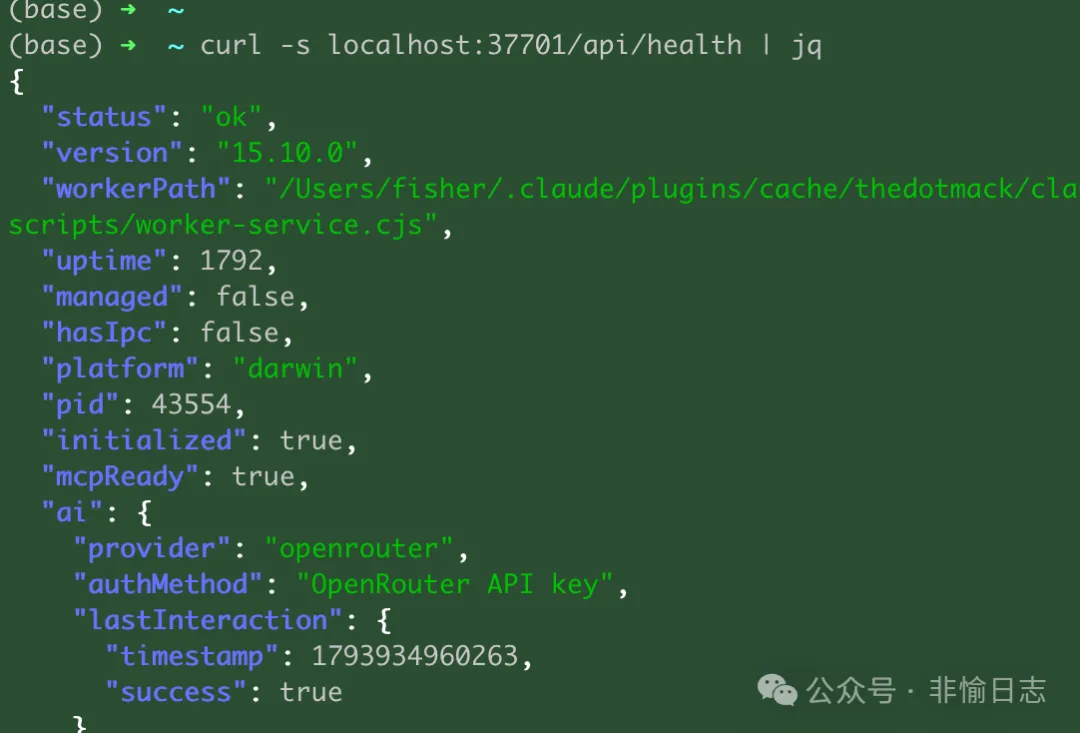
装完我确认了worker在37701端口、/api/health返回ok、OpenCode配置里注册了claude-mem的MCP。
装完之后,在OpenCode里怎么用
实际上这个安装器做了三件事:
把插件写到 ~/.config/opencode/plugins/claude-mem.js,在 ~/.config/opencode/opencode.json里注册claude-mem的MCP,再启动worker。重启OpenCode后,插件挂在会话生命周期上:
experimental.chat.system.transform/api/context/inject | ||
tool.execute.after/api/sessions/observations | ||
session.idle/api/sessions/summarize | ||
session.deleted |
日常使用不需要额外操作:正常开会话、改代码,它自己在后台记。
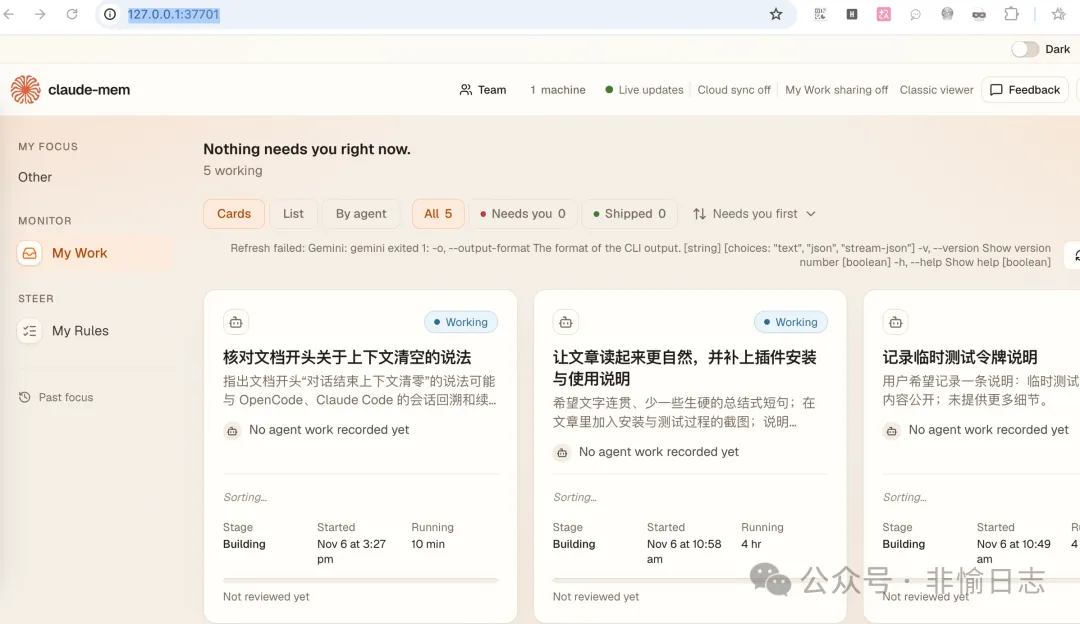
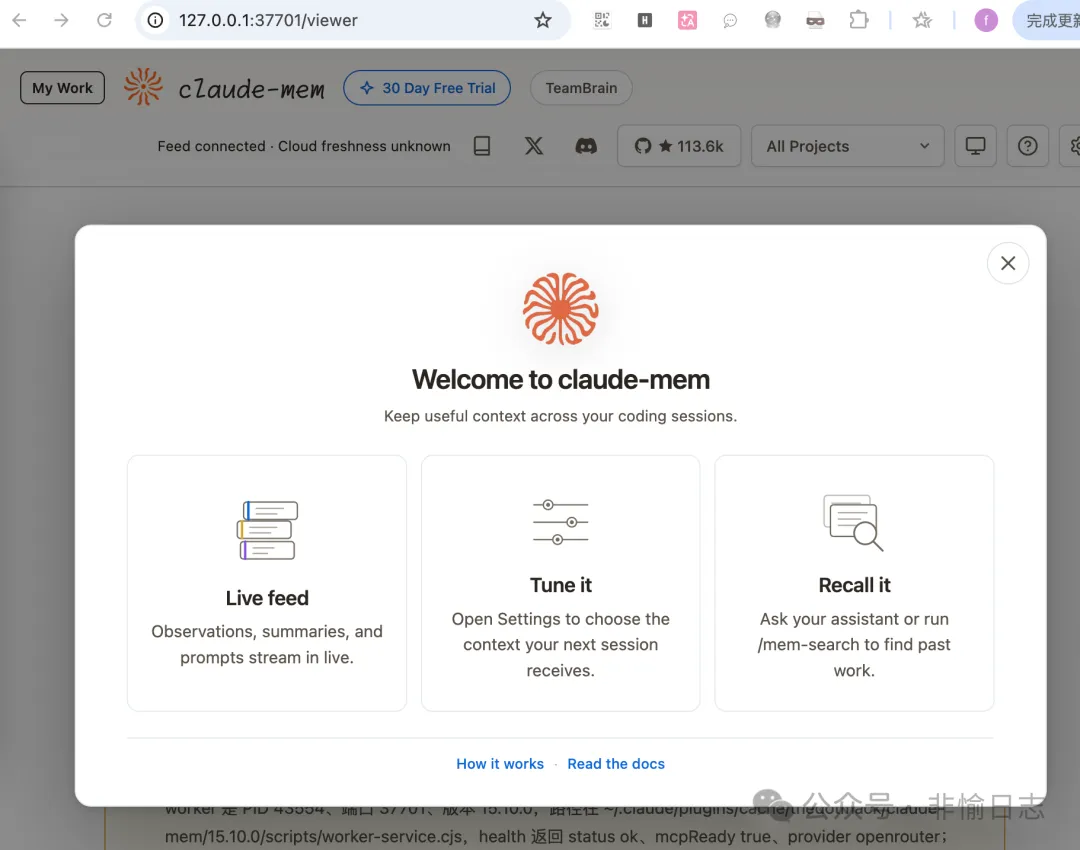
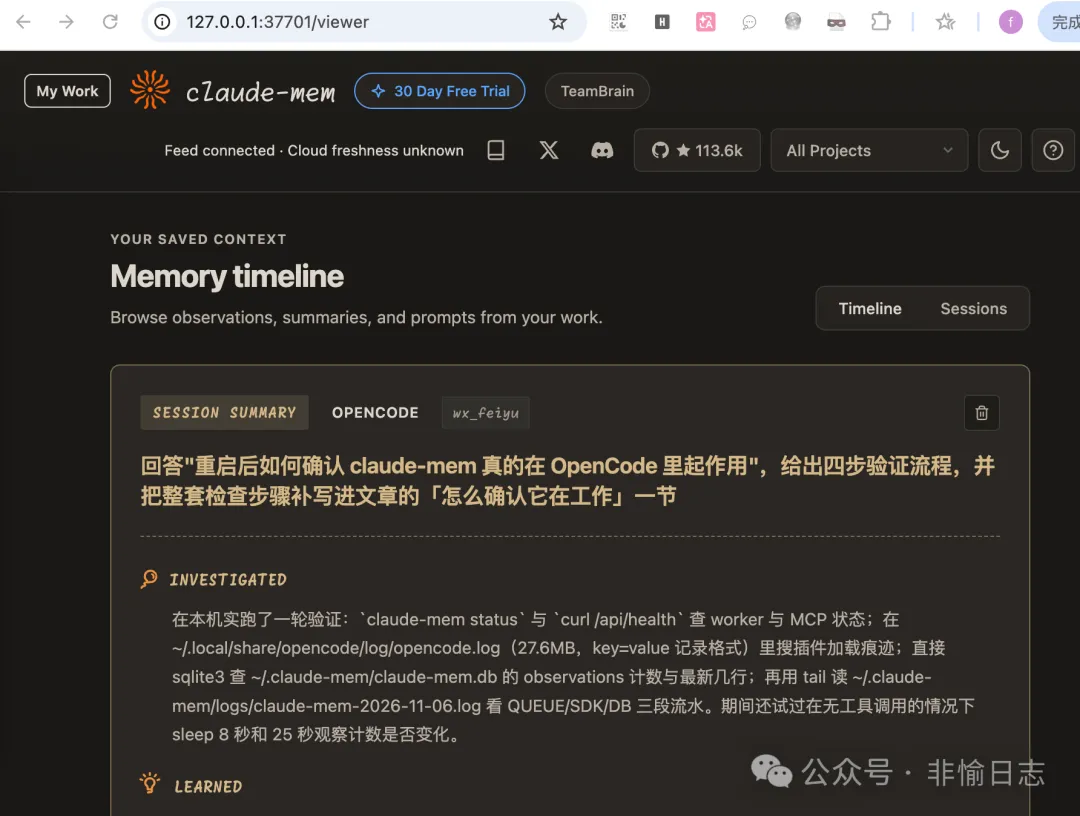
想找回以前的东西,直接在对话里问,模型会调用三个工具:先用claude_mem_search拿索引,再用claude_mem_timeline看上下文,最后用claude_mem_get_observations取详情。也可以打开http://127.0.0.1:37701/viewer自己翻。
举个具体的:新会话里问“上次retry为什么改成指数退避”,模型会先搜retry,拿到观察#9和会话摘要S1,再回答文件、原因和上限。这个过程不需要你记住ID,工具会自己串起来。
怎么确认claude-mem它在工作?
先看worker在不在:claude-mem status应该显示Worker is runningcurl -s localhost:37701/api/health应该返回"status": "ok"和"mcpReady": true。查看~/.claude-mem/logs/的最新日志。
再看插件加载没有:grep "plugin reconciliation" ~/.local/share/opencode/log/opencode.log | tail -1,能看到类似plugins=14的完成记录,说明OpenCode把插件挂上了。
然后看它有没有在记:随便跑一个命令,等二三十秒,再查sqlite3 ~/.claude-mem/claude-mem.db "select count(*) from observations;",数字应该往上走。我这边从82涨到83,延迟大约20秒,因为要等观察模型压缩完才入库。
最后看注入有没有生效:新开一个会话,问“你现在能看到claude-mem注入的上下文吗?最近一条记忆标题是什么?”,它能说出标题,就说明系统提示里已经带上了记忆。或者直接打开http://127.0.0.1:37701/viewer,选当前项目,看时间线里有没有新记录。
如果第三步不动,多半是观察模型没配好,回到上一节的provider配置检查;如果第四步没反应,确认是不是在插件加载之前就已经开着的旧会话,新开一个再试。
三、实测:召回、隔离、隐私与成本核算!
测试环境是macOS、OpenCode v2.2.5、claude-mem v15.10.0、观察模型deepseek-v4-flash,取数时间2026-11-06。
为了控制变量,我用worker的HTTP接口跑完整会话流程,和OpenCode插件调用的是同一组端点;另外建了一个独立项目做隔离和隐私测试。
先测的是跨会话召回。会话A里,我让Agent把retry.ts的固定延迟改成指数退避,上限30秒,原因是固定延迟会在服务恢复时造成惊群。会话结束时它生成了一份摘要。新会话启动时注入的内容里,五项都在:改了哪个文件、从什么改成什么、为什么改、上限多少、下一步是什么。摘要里甚至写了基数为2、1000ms起步、最大30秒。
注入到新会话的内容,节选是这样的:
Investigated:已检查src/retry.ts中的延迟计算逻辑,原实现为固定线性延迟
n*1000,在服务恢复时会导致大量客户端同时重试造成惊群问题。Learned:固定延迟的重试策略在系统恢复时会让所有等待重试的客户端在同一时刻发起请求,形成流量尖峰;指数退避可分散重试时间,且需要设置上限避免无界等待。
Completed:已将src/retry.ts的延迟公式从
return n*1000改为return Math.min(30000, 1000*Math.pow(2,n)),实现指数退避并封顶30秒。Next Steps:修改已完成,等待确认测试通过或接受后续进一步调整。
注入文本880字符,按2.5字符一个token估,约352 token。它自己给的统计是2条观察、331 token可读、5863 token的工作量、省了94%。它没有把整段对话塞回来,而是压成“查了什么、学到什么、做完什么、下一步”四段。新会话不用读历史,读这四段就能接上,这是用着最舒服的地方。
接着是项目隔离。我另建了一个项目,写入“支付签名密钥PAY_SECRET_ABC,不要外传”,再读原项目的注入内容。支付、密钥、另一个项目名,全部0命中。记忆按项目目录隔离,注入时只取当前项目,没有出现我担心的串味。
真正麻烦的是隐私。明文写进工具调用的密钥PAY_SECRET_ABC,我直接用sqlite3查了observations表,title、narrative、facts三个字段里都能搜到。测试当时整个库里有2条观察带着它:一条在测试项目里,另一条在当前工作项目里——我在终端里跑测试脚本时,输出被会话记录抓走了。两条都没有自动打码,其中一条的叙述里甚至写着“用户说这是内部密钥、不能外传”,然后照样把值记了下来。写稿时再查,当前工作项目已经涨到5条。
用<private>TOKEN_XYZ_123</private>包住的令牌,测试项目里0命中,标签生效了。但模型仍然生成了一条观察,标题是“临时测试令牌被确认为非敏感”——值没存,判断存了。后来我为了截图又在终端里打了一次这个令牌,它立刻出现在当前项目的观察里,标签管不到命令输出。
成本计算。日志里8次观察调用,输入加输出从3148到10529 token,多数在3k到4k之间。用便宜模型,一条观察的成本可以忽略;用贵模型,一天几十条观察就要算账。数据库倒是不大,测试跑到32条观察时,主库792KB,WAL 1.3MB。
四、claude-mem适合谁用?
跨天推进的项目、多人协作的仓库、经常换设备但想接着上下文干的人,适合装!它省的是每次重新解释项目的时间,一次性脚本、临时目录、跑完就删的实验不适合,注入的记忆会占上下文,项目越杂噪音越多。含生产密钥、客户数据、内部合同的仓库,在确认排除列表和<private>覆盖了所有敏感路径之前,最好别让它进数据库。
摘要的结构是插件给的,但哪些内容算结论、哪些算敏感,是观察模型在判断。“这是测试令牌所以非敏感”就是它自己下的结论,下次会话会当真。
它把“重复解释”这件事做扎实了,但模型本身会不会变聪明,不在它的范围内。这两件事经常被混在一起,前者是工程问题,后者是模型问题。
我现在的用法是只给长期项目开记忆,敏感仓库加进排除列表,每周看一眼数据库大小。
装完这一遍,至少不用在第二天新开会话时,再把“为什么改成指数退避”讲第四遍。