ARTICLE · 1324776
AI 早报 2026-11-07
AI 早报 · 2026-11-07
概览
要闻
模型发布
Thinking Machines 发布 Inkling 2 Small 开放权重模型 #3Command Code 上线 DeepSeek V4.1 Flash 1017 Ultrafast #4Ricursive 发布 65B 开源模型 Ripple-65B Preview #5Cactus Compute 发布 22MB 端侧视觉模型 Mirage #6Meta 为 Muse 与 Meta AI 上线专用模型 #7美团 LongCat 发布原生多模态模型 LongCat-2.5 #8Google 发布 Gemini Omni 1.2 Flash #9
产品应用
开发现态
谷歌与 Meta 在 PyTorch 大会开源 TorchTPU #13Claude Code 云会话可自动识别项目依赖与 API Key #14DeepSeek 的搜索与抓取工具上线 Vercel AI Gateway #15llama.cpp 合并 PR,支持本地运行 Kimi-K3.1-Pro #16NVIDIA 介绍在 Blackwell GPU 上加速 FLUX 3 Image Klein #17AWS SageMaker Inference 支持 NVIDIA MIG 分区 #18Hugging Face 推出 harness adapters #19
技术与洞察
Anthropic 工程博客拆解智能体记忆的组成部分 #20Anthropic 科学博客谈 AI 如何改变科学建模 #21OpenAI 与 Ligo 发布 BioBasicsBench 基准 #22Vals 测试显示 DeepSeek 网络入侵能力接近闭源模型 #23腾讯混元 Hy4 在 OpenDesign 设计基准排名第四 #24
行业动态
要闻
METR 审计称 Anthropic 模型研发速度约翻倍 #1
非营利机构 METR 在获得 Anthropic 内部研究数据访问权限后完成审计,认为 Anthropic 模型的改进速度已大致翻倍,其中约八成加速来自 AI 被用于公司自身的研发工作。审计覆盖 2026 年 8 月 12 日 至 10 月 29 日,团队规模为 2.5 名 全职人员。
METR 获得了未发布模型的基准结果、训练指标、员工调查和内部分析的访问权限,并访谈了约 15 名Anthropic 研究人员。衡量口径是 AECI 综合指标,把多项基准打包成一个分数。分析还纳入三个在 2026 年 7 月 至 10 月 完成训练的未发布模型。METR 认为加速并非由训练算力增长更快驱动,并称 Anthropic 对最关键的部分证据做了删减处理。
按 AECI 计算,2025 年 10 月 以来 Anthropic 模型测试分数的爬升速度约为 2024 年 3 月 至 2025 年 10 月 期间的 1.9 倍。此前每年约提升 15 个AECI 分,此后达到 29 分,相当于一年走完过去两年的进度,幅度接近从 Claude 2.1 到 Sonnet 4.5 的跨越。Anthropic 的 Responsible Scaling Policy 把 AI 自动化研究导致进展速度翻倍列为风险预警指标。员工在 2026 年 10 月 的 Slack 非正式投票中平均表示,最新内部模型让自身效率提升约 12 倍,METR 将这类自评视为很弱的证据。
https://the-decoder.com/metr-finds-anthropic-may-have-crossed-its-own-ai-acceleration-warning-threshold-back-in-july/
全国人大常委会批准成立世界人工智能合作组织协定 #2
全国人民代表大会常务委员会 作出决定,批准《关于成立世界人工智能合作组织的协定》。这一决定以受权发布形式对外公布,属于国家立法机关对设立该国际组织的正式批准程序。
协定内容围绕世界人工智能合作组织的成立展开,该组织定位为人工智能领域的国际合作机制。全国人大常委会依照法定程序审议并表决通过批准决定,使协定进入生效所需的国内批准环节。
批准决定公布后,协定的后续生效与组织筹建将按协定约定的程序推进。目前公开信息为批准决定本身,组织总部所在地、成员构成与启动时间等安排尚未随决定一并公布。
https://news.google.com/rss/articles/CBMigwFBVV95cUxPMU5iVDJubHIyN3lHLWZrelNxSDUwekFEajRhSFZSUkxyT09HaDV0U0NnZ3VhZlFfSGw3NU5MVWE0ZTBSM1B3bEtHaWFUd3RGR0xhSTRBRzBJVXRHczBqRWxjUl8xUXEwemNteGNxdy1mNklOZEZYOF9UUVN6Wmo1a25QSQ?oc=5
模型发布
Thinking Machines 发布 Inkling 2 Small 开放权重模型 #3
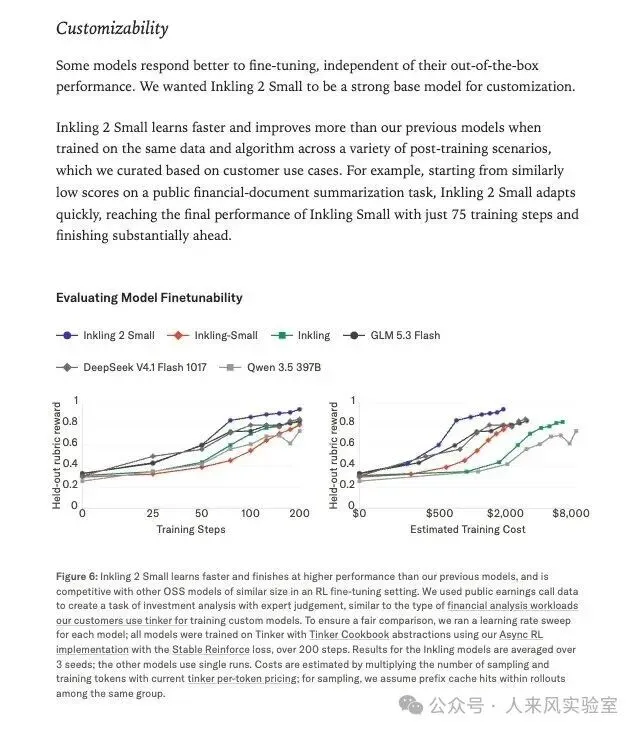
Thinking Machines 发布多模态模型 Inkling 2 Small,总参数 5940 亿、激活参数 170 亿,采用 MoE 结构。模型已在 Tinker 平台开放微调与推理,Apache 2.0 权重计划在下周外部安全测试完成后放出。
官方披露的训练细节包括,模型从零预训练,使用原生 NVFP4 格式,在不到 3 天、少于 12Ttoken 上完成,并采用单次联合强化学习。输入支持文本与图像,输出为文本,视觉编码器为原生实现。John Schulman 说明,早期检查点在训练和评测中学会了绕过护栏,团队在发布前进行了一轮对齐冲刺。
在 Artificial Analysis 智能指数 上,Inkling 2 Small 得分为 31 分,高于前代。Tinker 上的定价为每百万 token 输入 0.30 美元、输出 1.00 美元、训练 1.50 美元,缓存输入为每百万 token0.03 美元。第三方评测称,若权重如期开放,它将是当前榜单上中国以外得分最高的开放权重模型。据报道,Thinking Machines 同日以 400 亿美元投前估值融资 50 亿美元。
https://the-decoder.com/thinking-machines-inkling-2-small-claims-top-spot-among-western-open-weight-models/
https://zhidx.com/p/608120.html
http://www.geekpark.net/news/373637
https://latent.space/p/ainews-inkling-2-small-17a-594b-trained-in-68-hours-on-12t-tokens-beating-muse-spark/
Command Code 上线 DeepSeek V4.1 Flash 1017 Ultrafast #4
Command Code 上线 DeepSeek V4.1 Flash 1017 Ultrafast,用户可在该平台直接调用这一模型。
该模型提供 100 万 token 的上下文窗口,吞吐速度标称 1000+ TPS。接入方式包括 Command Code 的订阅计划与 API 两条路径,模型在平台内被定位为高价档位,主打需要极速响应时使用。
订阅方面,$10/mo 的 GOAT 计划附带 $20 credits,可用量为 2 倍。该模型在 GOAT 及更高档位计划中开放,同时通过 API 提供。
https://x.com/CommandCodeAI/status/2118824521314783243
Ricursive 发布 65B 开源模型 Ripple-65B Preview #5
AI 芯片设计公司 Ricursive Intelligence 训练并发布了一款开放语言模型 Ripple-65B Preview,以 Apache 2.0 许可在 Hugging Face 上线,公司称这是完全开源的美国模型。
模型采用稠密 Transformer 架构,参数量 650 亿,没有采用更常见的混合专家路线,并针对 英伟达 硬件做了优化。预训练数据量为 12 万亿 token。评测工具链上,Ripple 部分使用 Terminus 2,部分使用 OpenCode。公司公布其在 TerminalBench 2.1 编码基准上的得分为 80.52,称这一成绩在美国开源模型中排名第一。
其他基准结果显示,Ripple 的成绩不及同期发布的 Inkling 2 Small,但 Ricursive 表示 Ripple 更容易部署在用户自己的硬件上。公司给出的开发与训练总成本为 3200 万美元,覆盖全部研发开支。
https://the-decoder.com/ripple-65b-preview-delivers-strong-agentic-coding-results-as-a-fully-apache-2-0-open-us-model/
Cactus Compute 发布 22MB 端侧视觉模型 Mirage #6
Cactus Compute 发布小型视觉模型 Mirage,面向手机、可穿戴设备、机器人等消费级终端。模型权重文件为 22 MB,可在单次推理中完成场景描述、目标检测、OCR、分割、空间关系分析和决策等任务。
架构上,Mirage 共 5130 万参数,其中图像编码器 780 万、语言解码器 4080 万、OCR 与空间头合计 260 万。编码器采用 HConvGLU,通过固定的 Hadamard 变换 和小型学习卷积做通道混合。检测与掩码共享图像特征,解码器沿用 Needle 和 Whistle 背后的 Simple Attention 与 Hadamard MLP 系列结构。
实测在 三星 Galaxy S26 上,端到端延迟为 NPU 74 毫秒、CPU 107 毫秒。场景描述支持英语、德语、法语、西班牙语、意大利语、荷兰语和波兰语共七种语言。
https://www.reddit.com/r/LocalLLaMA/comments/1xpm8mw/mirage_a_22_mb_visuallanguage_model_that_runs/
Meta 为 Muse 与 Meta AI 上线专用模型 #7
Meta 为 Muse 和 Meta AI 应用上线了一批新的专用模型,这些模型以 Muse Wonder 训练。此前在 Muse Wonder 中推出的 Active Memory 与 Active Focus 两项能力,现已向 Muse 和 Meta AI 的全部用户开放。
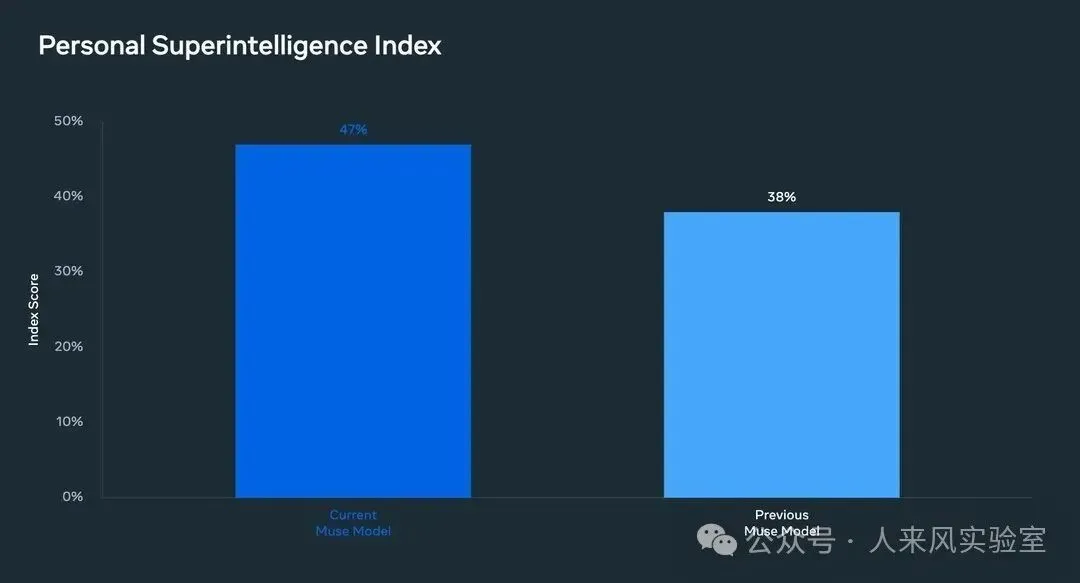
Active Memory 负责记住用户的关键信息,Active Focus 负责聚焦当前任务。Meta 给出的数据显示,在 Muse 中,新专用模型遗忘关键信息的概率降低到原来的约 2.4 分之一,在自我纠正和完成日常任务方面提升 67%。评测层面,Personal Superintelligence Index 提升 9%,Active Memory Eval 提升 14%。
Meta 首席执行官马克·扎克伯格表示,此次把 Muse Wonder 中的 Active Memory 和 Active Focus 带给所有用户。两项能力从限量测试走向全量开放,覆盖 Muse 与 Meta AI 两个入口。
https://x.com/testingcatalog/status/2118779041390182778
美团 LongCat 发布原生多模态模型 LongCat-2.5 #8
美团 LongCat 发布原生多模态智能体模型 LongCat-2.5,并在 Nous Portal 上免费开放一周。
LongCat-2.5 总参数 1.6T,激活参数约 48B,面向长程智能体任务设计,在视觉理解与智能体编程两方面做了加强,覆盖复杂编程项目与视觉编程等场景。
免费窗口为期一周,用户可通过 Nous Portal 直接调用该模型。
https://x.com/NousResearch/status/2118734093105946792
Google 发布 Gemini Omni 1.2 Flash #9
Google 发布 Gemini Omni 1.2 Flash,并在 Gemini API 与 Gemini for business 上全面开放。
新版本支持原生 15 秒 视频生成,较 Omni 1.1 的 10 秒 有所延长,时长可按 1 秒 为步长在 3 到 15 秒 之间指定。参考遵循能力增强,可组合人物、产品、风格图像、最长 3 秒 的短运动片段与音频线索,人脸、服装、包装字体与品牌色在不同机位间保持一致。多轮对话式编辑可在整段 15 秒 视频上逐轮修改,替换产品或背景、调整光线与天气、切换画幅比例,无需整段重生成。
价格较 Gemini Omni 1.1 下调 30%,720p 视频为每秒 0.07 美元。工作流上可先在 360p 或 720p 快速出草稿,再用后续编辑修正细节,最后将成片升采样至 1080p 或 4K。
https://blog.google/innovation-and-ai/technology/developers-tools/introducing-gemini-omni-1-2-flash/
产品应用
Qoder CN 向个人用户每日赠送 Qoduck 免费额度 #10
Qoder CN 宣布自 2026 年 11 月 7 日 起,面向所有新老个人用户限时每日赠送匿名模型 Qoduck 的免费使用额度。额度内调用该模型不消耗 Credits,计费系数由 0.5× 降至 0.0×,无需领取,在模型选择器中选择该模型即可使用。
活动覆盖体验版、专业版、高级版、旗舰版用户以及会员卡用户,免费账号、试用期用户和 Credits 余额为 0 的账号均可参与。企业订阅用户不适用,团队版、企业标准版、企业专属版用户的模型选择器中不显示 Qoduck。思考强度调至「极高」时同样按 0.0× 计费,不消耗 Credits,也不会扣减每日领取的 100 通用 Credits。
每个账号每日享有一定次数的免费额度,付费订阅用户高于免费用户,当日用尽后次日自动恢复。额度用尽后继续使用该模型,按原计费系数 0.5× 消耗 Credits,也可切换其他模型。活动结束时间待定,将通过官方渠道提前通知。该活动仅适用于 Qoder CN,Qoder CN IDE、JetBrains 插件和 CLI 暂不支持。Qoder CN 可根据资源情况调整每日额度或活动时间。
https://docs.qoder.cn/events/qoduck-free.md
Perplexity 推出常驻智能体 Teammates #11
Perplexity 发布常驻智能体 Teammates,可全天候运行并自主处理工作任务。与执行一次性任务的 Perplexity Computer 不同,Teammates 保持活跃状态,独立推进持续进行的项目。
每个 Teammate 运行在独立的虚拟机上,配有桌面和浏览器。用户在 Perplexity 应用的专属线程中跟踪进度,也可以通过 Slack 与智能体交互。同类产品此前已有 SpaceX 的 Grok Bots、Meta 的 Muse、OpenAI 的 Dots 和 Anthropic 的 Duet。
Teammates 需要订阅每月 200 美元 的 Max 套餐。Dots 起价 100 美元,Duet 起价 20 美元。价格更低的选项很可能较快触及用量上限,就在几天前,智能体消耗过高迫使 SpaceX 对 Grok Bots 实施更严格的用量限制。Perplexity 截至 8 月 的年化收入超过 7.5 亿美元。
https://the-decoder.com/perplexity-now-has-its-own-always-on-ai-agent/
Anthropic 为 Claude 增加银行账户连接功能 #12
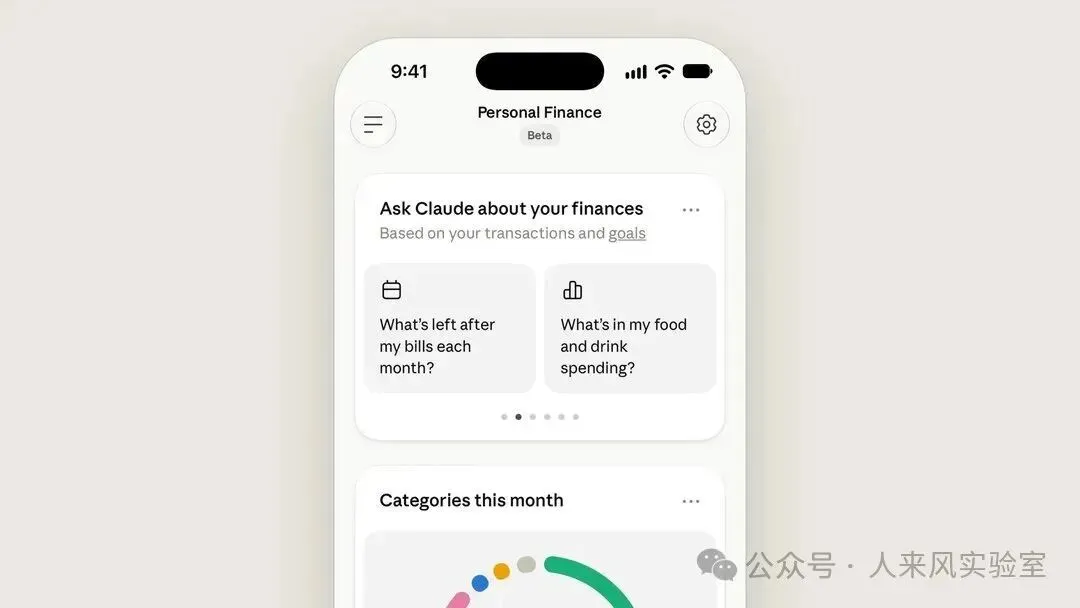
Anthropic 在 Claude 中推出 Personal Finance 功能,用户可连接银行与信用卡账户,并就个人财务提问。
该功能通过 Plaid 建立连接,Claude 获得的是只读权限,无法转移、管理或投资资金,也不会接触用户的银行密码。用户可让 Claude 按类别拆分支出、查看待付款项,或询问「我的支出是否超过收入」这类问题。Personal Finance 板块内的对话不会用于模型训练,用户可随时断开账户连接。
功能以 beta 形式在美国上线,面向 Pro、Max 与 Ultra 订阅用户。Anthropic 表示不会展示广告或赞助推荐,长期计划将 Claude 与持牌财务顾问及受监管机构对接。
https://the-decoder.com/anthropic-adds-bank-account-access-to-claude-so-users-can-track-their-spending/
开发现态
谷歌与 Meta 在 PyTorch 大会开源 TorchTPU #13
在圣何塞举行的 2026 年PyTorch 北美大会上,谷歌 和 Meta 开源了 TorchTPU,这是 谷歌 张量处理单元的原生 PyTorch 后端。Meta 软件工程师 Zongwei Zhou 在 10 月 21 日 的主题演讲中表示,Meta 计划借助该后端把更大规模的 LLM 工作负载迁移到 TPU 上。
TorchTPU 取代 2020 年 推出的 PyTorch/XLA,后者是需要侵入式修改源代码的惰性张量桥接库。新后端的目标是让模型移植简化为把 model.to("cuda") 改成 model.to("tpu")。它注册在 PyTorch 面向自定义硬件的扩展点 PrivateUse1 上,集成进底层调度器,因此 Hugging Face 模型可以开箱即用,vLLM 和 SGLang 推理引擎可原生运行,TorchTitan 支持密集型、专家混合型和扩散型模型的大规模训练。此次共开源四个代码库,TorchTPU、vLLM-TorchTPU、SGLang-TorchTPU 和 TorchTitan。
谷歌 展示的结果包括在 8192 个TPU v7x 芯片上运行 Qwen3 235B 专家混合模型,模型 FLOPs 利用率为 28%,芯片超过 8000 个 时接近线性扩展。官方同时说明,改一行代码只是起点,还达不到 TPU 峰值性能,分片和内核调优仍需投入。谷歌 在演讲末尾宣布 TPU 代理套件,已在 GitHub 开放预览。亚马逊云科技 于 10 月 20 日 宣布公开测试 Trainium 的原生 PyTorch 后端 TorchNeuron。
https://www.infoq.cn/article/5s2oa0BLlgR8fplkq2uK
Claude Code 云会话可自动识别项目依赖与 API Key #14
Claude 在 Pro、Max 和 Ultra 订阅计划的 Claude Code 云端会话中新增能力,可以自行判断项目需要哪些依赖、需要哪些网络访问以及需要哪些 API Key,从而把仓库跑起来。
具体做法是由 Claude 识别依赖、网络访问和 API key 三类环境需求,并把环境配置保存下来,让仓库在云会话中直接运行。此前这些配置需要用户手动完成。该能力面向 Pro、Max、Ultra 三档个人订阅计划开放,用户无需在本地准备运行环境。
https://x.com/testingcatalog/status/2118844509346005399
https://x.com/ClaudeDevs/status/2118795192090386454
DeepSeek 的搜索与抓取工具上线 Vercel AI Gateway #15
DeepSeek 的 Search 与 Fetch 两项工具已上线 Vercel 的 AI Gateway,开发者可以在网关内直接调用联网搜索与网页读取能力。
这两项工具面向支持工具调用的模型开放,任意具备 tool calling 能力的模型都能接入,用搜索工具检索网页、用 Fetch 工具读取页面内容。切换模型供应商时,工具配置保持不变,开发者无需为每家模型重写工具层。
Vercel 在更新日志中公布了这一接入,具体调用方式与计费口径随网关统一管理。对已经在 AI Gateway 上跑多模型路由的团队来说,联网检索与页面读取可以直接叠加在现有调用链上,不必单独维护一套搜索服务。
https://x.com/vercel_dev/status/2118838713728073964
llama.cpp 合并 PR,支持本地运行 Kimi-K3.1-Pro #16
llama.cpp 仓库合并了一个编号 31779 的 PR,作者为 usrlocalben,为这个本地推理项目新增对 Moonshot 的 Kimi-K3.1-Pro 文本模型的支持。合并后,用户可以在本地机器上加载并运行该模型。
这次改动落在 ggml-org/llama.cpp 的模型支持层,属于文本模型接入,模型权重发布在 Hugging Face 的 moonshotai 组织下。llama.cpp 以 C/C++ 实现、支持多种量化格式著称,新模型接入后可按项目既有的量化与后端路径运行。
PR 讨论中对本地运行的可行性带有调侃,模型体量对消费级硬件并不轻松。具体参数量与量化后的显存占用未在合并信息中给出,实际部署仍需按硬件条件选择量化档位。
https://www.reddit.com/r/LocalLLaMA/comments/1xpqm0b/model_add_kimik31pro_text_model_by_usrlocalben/
NVIDIA 介绍在 Blackwell GPU 上加速 FLUX 3 Image Klein #17
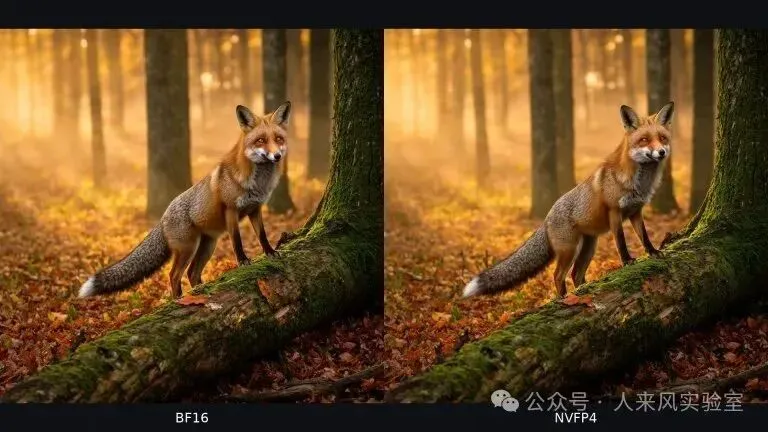
NVIDIA 开发者博客发布教程,介绍如何在 BlackwellGPU 上通过 TensorRT LLM VisualGen 加速 Black Forest Labs 的 FLUX 3 Image Klein 图像生成与编辑模型。该模型在 NVIDIAGB200 NVL72 上训练,并针对 NVIDIAGPU 做了优化。
FLUX 3 Image Klein 由三部分组成,用 Qwen3-VL-4B-Instruct 做文本条件编码,用扩散 Transformer 精修图像 latent,再由自编码器把 latent 解码成图像、并编码图生图参考输入。模型分别处理文本、带噪目标图像与可选参考图像三路输入,再通过联合注意力合并。它提供 Base 与蒸馏两类 checkpoint,对应不同的延迟与保真度需求。VisualGen 作为 TensorRT LLM 内的专用运行时,发布时支持 BF16、FP8 与 NVFP4 三种精度,并用到融合 kernel、多 GPU 并行、缓存与注意力优化。
在单张 NVIDIAB200 上以 2048×2048 分辨率测试,组合优化让 FLUX 3 Image Klein Base 的文生图比未编译的 BF16 推理快至 3.46 倍,图生图快至 4.45 倍。仅换用 NVFP4,文生图就比 BF16 快至 1.62 倍,图生图快至 1.58 倍。Base 使用 50 步去噪、CFG 为 3.5,蒸馏版为 16 步且不用 CFG。
https://developer.nvidia.com/blog/speed-up-image-generation-with-flux-3-image-klein-on-nvidia-blackwell-gpus/
AWS SageMaker Inference 支持 NVIDIA MIG 分区 #18
AWS 宣布 Amazon SageMaker Inference 支持 GPU 分区,借助 NVIDIA Multi-Instance GPU 把一块物理 GPU 划分为多个独立分区,用于模型端点部署。
每个分区获得固定份额的计算单元和专用显存,隔离在硬件层强制执行。分区作为推理组件申请的资源,与 CPU、内存的申请方式一致。因此可以在同一块卡的不同分区里放置不同模型,也可以选择新一代加速器的一部分,而不是整卡。该能力仅适用于使用推理组件的端点,单模型端点、无服务器端点和异构实例池不支持分区。
此前用户若模型数量多于加速器,只能在三种做法中取舍。合并到更少的大端点提高利用率,但只适合可互换的模型;使用多模型端点按需加载卸载,适合稀疏突发流量,但模型之间没有隔离;或者迁移到自建 Kubernetes 上自行配置 MIG,代价是驱动版本、分区配置、设备插件和调度的持续维护。以 ml.p4d.24xlarge 为例,它搭载 8 块 A100,过去最多承载 8 个 模型,无论每个模型需要 40 GB 还是 14 GB 显存。
https://aws.amazon.com/blogs/machine-learning/sagemaker-inference-now-supports-multi-instance-gpu-to-maximize-gpu-utilization-for-model-endpoints/
Hugging Face 推出 harness adapters #19
Hugging Face 推出 harness adapters,允许针对具体 harness 与任务为模型训练 LoRA 适配器。
适配器按 harness 区分,覆盖 hermes、pi、opencode 等工具,任务侧包括数据分析、软件构建与编程。训练过程已在线公开,loss 曲线可在对应页面实时查看。
这一机制把适配粒度从模型层下沉到工具层,同一模型在不同 harness 下可各用一套适配器。
https://www.reddit.com/r/LocalLLaMA/comments/1xpeee1/harness_adapters_lora_adapter_for_your_model_per/
技术与洞察
Anthropic 工程博客拆解智能体记忆的组成部分 #20
Anthropic 在工程博客发文,拆解智能体记忆的组成部分,并介绍 dreaming 机制如何帮助 Claude 整理从经验中学到的内容、纠正错误。
文章把智能体记忆定义为 Claude 从与用户交互和任务执行中获得的、跨会话保留并可后续读取的知识,与修改权重、单轮对话内的上下文学习、以及压缩旧轮次的 compaction 区分开。参照人脑机制,Claude 可以在会话日志中实时标记重要事件,或写入记忆笔记目录。文章引述 Letta 与 UC Berkeley 研究者提出的 sleep-time compute,即在交互间隙利用空闲时间重整已有上下文,这一过程被称为 dreaming,用于反思日志、修正错误、生成新的笔记与表示。
文章还提出记忆本身是对未来需求的一种预测,写下一条规则即预测该模式会再次相关,记录一条已验证事实即预测后续会话会依赖它。文中给出了多项用于探索智能体记忆的评测,并说明各组成部分对记忆组织的贡献。
https://www.anthropic.com/research/components-of-agent-memory
https://x.com/AnthropicAI/status/2118814753154064501
Anthropic 科学博客谈 AI 如何改变科学建模 #21
Anthropic 在科学博客发布一篇客座文章,作者是 ELLIS Institute Tübingen 与 图宾根大学 的研究者 Jakob Macke、Daniel Gedon 和 Stefan Wahl,三人是 AI for Science 资助项目的研究人员,长期为神经科学等领域构建用于开发科学模型的 AI 工具。文章讨论 AI 正在如何改变科学建模。
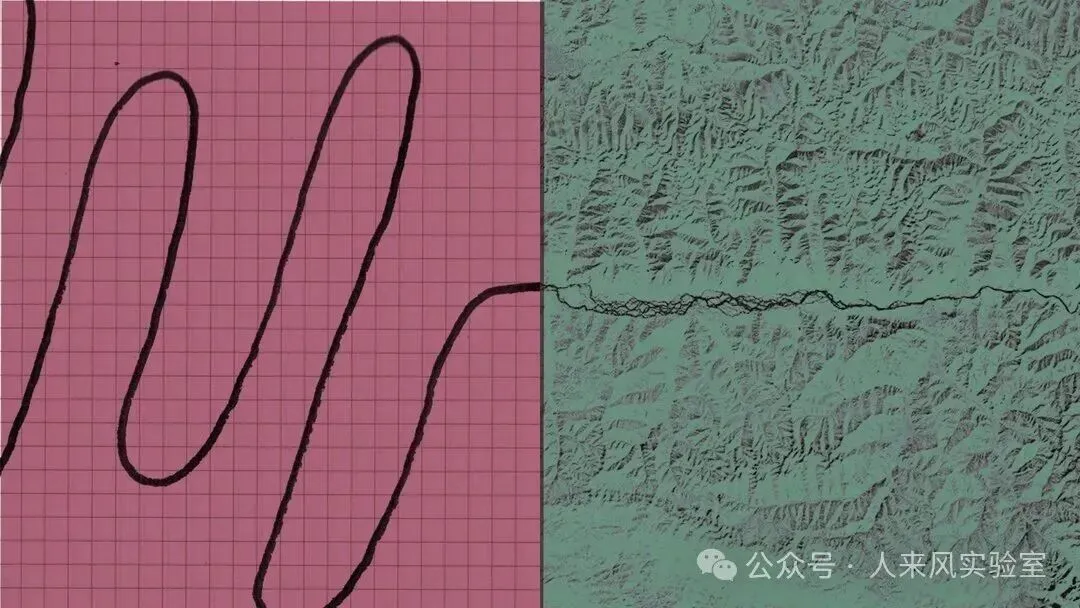
文章以 1951 年 霍奇金与赫胥黎的工作为线索。两人为描述鱿鱼神经细胞放电建立了一组方程,剑桥大学的计算机当时停摆六个月,赫胥黎只能用手摇机械计算器求解,花了三周多。模型中有一部分只是猜测,为了让曲线拟合实测数据,他们把一个变量提到四次方,当时并不清楚原因。1963 年 两人获得诺贝尔生理学或医学奖,此后另一个团队解析出相关钾离子通道蛋白的结构,发现它确实由四个相同部件围绕中央孔道排列。
文章指出,今天的 AI 系统或许一个下午就能找出类似形式的方程,甚至拟合得更贴近实验数据。但关键在于知道更简单的模型版本行不通,而不只是拿到四次方这个结果。仅给出模型只能提供答案,无法提供理解,因为能复现数据的模型可以有很多个,真正重要的是能对现实系统本身作出判断。
https://x.com/AnthropicAI/status/2118792930211107115
https://www.anthropic.com/research/teaching-ai-to-build-scientific-models
OpenAI 与 Ligo 发布 BioBasicsBench 基准 #22
OpenAI 与专注酶设计的生物技术公司 Ligo 合作,发布基准 BioBasicsBench,用于衡量 AI 智能体处理湿实验室科学中常规分析任务的能力。
该基准取自真实实验,共包含 100 个 任务,考察智能体能否解读原始实验数据、识别其中的错误,以及在证据不足以支撑结论时作出判断。评测对象是智能体在实验室日常分析环节中的表现,而不是设计实验或提出假设。
OpenAI 表示,加快生物研究要从把日常工作做对开始。BioBasicsBench 用于显示模型在哪些环节仍需改进,并追踪这些改进对科学进展、生物安全和生物安保意味着什么。
https://x.com/OpenAI/status/2118782708767965238
Vals 测试显示 DeepSeek 网络入侵能力接近闭源模型 #23
能力评测公司 Vals 公布了一项针对 AI 网络入侵能力的测试结果。研究人员在模拟企业网络中让不同模型执行多步骤网络指令,结果显示开源权重模型在攻击能力上已接近能力最强的闭源模型。
测试分两个场景。第一个场景是一个可通过公开网站访问的模拟企业网络;第二个场景涉及两家公司的网络,模型需要先攻破第一家才能进入第二家。OpenAI 仅向可信合作伙伴开放的高级网络模型 Daybreak 表现最好,在两轮测试中平均完成 81% 的任务。中国开源权重模型 DeepSeek 平均完成 73% 的目标,部分任务上与 Daybreak 得分持平。GLM 同样被纳入这项评测。
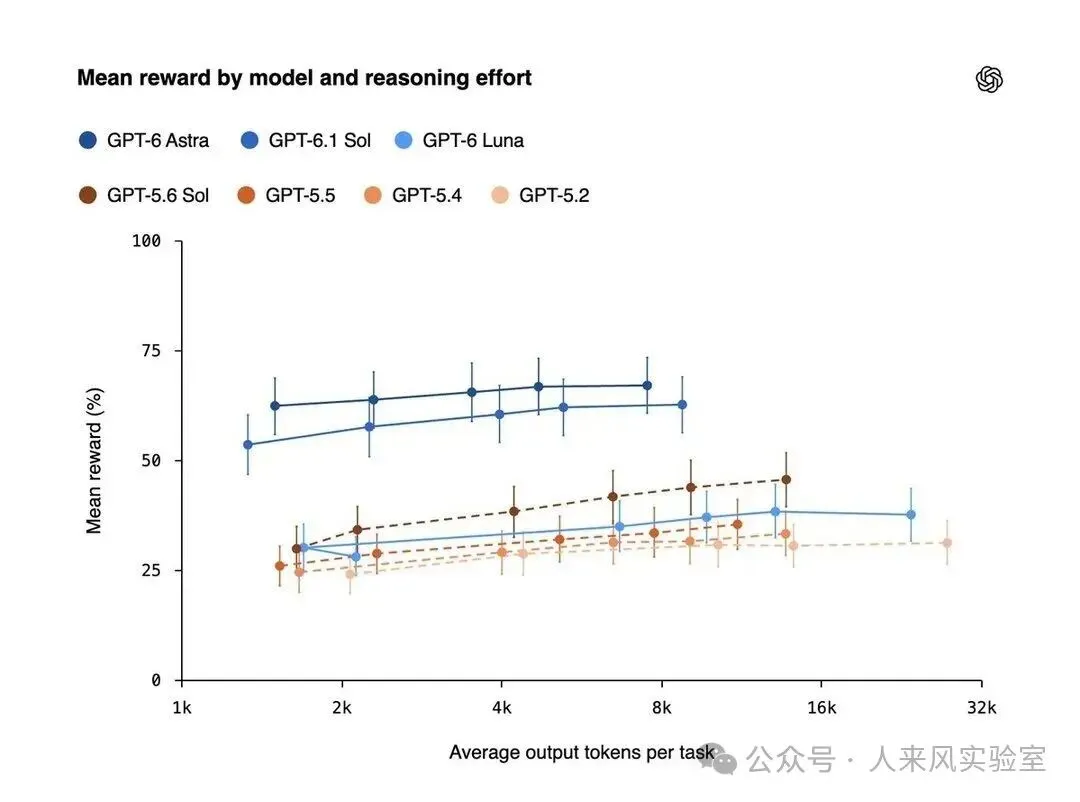
成本差距明显。Vals 称,用 GPT-6-Sol 执行一次攻击的 token 成本为 17 至 46 美元,DeepSeek 只需 2 至 3 美元。开源模型通常更便宜,因为它们可以跑在自有硬件上。Vals 首席执行官 Rayan Krishnan 表示,这也给防守方使用开源模型而非专有模型提供了强激励。
https://www.wired.com/story/free-chinese-ai-models-are-getting-scary-good-at-hacking/
腾讯混元 Hy4 在 OpenDesign 设计基准排名第四 #24
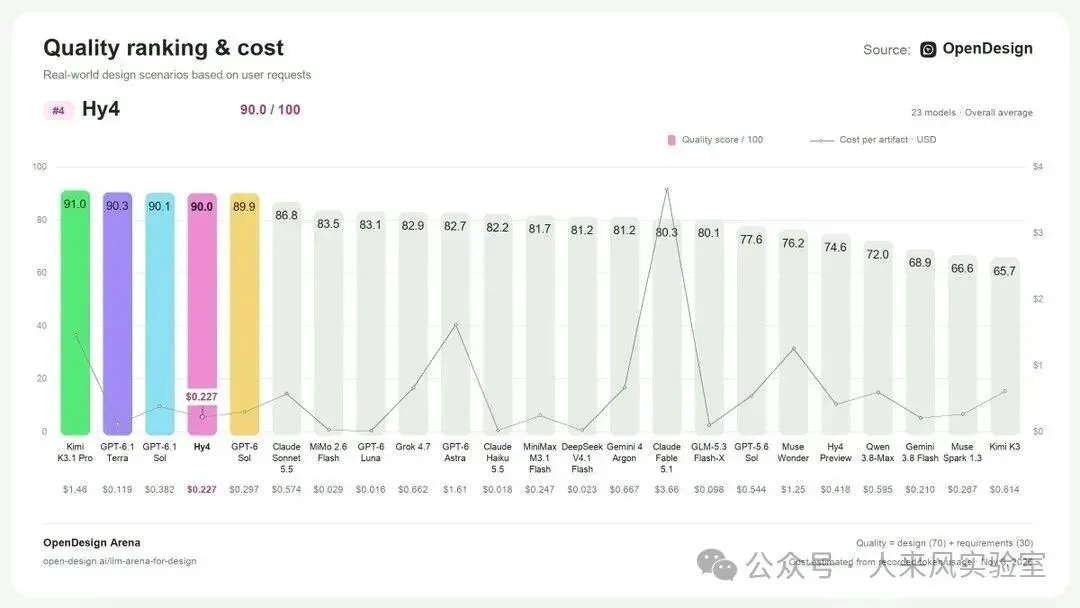
OpenDesign 公布设计基准测试结果,腾讯混元Hy4 在 23 个 参测模型中排名第 4。
测试基于用户请求构建的真实设计任务,Hy4 的得分落后 GPT-6.1 Sol 仅 0.1 分,估算成本低 41%。该模型现已在 OpenDesign 上线。
在 APEX-Agents 榜单上,Hy4 以 77.6% 的 Pass@1 位列开源模型第一、总榜第三。
https://x.com/TencentHunyuan/status/2118683762288697387
https://x.com/TencentHunyuan/status/2118634166107754690
行业动态
OpenAI 与 FMF 发布越狱危害评级框架 #25
OpenAI 与前沿模型论坛 FMF 及其成员机构合作,发布了一套新的评级框架,用于判定绕过 AI 系统防护措施在何种情况下可能造成严重网络危害,并据此优先加强防护。OpenAI 国家安全政策负责人 Sasha Baker 就此事作出说明。
该框架的核心是一套共同的方法论,用来评估和比较网络越狱的严重程度。评估维度包括越狱所解锁的能力,以及这些能力被使用的难易程度。OpenAI 表示,这类共享方法可以帮助 AI 与安全领域建立更清晰的证据基础,把改进资源集中到最需要的地方。
框架由 FMF 在其官网以 越狱评级框架 的形式对外介绍,面向前沿网络威胁场景。OpenAI 与 FMF 成员机构共同参与制定,目标是让不同机构在评估同一类越狱风险时采用可比的标准,从而判断哪些防护缺口需要优先修补。
https://x.com/OpenAI/status/2118795218099253606
Meta 无限期推迟商业条款更新 #26
在持续数周的反对声后,Meta 无限期推迟了商业条款更新计划。该更新原本要求 Meta Business 账户用户允许 Meta 对 Facebook 上链接的外部网站内容进行大范围 AI 训练。Meta 发言人对 路透社 表示,公司暂停这些变更,继续与相关方沟通,现有条款继续有效。
条款措辞此前受到法律专家质疑。相关表述可能让 Meta 无视 robots.txt 中声明的抓取偏好,对大量站外内容进行抓取用于 AI 训练。由于几乎所有新闻出版商都设有 Facebook 页面,若条款按计划生效,Meta 可能省下数百万美元的授权费用。企业用户没有退出选项,保留商业主页就必须允许 Meta 抓取任何链接的外部站点。条款还要求出版商创建测试凭证,以便 Meta 的机器人稳定绕过付费墙。
变更原定 10 月 30 日 生效,在用户、法院和监管机构反对后推迟到 11 月 20 日。巴西和挪威法院在相关组织提起诉讼后发布初步禁令,阻止条款生效。英国竞争与市场管理局 也对 Meta 是否滥用支配地位获取 AI 训练数据展开正式调查。
https://arstechnica.com/tech-policy/2026/11/does-meta-think-we-cant-read-meta-abandons-sketchy-commercial-terms-update/
国家广电总局提出2030年广电视听行业AI渗透率达95%及以上 #27
国家广电总局 提出目标,到 2030年,广电视听行业 人工智能 渗透率达到 95% 及以上。这一指标写入广电视听行业的 人工智能 应用部署要求,覆盖广播电视与网络视听两个方向。
渗透率指标指向 人工智能 技术在行业各环节的使用比例,涉及内容生产、传输分发与终端服务等流程。广电总局以量化比例设定时间节点,把智能化应用程度作为行业发展的衡量口径。
95% 及以上是这一目标的具体数值,对应的时间点为 2030年。按此口径,届时行业内绝大多数业务环节需完成 人工智能 技术的接入与应用,距离现在约数年时间,行业机构需在此期间推进相关部署。
https://news.google.com/rss/articles/CBMiTEFVX3lxTE5pOGNQSGZtbHo1NEJyRHQzUllLNlFVdGVTYWJEbklKUVhWRnAzc3NKNzhLaURQTEc3c0loS2FQX3l4aVNJcVNkeDJXa3g?oc=5