ARTICLE · 1324887
你让 AI 记住的东西,可能正在拖累它:Anthropic 工程团队拆开智能体记忆的 5 种「做梦」
这篇在回答一个问题:给 AI 加上记忆,让它记得越多,它就会越好用吗?
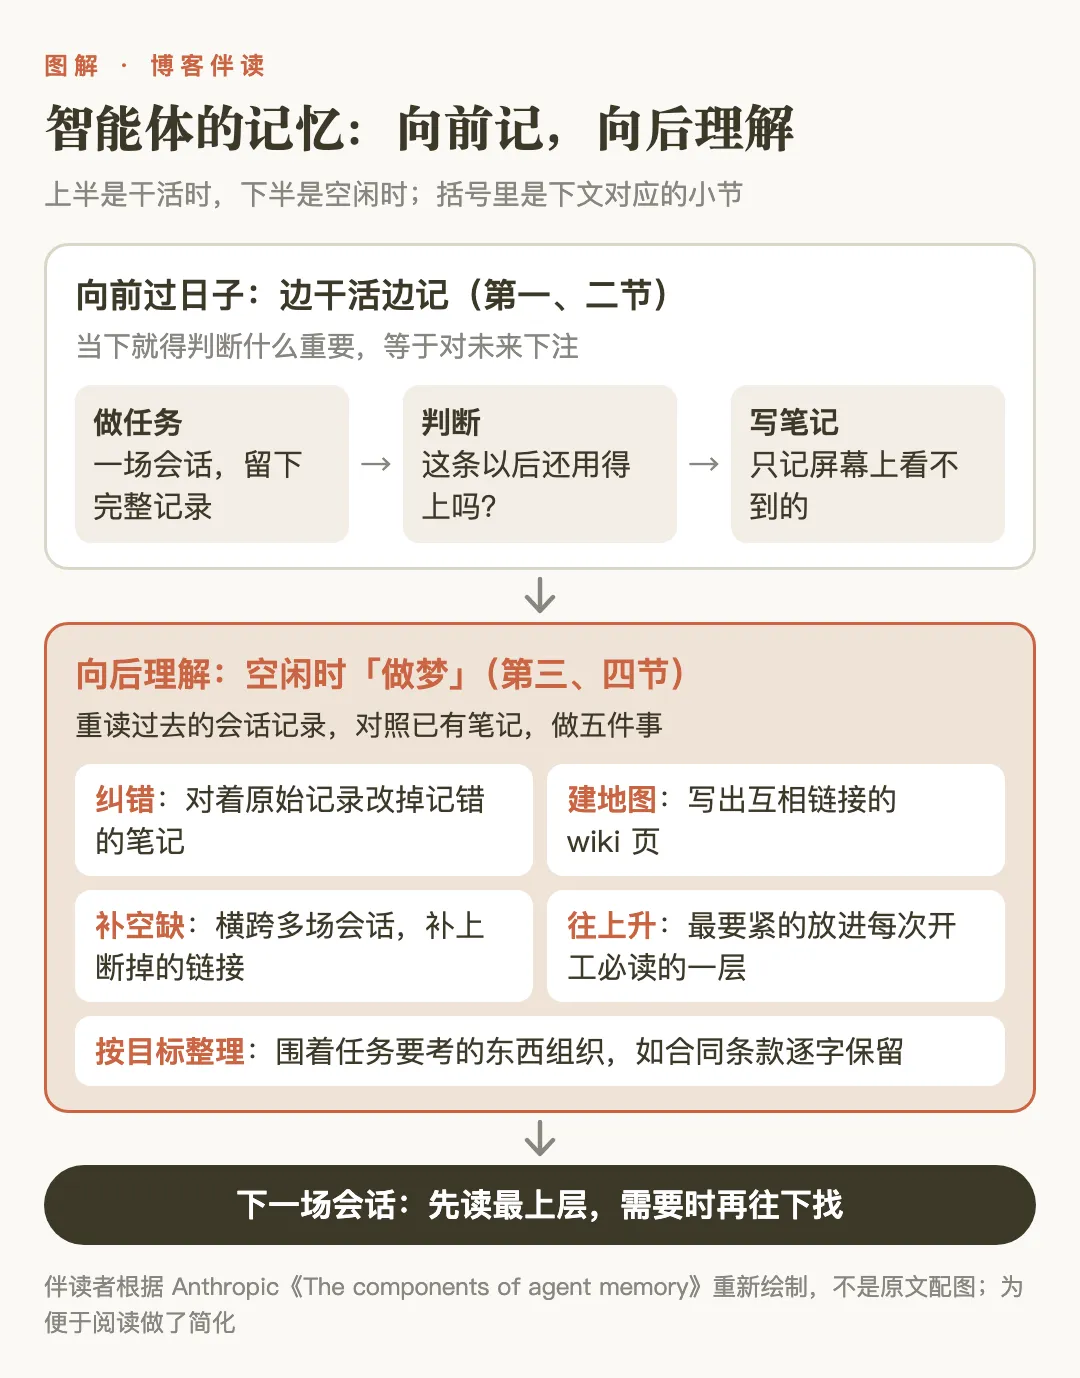
作者的答案:不会。记忆是对未来的一次预测,记什么要靠模型自己判断;再强的模型也猜不准未来,所以还要有「往回看」的一步,让它在空闲时重读过去的记录,纠错、建地图、只把最要紧的放在最上层。Anthropic 把这一步叫「做梦」。
读完你会带走:一个判断该记什么的标准;一套「小索引 + 分页笔记 + 定期回看」的记事办法,人和 AI 都能用;以及我们的判断:这篇的证据大多来自 Anthropic 自己的单次实验,结论的方向可信,具体数字只能当参考。
01
记下一条笔记,就是在下注
这篇文章出自 Anthropic 工程团队,执笔的是 Lance Martin。开头引了克尔凯郭尔的话:人生只能向后理解,却必须向前生活。作者称,给智能体设计记忆,碰到的是同一个困境:事情发生的当下就得决定记什么,可什么重要,往往要过后才知道。
先说清楚这里的「记忆」指什么。作者把它限定得很窄:Claude 从经历里(和用户的互动、交给它的任务)得到的知识,在会话之间留下来,存成以后能读的文字。改动模型参数不算,一次对话之内的临场学习不算,上下文太长时把旧内容压缩成摘要也不算。说白了,就是一个文件夹,里面放着它自己写的笔记。
作者的核心说法是:记忆有时就是一次预测。写下一条规则,等于预言这个规律以后还会用到;写下一条核实过的事实,等于预言将来的自己会直接用它、不再复查。
他们用一个叫 CL-Bench 的测试看模型会不会「下注」:Claude 要查数据库回答一连串问题,每答完一题就被告知正确答案,可以写一条记忆,下一题在全新的会话里开始,只有记忆文件夹会留下来。不同代的模型交出了不同的笔记。Sonnet 4.6 只走到猜原因这一步,文件夹里散着一堆文件,每个列着几条没验证过的猜测;Opus 4.7 把笔记合成一份参考文档,开始标哪些查证过、哪些还没有;Opus 5 第一次把循环走完,大多数条目都写着一条规则、怎么知道它是对的,以及路上踩过的坑。
另一个测试是玩《宝可梦·红》,差别更直观。走到大约一万步时,Sonnet 3.7 觉得什么都可能有用,每场战斗、每件道具、每个路人都单开一个文件,一共写了 413 个文件、225 个文件夹,拿到 1 枚徽章;Fable 5 只写了 9 个文件、2 个文件夹,外加一个总览文件,拿到 4 枚徽章。
Sonnet 3.7 输在哪?游戏状态一直在变,它的详细记录也一直在过期,越往后,它花在翻笔记上的时间越多。作者举了一个瞬间:一万步左右,它开了第四个「总档案」文件夹,接下来 17 步里新建 6 个文件、删掉 9 个,游戏里一步没走。Fable 5 只记游戏不会告诉它的东西:钱有多少、人在地图哪里,屏幕上每一刻都看得到,记了是多余;策略、计划和验证过的规则,只有自己想出来才存在,不写下来就没了。
能分清哪些值得记,下一个问题就来了:人该怎么教它记?
02
告诉它记忆是干什么的,别规定它怎么记
作者的经验是一句话:告诉 Claude 记忆是做什么用的,但别告诉它怎么用。在 CL-Bench 上,他们只说了一句「有个记忆文件夹可以用」,这对 Opus 4.7 和 Opus 5 就够了,两者的成绩都明显上去了。
他们也试过反过来,给模型定具体规则,比如「只记录失败」。结果 Opus 5 和 Opus 4.7 从记忆里得到的提升,大半都没了。作者的结论是:模型越强,越应该让它自己判断什么重要,事先定好的规则反而可能拖后腿。
规则也不是没用,它帮的是老模型。Sonnet 4.6 经常不读自己的记忆文件,也不去验证自己猜的原因;提示它「回答前先读记忆,再动手验证猜测」,分数差不多翻了一倍。到了 Sonnet 5,不用提示,十次里有九次它会先读记忆。所以 Anthropic 现在给前沿模型的指导很简单:用户要求时,或者有什么明显值得记时,记下来,剩下的交给 Claude 自己判断。
✦ 伴读批注|给 AI 写说明时,写目的,少写步骤
这条经验能直接搬到你自己用 AI 的方式上。很多人给 ChatGPT 的记忆、Claude 的项目说明写了一长串「每次都要……」「永远不要……」,以为规则越细越稳。这篇的实验提示了另一种可能:对强模型,一句「这个文件是给以后的你看的,记下你下次会需要、但从别处查不到的东西」,可能比十条规则更管用。
边界也要说清。这个结论只在强模型上成立,Sonnet 4.6 那样的老模型恰恰需要你把步骤写出来。所以先看工具:如果它总是忘了读笔记、总在同一个地方犯错,就把那一步写成规则;如果它已经会自己整理,规则就少写。
可模型再会判断,当下写下的笔记也可能从一开始就是错的。
03
往回看的那一步:做梦
人的大脑是这样处理的:海马体随时记录经历,但只有一部分会沉淀成长期知识;这种沉淀很多发生在离线时,睡眠和安静休息时,海马体会回放最近的经历,慢慢把它们整合进新皮层。Letta 和加州大学伯克利分校的研究者提出过「睡眠时计算」,让模型在两次交互之间的空闲时间重新整理已有的上下文。Anthropic 把同样的思路用在记忆上:让 Claude 回头读过去的会话记录,修正笔记、写出新的整理。这就是「做梦」。
作者举的纠错例子很有画面。游戏里要穿过月见山,一个西进东出的洞穴,入口附近有一道单向的坎,跳下去就回到来时的路,爬不回去。Claude 拿山脚的宝可梦中心当路标,却把它的位置记错了,以为在东边。走出中心时它宣布「月见山已在身后」,笔记里写上「月见山完成」;没走几步就跳下了那道坎,回到了来时的路,还以为自己「往西走过头了」。
让它对着会话记录「做一次梦」,它发现了笔记的错误,改了过来,带着改好的笔记径直回到山洞,最后到了华蓝市。没改的那一轮,它掉回原路三次,第三次后写下「我不打算再绕圈了」,被设置好的自动回复要求继续,于是一路退回了山前的尼比市,到结束都没到华蓝市。
做梦不只纠错,还能给记忆画地图。作者说的一种地图叫 wiki:Claude 自己写、自己维护的一组页面,每页汇总一个主题,互相链接。他们拿 Anthropic 5 月收购的软件公司 Stainless 的内部文档做测试,约 35 万个文件、4.2 亿个 token,出了 25 道题。让 Opus 5 一轮轮做梦建 wiki,从 2 轮做到 128 轮,只靠 wiki 答题的得分从 13% 涨到 48%;wiki 加搜索一起用,得分从 54% 涨到 61%,只用搜索是 53%,每题还省下约 2 万个 token。在一组关于公司并购的问题上,过半的题要跨几份文件拼信息;在这些题上,用 wiki 得 87%,只用搜索 73%。
wiki 也有不灵的时候。一项法律文书测试里,大部分答案在单份文件里就能搜到,wiki 没带来明显提升;另一项里,wiki 长得比原始文件还大。作者想到了博尔赫斯的一段话小说《论科学的严谨》:制图师画出一张和帝国一样大的地图,等于什么都没有概括。
做梦的第三件事,是补上单次会话留下的空缺。每次写笔记时,Claude 只看得到眼前这一场会话;做梦时它能横跨很多场,找出共同的问题。建 wiki 时,Claude 有时会链接到还没写出来的页面,第二轮做梦就把这些缺口补上:作者举的一次里,它找到 9 个指向不存在页面的链接,改指到同一份文件已有的页面,又新加了 3 页,其中一页是索引。
04
最上面那一层,必须很小
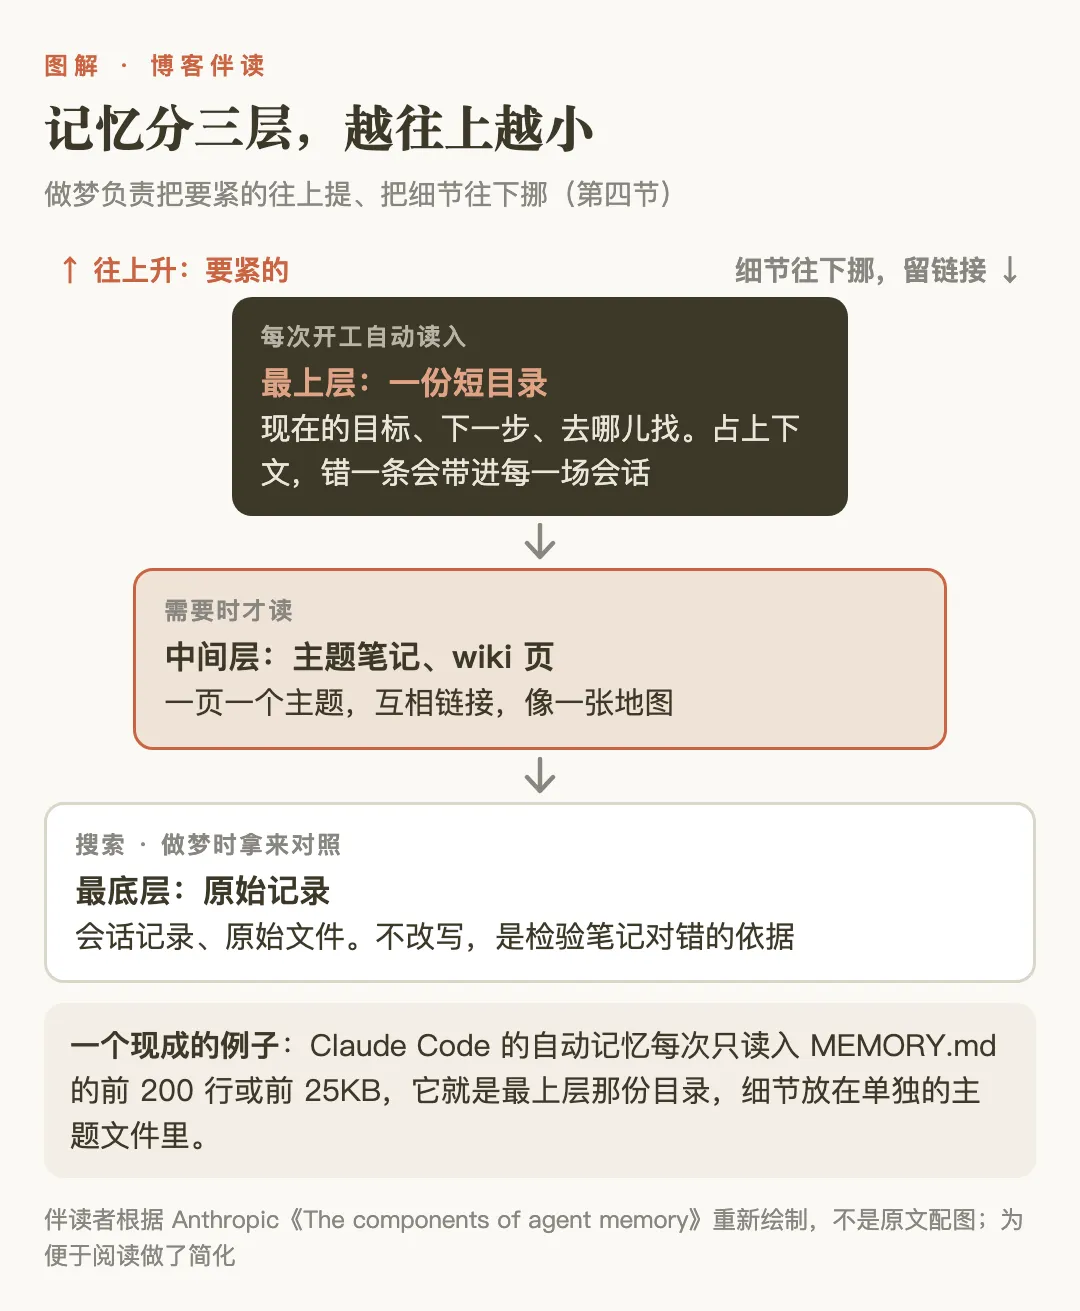
做梦还能决定每次开工时先看什么。整理好的笔记可以「升」到记忆的最上层,每次新会话一开始就自动放进上下文,Claude 连搜都不用搜。
作者提醒,这一层要格外小心:放进去的每一行都要占用宝贵的上下文,一条错的笔记会被带进每一次会话;放进去了也不保证它照做,Claude Code 的文档就提醒过,说明文件越长,模型越不容易照着做。所以做梦在这里的主要工作,是把细节往下挪,只在上层留一个链接。Claude Code 的自动记忆就是这么做的:每次只读入 MEMORY.md 的前 200 行或前 25KB,它就是一份目录,告诉 Claude 自己知道什么、去哪儿找。
最上层放什么,又取决于目标。作者举了一个合同的例子:任务是根据一批收购合同写法律文书,打分看合同条款写得对不对。一开始的建 wiki 说明没讲清这一点,几个智能体同时往一张共享的条款表里写,互相覆盖,表也概括得很差,最后 57 条该写进文书的事实只进了 41 条,约 72%。他们让 Claude 对着失败反思、自己改建 wiki 的说明,改成每份合同一页、一个智能体负责、条款逐字引用,57 条全部进来。
✦ 伴读批注|你的笔记,也需要一次「做梦」
这套结构对人一样适用。不管你用的是备忘录、Notion,还是给 AI 写的项目说明,都可以分三层:最上面一页很短的目录,只写现在的目标和去哪儿找;下面按主题分页;最底层是原始记录,聊天、会议纪要、原文,不改。再定期做一次「梦」:拿笔记对照原始记录,删掉过期的、改掉记错的、合并重复的。
合同那个例子还提醒了一件事:概括不是总比原文好。会被逐字追问的东西,比如合同条款、数字、承诺过的日期,就原样抄下来,标好出处,别急着用自己的话改写。
深读
为什么记得少,反而做得好?
Sonnet 3.7 的 413 个文件,让人想起博尔赫斯的另一篇小说《博闻强记的富内斯》。富内斯摔伤之后什么都忘不掉,每片叶子、每朵云的形状都记得清清楚楚,代价是他再也无法概括:他很难理解,为什么三点十四分从侧面看到的狗,和三点十五分从正面看到的狗,要用同一个词。记住一切的人,没法思考。
神经科学里有一个呼应这个直觉的观点。神经科学家 Blake Richards 和 Paul Frankland 2017 年在《神经元》上发表过一篇综述,说记忆的目的不是把信息原样送到未来,而是帮人做更好的决定;所以遗忘和记住一样重要:它能让过时的信息少干扰判断,也能防止人死抠某件具体往事、学不会举一反三。这和宝可梦里的情形几乎一模一样:钱和位置每秒都在变,记下来只会过期,真正帮助决策的是抽象出来的规则。
但这篇文章自己也给这个直觉划了边界。在合同那一例里,赢的恰恰是「不概括」:逐字抄条款,57 条一条不落;改写进共享表格的那版,丢了四分之一多。wiki 长得比原始文件还大,则是另一头的失败,没有概括。看来,问题不在记多记少,而在作者开头那句话:记忆是一次预测。宝可梦的未来会不停变化,奖励的是规则;法律文书的未来会被逐条打分,奖励的是原话。记什么、记多细,取决于你预料将来会被怎样追问。
这个判断在哪里会失效?就在未来本身难以预料的时候。作者在结尾也承认,再强的模型也不知道之后会发生什么;做梦能补救一部分,但它要花算力,也不可能把所有记忆都反复检查一遍。还有一层要读者自己留意:这些证据几乎都来自 Anthropic 自己的实验,宝可梦是每个模型各跑一轮,wiki 测试只有 25 道题,没有给出波动范围;文中多处链接到 Anthropic 正在推的「做梦」功能和示例代码。而写这篇伴读的,也是这些实验里被测的 Claude。
落到自己身上,我们的判断是:别问「要不要多记一点」,先问「将来会怎么用它」。会变的,记规则;会被追问原话的,记原文;判断不了的,先把原始记录留好,等回头看的时候再整理。
核对
原文的几处说法
•「睡眠时计算」:确有其文,Letta 与加州大学伯克利分校的 Kevin Lin、Charlie Snell 等人 2025 年 4 月的论文《Sleep-time Compute: Beyond Inference Scaling at Test-time》(arXiv(arxiv.org))
•海马体在离线时回放、把经历整合进新皮层:原文引了神经科学的经典理论,如 McClelland、McNaughton 与 O'Reilly 1995 年的互补学习系统论文(PDF(stanford.edu)),本文只做了概述
•CL-Bench 1.0:是公开的测试,2026 年 5 月 4 日发布(CL-Bench(continual-learning-bench.com));文中各代模型的表现是 Anthropic 自己跑的,没有公开的独立结果
•宝可梦里的文件数和徽章数(413 个文件 / 225 个文件夹 / 1 枚徽章,对 9 个文件 / 4 枚徽章)、Opus 5.5 打通游戏:作者称,原文说明是每个模型各跑一轮的比较,没查到独立来源
•Stainless 的内部文档:Anthropic 2026 年 5 月 18 日宣布收购 Stainless(Anthropic(anthropic.com));约 35 万个文件、4.2 亿个 token 和 25 道题的得分是作者称
•法律文书测试:用的是 Harvey 公开的 LAB 测试集(GitHub(github.com));87% 对 73%、41/57 到 57/57 这些数字是作者称
•Claude Code 只读入 MEMORY.md 前 200 行或 25KB;说明文件越长越不容易被遵守:属实,Claude Code 官方文档写着「前 200 行或前 25KB,以先到者为准」,并说超过 200 行的文件会占更多上下文、可能降低遵守程度(文档(code.claude.com))
•「做梦」是一项产品功能:Claude Managed Agents 的「Dreams」目前是研究预览,要申请才能用(文档(platform.claude.com));原文末尾也链到了配套示例
•利益相关:原文是 Anthropic 介绍自家模型和功能的研究文章;本文由 Claude(Anthropic 的模型)参与写作,也就是文中被测的模型家族,请读者留意
留给你
一个问题
你现在留着的笔记里,有多少是「屏幕上随时看得到」的东西?真正只有你自己想明白、不写下来就会没了的,又有几条?
···
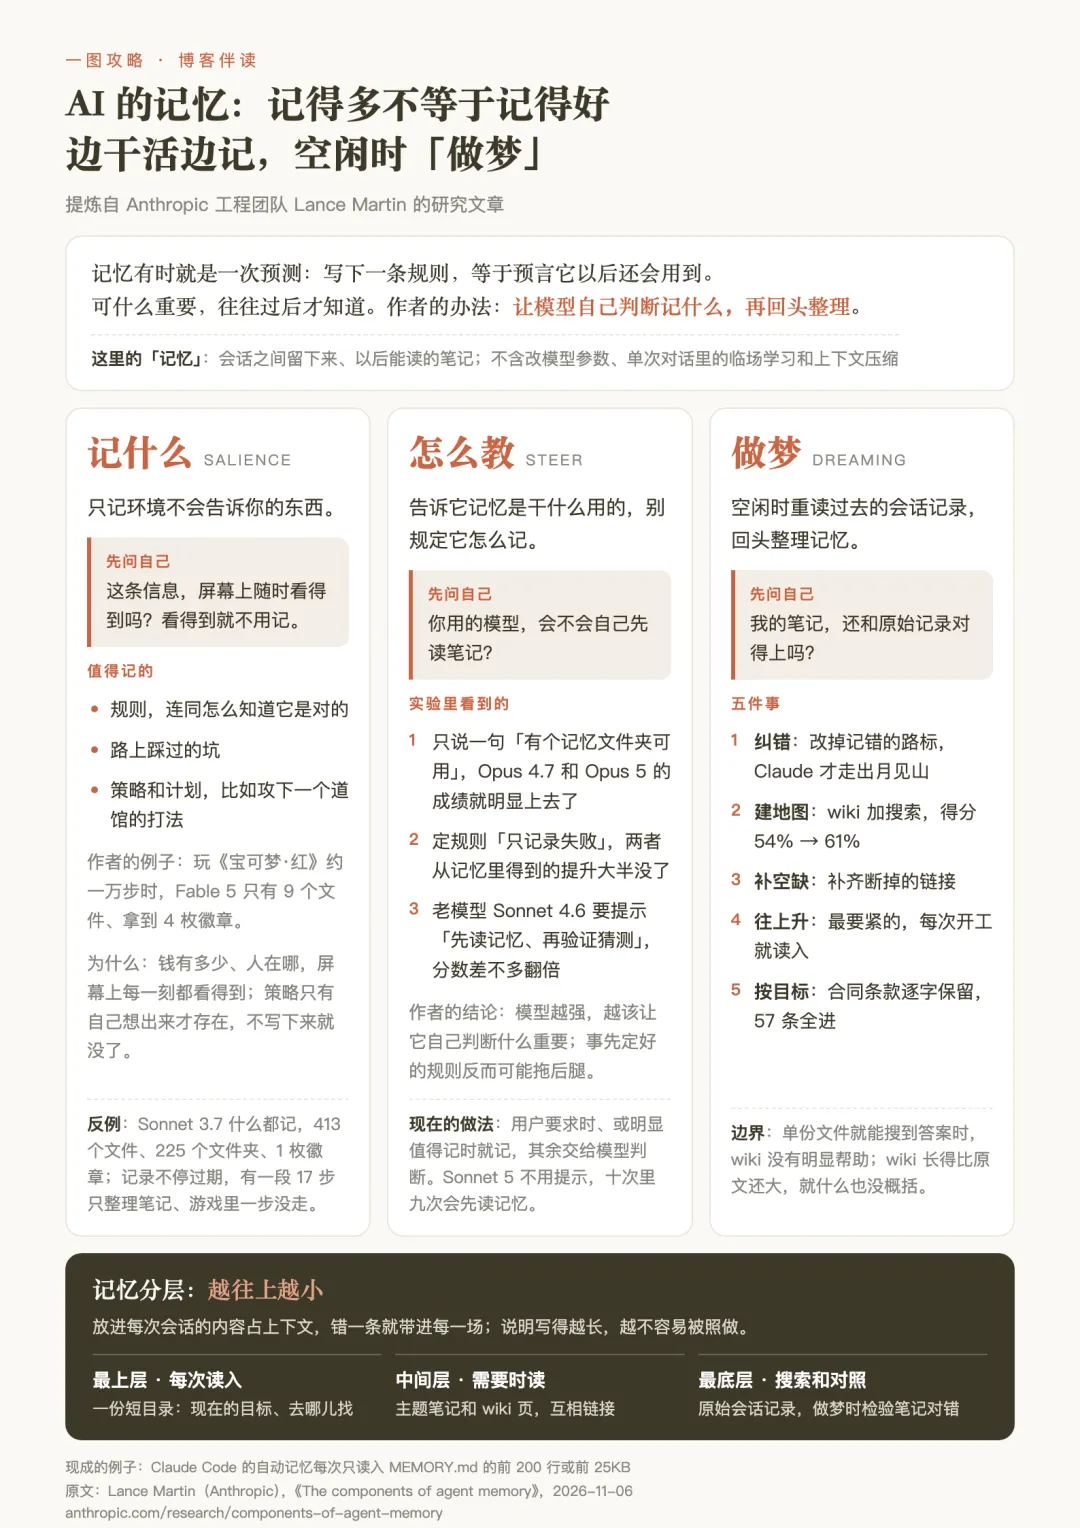
一图攻略 · 点击下图,可保存 / 分享图片
延伸阅读
想继续往下读
•Sleep-time Compute 论文(arxiv.org):「做梦」思路的来源之一,讲模型怎么在用户提问之前,利用空闲时间预先想好
•Karpathy 的 LLM Wiki 笔记(gist.github.com):原文链接到的一份「个人知识库」做法,主张让模型逐步建起并维护一个互相链接的 wiki,而不是每次提问都从原始文件里现找,可以对照第三节读,自己就能照着搭
•Forgetting can make you smarter(eurekalert.org):Richards 与 Frankland「遗忘让人更聪明」那篇综述的新闻稿,深读一节的出处,几分钟能读完
原文链接:The components of agent memory(anthropic.com)(Lance Martin,Anthropic,2026-11-06)
本文是伴读导读,不是全文翻译;批注和「深读」是伴读者的观点,不代表原作者。原文版权归作者所有。