ARTICLE · 1333686
Chroma 源码拆解
4 个 API 的背后,是 34 万行 Rust:Chroma 源码拆解
上一篇结尾我预告说,要拆一个"三千行代码的向量数据库"。这句话说错了。
那是 Chroma 早期 Python 版本的印象。现在这个仓库光 Rust 就有 340,396 行、762 个文件、41 个 workspace crate。而它对外的核心 API,官方 README 写得很直白:只有 4 个函数——建集合、加数据、查询、按 ID 取。
开源地址:https://github.com/chroma-core/chroma 许可证:Apache-2.0 版本:Rust 核心 0.15.0,Python 客户端 1.6.0 规模:约 3 万 stars,Rust 34 万行
4 个 API 和 34 万行之间的落差,就是这篇要拆的东西:一个"给 AI 用的数据库",到底把复杂度藏在了哪里。
它到底是什么
Chroma 自称"the open-source data infrastructure for AI"。翻成工程语言:它存三样东西——向量、原文、元数据,并且支持这三样混在一起查。
你给它一段文本,它帮你算 embedding、建索引;你查询时可以用向量找相似、用 where 过滤元数据、用 where_document 做全文匹配,最后按距离排序返回。单机 pip install chromadb 就能跑,也可以起服务端,或者用它的云服务。
真正值得看的是它的架构选择:它没有把"数据库"做成一个大程序,而是拆成了日志、块存储、索引、元数据四套独立系统,用对象存储当底座。
为什么要从 Python 搬到 Rust
早期 Chroma 是 Python + SQLite + hnswlib,原型体验极好:一个进程、一个文件、没有依赖。但要做云,这套东西会撞上三堵墙。
第一堵是存算分离。云上的数据必须放对象存储(S3),计算节点要能随时扩缩。SQLite 是本地文件,天然做不到。
第二堵是写入与索引解耦。HNSW 是图结构,插入要改邻居指针,天然不适合"来一条写一条"。要么牺牲写吞吐,要么牺牲读一致性。
第三堵是多副本与故障恢复。单机 SQLite 没有 WAL 复制、没有 quorum、没有崩溃后的一致性校验。
Rust 重写不是为了性能数字好看,是为了能同时拥有这四样东西:对象存储、日志复制、异步 compaction、多语言绑定。代价是你现在看到的 34 万行。
代码怎么组织
41 个 crate 看着吓人,按数据路径分其实就五层。
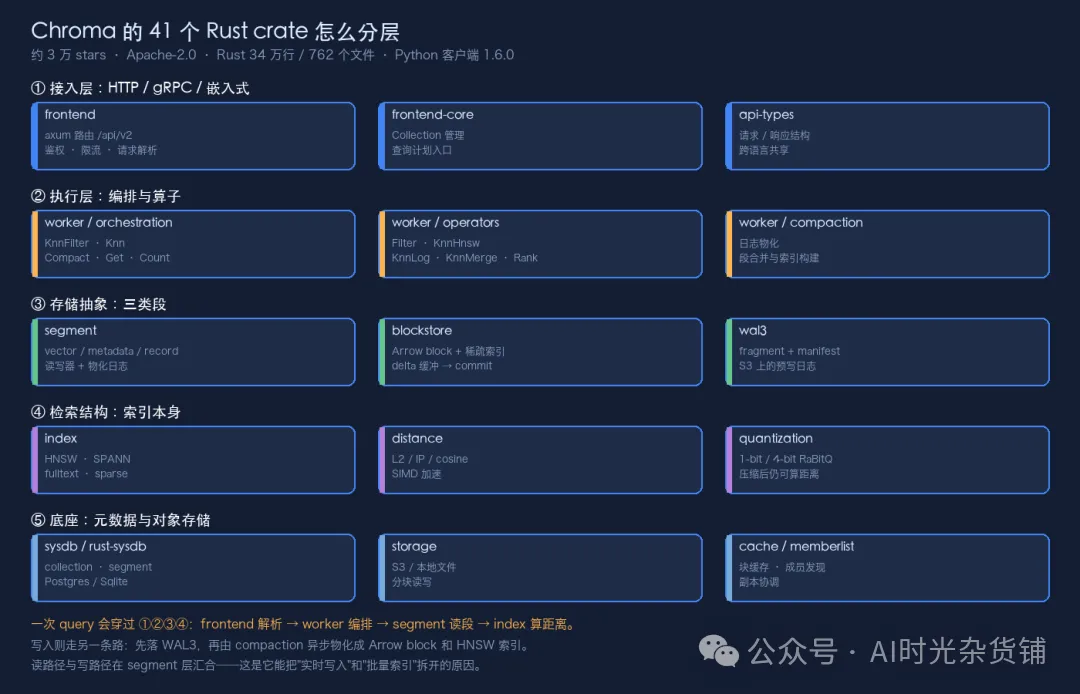
Chroma 的 41 个 Rust crate 怎么分层
- 接入层
: frontend用 axum 暴露/api/v2,frontend-core处理集合管理,api-types定义请求响应。 - 执行层
: worker里再分orchestration(编排 DAG)和operators(单个算子),外加compaction。 - 存储抽象
: segment定义"段",blockstore提供 Arrow 块文件,wal3提供日志。 - 检索结构
: index里是 HNSW、SPANN、全文、稀疏向量,distance算距离,quantization做压缩。 - 底座
: sysdb存集合和段的元数据,storage抽象 S3 与本地文件,cache、memberlist做缓存和成员发现。
读代码时有一个很实用的顺序:先看 rust/types/src/collection.rs 搞清数据模型,再看 rust/worker/src/execution/ 搞清一次查询怎么被拆成算子,最后才进 rust/index 和 rust/blockstore 看底层。反过来读会陷进细节。
一个关键设计:一个 collection 等于三个段
这是理解 Chroma 的钥匙。你在客户端看到的是一个 collection,服务端存的是三个独立的 segment。
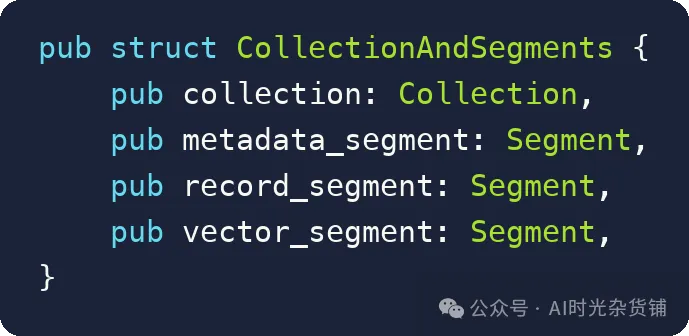
定义在 rust/types/src/collection.rs:392。三个段各管一摊:
- vector_segment
:只存向量和 ID 的映射,底下挂 HNSW 或 SPANN 索引。 - metadata_segment
:存元数据的倒排,负责 where过滤和全文检索。 - record_segment
:存原始文档和完整记录,查询最后一步回表用它。
为什么要拆?因为三者的更新频率和存储格式完全不同。向量索引要批量构图,元数据要频繁更新,原文要按行读。混在一个文件里,任何一方变化都会拖累另外两方。拆开之后,可以各自选格式、各自 compaction、各自扩容。
代价是查询要跨三个段做拼接,这就是后面调用链里那些 merge 算子存在的原因。
核心机制一:过滤不是"查完再筛"
最容易被误解的一点:带 where 的向量查询,不是先取 top-k 再过滤。那样一旦过滤条件苛刻,可能前 100 个都不符合,结果直接空掉。
Chroma 的做法是先把"允许的 ID 集合"算出来,再让 HNSW 在这个集合里走图。
第一步,FilterOperator 在 rust/worker/src/execution/operators/filter.rs:51。它的输入是日志、元数据段、记录段,输出是位图:
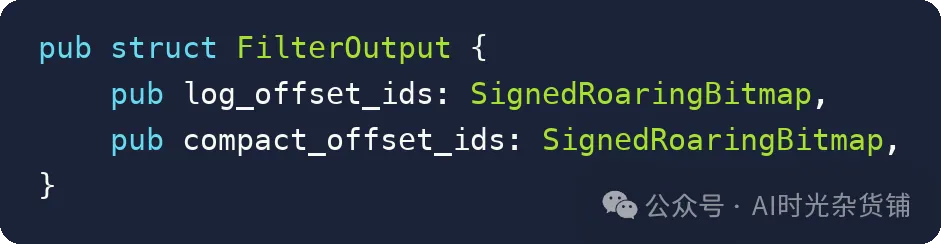
SignedRoaringBitmap 就是 RoaringBitmap 加了"排除"语义。元数据条件先查倒排拿到一批 offset,多个条件之间做交并差;文档的 $contains 走 n-gram 或全文索引;ID 条件再求一次交。整个过程都在位图上做集合运算,不碰向量。
第二步,把位图转成 offset 列表,传进 HNSW 查询。rust/index/src/hnsw.rs:270:
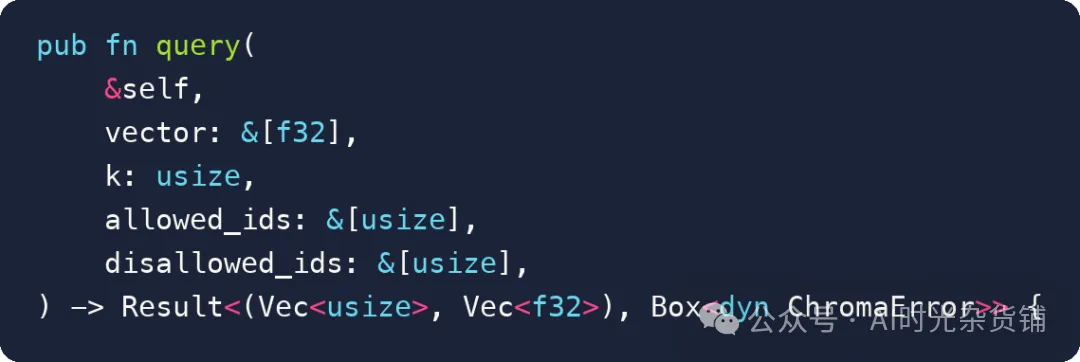
底层 hnswlib 的 query 支持 allowed/disallowed 两个列表,走图时直接跳过不在集合里的节点。这比"多取一些再过滤"稳得多:召回率不会随过滤强度崩塌。
人话类比:不是先让所有候选人排队再查户口,而是先把不合格的人挡在门外,再让剩下的人比距离。
核心机制二:把 Arrow 当 KV 用
blockstore 是 Chroma 最像"自研数据库"的部分。它要解决的问题是:如何在对象存储上存一张可随机读、可范围扫、还能增量写的表。
答案是三层结构:不可变块 + 稀疏索引 + 可变 delta。
不可变块用 Arrow IPC 格式,列式存储,天然适合批量读。稀疏索引在 rust/blockstore/src/arrow/sparse_index.rs:64,核心是一个 BTreeMap:
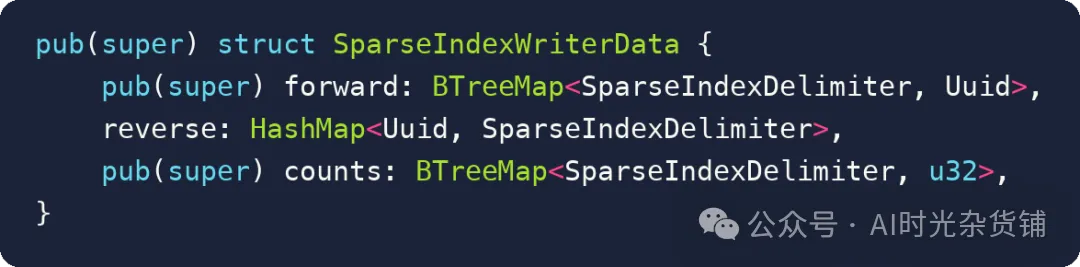
它记录"每个块的起始 key 是哪个、块 ID 是什么"。查一个 key 时,先在 BTreeMap 里二分找到目标块,再去对象存储读那一个块。这就是 LSM 的思路,只是值从字节变成了 Arrow RecordBatch。
增量写先落在内存里的 delta,读的时候 delta 优先、块其次。真正落盘发生在 commit(rust/blockstore/src/arrow/blockfile.rs:118):
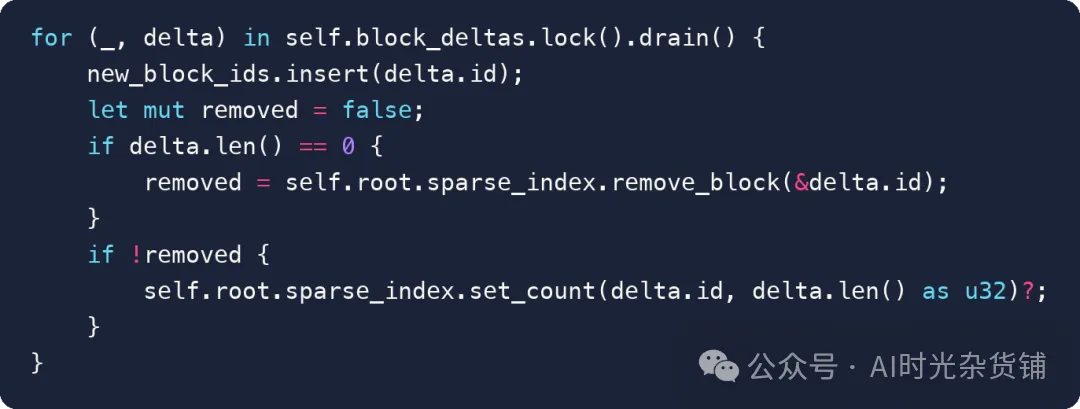
空 delta 直接从稀疏索引里摘掉,非空的转成新块、更新计数。commit 之后产生的是不可变文件,可以直接上传对象存储,也可以被多个副本共享。
人话类比:像一本活页笔记本。已经写好的页不再改,新内容先写在便签上;便签攒够了,换成新的一页插进目录,旧便签扔掉。
核心机制三:WAL3,在 S3 上做预写日志
有了块存储还不够。用户 add 之后,数据要立刻能查到,不能等 compaction 跑完。这段窗口由日志兜住。
wal3 是第三代 WAL,专门为对象存储设计。它没有"追加写一个文件"这种奢侈,因为 S3 不支持原地追加。它的做法是:每次写入生成一个 fragment,同时推进 manifest。
manifest 是一个很小的原子指针,记录"这个日志当前由哪些 fragment 组成"。fragment 写成功不算数,manifest 推进成功才算持久化——这就是 commit point。
多副本靠 quorum。rust/wal3/src/lib.rs:48 导出了 write_quorum,rust/wal3/src/interfaces/repl/fragment_manager.rs:357 调用它,再用 process_quorum_results 判断是否达到最小副本数。更细的一点是 setsum:每个 fragment 带一个集合校验和,副本之间不仅要比"写成功",还要比"内容一致"。
人话类比:不是往一个本子上续写,而是每页单独复印几份放进不同抽屉,再用一张目录卡声明"这一版由第几页到第几页组成"。目录卡换了,才算改版成功。
核心机制四:大到单机放不下时,用 SPANN
HNSW 的内存开销随数据量线性涨。十亿级向量塞不进一台机器,Chroma 的答案是 SPANN。
rust/index/src/spann/types.rs:322 定义了 SpannIndexWriter。它先用一个小 HNSW 存"聚类中心",每个中心挂一条 posting list(倒排列表),列表里是该簇的向量 ID。查询时先找最近的若干中心,再只扫这几条 posting list。
为了省内存,向量会被量化。rust/index/src/quantization/multi_bit.rs 实现的是 4-bit RaBitQ:把向量切成网格点,用"射线游走"找与残差余弦相似度最高的格点。1-bit 版本更狠,只存符号位。量化后的码可以直接算近似距离,用来粗排,精排再回原始向量。
这套东西和 HNSW 是并存的:单机小集合用 HNSW,分布式大集合用 SPANN。选哪条路由 collection 的配置决定。
一次查询和一次写入,走的是两条路
查询路径可以概括成"两段编排、四个算子"。
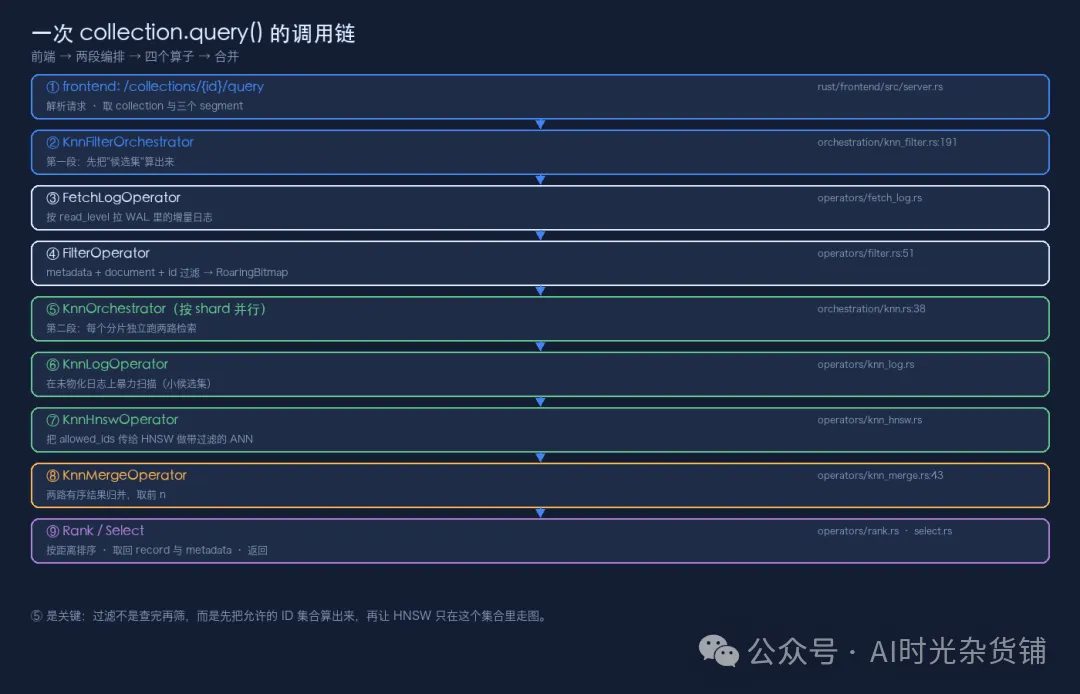
一次 collection.query() 的调用链
前端收到请求后,KnnFilterOrchestrator(rust/worker/src/execution/orchestration/knn_filter.rs:191)先跑第一段:拉日志、做过滤,得到候选位图。然后 KnnOrchestrator 按 shard 并行跑第二段:每个分片同时查 KnnLogOperator(未物化日志,暴力扫)和 KnnHnswOperator(已建索引,走图),两路结果由 KnnMergeOperator 归并(rust/worker/src/execution/operators/knn_merge.rs:43),最后排序、回表、返回。
写入路径则是另一个故事。
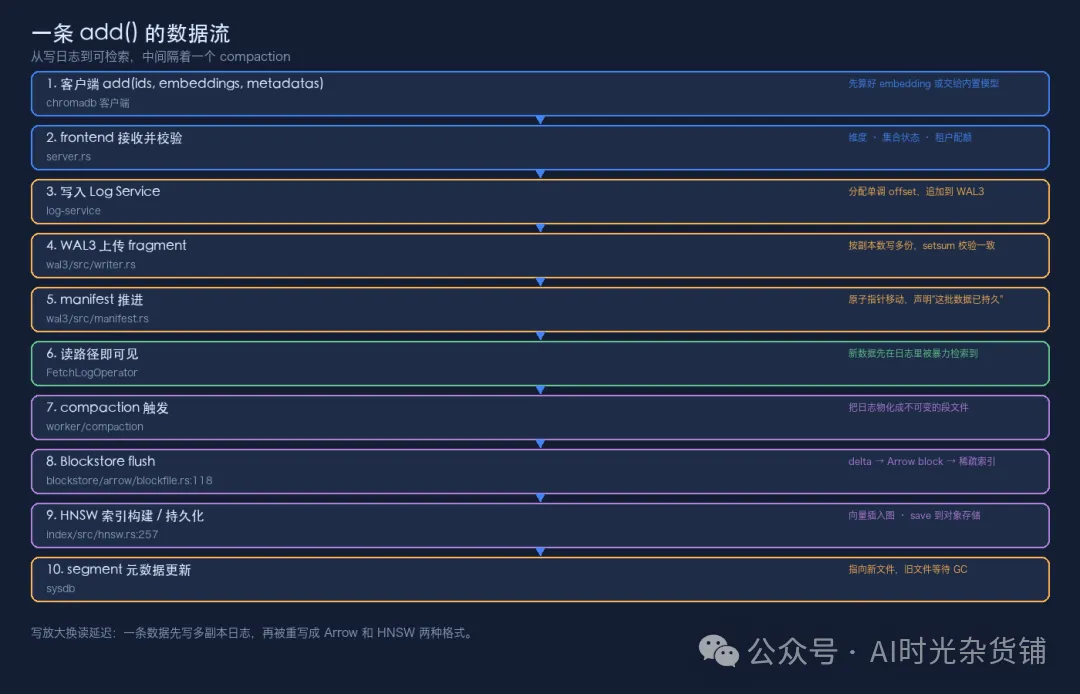
一条 add() 的数据流
数据先写日志服务拿到单调 offset,再由 WAL3 复制成多份 fragment、推进 manifest。此时读路径已经能查到它——因为 FetchLogOperator 会读日志。compaction 在后台把日志物化成 Arrow block 和 HNSW 索引,更新 sysdb 里的段元数据,旧文件交给 GC。
这就是"写入快、索引慢"的来源:写入只碰日志,索引构建是异步的。代价是同一份数据在一段时间内存在两份(日志和索引),查询要把两路结果合并。
取舍清单
边界
它适合:RAG 的知识库、语义搜索、推荐召回、需要"向量 + 元数据 + 全文"混查的场景。单机模式足够跑原型,服务端模式能上生产。
它不适合:强事务的 OLTP、复杂 join、需要精确一致性的账务类数据。它是检索系统,不是关系数据库。
运维成本是真实的。自建服务端意味着你要管对象存储、元数据库、worker、compaction。单机模式没有这些,但也没有水平扩展。
版本还在快速变。Rust 核心 0.15、客户端 1.6,接口和内部结构都还在动。读源码时以你 clone 到的那一版为准。
怎么跑起来
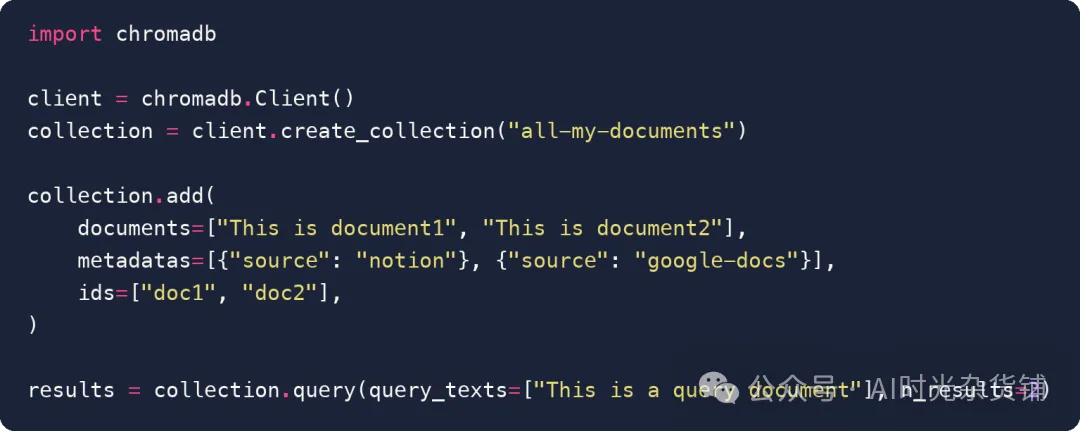
最省事的路径是嵌入模式,不需要起服务:
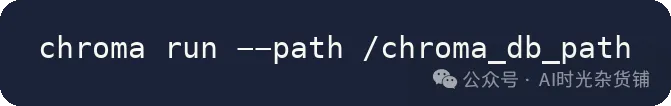
想跑服务端:
想读源码,建议先 cargo build -p chroma-frontend,再从 rust/frontend/src/server.rs 的路由表往里跳。41 个 crate 不用全看,按"接入 → 编排 → 段 → 索引"这条线走一遍就够建立地图了。
为什么值得读
向量数据库这个品类,很多产品的差异在"封装了哪个索引库"。Chroma 的差异在"怎么把索引库塞进一个能水平扩展的存储系统"。
它把 HNSW 当成一个可替换的索引实现,真正自研的是三段模型、Arrow 块存储和 WAL3。这三样决定了它能不能上云,而 HNSW 只决定单机快不快。
如果你只想知道"怎么存向量、怎么算相似度",看 rust/index 就够。如果你想看"一个检索系统怎么从单机原型长成分布式服务",那 34 万行里真正值得读的,是 blockstore 和 wal3。
下一篇写 memfree:一个跨会话记忆层,看它怎么决定"什么该记住、什么该忘"。
「热门开源项目拆解」系列持续更新,拆的是代码,不是新闻稿。觉得有用可以点个关注。