ARTICLE · 1365013
WorkBuddy 读 PDF 七步教程:18 页我只让它读 12 页
WorkBuddy 读 PDF 七步教程:18 页我只让它读 12 页18 页的指南,它 0.87 秒就读完了,吐出六万多个字符。我没急着看摘要,先翻了它吐出来的原文,翻到第 3 页就停下了。 左右两栏被拼成一行,句子的主谓宾全错位。不是它读不懂,是我把一半不用读的东西也塞给了它。 先说结论,省你 3 分钟:那后 6 页全是英文参考文献——字符数 33,835,比正文的 32,113 还多;里面真正的正文汉字只有 174 个。把范围卡死在 1 到 12 页,它才读得对。下面七步,就是把这句话落到操作上。 没用过的从第 1 步看;只会说「帮我总结一下」的,直接跳到第 3、4 步。 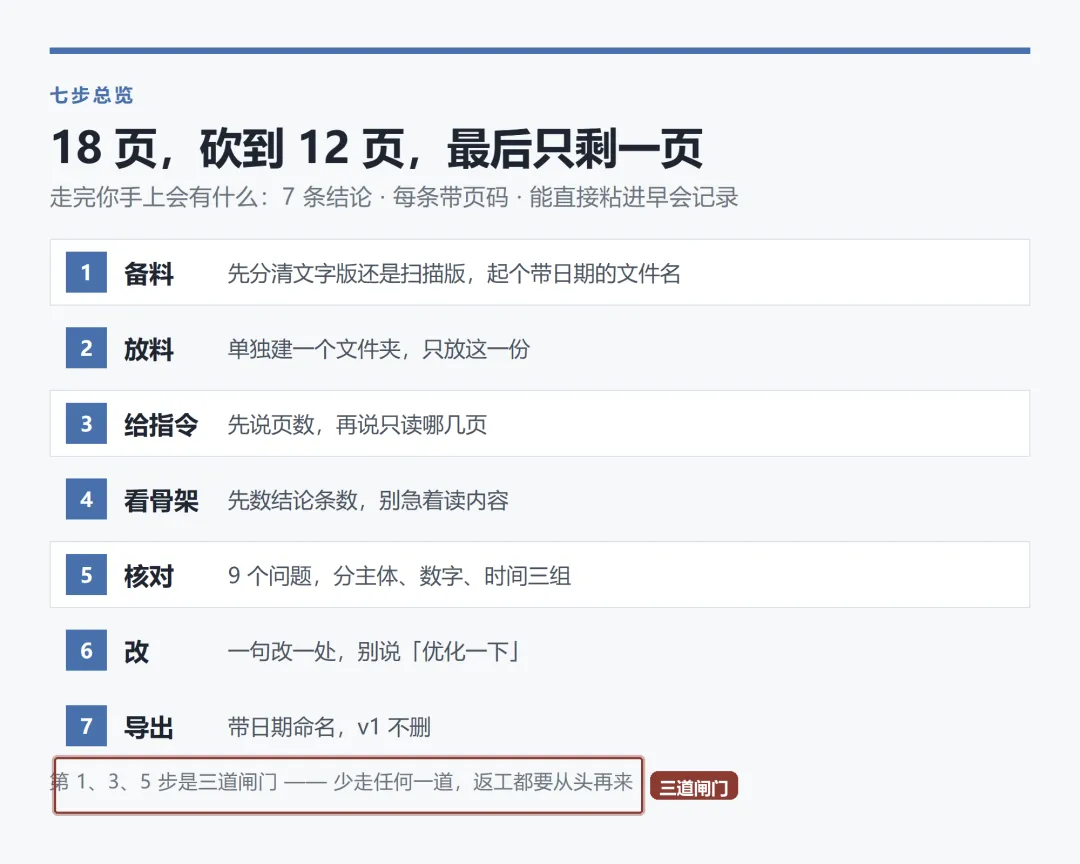
七步的顺序不能换,第 1、3、5 步是三道闸门 走完你手上会有什么 一页东西,7 条以内的结论,每条后面带一个页码,格式是(P5)。表结构单独一节,写清表名、页、行列数。 我那次的成品是 6 条结论加 3 张表的清单,粘进早会记录里,谁问哪句我都能翻回第几页。 1备料:先分清它是文字版还是扫描版 这一步三十秒,但决定后面七步能不能走。文字版能提取文字,扫描版是一张张图,得先有 OCR 引擎。 我另一份护士站的演练方案就是这么翻车的:跑出来不是文本,是一行报错,--ocr needs PaddleOCR or Tesseract on PATH。那份是扫描件。 文件名也顺手改掉:2026-11-16-ANCA指南.pdf。带日期,不带空格,以后你自己一眼认得出是哪一版。 别写进材料说明的词 「大概」「部分」「有所」「相关资料」——这几个词它没法核,只会顺着编。要么给数字,要么删掉。 2放料:一个文件夹只放这一份 我建了个 PDF速读/2026-11-16-指南/,里面只有这一个 PDF。工作空间选这个文件夹,别选桌面。 选桌面的后果我试过:它会顺手把旁边几个也读了,摘要里混进别的文件的内容,你还得倒回去猜哪句是哪份的。 放好书,第一句先验它到底读到了没有,就问一句:「这份 PDF 一共几页?第 3 页第一句是什么?」答 18 页,就是读到了。 3给指令:先把页数说死 我数了一遍这份指南的字符:1 到 12 页 32,113 个字符,13 到 18 页 33,835 个,汉字只有 174 个——后面六页全是英文参考文献,占了一半篇幅。 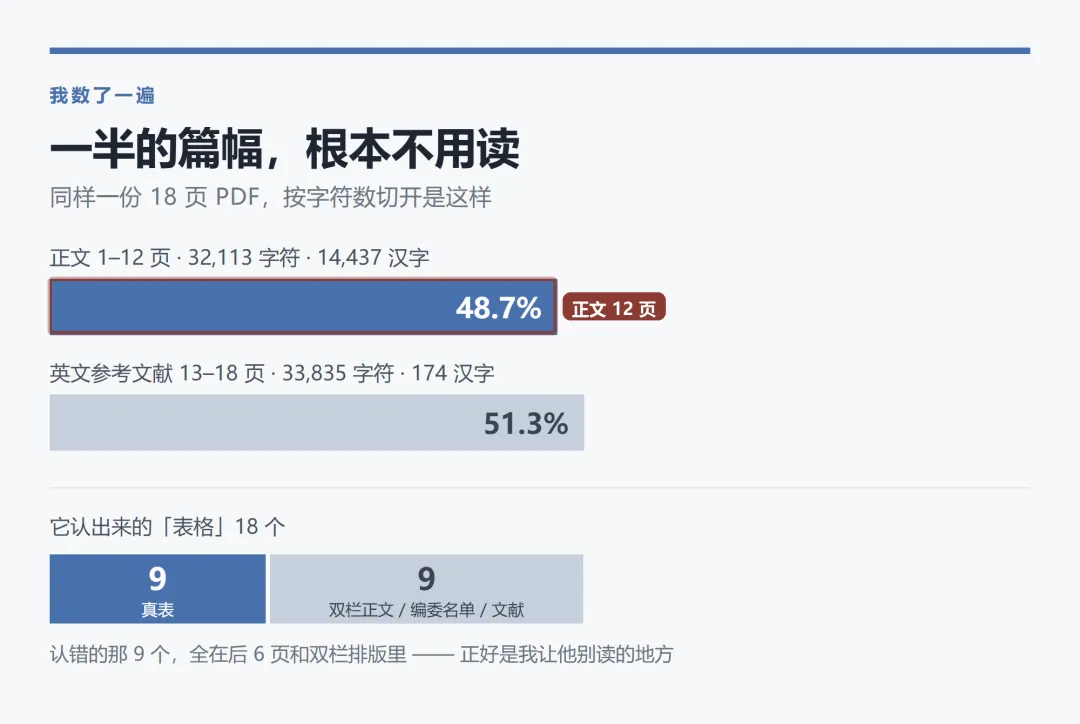
同样 18 页,按字符数切开:一半在读文献 所以指令第一句不是「帮我总结」,是把范围划出来。下面这段可以直接抄,把数字换成你自己的: 这份 PDF 一共 18 页。正文在 1 到 12 页,13 到 18 页是英文参考文献,跳过不读。 只读 1 到 12 页,做三件事: 一、先报正文有几个一级标题,分别在第几页。 二、给我 7 条以内的结论,每条后面用括号标页码,格式(P5)。 三、表格单独一节:表名、在第几页、读到几行几列。表头缺了就写「表头缺失」。 不确定的地方写「未找到」,不要猜。 照抄就行,第 1 步和第 3 步的数字必须跟你手上那份对上 4看骨架:先数条数,别急着读内容 它答完,我先干一件很笨的事:数。数它给了几条结论、几条带页码、一级标题是不是 6 个。 数不对就直接让它补,一句话的事:「第 4 条和第 7 条没有页码,补上,补不出来就删掉。」 为什么不先读内容?因为我上一版就是先读了内容,觉得挺顺,读到第四条才发现第三条的数字和原文对不上,前面全白读。 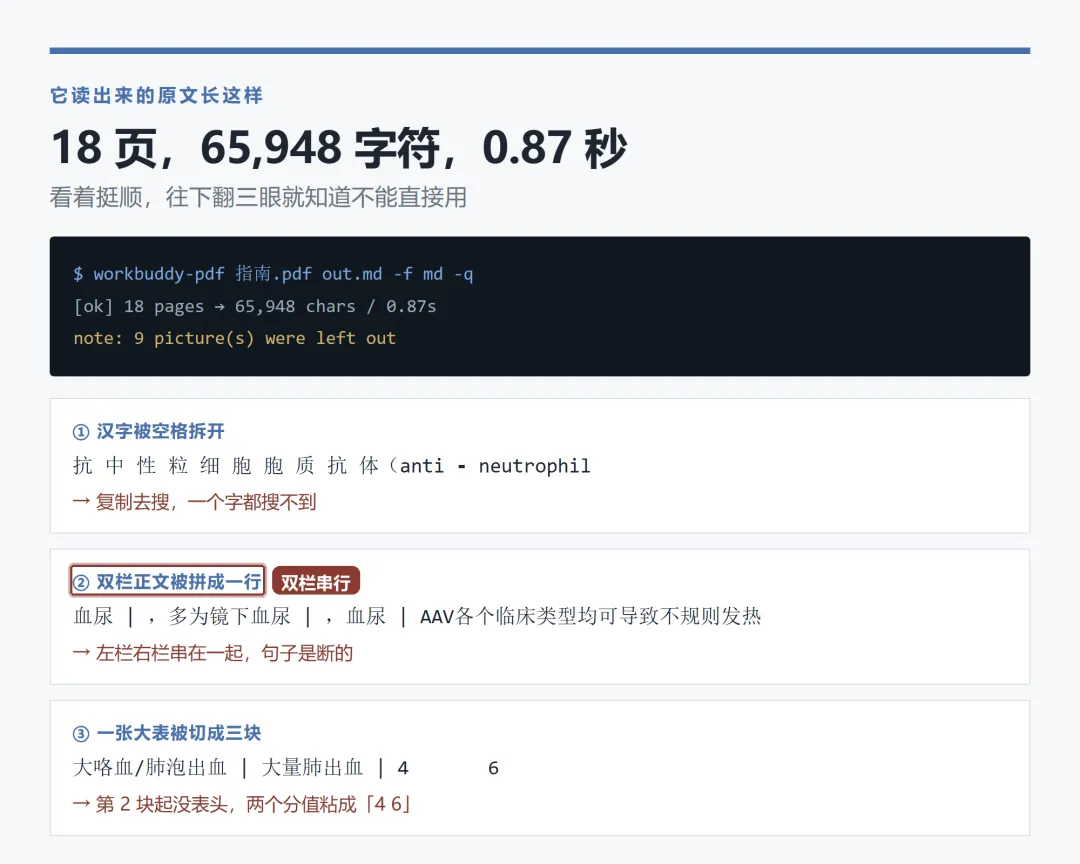
它读出来的原文长这样,看着顺,其实不能直接用 三处硬伤我都在原文里指出来了:汉字被空格一个个拆开,复制去搜一个字都搜不到;双栏正文拼成一行;一张大表被切成三块。 最坑的是表格。它一共认出来 18 个「表格」,我一个个点开看,真表 9 个,另外 9 个是双栏正文、编委名单、英文文献被切成的伪表,全在后六页。 其中一张我印象最深:那不是表,是编委会名单,几十个人名被硬排成三行四列,中间还夹着英文文献的句子。要不是点开看一眼,我会以为自己多了一张数据表。 5核对:九个问题,问能指回原文的事实 这一步是整篇最值钱的地方。别问「准不准」,它一定说准。要问那种它能翻回第几页指给你看的。 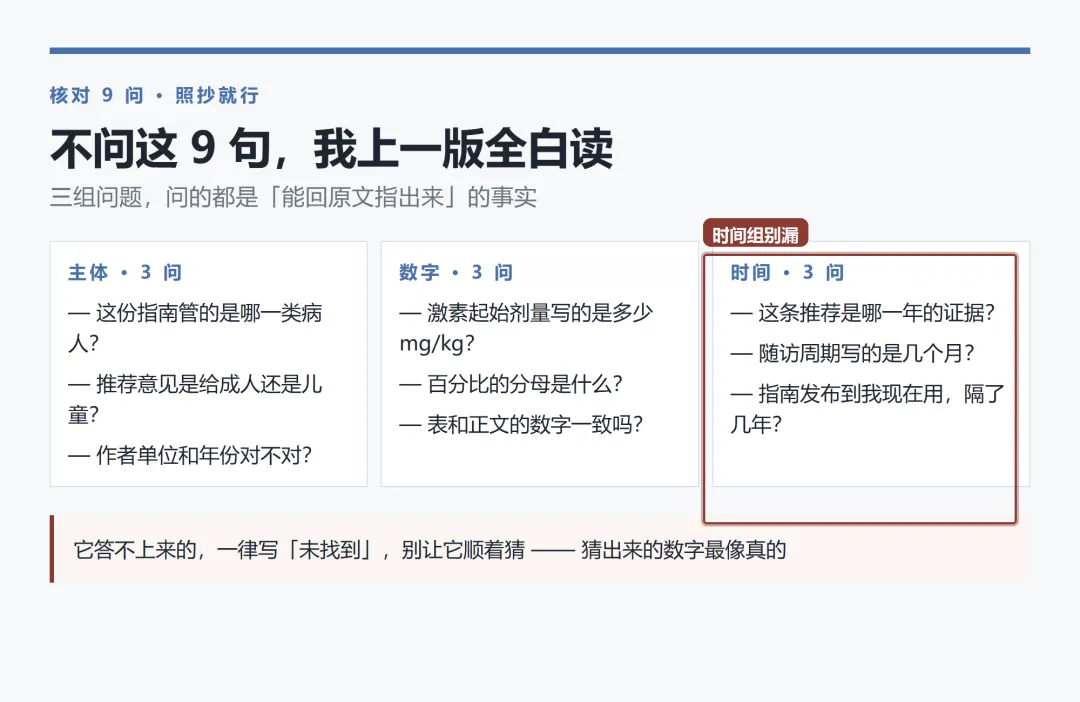
三组九问,照抄就行 按下面 9 个问题逐条回答,每条后面标页码;答不出来的写「未找到」,不要推测。 主体:这份指南管的是哪一类病人?推荐意见是给成人还是儿童?作者单位和年份对不对? 数字:激素起始剂量写的是多少 mg/kg?百分比的分母是什么?表和正文的数字是否一致? 时间:这条推荐是哪一年的证据?随访周期写的是几个月?指南发布到现在隔了几年? 我把这九问问完,又做了一件更笨的事:把 9 张真表一张张点开,对着原文页看表头。9 张里有 5 张没有表头行,第一行直接就是数据,照着列读必错。 它的规矩我后来定死了:答不上来的写「未找到」,别顺着猜。猜出来的数字最像真的,也最难被发现。 这九问你自己未必用得上,但你身边一定有人正把 AI 读出来的数字直接往报告里抄。转给那个还在逐字核对 PDF 的同事——他省下的,可能是一整个晚上。 6改:一句改一处 改的时候句式很关键。说「第 5 条把 30% 写成 3%,原文是 P7」,它只动这一处;说「再优化一下」,它会整篇重写一遍,页码全乱。 我总结的模板就一句:第 X 条,把 A 改成 B,原文在 P几,别的不要动。 7导出:留一份 md 底稿 命名带日期和版本:2026-11-16-ANCA指南-v1.md。改完存 v2,v1 别删。 为什么留 md:docx 只是交付壳,排版一乱你就没底稿了;md 是纯文本,哪天换个工具还能直接用。 四个卡点,我踩的时候都不知道该说什么 它说读不出来 说「这份是扫描件,先告诉我哪几页是图」;别说「你仔细看看」。 两栏被拼成一行 说「第 3 页两栏被拼在一起了,按左栏到右栏重排」;别说「重新提取一下」。 表被切成三块 说「表 6 从第 5 页跨到第 6 页,表头在第一块里,三块拼起来」;别说「表格有问题」。 汉字被空格拆开 说「去掉汉字之间的多余空格,把 ⁃ 换成 -」;别说「格式乱了」。 四句我都是被逼出来的。第一句当时我说的是「怎么什么都读不出来」,它回了我三段道歉,问题一点没解决。 这四句话我建议直接截图存着,下次卡住照着发就行。也转给那个总说「AI 根本读不懂我文档」的朋友——多半不是它读不懂,是话没说对。 它干到哪,哪几件必须你来 它干到:把 18 页压成 6 条带页码的结论,把 9 张真表的行列列清楚,把认不出来的老老实实写成「未找到」。 你来干三件:结论对不对(这是判断,不是提取)、数字能不能用(剂量少一位数就是事故)、引用页码必须回原文对一遍。 这篇讲的是怎么让它读对,不是医学建议。指南里的东西,以原文和上级医师为准。 你现在手边最厚的那份 PDF,翻到中间看一眼——从第几页开始全是英文文献? —— 阿言 领清单 · 回复「清单」 有没有过这种时候:一份几十页的 PDF 扔进来,它读出来的东西你却不敢直接用。关注我、后台回复「清单」,领我整理的《WorkBuddy 读 PDF 核对清单》——七步顺序、九问核对、四句救场话术都在里面,下次直接照着填。回复「进群」,我拉你一起对答案。 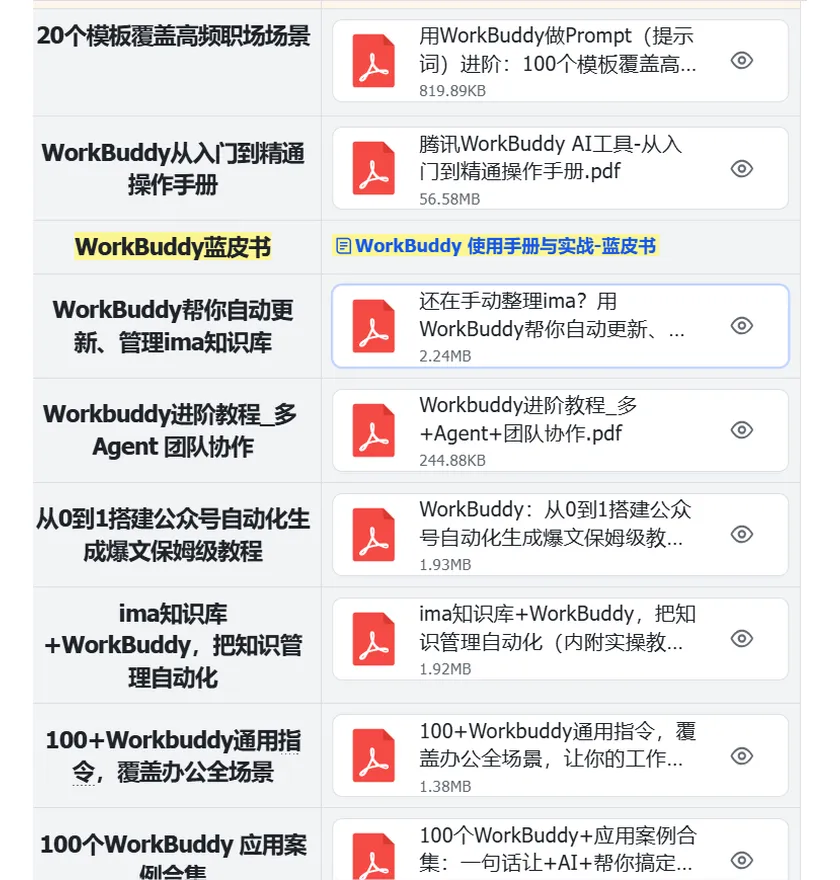
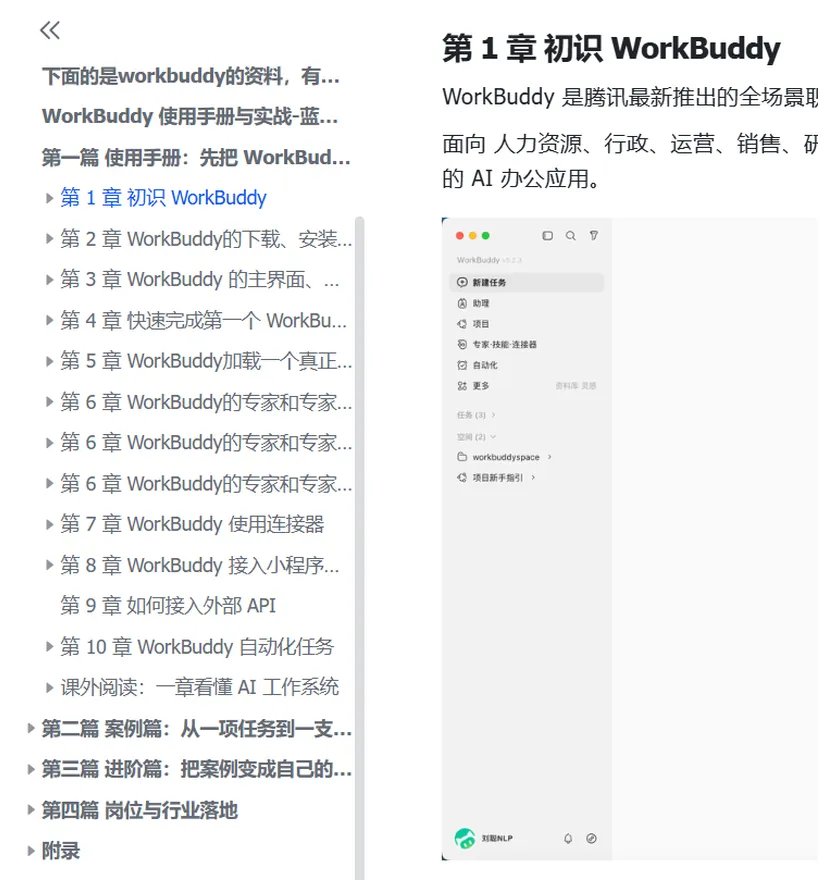
资料库里的一部分,都是我自己整理和试过的
溪风 · AI提效笔记 · 实操第 013 期
WorkBuddy 读 PDF 七步教程:
18 页我只让它读 12 页
2026 年 11 月 16 日 / 阿言